

Наблюдаемость как фундамент: телеметрия, логи, трассировка, метрики
Наблюдаемость - это способность системы помимо мониторинга давать не только текущее состояние, но и контекст причин и предпосылок изменений. В контексте дата-платформ это означает единую телеметрию из приложений и инфраструктуры, структурированные логи, трассировку запросов через сервисы и понятные метрики, которые позволяют корректно оценивать SLA и оперативно реагировать на инциденты. Эффективная наблюдаемость строится не на отдельных каналах сбора, а на единых моделях данных, связанных контекстом (trace, span, лог, метрика), а также на архитектурных паттернах, которые обеспечивают качество данных, масштабируемость и быстрый доступ к инсайтам.
В данной главе рассматриваются архитектурные принципы наблюдаемости, конкретные подходы к сбору телеметрии, роли логов и трассировки, а также связь метрик с управлением SLA и инцидент-менеджментом. Особое внимание уделяется выбору стандартов и форматов (OpenTelemetry и OTLP, W3C TraceContext, единая семантика), а также практикам внедрения, которые минимизируют дорогую техническую debt и ускоряют реакцию на инциденты.
- Архитектура наблюдаемости и ее взаимоотношения с SLA
- Каналы телеметрии, их форматы и схемы нормализации
- Логи и трассировка: контекст как ключ к корреляции
- Метрики и SLO/SLI: проектирование и использование
- Интеграции, операционные практики и эволюция платформы наблюдаемости
Архитектура наблюдаемости
Архитектура наблюдаемости должна быть спроектирована как единая платформа, объединяющая сбор данных из множества источников, их нормализацию, хранение и предоставление операторам понятных интерфейсов. Центральной идеей является канонизация форматов и контекстов, чтобы данные из разных компонентов можно было сопоставлять и связывать при любых нагрузках.
Ключевые элементы архитектуры включают:
- Источники данных: приложения, микросервисы, инфраструктура, обрабатывающие конвейеры и дата-центры. Источники должны поддерживать как встроенную, так и стороннюю инструментализацию. Важно обеспечить возможность автономного внедрения без пониженного темпа разработки.
- Агентный и безагентный сбор: выбор между встроенными SDK, sidecar-агентами и агентами сбора. Такая гибкость позволяет быстро масштабировать наблюдаемость и снижает затраты на внедрение.
- Ингестер/коллектор: централизованный сбор и маршрутизация телеметрии к хранилищам. Пример: OpenTelemetry Collector, Fluent Bit. Коллектор выполняет нормализацию и обогащение данных перед экспортом.
- Обработка и обогащение данных: processors, enrichments, фильтрация, семантические конвенции. Важно реализовать конвейеры, поддерживающие версионирование схем и обратную совместимость.
- Хранилище данных: раздельные хранилища для разных типов телеметрии - метрики, логи и трассировки. Метрики часто хранятся в специализированных системах (Prometheus/TimescaleDB), логи - в Elasticsearch или Loki, трассировки - в Jaeger/Tempo.
- Аналитика и визуализация: унифицированные дашборды и поиск; обеспечение возможности корреляции между каналами. Важно обеспечить быстрый доступ к контексту и возможность детального разбирательства инцидентов.
- Управление доступом и безопасность данных: политики доступа к данным, приватности и соответствие регуляциям. Нормализация прав доступа, шифрование в покое и в канале передачи.
- Интеграции с алертингом и инцидент-менеджментом: связь мониторинга, алертинга и процессов эскалации с системами управления инцидентами.
Нормализация данных - краеугольный камень этой архитектуры. Для целей интеграции и сопоставления необходимо использовать единый набор семантик и версионированные схемы данных. В качестве стандарта для телеметрии в большинстве современных стэков применяется OpenTelemetry с форматом OTLP для передачи данных, единые атрибуты ресурсов и следование семантическим конвенциям. Концепция контекста, например trace-id, span-id и baggage, позволяет сохранять корреляцию между событиями, логами и метриками, что критично для качественного анализа инцидентов.
Для иллюстрации возможной структуры можно привести следующую концептуальную схему: источники данных (приложения, сервисы, инфраструктура) → коллектор/ингест (OTel Collector) → обработчики/процессоры (нормализация, обогащение, фильтры) → экспортеры в хранилища (метрики, логи, трассировки) → слои аналитики и визуализации. Такая схема обеспечивает модульность, масштабируемость и возможность заменять компоненты без нарушения доступности данных.
Таблица
- Типы компонентов наблюдаемости и их роли
| Компонент | Роль | Примеры технологий |
|---|---|---|
| Производители данных | Генерируют телеметрию, логи и трассировки | Instrumentation SDKs, client libraries, sidecar-агенты |
| Ингест/коллектор | Исчерпывающая маршрутизация и нормализация данных | OpenTelemetry Collector, Fluent Bit |
| Обработчик/процессор | Обогащение, агрегация, фильтрация, версионирование схем | Processors в OTel, Spark/Flink для батчей |
| Хранение | Быстрый доступ к данным, разделение по типу | Prometheus/TimescaleDB для метрик, Loki/Elasticsearch для логов, Jaeger/Tempo для трассировок |
| Аналитика и визуализация | Поиск, дашборды, корреляция данных | Grafana, Kibana, Tempo UI |
| Интеграции с операционкой | Алёртинг, инцидент-менеджмент, управление данными | PagerDuty, Opsgenie, ServiceNow |
Понимание этических и правовых ограничений при сборе данных также критично: необходимо ограничивать сбор персональных данных, обеспечивать анонимизацию и соответствовать регуляторным требованиям на хранение и обработку глобальных данных. Архитектура должна поддерживать политику минимизации данных и возможность удаления данных по запросу.
Телеметрия: сбор и нормализация
Телеметрия - это входной поток данных, через который система получает информацию о своем состоянии. Эффективность сбора во многом определяет качество наблюдаемости, поэтому следует уделить внимание стандартам, формату данных и механизмам нормализации.
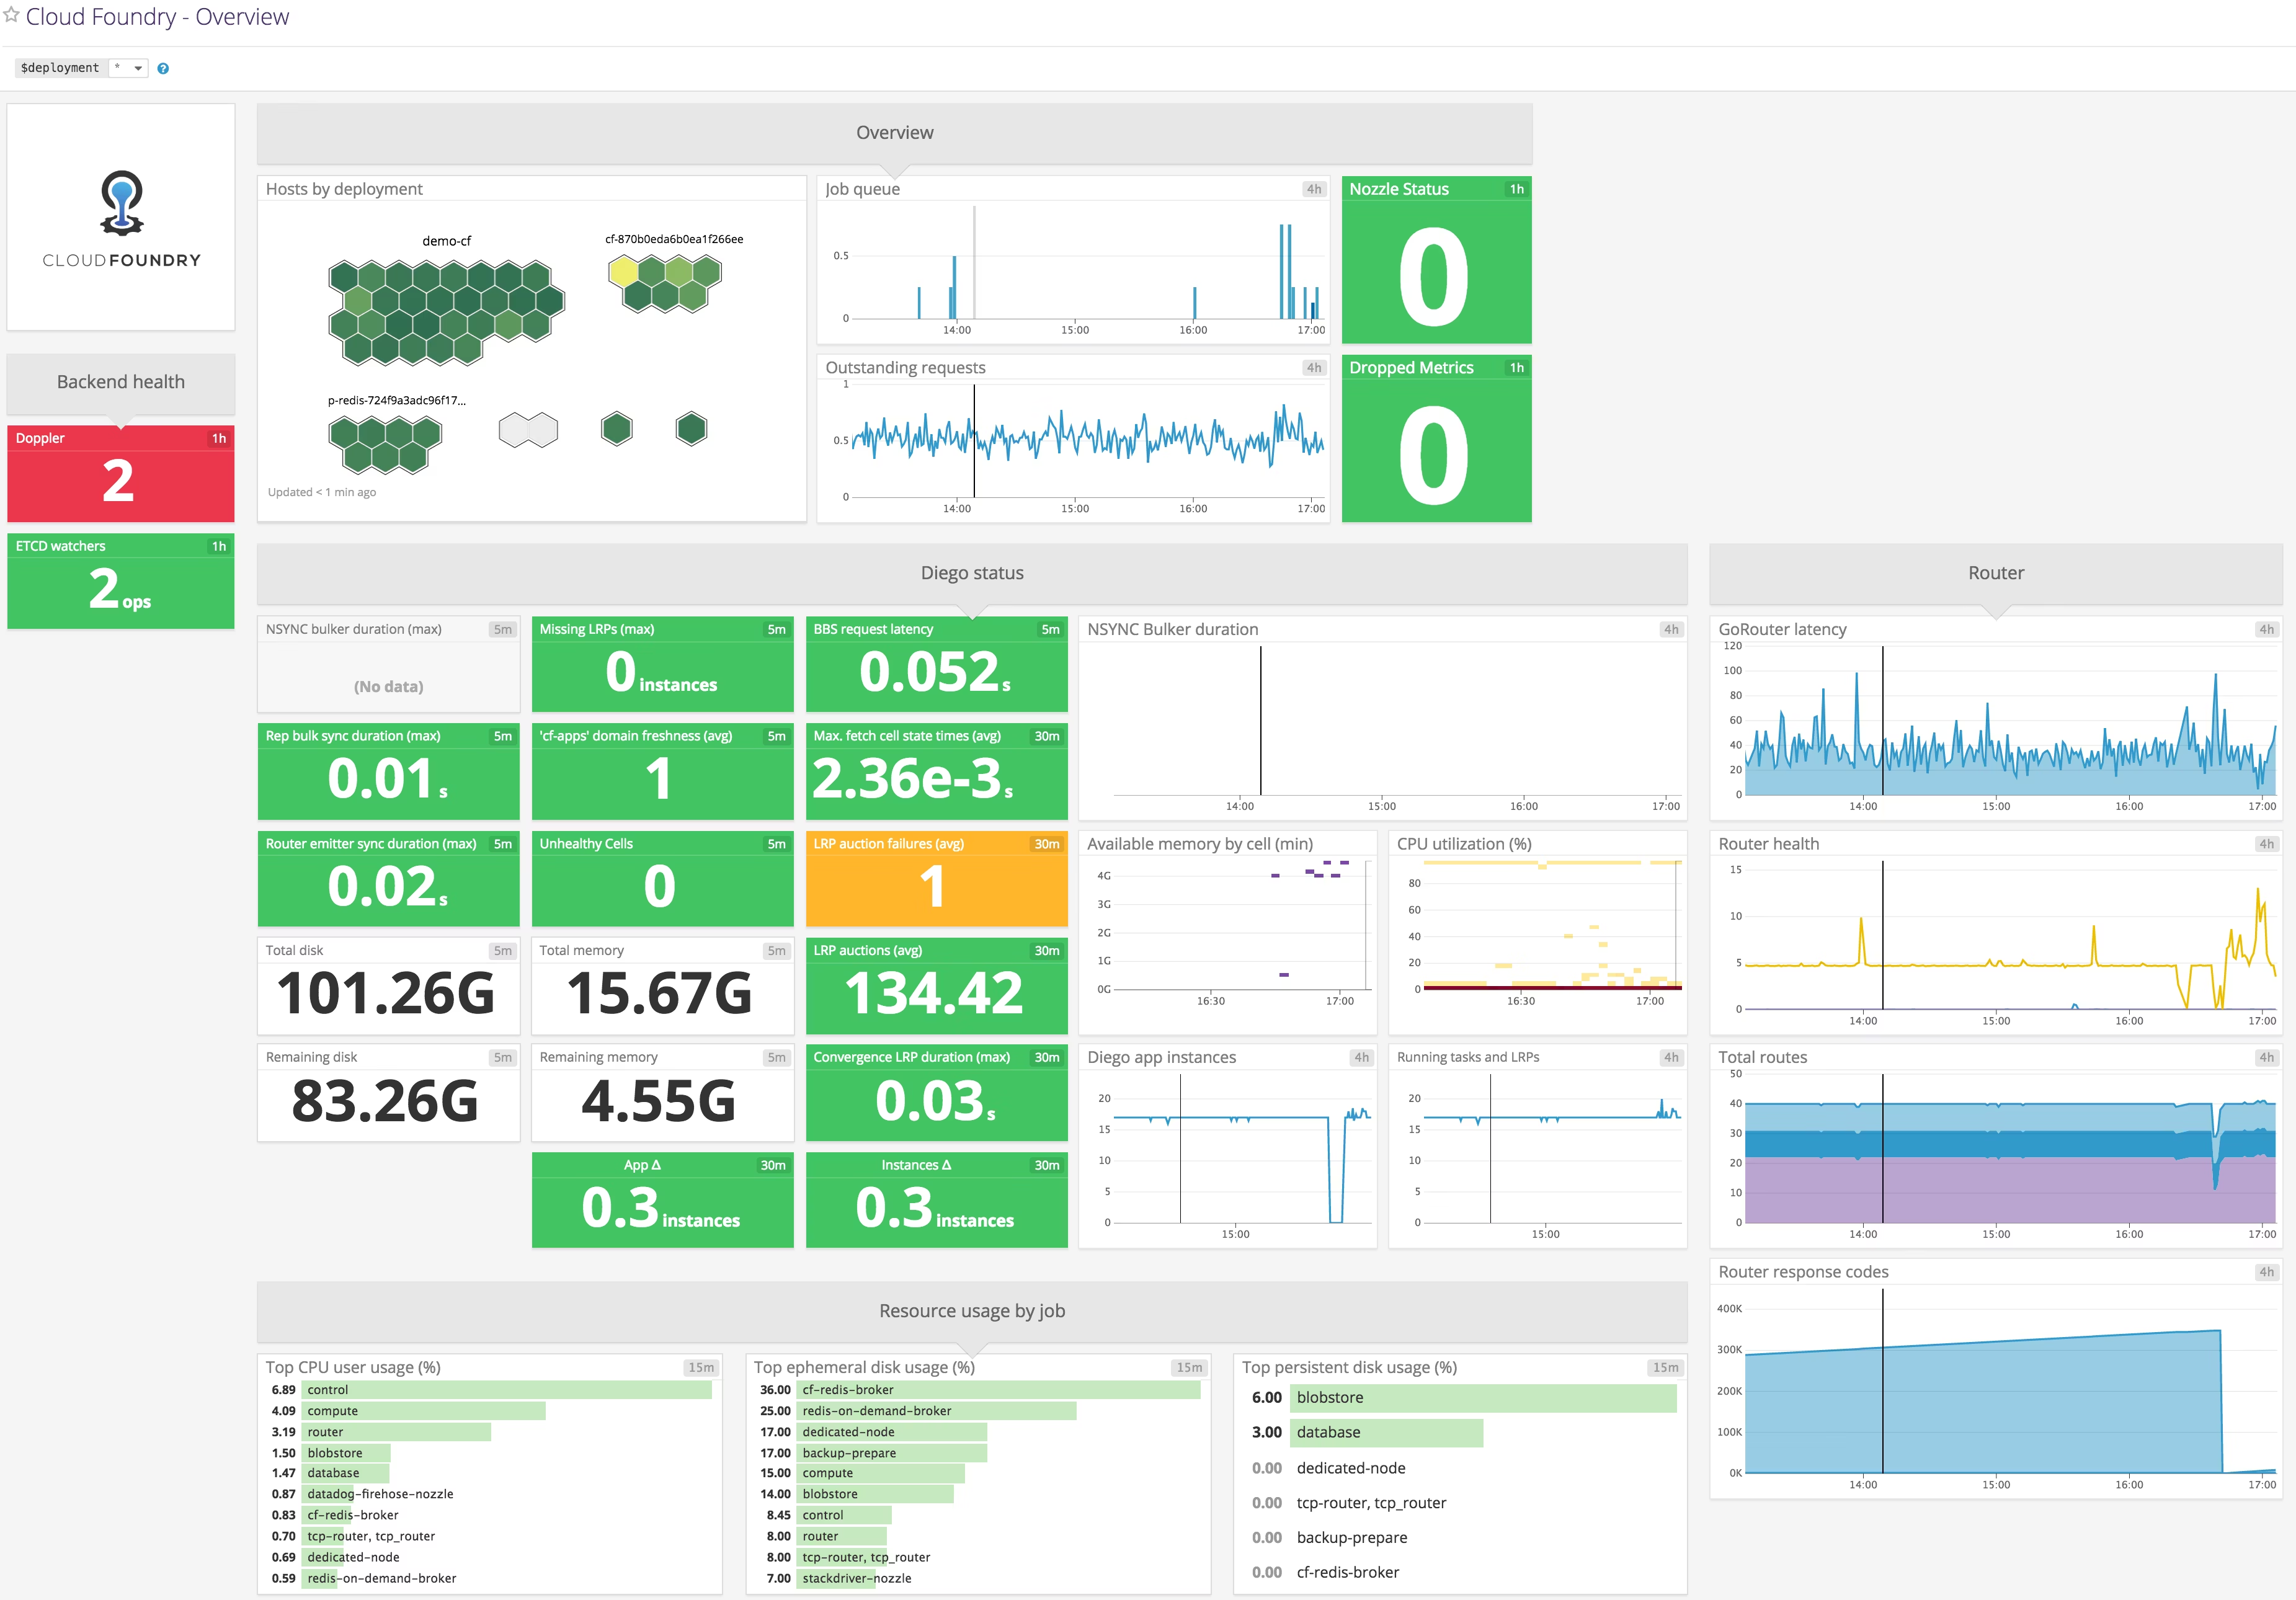
Ключевые аспекты:
- Единый формат и протокол: OTLP как основа передачи телеметрии между источниками и хранилищами. Он поддерживает телеметрию в виде трасс, метрик и логов и допускает расширение по мере необходимости. Использование OTLP облегчает консолидацию данных и упрощает добавление новых источников.
- Семантические конвенции: единый набор атрибутов и именования, которые позволяют сопоставлять данные из разных сервисов. Примеры включают naming conventions для сервисов, экземпляров, окружения, версии и т. п.
- Контекст и корреляция: через trace-context и распространение trace-id в заголовках сервисов. Это обеспечивает возможность сопоставлять логи с трассировками и связывать метрики с конкретными цепочками вызовов.
- Нормализация схем: версия схемы данных должна поддерживать обратную совместимость. Введение версий схемы снижает риск потери совместимости между обновлениями инструментов и приложений.
- Контроль качества данных: заметки по качеству данных - полнота, точность, задержка, дубликаты. Включение автоматических проверок на каждом этапе конвейера позволяет обнаруживать проблемы на ранних стадиях.
- Снижение затрат: выбор подходящего уровня детализации (sampling) и агрегации на раннем этапе конвейера снижает стоимость хранения и анализа. Правильно настроенный sampling сохраняет критический контент, не перегружая хранилище.
Процесс сбора состоит из нескольких стадий: сбор данных на стороне источника, передача через сеть к коллектору, обработка и обогащение, экспорт в целевые хранилища. Важно обеспечить точное соответствие форматов и версий, чтобы данные можно было сопоставлять между сервисами и временными периодами. В частности, трассировка требует особой внимательности к пропагации контекстов: trace-id и span-id должны сохраняться на всем пути прохождения запроса.
Для наглядности можно рассмотреть два сценария интеграции:
- Инструментальная сборка на основе OpenTelemetry: приложение включает SDK, генерирует телеметрию, коллекторами обогащает и экспортирует в централизованное хранилище. Такой подход обеспечивает единый язык телеметрии и упрощает масштабирование.
- Безагентная сборка через sidecar: особенно удобна в контейнеризированных средах. Sidecar выполняет роль телеметрического агента, снимая нагрузку с кода приложений и позволяя централизовать сбор данных без перекомпиляции сервисов.
Схема налаживания телеметрии часто включает следующие шаги:
- Определение критических точек сбора: ключевые сервисы, инфраструктура, конвейеры данных.
- Выбор форматов и протоколов: OTLP, JSON-логирование, W3C TraceContext.
- Организация конвейера: сбор, нормализация, обогащение, агрегация, экспорт.
- Внедрение семантических конвенций и версионирования схем.
- Настройка мониторинга качества данных и автоматических проверок.
- Планирование ретенции и защиты данных.
Важно помнить, что телеметрия должна поддерживать не только текущее состояние, но и возможность ретроспективного анализа. В контексте SLA это означает способность быстро реконструировать события и установить правовую или причинную связь между инцидентом и конкретной функциональностью.
Логи и трассировка: контекст как связующий элемент
Логи - это последовательности событий, фиксируемых системой. Их сила в контексте и детализации событий. Трассировка же обеспечивает трассировку запроса через распределенную архитектуру, давая вид на узлы и задержки между сервисами. В идеале логи и трассировки должны образовывать единый контекст, где каждый лог может быть сопоставлен с конкретной трассой и, наоборот, трасса - с набором логов.
Ключевые принципы связности контекста:
- Корреляция по trace-id: логам должны присваиваться trace-id и span-id, если они относятся к трассируемому потоку. Это позволяет быстро переходить от графа вызовов к конкретным записям в логах.
- Структурированность логов: структуры должны быть предсказуемыми и валидируемыми. Чистые поля типа timestamp, level, message, service, instance, trace_id, span_id ускоряют поиск и автоматическую агрегацию.
- Жесткие уровни логирования: определение уровней (DEBUG, INFO, WARN, ERROR) и их соответствие требованиям SLA. В продукционной среде следует минимизировать level DEBUG за пределами инцидентов.
- Хранение и поиск: логи хранятся в специализированных хранилищах, поддерживающих полнотекстовый поиск и агрегацию по полям; связь с визуализацией позволяет операторам быстро находить инциденты и реконструировать сценарии.
- Согласование времени: синхронизация времени между сервисами критична. Без точной синхронизации аналитику трудно определить порядок событий и задержек.
- Роли и политики доступа: логи часто содержат чувствительную информацию; доступ должен быть ограничен по ролям и соответствовать правовым требованиям.
Трассировка дополняет логи, давая ответ на вопрос “что произошло на уровне вызовов между сервисами”. В практике это означает наличие таких элементов:
- Контекст трасс: уникальный trace-id для всей цепи вызовов; каждый узел (span) в цепи имеет идентификатор и временные рамки.
- Фрагменты и вложенность: отображение вложенности вызовов позволяет понять узкие места. Глубокая трассировка помогает выявлять лимиты задержек в конкретных сервисах.
- Пр propagation: контекст должен распространяться через все коммуникации, поддерживая совместимость между сервисами на разных языках и платформах (HTTP headers, gRPC metadata).
- Прозрачность кросс-компонентной архитектуры: трассировка должна быть доступна через единый интерфейс, даже если сервисы написаны на разных стэках.
Практикой является интеграция корреляции логов и трассировки через единый идентификатор. Например, когда сервис записывает лог, он включает trace_id и span_id, связанных с конкретной трассой. В обратном направлении можно от трассы перейти к логам, которые относятся к данному фрагменту вызова. Это позволяет быстро определить звенья цепи, приводящие к задержкам или ошибкам.
Еще один аспект - структура логов. Структурированные логи, в формате JSON или схожем, позволяют автоматически извлекать поля, фильтровать по сервисам, окружениям и уровням. Это существенно упрощает поиск инцидентов и проведение ретроспективного анализа. В сочетании с распределенной трассировкой это обеспечивает полную видимость по всей системе.
Понимание сложностей приходит с практикой: в реальных условиях может быть множество сервисов, языков программирования и стеков. В таких условиях особенно важно соблюдение стандартов и централизованного управления. Наличие общего словаря атрибутов, единых контрактов на передачу контекста и поддержка совместимых форматов значительно упрощают внедрение наблюдаемости на масштабах предприятия.
Метрики и SLA: проектирование и оперативное использование
Метрики служат для количественной оценки состояния системы и ее способности удовлетворять требованиям бизнеса. В рамках SLA и SLO они формируют основу для мониторинга, алертинга и принятия решений по развитию и управлению нагрузкой. Важно различать три уровня: сигналы, индикаторы и целевые показатели.
Ключевые метрики для дата-платформ:
- Стабильность и доступность: доступность сервисов, процент успешных запросов, отказоустойчивость узлов.
- Производительность: латентность запросов, задержки на ключевых путях, среднее время обработки задач.
- Качество данных: полнота данных, точность, консистентность и задержка обновления данных.
- Загрузка и пропускная способность: использование CPU/ПЗУ/сетевых ресурсов, очереди и backpressure, saturated-метрики.
- Элементы SLA: SLO, SLA и SLI для каждого критического сервиса. Важно определить целевые показатели и пороги тревожности.
В проектировании метрик применяются принципы:
- Каноничность именования: единое именование сервисов и операций, чтобы метрики можно было агрегировать без конфликтов.
- Графовая модель данных: связь между сервисами и их зависимостями, позволяющая видеть критические пути.
- Градиентная детализация: сбор базовых показателей по умолчанию и возможность увеличения детализации в случаях инцидентов.
- Временная привязка: использование согласованного времени и временных зон; хранение точного времени событий - ключ к анализу задержек.
- Сегментация по контексту: разделение по окружениям (prod/stage/dev), регионам и версиям, чтобы изолировать параметры экспериментов.
Сигналы для SLO:
- Latency: p95, p99 времени отклика критических операций.
- Error rate: доля ошибок среди обработанных запросов.
- Availability: доля успешных операций в заданный период.
Эти сигналы должны соответствовать бизнес-целям и быть интегрированы в дашборды, чтобы операторы имели понятную картину состояния сервиса.
Алгоритмы обработки метрик включают:
- Аггрегацию и скользящее окно: для контроля долгосрочных трендов и раннего выявления изменений.
- Подсчет процента ошибок и доли срабатываний алертов: помогает не перегружать операторов слишком частыми тревогами.
- Гистограммы и квантили: для понимания распределения задержек и ресурсов.
- Детекция аномалий: использование статистических порогов или моделей машинного обучения для обнаружения отклонений от нормы.
Связь метрик с инцидентами требует тесной интеграции алертинга: тревоги должны основываться на сигналах и контексте. В идеале алерты должны содержать: trace context, сервисы involved, предикаты, временные рамки и ссылки на соответствующие логи и трассировки. Такая полнота упрощает диагностику и сокращает время восстановления.
Интеграции, процессы и операционные практики
Наблюдаемость не существует в вакууме: она должна быть встроена в процессы разработки, эксплуатации и управления изменениями. Ключевые принципы включают:
- Интеграция в CI/CD: автоматическая генерация телеметрии в тестовой среде, ранний доступ к наблюдаемости на ранних этапах DevOps. Это позволяет выявлять проблемы на стадии сборки и тестирования.
- Эволюция платформы: управление версиями схем данных, миграции без простоя и обратная совместимость. Важно поддерживать дорожную карту observability и согласованно обновлять инструменты.
- Управление данными: политика хранения и удаления данных, обеспечение приватности и соответствие регуляциям. Это особенно важно для логов с чувствительной информацией.
- Управление инцидентами: связь между инцидент-менеджментом и наблюдаемостью. Быстрый доступ к контексту, воспроизводимость и способность проводить постмортем и последующие улучшения.
- Безопасность и доступ: принципы least privilege, аудит доступа к данным наблюдаемости, защита каналов передачи и шифрование.
- Гражданский актив: создание единого «наблюдаемого продукта» внутри организации, где команды могут делиться шаблонами, конфигурациями и наработками.
Практически это означает наличие регламентов:
- Руководство по внедрению наблюдаемости: когда и какие сервисы должны иметь instrumentation.
- Руководство по конфигурации коллектора: настройки x-коллектора, processors, exporters для разных сред.
- Руководство по алертингу: пороги, сценарии эскалаций, интеграции с incident-management системами.
- Руководство по хранению и ротации данных: требования по retention, архивированию и удалению.
Переход к зрелой наблюдаемости требует не только технических решений, но и организационных изменений. Введение SRE-практик, распределение ответственности и формирование культуры внимательного отношения к данным - все это усиливает устойчивость и способность к быстрому принятию решений. Важно также обеспечить обучение команд: как интерпретировать метрики, как применять трассировку для диагностики, как использовать логи для аудита и разбиения причинно-следственных связей.
Наблюдаемость - это инвестиции в ясность: ясность того, что происходит в системе, почему происходят изменения, и что следует сделать для непрерывного улучшения. Архитектура, стандарты и процессы должны поддерживать не только скорость обнаружения инцидентов, но и скорость их разрешения, а также способность объяснять причины бизнес-задач и последующие улучшения.
Key takeaways
- Наблюдаемость требует единой архитектурной модели: единый язык телеметрии, корреляционный контекст и централизованное хранилище.
- OTLP и OpenTelemetry являются основой современных конвейеров телеметрии; семантические конвенции позволяют сопоставлять данные между сервисами.
- Корреляция логов и трассировки критична для ускоренного расследования инцидентов и повышения точности RCA.
- Метрики должны быть связаны с бизнес-целик и SLA/SLO, использовать канонические сигналы, % доступности, latency и качество данных.
- Интеграции и операционные практики (CI/CD, алертинг, инцидент-менеджмент, безопасность) необходимы для устойчивого перехода к зрелой observability.
- Важна версия схем и контроль качества данных на каждом этапе конвейера сбора, нормализации и экспорта.
- Внедрение наблюдаемости должно сопровождаться обучением команд, процедурами постмортем и эволюцией процессов в организации.
FAQ
- Что такое наблюдаемость и чем она отличается от мониторинга?
Наблюдаемость - это способность системы объяснять внутреннюю работу и поведение на основе данных телеметрии, логов, трассировок и метрик. Мониторинг чаще фокусируется на измерении состояния и порогах сигналов для оповещения. Наблюдаемость включает умение анализировать происхождение проблем и их контекст, чтобы RCA и быстро восстановить работоспособность. В реальном внедрении обе практики работают совместно: мониторинг обеспечивает раннее оповещение, наблюдаемость - глубинное понимание причин и контекста.
- Какие каналы телеметрии стоит внедрить в первую очередь?
В первую очередь - телеметрия в виде трасс и метрик критических сервисов, дополненная структурированными логами. OTLP обеспечивает единый путь передачи данных между источниками и хранилищами. Важно поддержать корреляцию через trace-id и span-id и обеспечить доступ к эти данным для всего стека, чтобы можно было анализировать задержки и ошибки на уровне цепочки вызовов.
- Как обеспечить единый контекст между логами, трассировками и метриками?
Необходимо внедрить единый контекст: trace-id и span-id должны проходить через все сервисы и попадать в логи. Гарантийная часть - структурные логи с полями trace_id, span_id, service, timestamp; метрики должны иметь теги, включающие идентификаторы контекста. Это позволяет связывать события из разных источников и восстанавливать трассу через логи и метрики.
- Что такое OTLP и зачем он нужен?
OTLP - протокол передачи телеметрии, созданный в рамках OpenTelemetry. Он предназначен для передачи трасс, метрик и логов между источниками, коллекторами и хранилищами. OTLP обеспечивает единый формат, облегчает агрегацию и обработку данных, упрощает внедрение новых источников и расширение платформы наблюдаемости.
- Как влияет sampling на качество наблюдаемости и SLA?
Sampling уменьшает нагрузку на конвейер и хранение данных, но может привести к потере деталей. В критических сервисах разумно применять tail или adaptive sampling: сохранять больше данных для ошибок, задержек выше порога, а для фоновых операций - снижать детализацию. В SLA важно знать, какие данные остаются доступными и какие сигналы должны сохраняться для расчета SLO. Хороший баланс между полнотой данных и стоимостью хранения достигается через стратегию выборочного сбора, экспорта и ретенции.
- Как эффективно коррелировать логи и трассировки?
Назначение trace-id на входе и протоколируемый trace-id на выходе из каждой сущности создают связующий контекст. Логи должны содержать trace_id и span_id, чтобы можно было сопоставить конкретный лог с трассой и узлом графа вызовов. Визуально это можно реализовать через дашборды, где клики по трассе открывают связанные логи и метрики, что позволяет быстро определить узкие места и причины задержек.
- Какие риски связаны с хранением наблюдаемости и как их минимизировать?
Основные риски - перегрузка хранилищ, нарушение приватности, задержки в обновлениях данных, и сложность управления схемами данных. Минимизировать риски можно через:
- разделение хранилищ по типам данных и настройку retention;
- применение политик доступа и шифрования на уровне инфраструктуры;
- версионирование схем и миграции без простоя;
- автоматические проверки качества данных на входе и во время обработки.
- Как начать переход к зрелой наблюдаемости в организации?
Начать следует с определения бизнес-целей и критических сервисов, затем выбрать единый набор стандартов форматов и контекстов. Внедрить OTLP, организовать коллекцию через OTel Collector, определить схему атрибутов и семантики, настроить корреляцию между логами, трассировками и метриками. Постепенно расширять покрытие на новые сервисы, внедрять стратегию контроля качества данных и интегрировать процесс алертинга с инцидент-менеджментом. Важно поддерживать обучение команд, регулярные постмортемы и эволюцию процессов.
- Какие примеры инструментов можно использовать как стартовую точку?
В рамках открытого и российского контекста можно рассмотреть: OpenTelemetry в связке с Tempo для трассировки, Loki или Elasticsearch для логов, Prometheus/TimescaleDB для метрик, Grafana для визуализации. Для интеграции с инцидент-менеджментом применяют PagerDuty или аналогичные системы. Эти инструменты позволяют реализовать современную архитектуру наблюдаемости с минимальными затратами на начальном этапе, поддерживая стандартные протоколы и схемы.
- Как связать наблюдаемость с SLA и бизнес-решениями?
Наблюдаемость должна поддерживать объективную оценку SLA через SLO-сигналы: latency, availability, error rate и качество данных. Эти показатели должны быть встроены в дашборды бизнес-ориентированных команд. В дополнение к технике наблюдаемости следует внедрить процессы регулярной оценки и постмортем после инцидентов, чтобы выявлять слабые места в архитектуре и оперативно внедрять улучшения.
Глава завершает систематическое представление того, как телеметрия, логи, трассировки и метрики образуют единую карту состояния дата-платформы. Правильное проектирование конвейеров, единые форматы и семантика, связь контекста и последовательное внедрение практик SRE обеспечивают не только быстрое обнаружение инцидентов, но и глубокое понимание причин их возникновения, что является основой для устойчивого повышения качества услуг и доверия бизнес-заказчиков.


