

Введение в EDA и хранение данных
Добро пожаловать в раздел, посвящённый введению в EDA и хранение данных в рамках курса по построению хранилища данных для архитектуры Event Driven Architecture (EDA). Цель главы — объяснить, зачем в современных системах нужна архитектура, ориентированная на события, каковы базовые концепции и термины, какие модули и технологии чаще всего используют на практике, и какие существуют риски и ограничения. Мы ориентируемся на реальный рабочий контекст: как проектировать поток данных от источников событий до хранилища и аналитических витрин, какие подходы применяются к моделированию данных, как обеспечить надёжность и воспроизводимость, а также какие решения можно использовать как в открытом доступе, так и в рамках российского рынка.
Что такое Event Driven Architecture и зачем она нужна в хранении данных
Event Driven Architecture — это стиль проектирования систем, где основным способом обмена и обработки информации являются события. Событие — это зафиксированное изменение состояния или факт, который произошёл: например, создание заказа, изменение статуса оплаты, поступление позиции на склад и т. п. В EDA данные поступают в виде потоков (стримов) событий, которые можно обрабатывать в реальном времени или с запаздыванием. Преимущества такого подхода включают низкую связанность компонентов, масштабируемость, гибкость в добавлении новых потребителей и возможность строить аналитические витрины, которые обновляются по мере поступления событий.
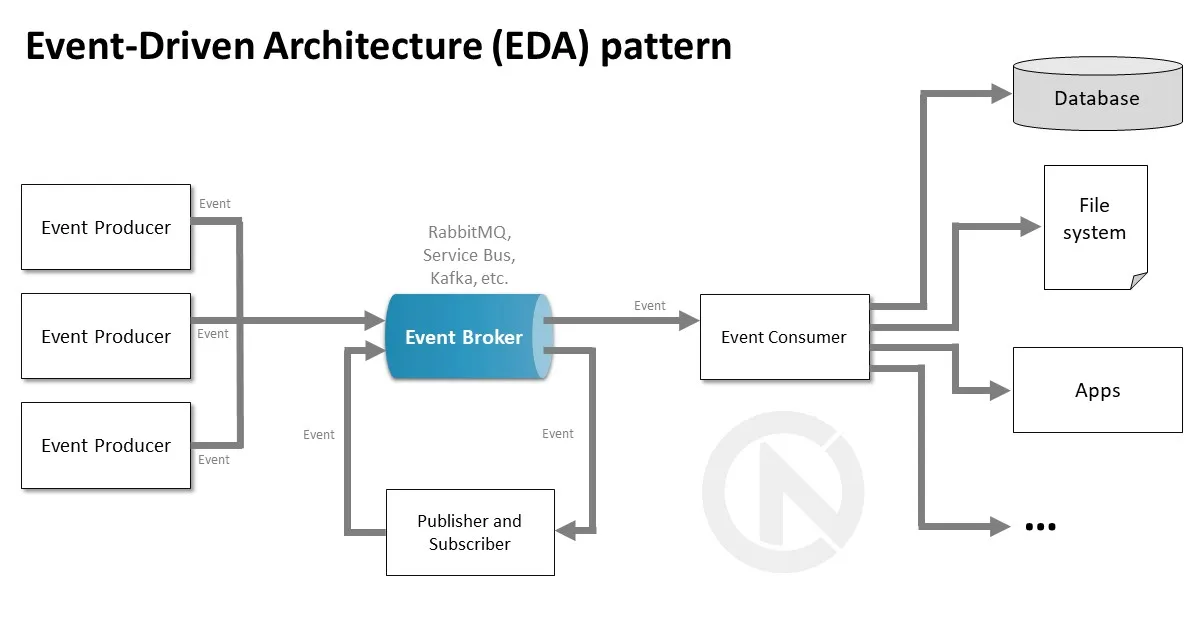
События и хранилища: как связаны EDA, поток данных и хранение
- Источник событий (producer) — система или сервис, который генерирует события.
- Брокер сообщений/платформа потоковой передачи — принимает события и обеспечивают их доставку потребителям. Часто это Apache Kafka, но могут использоваться и другие системы: RabbitMQ, NATS и т. д.
- Обработчик событий — служба, которая читает события и производит преобразования, агрегации, обогащение данных. Это может быть потоковый движок (Flink, Spark Structured Streaming, Beam) или пакетный инструмент (не исключен ELT-подход, когда данные сначала кладутся в хранилище, затем обрабатываются пакетно).
- Хранилище данных — здесь события приводят к записям в хранилище, которое поддерживает аналитические запросы и последующую эксплуатацию, например data lake (объектное хранилище) и/или data warehouse (OLAP-хранилище).
В рамках EDA хранение данных часто реализуется как две ступени:
- Неизменяемый журнал событий (event log) в виде потока, который может служить устойчивым источником для анализа и воспроизведения.
- Аналитическая витрина (data warehouse/OLAP) для поддержки бизнес-аналитики и отчетности.
Особенности проектирования событийных схем
- Гранулярность: выбор размера единицы события — от крупных business events до микро-событий в рамках одного бизнес-процесса.
- Уникальные идентификаторы: каждый событие должно иметь уникальный event_id и временную метку event_time для воспроизводимости и дедупликации.
- Схема и эволюция: схема события должна поддерживать эволюцию без разрыва для потребителей. Часто применяется схема регистрации (schema registry) и контрактное тестирование.
- Idempotence и повторная доставка: в системах с at-least-once доставкой события могут приходить повторно. Нужно разрабатывать потребителей так, чтобы они безопасно обрабатывали повторы.
- Временные зоны и событийное время против времени обработки: важно различать время, когда событие произошло (event_time), и время, когда оно было обработано (processing_time).
Системы потоков и принципы обработки
- Стриминговые движки (Flink, Spark Structured Streaming, Beam) позволяют обрабатывать события в реальном времени, поддерживают оконные операции, агрегации, обогащение данных, а также управляют состоянием и гарантируют различный уровень консистентности (at-least-once, exactly-once).
- Этапы ELT против ETL: в контексте EDA чаще применяется ELT-подход, когда данные сначала поступают в хранилище в виде сырого журнала, затем обрабатываются и моделируются для аналитики. Это даёт большую гибкость и упрощает повторную обработку.
- Управление качеством данных: валидирование форматов, типов, целостности ключей, проверка на дубликаты, мониторинг задержек и задержки в потоке.
Модели данных и архитектура хранения
- Data lake vs data warehouse: данные в data lake зачастую хранятся в формате Parquet/ORC в объектном хранении и используются для машинного обучения, прогнозной аналитики и обработки больших массивов данных. Data warehouse предназначено для оперативной бизнес-аналитики и поддерживает структуры, такие как звезда (star schema) и снежинка (snowflake schema).
- В контексте EDA часто применяют Data Vault 2.0, где события и данные приводят к созданию хранилища с гаппулем из Hubs (контакты/сущности), Links (связи) и Satellites (истории изменений). Однако для быстрого аналитического доступа многие предпочитают схему звезды или снежинки.
- Управление схемами через schema registry и контрактные тесты, поддержка эволюции схем без падения потребителей.
Технические детали, которые важно усвоить
- Событие как единица загрузки: event_id, event_type, source, event_time, payload. payload может быть вложенной структурой с различными полями в зависимости от типа события.
- Выбор форматов сериализации: Avro и Protobuf предпочтительны в целях эффективной сериализации и контроля схем, JSON — удобен для отладки, но занимает больше места и может потребовать дополнительных проверок.
- Схема должна поддерживать эволюцию, например добавление новых полей без разрушения существующих потребителей. Важна совместимость схем и точное управление версиями.
- Дедупликация: хранение контрольных сумм, использование дедупликации на уровне брокера или обработчика (например, запись события только при отсутствии ранее зафиксированного event_id).
- «exactly-once» доставка достигается на уровне брокера и обработки данных; некоторые системы допускают «at-most-once» и требуют дополнительных мер для восстановления.
- Безопасность и соответствие: шифрование данных в пути и на хранении, контроль доступа к темам и данным, аудит действий, соответствие требованиям конфиденциальности и регуляторике (например, по персональным данным).
Практические примеры
Open-source решения
- Apache Kafka: наиболее популярная платформа для потоковой передачи и хранения событий. Позволяет создавать темы (topics) по источникам данных, обеспечивать репликацию, устойчивость и масштабируемость.
- Debezium: система CDC (change data capture), которая отслеживает изменения в базах данных и публикует их в Kafka. Поддерживает MySQL, PostgreSQL, MongoDB и другие СУБД.
- Apache Flink: движок потоковой обработки в реальном времени. Обеспечивает сложную обработку событий, окно-агрегации, обогащение, обработку ошибок и управление состоянием.
- Apache Spark (Structured Streaming): альтернативный движок для потоковой и пакетной обработки; хорошо интегрируется с данными в data lake и в некоторых случаях — с хранилищами типа ClickHouse.
- ClickHouse: высокопроизводительное открытое OLAP-хранилище, особенно популярно в России и у российских компаний. Подходит для аналитических запросов на уровне миллисекунд к миллисекундам, supports real-time ingestion и масштабируемость.
- Apache Pinot и Apache Druid: альтернативы для нереального времени аналитики и интерактивных дашбордов; дают быстрый ответ на агрегаты по крупным данным.
Российские решения и практики
- ClickHouse: отечественное происхождение и активное использование в российских организациях. Прекрасно подходит для OLAP-аналитики, аггрегаций, дашбордов и фильтрации больших наборов данных в реальном времени.
- Яндекс.Облако и украинские сервисы: в экосистеме российского рынка присутствуют управляемые сервисы для Kafka и другие инструменты. Например, Managed Service for Apache Kafka (MSAK) в Яндекс Cloud, а также возможности хранения в Object Storage, обеспечивающие S3-совместимость и интеграцию с данными в ClickHouse.
- Яндекс Datalake: решения, которые поддерживают сбор и хранение данных в научно-аналитических целях, включая интеграцию с сервисами аналитики и обработки данных.
- Применение Data Lake и управляемого стека в российских условиях часто подразумевает использование российских решений по обеспечению доступности, безопасности и соответствия требованиям локального законодательства.
Пример реализации типичного пайплайна
-
Этап 1: CDC и ingest в Kafka
- Источник: база данных PostgreSQL или MySQL в продакшене.
- Debezium фиксирует изменения и отправляет события в тему Kafka, например orders_events, inventory_events.
- Включение схемной регистрации (Schema Registry) для контроля форматов сообщений.
-
Этап 2: Стримовая обработка
- Apache Flink читает события из Kafka, обогащает значения (например, добавляет данные о курсе валют, курирует статусы), выполняет оконные агрегации (за день, за час).
- Обеспечение идемпотентности обработки.
-
Этап 3: хранилище и выгрузка
- Raw слой: запись сырой выборки в data lake (MinIO или S3-совместимое хранилище) в Parquet.
- Cleansed/Processed слой: запись в аналитическое хранилище, например ClickHouse, с использованием star schema (факты продаж, dims) или Snowflake-подобная модель.
- В реальном времени может использоваться Pinot или Druid для интерактивной аналитики на основе текущих событий.
-
Этап 4: аналитика и визуализация
- BI-инструменты (например, ClickHouse-бизнес-досье, Grafana) для создания дашбордов и детального анализа по заказам, запасам и клиентам.
Технические детали реализации
-
Архитектура хранения
- Raw data layer: журналы событий в формате Parquet в объектном хранилище. Пример: событие заказа включает: event_id, event_type, event_time, order_id, customer_id, amount, currency, payload.
- Cleansed/Enriched layer: структурированные таблицы для аналитики. Примеры таблиц: facts_orders (мостовая таблица фактов продаж), dim_customers, dim_products, dim_time.
- Схемы Star/Snowflake: для упрощения анализа, использования предикатов в WHERE и быстрых агрегаций.
-
Моделирование событий
- Обеспечение единичной идентификации и дедупликации (event_id как первичный ключ события).
- Нормализация и денормализация: иногда имеет смысл денормализовать payload для ускорения аналитических запросов, но это требует контроля за размером и обновлениями.
- SCD (Slowly Changing Dimensions): для измерений клиентов и товаров можно применять SCD Type 2, чтобы сохранять историю изменений.
-
Форматы и совместимость
- Avro/Protobuf в качестве форматов сериализации: поддерживают схематическую эволюцию, компактность и скорости передачи.
- JSON: полезен на этапе разработки и отладки, но менее эффективен на больших объемах.
-
Управление схемами
- Ввод схем в Schema Registry для контроля изменений, поддержка совместимости (backward, forward, full compatibility).
- Контракты между источниками и потребителями: строгие соглашения о полях и типах данных.
-
Надёжность и консистентность
- Репликация брокера Kafka и настройка уровня гарантий доставки (at-least-once, exactly-once) в зависимости от потребностей.
- Idempotent write: обработки событий, чтобы повторная доставка не приводила к дублированию данных.
- Мониторинг задержек, пропускной способности и ошибок обработки.
-
Безопасность
- Аутентификация и авторизация (SASL/SSL для Kafka, RBAC на уровне данных и объектов).
- Шифрование на хранении и в пути, контроль доступа к данным в хранилищах.
- Регуляторика и аудит действий.
-
Управление производительностью
- Разделение тем по источникам и типам событий.
- Настройка партиций в Kafka, размер окон в Flink/Spark, режимуWRITE в ClickHouse для эффективной загрузки.
-
Операционная практика
- Непрерывная интеграция и развёртывание пайплайнов: тестирование изменений схем, регрессионные тесты на повторную загрузку и воспроизведение.
- Логирование и мониторинг: Prometheus/Grafana для процессов и задержек, системы алертинга.
Риски и ограничения
- Временная задержка и потеря событий: даже при оптимальных настройках возможны задержки и редкие потери; это влияет на точность реального времени и дедупликацию.
- Эволюция схем: изменения форматов и полей требуют координации между поставщиками и потребителями; без правильного управления версиями схем сложнее поддерживать совместимость.
- Сложность инфраструктуры: EDA-пайплайны включают несколько компонентов (CDC, Kafka, Flink/Spark, хранилища). Это требует продуманной эксплуатации, мониторинга и специалистов.
- Производительность и стоимость: работа в реальном времени по высоким нагрузкам требует мощной инфраструктуры и может быть дорогой. Необходимо балансировать между реальным временем и затратами.
- Вопросы согласованности: в некоторых сценариях может потребоваться exactly-once доставка; в других — допустимо at-least-once, но применяется дедупликация.
- Безопасность и приватность: обработка персональных данных потребует строгого контроля доступа, маскирование и соблюдения регуляторных норм.
- Вложения в российском рынке: выбор отечественных и локальных решений может ограничивать доступность некоторых инструментов за пределами региона; однако ClickHouse и Яндекс-облако предоставляют мощный набор услуг и хорошую совместимость для местных потребителей.
- Миграции и портируемость: переход между инфраструктурами (например, перенос между облаками, локальным дата-центром и облаком) требует продуманной стратегии миграций и совместимости форматов.
Выводы
Введение в EDA и хранение данных в контексте данного курса подчеркивает, что современная аналитика строится на потоках событий и непрерывном обновлении витрины данных. Архитектура EDA позволяет быстрее реагировать на бизнес-события, обеспечивает гибкость в масштабировании и позволяет строить аналитические модели почти в реальном времени. Правильное проектирование схем, выбор инструментов с учётом региональных реалий и грамотная организация пайплайнов — залог успешной реализации хранилища данных для EDA. Важно помнить о рисках и ограничениях, поэтому рекомендуется постепенно наращивать функциональность, начинать с минимально жизнеспособного пайплайна и эволюционно добавлять новые источники, преобразования и витрины.
Вопрос–Ответ (FAQ)
-
Что такое EDA и как она связана с хранением данных?
EDA — это архитектура, основанная на событиях, где данные поступают в виде событийных потоков. Хранение данных в EDA строится на журналах событий и последующей аналитической витрине (data warehouse/OLAP) для поддержки бизнес-аналитики. Связь между источниками, потоками и витриной обеспечивает возможность анализа в реальном времени и устойчивой архитектуры данных. -
Какой формат событий оптимален для практической реализации?
В большинстве случаев рекомендуется использовать бинарные форматы с контролируемой схемой, такие как Avro или Protobuf, в сочетании с Schema Registry. Это обеспечивает совместимость схем, управление версиями и эффективную сериализацию. JSON может быть удобен на старте, но менее эффективен для больших объёмов и сложных схем. -
Какие инструменты чаще всего применяются в open-source стеке для EDA?
Ключевой базовый набор: Apache Kafka для потоковой передачи и хранения событий, Debezium для CDC, Apache Flink или Spark Structured Streaming для обработки, и ClickHouse как OLAP-хранилище. Для интерактивной аналитики часто выбирают Apache Pinot или Apache Druid. В качестве data lake можно использовать MinIO или S3-совместимое хранилище. -
Какие российские решения применяются в таких пайплайнах?
ClickHouse — популярное открытое OLAP-хранилище с сильной позицией в России. Яндекс.Облако предлагает управляемые сервисы для Kafka и объектного хранилища, которые интегрируются с ClickHouse и другими компонентами экосистемы. Эти решения позволяют строить локальные и совместимые инфраструктуры с учётом требования локализации данных и регуляций. -
Какие данные лучше хранить в raw layer и в обработанном слое?
Raw layer хранит неизменяемые журналы событий в формате, близком к источнику, чтобы обеспечить воспроизводимость и аудит. Cleansed/Enriched слой содержит структурированные данные, пригодные для аналитики: факты продаж, измерения, справочники (DIMs). Разделение слоёв упрощает управление качеством данных и позволяет выполнять эффективные запросы в аналитике. -
Как обезопасить данные и соблюсти регуляторику?
Реализуйте шифрование в пути и на хранении, управляйте доступом через IAM/RBAC, используйте аудит действий и журналирование, внедрите маскирование персональных данных и защиту конфиденциальной информации. Важно учитывать требования местного законодательства и регуляторов, в том числе по хранению и обработке персональных данных. -
Какие риски и ограничения стоит учитывать на старте проекта?
Основные risk-пойнты — задержки и потеря событий, сложность инфраструктуры, управление схемами и эволюцией данных, стоимость эксплуатации, обеспечение Exactly-Once доставки там, где это критично, и требования к безопасности. Начинать можно с минимального набора источников и витрин, постепенно расширяя пайплайн, поддерживая строгие контракты между компонентами. -
Какой подход к моделированию данных предпочтителен в EDA?
Чаще применяют star schema или data vault 2.0 в зависимости от целей и зрелости проекта. Star schema обеспечивает простоту и скорость запросов, тогда как data vault помогает хранить гибкую историю изменений и лучше управлять эволюцией схем, особенно в крупных организациях с множеством доменов. -
Что важно учесть при выборе между Proof-of-Concept и продакшн-пайплайном?
В PoC-фазе фокус на минимально жизнеспособном пайплайне: быстрый сбор источников, базовый поток и витрина. В продакшне важны надёжность, мониторинг, безопасность, управление версиями схем, устойчивость к сбоям и возможность масштабирования. Планируйте миграции, тесты на регрессию и процедуры отказоустойчивости заранее. -
Какие шаги помогут ускорить переход к EDA-хранилищу данных в вашей компании?
Начните с определения нескольких критичных бизнес-событий, создайте минимальный поток с CDC из одной базы, направьте данные в Kafka, примените простую обработку в Flink и загрузите в ClickHouse как первую витрину. Постепенно расширяйте источники, добавляйте обогащение и новые витрины, внедряйте контроль контрактов, схему registry и мониторинг. Развивайте грамотную практику версионности схем и дедупликации на уровне потребителей.


