

Введение в SCD и значение Slowly Changing Dimensions
SCD, или Slowly Changing Dimensions, — это один из ключевых паттернов моделирования данных в хранилищах данных. Он отвечает на вопрос: как хранить и управлять изменениями во времени в измерениях (измеряемых сущностях), чтобы аналитика могла корректно учитывать не только текущее состояние, но и исторически изменяющуюся информацию. Представьте себе клиентов, продукты, адреса или менеджеров по продажам: их характеристики меняются со временем, и для точной аналитики порой важно сохранить каждую «версии» записи или хотя бы часть её истории. Без правильной реализации SCD аналитику приходится работать с неполной или неустойчивой информацией, что ведет к неверным выводам, репутационным рискам и дополнительным переработкам данных.
В современных хранилищах данных задача SCD решается не одним способом: зависит от бизнес-правил, сроков архивирования, требований к аудиту и объёма данных. В этой главе мы освоим базовые понятия, разберём типовые паттерны SCD (Type 1, Type 2, Type 3 и гибридные вариации), обсудим принципы проектирования и технологий реализации, приведём практические примеры на популярных платформах и рассмотрим реальный рынок решений, включая открытое ПО и российские решения. В конце глава поместит раздел FAQ, где вы найдёте развернутые ответы на наиболее частые вопросы новичков и практиков.
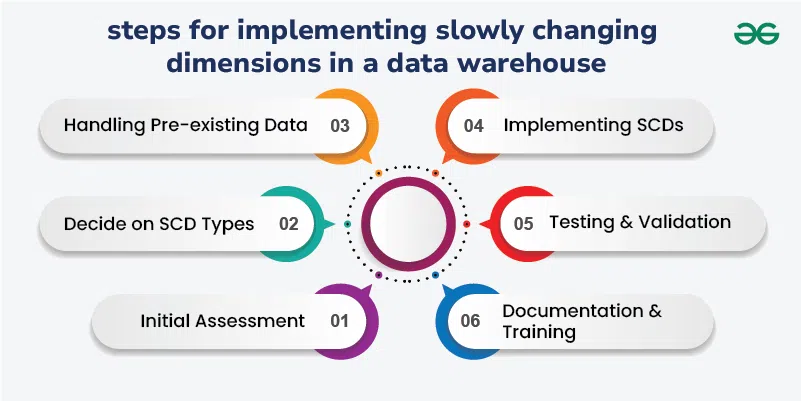
Определения и базовые концепции
- Что такое SCD? Это подход к хранению измерений, при котором система способна сохранять изменения значений атрибутов со временем и обеспечивает возможность запросов как по текущим значениям, так и по их историческим версиям.
- Элементы модели SCD: естественный ключ (natural key) — уникальный идентификатор бизнес-объекта в источнике (например, customer_id), суррогатный ключ (surrogate key) — внутренний ключ в измерении, обычно целочисленный, используемый для уникальной идентификации версии записи; поля версии и даты (effective_from, effective_to, дата вступления в силу, дата завершения действия); флаг текущей версии (is_current) или аналогичный механизм.
- Change Data Capture (CDC) и ETL/ELT. SCD часто тесно связан с интервенциями по данным: мы отлавливаем изменения во времени и применяем их к измерениям. В зависимости от архитектуры ETL/ELT можно обрабатывать изменение пакетами (batch) или в режиме потока (streaming).
-
Типовой набор паттернов SCD:
- SCD Type 1: обновление на месте без сохранения истории. Модернизация текущего набора значений. Простой и быстрый, но не сохраняет историю изменений.
- SCD Type 2: сохранение полной истории изменений. При каждом изменении создаётся новая версия записи со своими датами начала и окончания действия; в таблице хранится несколько версий одной сущности, и у каждой версии свой суррогатный ключ.
- SCD Type 3: частичная история, хранение ограниченного набора предшествующих значений в дополнительных столбцах (например, предыдущая версия адреса). Уместно, когда нужен только «прошлая» версия, а не вся история.
- SCD Type 4 и Type 6: альтернативные и гибридные подходы. Type 4 — выделение истории в отдельную таблицу; Type 6 — гибридное решение, сочетающее элементы Type 1, Type 2 и Type 3.
- SCD Zero/0: состояние без изменений — полезно для некоторых быстрых обновлений, но редко используется в полноценной хранилищной архитектуре.
- Математика версий и целостность. В Type 2 важно обеспечить корректное обновление обеих сторон: старой версии нужно задать корректный период действия, новой — начать срок действия с даты изменения, а текущее состояние помечать как активное. В некоторых системах используются конечные даты (end_date) и флаг is_current; в других применяют версию (version) и механизмы слияния Merge для поддержки истории.
- Архитектура и требования к консистентности. В зависимости от того, явяемся ли мы источником истинной информации (single source of truth) и какова частота обновления измерений, выбираются соответствующие подходы к CDC, кэшированию, индексации и архитектуре ETL/ELT. Важно обеспечить согласованность между измерениями и фактами: фактами, зависящими от версий измерений, и корректность временных окон. В среде больших данных многие компании предпочитают ELT-архитектуру: сначала загрузили данные в промежуточные стадии, затем применили логику SCD внутри облачных хранилищ или аналитических движков.
Технические принципы реализации
Surrogate key как единый идентификатор версии. Вместо использования естественного ключа в качестве PK в измерении, применяют суррогатный ключ, который обеспечивает уникальность каждой версии записи.
Источник и текущее состояние. Для Type 2 мы сохраняем все версии, где каждая версия имеет свой период действительности. В запросах по текущему состоянию часто используют is_current = true или end_date = бесконечная дата (например, 9999-12-31).
Схема хранения. Схема зависит от платформы и паттерна:
- Type 1 простой столбец на месте.
- Type 2 отдельная версия на каждую модификацию с полями: surrogate_key, natural_key, атрибуты, start_date, end_date, is_current, version.
- Type 3 добавляет столбцы для предыдущих значений, если нужно хранить только одну «прошлую» версию.
- Type 4 — история в отдельной таблице, где каждая версия хранится отдельно, и основная таблица содержит ссылки на нее.
- Type 6 — более продвинутый гибрид, который выбирает оптимальный компромисс между историей и эффективностью запросов.
Временные окна и запросы. Тип 2 требует аккуратной обработки изменений: при обнаружении различий между источником и текущей версией в DIM следует:
- зафиксировать конец действия старой версии;
- вставить новую версию с началом действия в дату обновления;
- обновить флаг текущей версии.
Это можно реализовать через последовательность SQL-запросов или через единый MERGE/UPSERT, если платформа поддерживает такие операции.
Управление качеством данных. Для корректной реализации SCD критически важно:
- детектировать изменения точно (поле по полю),
- учитывать нюансы типов данных (даталар, временные зоны, адреса, изменяемые атрибуты),
- минимизировать ложные изменения (например, ловить незначительные изменения форматов даты, пробелов и т. п.),
- обеспечивать аудит и видимость версии для бизнес-пользователей.
Практические примеры
Сценарий: хранение информации о клиентах с изменением адреса и имен
Исходная ситуация. В источнике есть таблица клиентов с полями: customer_id (естественный ключ), name, address, city, phone, updated_at. В Dim-таблице SCD мы хотим хранить полную историю изменений адреса и имени.
1) Пример реализации SCD Type 1 (обновление текущего состояния без истории)
Цель: при следующем обновлении сохраняем только текущее значение, предыдущие версии не сохраняются.
SQL-подход (PostgreSQL или совместимый синтаксис):
UPDATE dim_customer_scd d
SET name = s.name, address = s.address, city = s.city, phone = s.phone
FROM staging_customer s
WHERE d.customer_id = s.customer_id;
Комментарий: данные в dim_customer_scd обновляются на основе текущей версии, история не сохраняется.
2) Пример реализации SCD Type 2 (полная история)
Цель: по изменению сохраняем новую версию, предыдущее состояние помечаем как неактивное, устанавливаем дату окончания действия.
Алгоритм:
- Найти текущую активную версию для каждого customer_id.
- Если данные изменились по хотя бы одному атрибуту, вставить новую запись версии и обновить прежнюю версию.
Псевдо-SQL (PostgreSQL-совместимый стиль):
-определить изменения и обработать их пакетно
WITH current AS (
  SELECT d.customer_sk, d.customer_id, d.name AS old_name, d.address AS old_address,
         d.city AS old_city, d.phone AS old_phone,
         d.effective_from, d.end_date, d.is_current
  FROM dim_customer_scd d
  WHERE d.is_current = true
),
changes AS (
  SELECT s.customer_id, s.name AS new_name, s.address AS new_address, s.city AS new_city, s.phone AS new_phone,
         CURRENT_DATE AS change_date
  FROM staging_customer s
)
-если есть различия, вставляем новую версию и обновляем старую
INSERT INTO dim_customer_scd (customer_id, name, address, city, phone, effective_from, end_date, is_current, version)
SELECT c.customer_id, c.new_name, c.new_address, c.new_city, c.new_phone, ch.change_date, DATE '9999-12-31', true,
       COALESCE((SELECT MAX(version) FROM dim_customer_scd WHERE customer_id = c.customer_id), 0) + 1
FROM changes c
JOIN current cur ON cur.customer_id = c.customer_id
JOIN changes ch ON ch.customer_id = c.customer_id
WHERE (cur.old_name IS DISTINCT FROM c.new_name OR
       cur.old_address IS DISTINCT FROM c.new_address OR
       cur.old_city IS DISTINCT FROM c.new_city OR
       cur.old_phone IS DISTINCT FROM c.new_phone);
-обновить старую версию
UPDATE dim_customer_scd
SET end_date = (SELECT change_date FROM changes WHERE customer_id = dim_customer_scd.customer_id),
    is_current = false
WHERE customer_id IN (SELECT customer_id FROM changes)
  AND end_date = DATE '9999-12-31'
  AND is_current = true;
Комментарий: этот пример иллюстрирует логику, но в реальности его нужно адаптировать под конкретную СУБД и требования к транзакциям. Главная идея: обнаружение изменений, вставка новой версии и закрытие старой версии.
3) Пример реализации SCD Type 3 (частичная история)
Цель: сохранять только предыдущую версию поля, например, адрес. Это может быть полезно, если бизнес хочет видеть только текущее значение и немногую историю последнего изменения.
SQL-подход:
ALTER TABLE dim_customer_scd ADD COLUMN prev_address VARCHAR(255);
UPDATE dim_customer_scd AS d
SET prev_address = d.address, address = s.address
FROM staging_customer s
WHERE d.customer_id = s.customer_id AND d.is_current = true AND d.address <> s.address;
Комментарий: здесь у нас две колонки: текущий адрес и предыдущий адрес. В Type 3 можно реализовать более сложные паттерны, но основная идея — хранить ограниченное прошлое.
Практические примеры на реальных решениях
Open-source решения и подходы
- dbt (data build tool) с макросами для SCD Type 2. В dbt можно реализовать пакет моделей, которые по incremental-модели синхронизируют данные с хранением версий. Часто применяется подход «current» флага и «valid_from/valid_to» дат. Практически такой подход широко применяется в сообществе dbt: вы создаете staging-слой, затем dimension-предикаты на изменение и финальная таблица dimension с версиями.
- Apache Spark / PySpark. Реализация SCD Type 2 на уровне DataFrame: загрузка исходных данных, сравнение с последней версией в_dimension, генерация новых версий и обновление старых записей. Подобные решения хорошо работают в больших данных и позволяют обрабатывать миллионы изменений за пакет или поток.
- Pentaho Data Integration (Kettle). В открытом виде это одно из самых «популярных» решений в мире ETL с готовым шагом Slow Changing Dimension. Он визуально показывает логику обновления и версий и подходит для быстрого старта без больших скриптов.
- Apache NiFi. В рамках потоковой интеграции можно реализовать SCD через последовательность процессов: получение изменений, сопоставление с текущей версией DIM и вставку новых версий. Это решение подходит для потоковых сценариев и CDC.
Российские и локальные решения и подходы
- ClickHouse (разработчик Yandex, Россия). Это мощная колоночная база данных, широко применяемая в российских проектах. Для SCD Type 2 можно использовать таблицу с суррогатным ключом и полем версии, или применить ReplaceMergeTree/AggregatingMergeTree с версионной логикой. Важно спроектировать таблицу так, чтобы обрабатывать слияния и очистку устаревших версий без потери производительности. Пример:
  Dim клиент (customer_sk UInt64, customer_id String, name String, address String, city String, phone String, effective_from Date, effective_to Date, is_current UInt8, version UInt64)
  ENGINE = ReplacingMergeTree(version)
  ORDER BY (customer_id, effective_from);
Такой подход позволяет хранить историю через версии и регулярно объединять записи (Merge) для поддержания актуального состояния.
- 1C:Предприятие и российский слой аналитики. В России широко применяется 1С для учета и планирования. В 1С можно реализовать SCD внутри конфигурации учета: хранить значения в регистрах и экземпляры записей, где каждый обновляющийся атрибут может порождать новую версию, или преобразовать данные в измерения с версионной логикой на уровне конфигурации. Это позволяет бизнесу интегрироваться с привычными инструментами 1С и обеспечивать аудит изменений. Практика внедрения в 1С зависит от конкретной предметной области и блоков учета, но подход к версионности вполне реализуем: запись изменений в регистр или в регистр сведений с датами действия.
- Yandex Cloud DataSphere и другие российские сервисы. В рамках российского экосистемы можно использовать связку: источники данных → DataSphere/модели → ClickHouse/PostgreSQL → аналитика. В частности, ClickHouse может выступать как хранилище деревьев изменений, а DataSphere — как платформа для построения отчётов и дашбордов. Это сочетание хорошо подходит для компаний, ориентированных на российские сервисы и инфраструктуру.
Модель данных и проектирование
- Выбор суррогатного ключа. Обычно это целое число (UInt, BIGINT) с последовательной генерацией. Это ускоряет запросы и упрощает управление версиями.
- NATURAL KEY и объединение версий. NATURAL KEY — это бизнес-ключ сущности (например, customer_id). В dim-таблице SCD мы держим NATURAL KEY и SURROGATE KEY отдельно, чтобы обеспечить независимость от изменений естественных ключей.
- Атрибуты и изменения. Определите, какие атрибуты изменяют бизнес-правила, и какие изменения считают значимыми для истории. Часто выбирают ключевые атрибуты для SCD Type 2: имя, адрес, город, телефон и т. д.
- Временные поля. В большинстве реализаций используются:
  effective_from (дата начала действия версии),
  end_date (дата окончания действия версии),
  is_current (логический флаг текущей версии),
  version (номер версии).
- Архитектура потоков. Рекомендовано использовать ELT-подход: данные попадают в промежуточный слой, затем в слой измерений, где мы применяем логику SCD, пользуясь мощностью движка хранилища (SQL, Spark, ClickHouse и т. д.).
- Управление качеством и аудит. Включайте логирование изменений, хранение источника изменений, контроль версий и возможность отката. В бизнесе часто требуется аудит для регуляторных требований.
Технические реализации на конкретных платформах
PostgreSQL / Oracle / MSSQL:
- Тип 2 реализуется через две операции: обновление старой версии (end_date, is_current = false) и вставку новой версии (effective_from = текущая дата, end_date = '9999-12-31', is_current = true).
- Можно использовать MERGE или UPSERT паттерны в зависимости от СУБД.
- Создайте уникальный индекс на (customer_id, is_current) для быстрого доступа к текущей версии.
ClickHouse:
- ENGINE = ReplacingMergeTree(version) обеспечивает замену дубликатов по ключу с указанной версией. Типичная реализация Type 2 может выглядеть как:
    CREATE TABLE dim_customer_scd (
      customer_sk UInt64,
      customer_id String,
      name String,
      address String,
      city String,
      phone String,
      effective_from Date,
      end_date Date,
      is_current UInt8,
      version UInt64
) ENGINE = ReplacingMergeTree(version) ORDER BY (customer_id, effective_from);- Вставляете новую версию с increasing version и текущим состоянием. Устаревшие версии остаются в таблице, с последующей очисткой через merges.
dbt:
- Модели источников и моделей-«фермы» для SCD Type 2. Включает incremental materialization, проверку изменений через сравнение с последней версией и вставку новой версии.
1С:Предприятие:
- В рамках конфигурации 1С можно реализовать собственное дерево версий-изменений, используя регистры и справочники с датами действия и версионной логикой. Такой подход позволяет держать историю в рамках учетной системы и легко интегрировать с внешними BI-инструментами.
- Pentaho Kettle (PDI):
- Включает шаг Slow Changing Dimension, который поддерживает несколько типов SCD и позволяет визуально настроить логику для Type 1, Type 2, Type 3. Это решение популяpно в практических внедрениях благодаря простоте настройки и большому количеству готовых коннекторов.
Apache NiFi:
- Реализация SCD через последовательности Processors и Jolt/Record трансформация, адаптированная под потоковую обработку изменений. Хорошо работает в случаях CDC из систем оперативной обработки.
Риски и ограничения внедрения
- Увеличение объема данных. Type 2 неизбежно приводит к росту объема измерений, потому что каждая изменившаяся запись порождает новую версию. Это требует продуманного режима архивирования, очистки устаревших данных и эффективной архитектуры хранилища.
- Сложность поддержки логики. Реализация SCD требует точности в контроле дат, версий и флагов. Ошибки в обновлении старых версий могут сломать аудиты и привести к неверной аналитике.
- Производительность. В большинстве решений Type 2 запросы будут менее тривиальными: нужно правильно индексировать, поддерживать хранение версий, часто использовать Partitions/TTL. В больших системах это может потребовать настройки кеширования, параллельной загрузки и оптимизации запросов.
- CDC и задержки. В потоковых сценариях CDC может приходить с задержками, что несёт риск рассинхронности между фактами и измерениями. Важно устанавливать SLA по задержке обновления и тестировать концевые случаи.
- Конфиденциальность и регуляторные требования. Исторические данные могут содержать персональные данные (PII). Необходимо обеспечить соответствие требованиям защиты данных и политик хранения, включая анонимизацию, маскирование или ограничение доступа к историческим версиям.
- Управление жизненным циклом. Старые версии нужно штатно архивировать, очищать или упаковывать. Неправильное управление архивами может привести к переполнению хранилища и замедлению анализа.
- Интеграция с фактами. Фактовые таблицы часто связаны с измерениями по суррогатным ключам. При неверной синхронизации версий между измерениями и фактами возможны несоответствия в аналитике и вычислениях KPI.
- Выбор подхода. Type 1 очень прост, но лишает вас истории; Type 2 обеспечивает полную историю, но сложнее и ресурсоемче; Type 3 ограничен прошлой версией. Важно подобрать паттерн соответствующий бизнес-требованиям, техническим условиям и объему данных.
SCD — это фундаментальныйkniff в создании качественного и управляемого хранилища данных. Выбор конкретного типа SCD зависит от бизнес-тотребностей в аудите и аналитике изменений, а также от технических ограничений проекта, объема данных и инфраструктуры. В рамках курса мы закрепим понимание концепций и научимся реализовывать SCD на конкретных платформах: от открытых инструментов до российских технологий. Мы рассмотрим способы проектирования схем измерений, методы поддержки истории и актуальности, а также универсальные подходы к тестированию и внедрению. В следующей части мы углубимся в конкретные технические детали, примеры реализации и тестовые сценарии, чтобы вы могли начать работать над реальными проектами уже на следующем этапе.
Вопрос–Ответ (FAQ)
1) Что такое Slowly Changing Dimensions и зачем они нужны в хранилищах данных?
SCD — это подход к хранению изменений в измерениях во времени. Они нужны для того, чтобы аналитика могла учитывать не только текущее состояние объектов, но и их историю изменений. Это критично для регламентной отчетности, аудит комплаенса и точной бизнес-аналитики, где решения опираются на динамику характеристик клиентов, продуктов, сотрудников и т. д.
2) Какие основные типы SCD существуют и чем они отличаются?
Основные типы: Type 1 обновляет значения на месте без сохранения истории; Type 2 сохраняет полную историю изменений путём вставки новой версии с датами начала и окончания действия; Type 3 хранит частично прошлые значения (обычно одну предыдущую версию); Type 4 выделяет историю в отдельную таблицу; Type 6 — гибридный подход, который сочетает элементы нескольких типов. В реальных проектах часто применяют Type 2 для аудируемой истории, Type 1 для незначительных атрибутов и Type 3 для ограниченной архивной информации.
3) Какие практические подходы к реализации SCD существуют на практике?
Практически используют: (a) чистый SQL-подход (обновление старой версии и вставка новой версии в Type 2); (b) ETL/ELT-инструменты с готовыми шагами SCD (Kettle/Pentaho, dbt, NiFi); (c) потоковые решения с CDC (Debezium+Kafka+Spark); (d) базы данных и движки с поддержкой версионности (ClickHouse, PostgreSQL, Oracle). В современных проектах часто комбинируют ELT-архитектуру с движком хранилища и добавляют слой тестирования и аудита.
4) Какие есть open-source инструменты для SCD и какие задачи они решают?
- dbt: реализации Type 2 через incremental-материализацию и макро-логики. Хорошо подходит для моделирования в пироге SQL-ориентированной среды.
- Apache Spark: гибко реализует Type 2 через DataFrame-операции, удобен для больших данных и пакетной обработки.
- Pentaho Kettle: готовый шаг Slow Changing Dimension, упрощает настройку и визуализацию логики SCD.
- Apache NiFi: потоковая реализация CDC+SCD, полезна для реального времени и потоковых сценариев.
- ClickHouse: через ReplaceMergeTree/версии можно реализовать Type 2 на уровне СУБД, что даёт высокую производительность в аналитических задачах.
5) Какие подходы применяются на российском рынке?
На российском рынке широко применяются решения на базе ClickHouse (российская разработка и активное использование в России). ClickHouse применяется для хранения исторических версий и анализа больших массивов данных с высокой скоростью. Также активно используются 1С:Предприятие в сочетании с BI-слоем и интеграцией с внешними источниками; при этом внутри 1С можно реализовать логику версий через регистры и справочники, обеспечивая аудит изменений. Российские компании также применяют облачные сервисы и экосистемы Яндекс/Кубход DataSphere и аналитику на базе ClickHouse.
6) Какие риски связаны с внедрением SCD и как их минимизировать?
Риски: рост объема данных, сложность поддержки, задержки CDC, риск ошибок в обновлении версий, сложности с архивированием и регуляторные требования по защите данных. Минимизация: четкое определение бизнес-тактов и атрибутов, автоматизированные тесты изменений и аудита, разделение слоев (staging, dimension, facts), мониторинг задержек и производительности, настройка политики архивирования и использования TTL, тестирование на демо-данных и регрессионные тесты для обновлений версий.
7) Какие сложности могут возникнуть при переходе с SCD Type 1 на Type 2?
Главная сложность — увеличение объема данных и необходимость изменения процессов загрузки, а также перепроектирование логики зависимостей между измерениями и фактами. Нужно внедрить суррогатный ключ для версий, добавить даты начала и окончания действия, обеспечить корректную работу индексов и запросов к истории. Важна тесная координация между бизнес-правилами и технической командой, чтобы не нарушить существующие отчеты и BI-дашборды.
8) Какие лучшие практики помогут начать работу с SCD в нашем проекте?
- Определите требования к истории: какие атрибуты и какой объём изменений должны храниться.
- Выберите паттерн, соответствующий бизнес-правилам: Type 2 для полной аудируемой истории или Type 1/Type 3 для более простых случаев.
- Спроектируйте суррогатный ключ, естественный ключ и временные поля.
- Применяйте ELT-архитектуру: загружайте в промежуточный слой, затем применяйте логику SCD в целевых таблицах.
- Введите аудит изменений и тесты на регрессию.
- Рассмотрите использование готовых инструментов: dbt/macros, Kettle, NiFi, Spark, а также возможности ClickHouse для Type 2.
- Планируйте архивирование и управление жизненным циклом историй.
9) Какую роль играет CDC в SCD?
CDC позволяет получать изменения из источника оперативных систем почти в реальном времени или с заданной задержкой. Это критично для поддержания актуальности измерений в Type 2, если бизнес требует минимальных задержек между изменением в источнике и его отражением в хранилище. В зависимости от потребностей можно выбрать пакетную обработку (batch) или потоковую обработку (streaming).
10) Какие архитектурные решения будут полезны в нашем контексте?
- ELT-подход в сочетании с быстрым хранилищем (например, ClickHouse) для Type 2 истории.
- Включение CDC для минимальной задержки.
- Модульная архитектура с staging-слоем и dimension-слоем, чтобы изоляция изменений не влияла на факты и отчеты.
- Инструменты для тестирования и аудита изменений, а также мониторинг производительности по запросам и обновлениям версий.
Введение в SCD и понимание значимости Slowly Changing Dimensions — это отправная точка для построения качественного аналитического окружения. Мы рассмотрели теоретические основы, типовые паттерны и архитектурные принципы, а также практические примеры реализации на открытых и региональных технологиях. В следующих разделах курса мы углубимся в конкретные техники реализации (Type 1, Type 2, Type 3), покажем пошаговые примеры с кодом на разных платформах и обсудим тестирование, мониторинг и управление рисками в процессе внедрения. Этот контент обеспечит вам прочную базу для разработки устойчивых и аудируемых хранилищ данных, которые способны отвечать на современные бизнес-потребности в анализе временны́х изменений.
FAQ ч. 2
1) Что такое SCD и зачем он нужен новичку в работе с хранилищами данных?
SCD — это методика хранения изменений в измерениях во времени, чтобы аналитика могла видеть и текущее состояние, и историю изменений. Это важно для точной отчетности, аудита и регуляторных требований, а также для анализа трендов и влияния изменений на бизнес-показатели.
2) Какой тип SCD выбрать на старте проекта?
Выбор зависит от бизнес-правил и регуляторных требований. Type 1 подходит для незначительных атрибутов без потребности в истории. Type 2 обеспечивает полную аудируемую историю и чаще применяется там, где важно сохранять каждую версию записи. Type 3 — для ограниченной истории, когда нужна только предыдущая версия. Type 4/6 — для специальных сценариев, где история вынесена в отдельную таблицу или требуется гибридный подход. В большинстве крупных аналитических проектов выбирают Type 2, но решение должно приниматься на основе требований к аудиту, скорости запросов и хранения.
3) Какие практические примеры можно привести для Type 2 на реальных платформах?
Примеры: на PostgreSQL/Oracle MSSQL — реализуется через обновление старой версии и вставку новой версии; на ClickHouse — использование ReplacingMergeTree с версионным полем; в dbt — incremental-материализация с текущей версией; в Spark — PySpark-логика сравнения последних версий и вставка новых. Все эти подходы направлены на сохранение истории атрибутов и поддержание целостности версий.
4) Какие российские и открытые технологии особенно полезны для SCD?
Открытые: dbt, Apache Spark, Pentaho Kettle, Apache NiFi, PostgreSQL, ClickHouse. Российские решения: ClickHouse (российская разработка и активное использование в России); 1С:Предприятие — популярная платформа в России, где можно реализовать версионность внутри конфигурации; интеграция с российскими облачными и аналитическими сервисами через DataSphere и аналогичные локальные решения. Это сочетание позволяет внедрить SCD в рамках отечественной инфраструктуры и регуляторных требований.
5) Какие риски связаны с внедрением SCD и как их минимизировать?
Риски: рост объема данных, сложность поддержки, задержки CDC, риск ошибок в обновлениях, проблемы с архивированием и защитой данных. Минимизация: четко определить бизнес-правила, использовать тестирование изменений и регрессионные тесты, внедрить аудит изменений, обеспечить мониторинг производительности и корректное управление жизненным циклом формируемых версий, подобрать подходящий тип SCD под задачу и обеспечить документирование архитектуры.
6) Какой процесс внедрения SCD наиболее удобен для новичка?
Рекомендуется начать с Type 1 для некоторых атрибутов, затем постепенно переходить к Type 2 для критически важных объектов бизнеса, внедрять staging-слой, определять естественные ключи и суррогатные ключи, а затем строить логику обновления версий. Используйте готовые инструменты (dbt, Kettle, NiFi) для ускорения внедрения и уменьшения ошибок, параллельно настраивая мониторинг и тестирование.
7) Какие сложности могут возникнуть при миграции существующей базы к паттерну SCD Type 2?
Сложности связаны с переработкой существующих фактов и измерений, необходимостью перенастроить ключи и связи между таблицами, переработкой ETL/ELT-процессов, а также с потребностью в перенастройке BI-отчетов и дашбордов. Лучше начинать миграцию с пилотного набора объектов, чтобы проверить логику и влияние на отчеты, затем масштабировать.
8) Какие ключевые метрики и проверки пригодятся для контроля внедрения SCD?
- Количество версий на сущность за период;
- Доля версий, где обновляются атрибуты без изменений в естественных ключах;
- Время обработки изменений (latency) от источника до целевой DIM;
- Доля ошибок обновления и регрессионных тестов;
- Размер DIM и скорость выполнения запросов к нему;
- Аудит изменений: кто и когда внёс изменения.
9) Как выбрать стратегию архивирования для исторических версий?
Определите правила хранения: сколько лет истории нужно держать онлайн, какие версии можно перевести в архив, какие данные подлежат миграции в отдельную историю (Type 4). Учитывайте требования регуляторов и бизнес-потребности. В ClickHouse можно использовать TTL и перенос устаревших версий в холодное хранилище; в традиционных СУБД — периодическое архивирование в архивные таблицы.
10) Что будет полезно для быстрого старта в нашей команде?
- Определите основной паттерн SCD (чаще Type 2) и набор атрибутов для историрования;
- Протестируйте реализацию на демо-данных;
- Внедрите staging-секцию и начните с простейших обновлений;
- Попробуйте готовые инструменты: dbt для моделирования, Kettle или NiFi для ETL/ELT;
- Протестируйте сценарии аудита и регуляторных требований;
- Оцените российские решения (ClickHouse) и определите, как они впишутся в существующую инфраструктуру.


