

Защита персональных данных: классификация, обезличивание и псевдонимизация
Эта глава предназначена для новичков, которые только присоединяются к отделу Data Governance, а также для тех, кто хочет детально разобраться в методологиях обработки персональных данных, связанных с безопасностью, доступами и соответствием регуляторным требованиям. Мы последовательно рассмотрим теорию, термины, методологии, практические примеры и риски внедрения.
Персональные данные (PD) — это любая информация, которая прямо или косвенно может идентифицировать человека. В современном бизнесе большое значение имеет не только сбор PD, но и то, как эти данные защищаются, как они обезличиваются или псевдонимизируются, и какие требования регуляторов применяются к обработке. В рамках Data Governance задача состоит в том, чтобы обеспечить баланс между полезностью данных для аналитики и бизнес-потребностями и требованиями защиты приватности и регуляторности.
Ключевые понятия, с которыми мы будем работать:
- PD и PII (личная идентифицируемая информация)
- Обезличивание (de-identification)
- Псевдонимизация (pseudonymization)
- Анонимизация (anonymization)
- Маскирование данных (data masking)
- Форм-факторная криптография и форматно-сохранная криптообезличка (FPE)
- Синтетические данные (synthetic data)
- Принципы к-анонимности, l-диверситета, t-близости
- Регуляторика: GDPR, да и российские требования (ФЗ-152, локализация, кросс-границ регуляторная совместимость)
Данная глава структурирована так, чтобы вы могли не только понять теорию, но и увидеть практические примеры реализации, ознакомиться с инструментами и оценкой рисков.
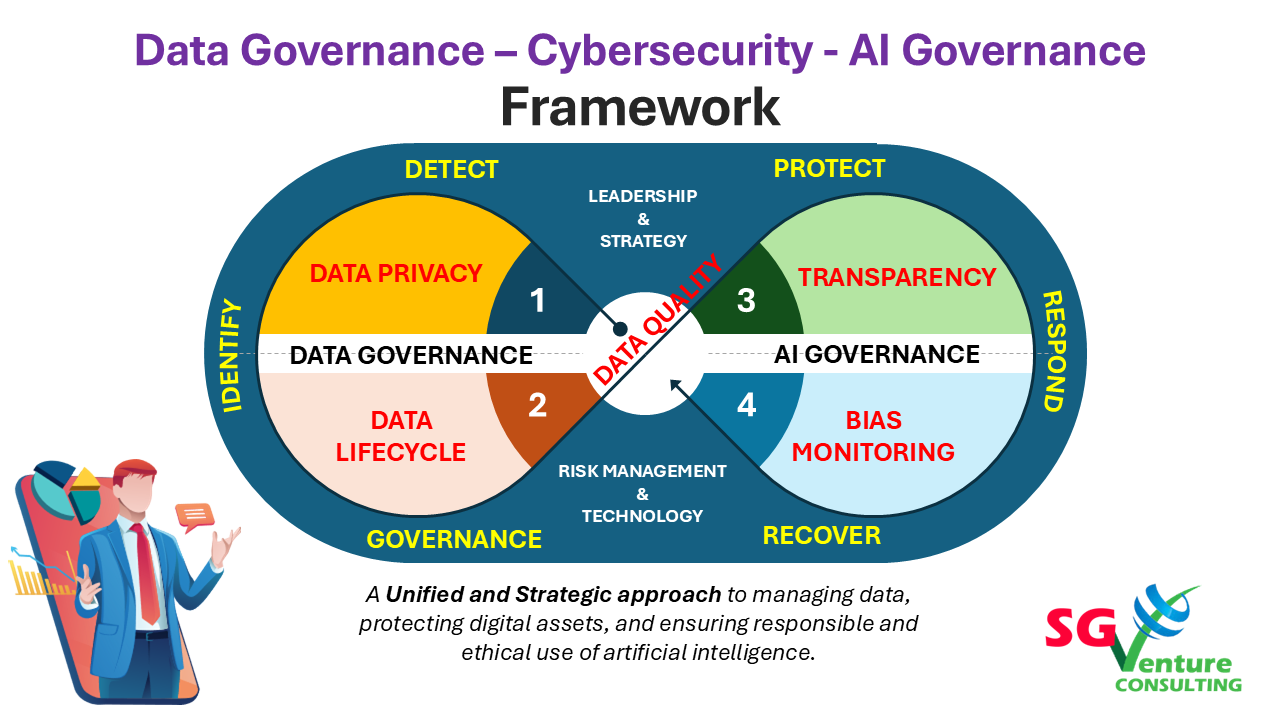
Основные термины и концепции
- PD (персональные данные) — любая информация, относящаяся к идентифицированному или идентифицируемому физическому лицу.
- Обезличивание (de-identification) — процесс удаления или трансформации PD таким образом, что идентификация лица становится чрезвычайно трудной или невозможной без дополнительных данных.
- Псевдонимизация (pseudonymization) — замена идентификаторов на псевдонимы (например, токены). Оставляет возможность восстановления данных через сопутствующий ключ или таблицу отображения, которая хранится отдельно и защищается.
- Анонимизация (anonymization) — трансформация PD таким образом, что идентификация лица становится невозможной даже при наличии внешних данных.
- Маскирование данных (data masking) — временная или постоянная замена чувствительных данных немагическими значениями, сохраняющими формат и полезность на уровне анализа.
- Форм-факторная криптография (FPE) — криптографическая техника, которая позволяет зашифровку данных так, чтобы их формат (напр., номера кредитных карт) сохранялся. Это полезно для аналитики и рабочих процессов без раскрытия PD.
- Дифференциальная приватность (Differential Privacy) — математический подход к защите приватности, который добавляет контролируемый уровень шума к результатам анализа.
- К-аномальность, L-диверситет, T-близость — концепции оценки риска переидентификации и информационной утечки в данных, используемые при обезличивании.
- Синтетические данные — автономно созданные данные, которые сохраняют статистическую структуру оригинала, но не содержат конкретных PD.
Три основных направления работы с PD в Data Governance:
- Обезличивание и маскирование: уменьшение риска при сохранении полезности данных.
- Псевдонимизация: снижение прямой идентифицируемости с возможностью восстановления по ключу при законных основаниях.
- Синтетика и дифференциальная приватность: обеспечение приватности на уровне публикации и аналитики.
Регуляторика и соответствие
- GDPR (RGPD) в Европе устанавливает, что PD не должна быть доступна без законного основания; при этом псевдонимизация — это полезная мера, но данные сохраняют риск переидентификации, если сопутствующая таблица отображения доступна.
- В России действует ФЗ-152 “О персональных данных” и связанные подзаконные акты. Обработчик PD должен обеспечивать безопасное хранение, контроль доступа, журналирование и локализацию при необходимости. Маскирование и обезличивание часто применяются как техники организации доступа и снижения риска.
- Для кросс-граничной передачи PD важно провести оценку соответствия и обеспечить соответствующие договоры и технические меры защиты.

Методологии и подходы к реализации
- Инвентаризация PD и классификация: какие поля содержат PD, какие поля премоделируются, какие связи между таблицами создают риск.
- Выбор уровня обезличивания: от простого маскирования до сложной демонстрации к-анонимности или FPE.
- Управление ключами и отображениями: хранение mappings в безопасном хранилище (Key Management System, Hardware Security Module).
- Оценка рисков переидентификации: использовать метрики к-анонимности/л-диверситета/т-близости, а также тестирование через атаки на данные.
- Верификация полезности: проверка, что аналитика после обезличивания по-прежнему даёт полезные результаты, например в сегментации клиентов или тренд-анализе.
- Жизненный цикл: от классификации PD до мониторинга использования данных и аудита.
Таблица: сравнение подходов к обезличиванию
| Методы | Что делает | Преимущества | Ограничения | Когда применять |
|---|---|---|---|---|
| Маскирование ( masking ) | Замена чувствительных значений на маски (например, ***) | Быстрое внедрение, сохраняет формат | Ограниченная аналитика, риск догадки по маске | Быстрая защита в отчётности, тестовые данные |
| Псевдонимизация | Замена PD на токены; связь хранится отдельно | Возможность восстановления при наличии доступа к ключам | Риск при компромете mapping | Внутренний доступ к PD под безопасным контролем |
| Анонимизация | Удаление идентификаторов, обобщение данных | Наиболее высокий уровень приватности | Потеря полезности, ограниченная аналитика | Публикация агрегированных данных |
| Форм-факторная криптография (FPE) | Шифрование с сохранением формата данных | Поддерживает формат, анализ без раскрытия PD | Не всегда выполнимо для всех типов данных | Обработки, где формат критичен (карты, телефоны) |
| Синтетика | Создание искусственных данных, имитирующих структуру данных | Высокий уровень приватности, публикация без PD | Модели могут быть сложны и требовать валидации | Публикации, демо-данные, обучение моделей |
Практические примеры
Пример 1: псевдонимизация идентификаторов в базе клиентов
Цель: заменить реальные идентификаторы клиентов (NAME, EMAIL) на псевдонимы, чтобы аналитика могла проводиться без прямой идентификации.
Подход: псевдонимизация с хранением отображения в безопасном KMS.
Инструменты: Python для генерации псевдонимов; ARX — для оценки риска переидентификации и экспертизы.
Шаги:
- Инвентаризация PD: какие поля требуют псевдонимизации.
-
Генерация псевдонимов:
- Используем salted hash для постоянного отображения.
- Храним mapping в отдельной защищённой БД (разделение доступа, аудит).
- Применение политики доступа: кто может восстанавливать оригинальные значения.
- Валидация: проверить, что аналитика по псевдонимизированным данным не требует оригинал.
Пример кода:
import hashlib
import os

# Безопасный соль
SALT = os.environ.get("PD_SALT", "default_salt")

def pseudonymize(value: str) -> str:
    h = hashlib.sha256((SALT + value).encode('utf-8')).hexdigest()
    return h

# Пример использования
original_email = "alice@example.com"
token = pseudonymize(original_email)
print("Псевдоним:", token)
Примечание: mappings (original_email -> token) должны храниться в зашифрованной таблице mapping, доступ к которой ограничен и аудитируем.
Пример 2: маскирование дат и местоположения для аналитики
Цель: сохранить аналитическую полезность, но скрыть точные PD.
Подход: обобщение даты рождения до возрастной группы; округление адреса до уровня района; маскирование точного времени.
Таблица обобщения:
| Показатель | Текущее значение | Обобщение | Пример после обработки |
|---|---|---|---|
| DOB | 1987-03-22 | Возраст 35-40 | Возрастная группа 35-39 |
| Адрес | Москва, ул. Ленина, д. 12 | Район: Центральный | Центральный округ |
Пример кода Python для обобщения возраста:
from datetime import date, datetime

def age_group(birth_date_str: str) -> str:
    birth_date = datetime.strptime(birth_date_str, "%Y-%m-%d").date()
    today = date.today()
    age = today.year - birth_date.year - ((today.month, today.day) < (birth_date.month, birth_date.day))
    # Простой диапазон
    lower = (age // 5) * 5
    upper = lower + 4
    return f"{lower}-{upper}"

print(age_group("1987-03-22"))  # "35-39"
Пример 3: анонимизация через ARX и оценка риска
ARX — это мощный инструмент для статистической защиты данных (анонимизация, к-анонимность, l-диверситет, t-близость). Он имеет GUI, но также поддерживает экспорт конфигураций и использование в CI/CD.
Шаги:
- Импортируйте набор данных в ARX.
- Выберите атрибуты: quasi-identifiers (QIDs) и сенситивные атрибуты.
- Примените техники обобщения или suppression для достижения требуемой защиты (например, k=5).
- Оцените риск переидентификации и полезность данных.
Примечание: ARX можно запускать как сервер или через GUI, что удобно для этапа пилотирования.
Пример 4: синтетические данные для обучения моделей
Цель: получить датасет без PD, но сохраняющий статистику оригинала.
- Подход: Synthetic Data Vault (SDV) — open-source инструмент для генерации синтетических данных.
- Преимущества: сохраняет распределения и корреляции между признаками; минимизирует риск раскрытия PD.
- Пример использования (концептуальный):
pip install sdv
from sdv.tabular import GaussianCopula
from sdv.metadata import SingleTableMetadata
import pandas as pd

# загрузить датасет с PD только в обезличенном виде
df = pd.read_csv("deidentified_dataset.csv")

metadata = SingleTableMetadata(schema={
    "columns": { "age": {"type": "numerical"},
                 "income": {"type": "numerical"},
                 "region": {"type": "categorical"},
                 "purchases": {"type": "numerical"}}
})

model = GaussianCopula(metadata)
model.fit(df)

synthetic = model.sample(1000)
synthetic.to_csv("synthetic_dataset.csv", index=False)
Хранение ключей, отображений и управление доступом
- Ключи и отображения (mapping) должны храниться в безопасном хранилище ключей (KMS) или HSM.
- Разграничение доступа: минимально достаточный доступ, разделение обязанностей (SoD).
- Журналирование доступа к mapping и к процессу обезличивания/псевдонимизации.
- Регулярная ротация ключей и аудит изменений.
Форм-факторная криптография (FPE)
FPE позволяет сохранить формат данных (например, номер карты начинается с той же цифры) после шифрования.
Примеры инструментов: библиотеки, реализующие FF1/FF3, такие как pyffx (Python) и другие реализации. Пример использования (псевдокод):
# Пример проектной интеграции FF1/FPE
# Требуется библиотека pyffx (установить pip install pyffx)
import pyffx

def fpe_encrypt(value, key, tweak=""):
    # предполагаем, что value — строка фиксированной длины, например, номер карты
    return pyffx.zip_ffx(value, key, tweak, radix=10)
Важно помнить: FPE не заменяет необходимость управлять правами доступа к исходной PD; это часть технического решения.
Дифференциальная приватность и качество данных
Дифференциальная приватность (DP) добавляет шум к агрегациям и обучающим запросам.
Практические замечания:
- Нужно правильно подбирать параметр ε (epsilon) — слишком большой шум ухудшает аналитическую полезность; слишком маленький — риск приватности.
- DP применяется в публикации агрегированных данных и статистических запросах, а не в индивидуальном анализе.
Вопросы совместимости и аудит
- Любое обезличивание должно сопровождаться тестами на регуляторную совместимость.
- Ведіть журнал аудита операций по обезличиванию: кто инициировал, какие данные подверглись обезличиванию, какие политики применялись.
- Риски, связанные с хранением отображения (mapping), должны учитываться: если mapping скомпрометирован, псевдонимизация теряет эффект.
Риски и ограничения внедрения
- Переидентификация: даже после обезличивания возможно восстановление идентичности, если сопоставления собираются из дополнительных источников.
- Ограничение полезности данных: чрезмерное обобщение снижает аналитическую ценность, ломает продуктивность моделей.
- Непосрочная соответствие регуляторным требованиям: псевдонимизация не всегда удаляет PD под GDPR, поскольку mapping может быть доступен.
- Сложность верификации: на практике трудно убедиться, что обезличивание не нарушает бизнес-цепочки и аналитические потребности.
- Технические затраты: внедрение KMS/HSM, управление ключами, процессы аудита, обучение сотрудников — это долгосрочные инвестиции.
- Риски при выборе инструментов: несовместимости между инструментами и требованиями организации; риск зависимости от стороннего ПО.
- Вопросы локализации: для российского рынка часто требуется локальная инфраструктура и соответствие отечественным требованиям по защите данных.
Выводы
- Обезличивание, псевдонимизация и анонимизация — это не одно и то же, и выбор подхода зависит от целей: публикации, аналитики, внутреннего использования или аудита.
- В большинстве случаев рекомендуется сочетать техники: псевдонимизация для оперативной аналитики внутри организации и анонимизация или синтетика для публикации внешних данных.
- Эффективное внедрение требует не только технических решений, но и организационных мер: управление ключами, аудит, контроль доступа, политики защиты данных и регулярную оценку риска.
- Open-source варианты (как ARX, sdcMicro, SDV) позволяют начать пилот без дорогого ПО, а российские решения и поставщики информационной безопасности могут дополнить DLP/маскированием в рамках корпоративной инфраструктуры.
- Важно помнить регуляторную составляющую: псевдонимизация не освобождает от ответственности; анонимизация — наиболее строгий уровень защиты — может повлиять на полезность данных, поэтому выбор метода должен быть стратегическим и документированным.
FAQ (Часто задаваемые вопросы)
1) Что такое обезличивание и чем оно отличается от псевдонимизации?
- Обезличивание — процесс удаления или трансформации PD таким образом, чтобы идентифицировать человека было невозможно без дополнительных данных. Псевдонимизация — замена PD на псевдонимы (токены), при этом сопутствующая таблица отображения хранится отдельно и может привести к восстановлению исходных данных при наличии доступа к ключам. Разница в том, что обезличивание чаще всего приводит к анонимности, тогда как псевдонимизация сохраняет возможность восстановления.
2) Как выбрать метод обезличивания для аналитики?
- Начните с оценки цели: если нужна публикация статистики без риска раскрытия PD — анонимизация или синтетика. Для внутренней аналитики, где возможно ограничение доступа — псевдонимизация с защитой изображения x mapping. Для сохранения форматов данных и удобной аналитики — FPE и маскирование. Используйте комбинацию: маскирование для оперативных процессов, FPE для форматных данных, синтез для публикаций.
3) Какие регуляторы и требования влияют на выбор методов?
- GDPR/ RGPD в Европе и ФЗ-152 в России устанавливают требования к защите PD. Псевдонимизация снижает риск, но не устраняет регуляторный контроль, если отображение хранится внутри организации. Анонимизация может исключать PD из состава обрабатываемых данных, но может ограничить полезность данных.
4) Какие инструменты лучше использовать в открытом доступе?
- ARX Data Anonymization Tool (Java) для оценки риска и настройки обезличивания.
- sdcMicro (R) для статистической защиты от скрытой идентификации.
- SDV (Synthetic Data Vault) для генерации синтетических данных, пригодных для обучения моделей.
- diffprivlib (IBM) для внедрения дифференциальной приватности в аналитическую нагрузку.
5) Какие отечественные решения помогут внедрить маскирование в инфраструктуру?
- Российские поставщики информационной безопасности предлагают DLP и маскирование как часть комплексных решений для защиты данных внутри организации. Примеры включают решения крупного российского рынка по DLP и маскированию в рамках инфраструктуры информационной безопасности. Важна детальная оценка соответствия требованиям, интеграции с существующими процессами, а также обеспечение локализации хранения данных и аудита.
6) Какие есть риски переидентификации после обезличивания?
- Ключевые риски возникают при наличии внешних наборов данных и слабой обособленности атрибутов. Методы к-анонимности, l-диверситет и t-близость помогают снизить риск, но не исключают его полностью. Регулярная проверка риска и обновление политики обезличивания необходимы.
7) Как хранить и защищать отображения (mapping) между PD и псевдонимами?
- Важно хранить mappings в отдельном, защищенном хранилище ключей (KMS/HSM), с ограниченным доступом, строгой политикой доступа, аудитом и шифрованием покоя. Механизмы ротации ключей должны быть автоматизированы и задокументированы.
8) Можно ли использовать синтетические данные для аналитики?
- Да. Синтетика позволяет публиковать данные без PD и сохранять релевантные статистические свойства. Важно валидировать, что синтетические данные сохраняют необходимые корреляции и распределения, чтобы аналитика не была искажена.
9) Что такое дифференциальная приватность и зачем она нужна?
- Дифференциальная приватность добавляет контролируемый шум к агрегированным ответам на запросы к базе данных. Это уменьшает риск раскрытия PD при публикациях и аналитике. Ее применение требует настройки параметра ε и систематической проверки влияния шума на результаты.
10) Как внедрять процесс обезличивания в компанию? Рекомендованный подход:
- Проведите инвентаризацию PD и классификацию QID-полей.
- Определите целевые уровни защиты: псевдонимизация для внутреннего использования, анонимизация или синтетика для публикаций.
- Выберите инструменты и методы в соответствии с требованиями регулятора и бизнес-целями.
- Создайте безопасную архитектуру хранения mappings и ключей, настройте контроль доступа и аудит.
- Помните о поддержке жизненного цикла данных: обновления данных, переработка PD, повторная оценка риска.
- Проведите пилот и итоговую верификацию полезности данных на реальных сценариях.


