

Практические кейсы: страховые компании - Solvency II и регуляторные отчеты
Страховые компании сталкиваются с необходимостью преобразовать внутренние данные в структурированную форму регуляторной отчетности. XBRL-архитектура здесь выступает как связующее звено между учетной/G/L-логикой, различными системами сбора данных и требованиями регулятора по Solvency II. В данной главе рассматриваются практические решения по проектированию, развертыванию и эксплуатации архитектуры XBRL-отчетности в страховании: от определения контура данных и выбора подходящих таксономий до реализации конвейера валидации и сдачи регуляторных форм. Особое внимание уделяется кейсам страховых компаний, где Solvency II требует точной привязки фактов к контекстам, единицам измерения и бизнес-правилам в рамках единого конвейера.
Во вводном разделе обозначим цели: обеспечить надежную и повторяемую генерацию регуляторных документов, снизить риск ошибок при соответствии требованиям регулятора и повысить скорость реагирования на изменения в Taxonomy и регуляторных правилах. Далее перейдем к практическим архитектурным решениям, их обоснованию и конкретным шагам внедрения в страховой доменной среде.
- Краткое содержание главы
- Архитектура данных и конвейеров XBRL-отчетности под Solvency II: модель данных, контексты и единицы, связь с Taxonomy
- Интеграционные протоколы и обмен данными: источники данных, конвертация, загрузка и подача в регуляторную систему
- Валидация, контроль качества и соответствие: набор проверок, формулы и регламентные требования
- Реализация инфраструктурного стека: сервисы, инфраструктура, безопасность, мониторинг
- Практические кейсы и уроки внедрения: миграции, эволюционные разворачивания, риски и меры минимизации
Архитектурная модель XBRL-отчета для страхования под Solvency II
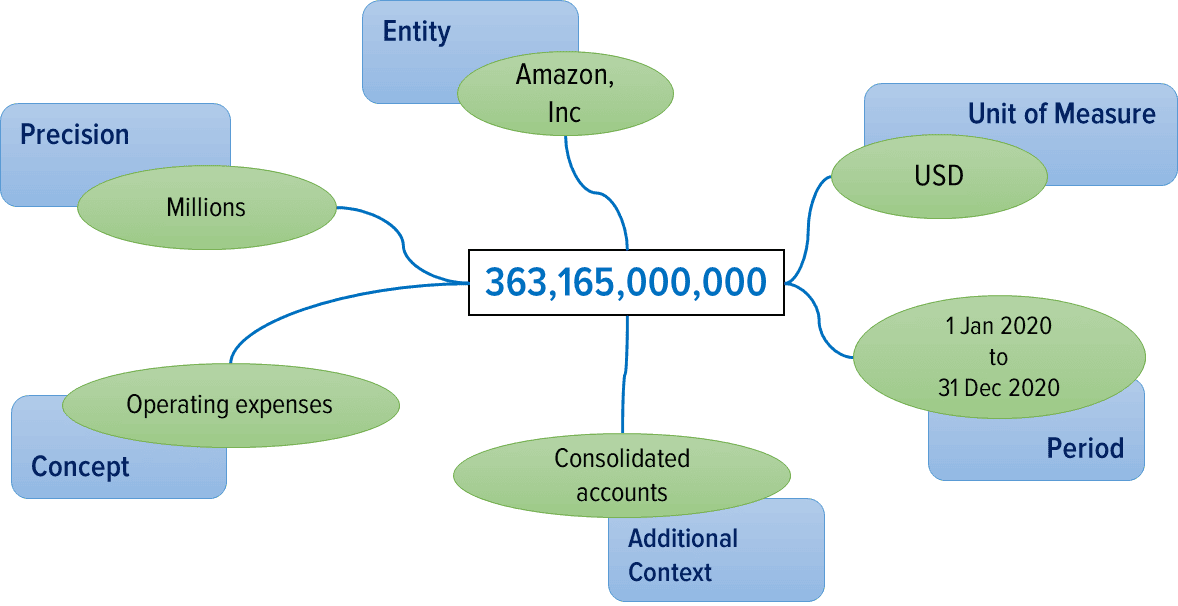
Архитектура XBRL-отчета строится вокруг концепции единого канала данных, который обеспечивает непрерывность и детерминированность трансформаций. В рамках Solvency II регулятор требует представления финансовой информации, корпоративного риска и финансового положения в формате, соответствующем Taxonomy, с привязкой к контекстам, периодам и единицам измерения. Главная задача архитектуры - превратить распределенные данные в согласованные XBRL-экземпляры и корректно упаковать их для подачи.
Ключевые компоненты архитектуры:
- Источники данных и Хранилища: ERP, финансовый учет, GL-системы, системы управления активами и рисками, страховые расчеты, актуарии и CAL-модели. Данные приходят в canonical data model (CDM), который служит единым базовым слоем для трансформаций.
- Слой сопоставления (Mapping): правила соответствия между внутренними элементами и концепциями Taxonomy. Включает маппинг линейных и нетто-показателей, резервов, технических обязательств и коэффициентов.
- Таксономия и расширения: базовая Solvency II taxonomy, возможно расширение под ЭДО или локальные требования. Поддерживаются обновления Taxonomy и переходы на новые версии.
- Генератор XBRL-экземпляров: конструирование документной модели на основе контекстов, единиц, измеряемых факторов и фактов (facts). Обеспечивает корректную последовательность и валидность структуры документа.
- Валидация и контроль качества: синтаксическая проверка схем, контроль связей между контекстами и фактами, бизнес-правила и префильтрация ошибок. Реализация интегрированной цепочки тестирования.
- Пакетирование и сдача: формирование пакетов для загрузки в регуляторную систему или portal, поддержка iXBRL-форматов для удобной верификации регулятором, журнал аудита и отслеживание статуса сдачи.
- Безопасность, аудит и управление изменениями: разграничение прав доступа, подписывание документов, хранение версий Taxonomy и XML-экземпляров, аудит операций.
Почему именно такая структура? Потому что Solvency II требует не только корректного набора фактов, но и строжайшей привязки к контекстам (период, валюты, юрисдикции), к точному соответствию концепций и единиц измерения. В этом контексте canonical data model играет роль «языка согласования» между системами банка/страховой компании и регуляторной Taxonomy. Для устойчивости решения необходимы модульность и четкая граница ответственности между слоями: данные → сопоставление → создание экземпляров XBRL → валидация → сдача.
## Пример концептуального потока сопоставления
## (псевдокод, демонстрирует идею трансформации данных в факты XBRL)
def map_to_taxonomy(source_record, taxonomy_concepts):
    context = create_context(period=source_record.report_period,
                             entity_id=source_record.entity_id)
    unit = select_unit(source_record.value_unit)
    concept_id = taxonomy_concepts.lookup(source_record.label)

    fact = {
        "context": context.id,
        "unit": unit,
        "concept": concept_id,
        "value": source_record.value
    }
    return fact
В реальном проекте код будет развёрнут в сервисах на Java/.NET/Python, но принцип остается единым: привести внутреннее представление к набору фактов, которые соответствуют Taxonomy и контекстам, а затем сгенерировать экземпляр XBRL внутри безопасного конвейера.
Технологический стек и интерфейсы
Для страховых компаний важна не только корректная логика отображения, но и способность масштабироваться, обновляться и интегрироваться с регуляторными порталами. В архитектуре под Solvency II рекомендуется следующий набор технологий и интерфейсов:
- Базовый стек данных: реляционные базы данных для учетной и финансовой информации, data lake/warehouse для «сырьевых» данных и агрегатов, каноническая модель данных для трансформаций.
- Этапы ETL/ELT: консолидированные потоки загрузки данных, нормализация, сопоставление и агрегации. В качестве инструментов часто применяются облачные сервисы или локальные решения SSIS/Matillion/Airflow, с упором на повторяемость и версионирование конверсионных правил.
- Обмен сообщениями и интеграции: брокеры сообщений (Kafka, RabbitMQ) для обеспечения буферизации и последовательности обработки данных, API-шлюзы для управления запросами к Taxonomy Manager и генераторам экземпляров.
- Таксономия и процессоры XBRL: open-source или коммерческие решения для работы с Taxonomy, валидации и подготовки документов. Вендорские варианты часто предоставляют готовые коннекторы к Taxonomy, валидацию линкбейс и поддержку iXBRL.
- Генератор экземпляров XBRL: сервис, отвечающий за сборку контекстов, единиц и фактов, формирование XBRL/XML, поддержка inline-форматов при необходимости.
- Валидация и регуляторные проверки: локальные и регуляторные валидации, формулы и базовые проверки, управление состоянием документа (черновик/готовo к сдаче).
- Безопасность и аудить: аутентификация/авторизация, роль-based access control, подпись документов, журнал изменений Taxonomy и экземпляров, хранение версий.
- Мониторинг и эксплуатация: сбор метрик конвейера, SLA-метрики, логи ошибок, alerting на этапах конвейера, CI/CD для обновлений Taxonomy и конверсионных правил.
Интеграционные сценарии здесь обычно соответствуют нескольким паттернам:
- Паттерн «данные → сопоставление → экземпляры» через централизованный конвейер, где каждый шаг выполняется как независимый сервис с тестами и версионированием.
- Паттерн «поставщик данных в регулятор» через API-гейтвей и отдельный пакет сдачи, с поддержкой пакетной отправки и онлайн-генерации, если регулятор позволяет.
- Паттерн «gather-validate-submit» с возможностью отката на любой стадии конвейера и механизмом уведомлений об ошибках или изменениях Taxonomy.
Пример распределения обязанностей между сервисами:
- Taxonomy Manager: хранение и версия Taxonomy, обработка обновлений, маппинг концепций.
- Instance Generator: сборка XBRL-экземпляров из фактов и контекстов.
- Validation Service: последовательная валидация по схеме, линк-базам и бизнес-правилам.
- Submission Service: упаковка, подача и возврат статуса, журнал аудита.
- Data Integration Layer: источники данных, трансформации, синхронизация CDM.
## Пример минимального XML-фрагмента XBRL-экземпляра (упрощено)


      INS-0001


      2024-12-31


    iso4217:EUR

  123456.78
Если регулятор поддерживает Inline XBRL (iXBRL), возможна оптимизация для просмотра регулятором, но сам конвейер чаще строится вокруг чистого XBRL-сигнала и отдельного слоя для визуализации.
Валидация, контроль качества и соблюдение требований
Ключевым компонентом является надежная валидация: от синтаксической проверки XML до бизнес-правил, которые затрагивают соответствие контекстов и единиц. В рамках Solvency II валидация должна охватывать:
- Синтаксическую корректность XBRL-экземпляра и соответствие схемам Taxonomy.
- Корректность контекстов: период, юрисдикция, идентификатор организация, валюты.
- Единицы измерения: удостовериться, что для каждого факта применима правильная единица измерения и масштабы.
- Связи между концепциями и фантомными связями: проверки линкбейс и использование формул, если регулятор поддерживает формулы в рамках процесса валидации.
- Внутренние бизнес-правила: соответствие бизнес-архитектуре, распределение резервов, маржинальных элементов, рисков.
- Регуляторные спецификации: сверка с требованиями по конкретным QRT-блокам и структурам для Solvency II.
Гибкость конвейера достигается за счет модульной структуры тестов и версионирования правил. Часто используется набор тест-кейсов, соответствующих типовым сценариям: полный годовой выпуск, частичная подача после изменения Taxonomy, миграция с устаревших версий Taxonomy, обработка ошибок и повторной подачи. Важна возможность отката на предыдущую версию, чтобы регулятор мог проверить корректность изменений до сдачи.
## Пример упрощенного псевдокода валидации контекста
def validate_context(context, taxonomy):
    if context.period not in taxonomy.allowed_periods:
        raise ValidationError("Period not allowed by taxonomy")
    if context.entity_id_scheme not in taxonomy.allowed_entity_schemes:
        raise ValidationError("Entity identifier scheme invalid")
    return True
Для повышения эффективности применяются автоматизированные тесты на уровне CI/CD, которые запускают синтаксическую валидацию XML и базовые бизнес-правила при каждом коммите. Важно поддерживать возможность “горячих правок” без полного разворачивания окружения и иметь единый журнал изменений Taxonomy с трассируемостью изменений по версиям.
Реализация инфраструктурного стека: сервисы, безопасность и управление изменениями
Реализация архитектуры требует устойчивого инфраструктурного окружения: контейнеризация сервисов, оркестрация и мониторинг. Рекомендованный набор практик:
- Контейнеризация микросервисной архитектуры: каждый компонент (Taxonomy Manager, Instance Generator, Validation Service, Submission Service) разворачивается как независимый контейнер, что упрощает масштабирование и обновления.
- Оркестрация: Kubernetes или аналогичная платформа для управления масштабируемостью, обновлениями и отказоустойчивостью.
- CI/CD: автоматизация сборки, тестирования и разворачивания обновлений Taxonomy и сопутствующих правил. Включает контроль версий, миграции схем и откаты.
- Безопасность: применение TLS, ограничение доступа по ролям, подпись документов, контроль изменений Taxonomy и логирование доступа к данным.
- Мониторинг и управляемость: сбор метрик конвейера, SLA-метрики, алертинг по задержкам на стадиях конвейера, журнал аудита и dashboards для регуляторной отчётности.
- Архитектура данных: прозрачный контроль версий CDM, карты соответствий и миграционные скрипты, позволяющие мигрировать данные при обновлениях Taxonomy.
Как правило, в страховой компании внедряют слои безопасности и аудита на уровне каждого сервиса, создавая единый реестр версий Taxonomy и конфигураций трансформаций с поддержкой отката. Для регулятора критически важно, чтобы цепочка сдачи была воспроизводимой, с возможностью трассирования источников фактов и изменений по версии Taxonomy.
Практические кейсы и уроки внедрения
Кейс 1: Миграция на новую версию Solvency II Taxonomy в крупной страховой компании
- Проблема: необходимость перехода на новую версию Taxonomy без остановки регуляторной сдачи.
- Решение: введение отдельного слоя-«адаптера» между существующим конвейером и Taxonomy Manager, поддержка параллельной обработки обеих версий Taxonomy, ретроспективная перепроверка данных.
- Результат: минимальное downtime, ускорение обновления правил в регуляторной части, снижение рисков несовпадения концепций между старыми и новыми версиями.
Кейс 2: Модернизация инфраструктуры подачи регуляторной отчетности
- Проблема: старые процессы сдачи через FTP и пакетную подачу не соответствуют требованиям к скорости.
- Решение: переход к API-подаче через безопасный канал, внедрение событийного конвейера и очередь сообщений для сборки и проверки в реальном времени.
- Результат: уменьшение времени прохождения контура от данных до подачи, повышенная прозрачность статусов сдачи, улучшенная возможность для регулятора реагировать на изменения.
Кейс 3: Валидация бизнес-правил в контексте Solvency II
- Проблема: регулятор требует не только корректности структуры, но и соответствия бизнес-правил по страховым резервам и рискам.
- Решение: внедрение набора формул и проверок в Validation Service, тесная интеграция с актуарскими моделями и системами управления рисками.
- Результат: более детальная проверка на ранних стадиях конвейера, снижение количества ошибок при сдаче.
Кейс 4: Интеграция с внешними данными и налоговыми требованиями
- Проблема: часть данных, необходимых для Solvency II, поступает из внешних систем и в рамках налогово-уровневой отчетности.
- Решение: унификация стандартов обмена, внедрение консолидированной модели данных и взаимодействие через унифицированные API для внутренних и регуляторных акторов.
- Результат: повысилась точность и полнота данных, улучшено управление изменениями.
Уроки, вытекающие из кейсов:
- Ясная граница ответственности между слоями архитектуры и модульность критически важны для масштабирования и адаптации к новым требованиям.
- Контроль версий Taxonomy и регулярная отправка обновлений должны быть встроены в процесс CI/CD, чтобы регулятор мог оценивать совместимость в реальном времени.
- Валидация должна быть неотъемлемой частью конвейера, а не финальным этапом; ранняя фиксация ошибок снижает риски повторной подачи.
- Безопасность передачи и хранения регуляторной отчетности должна быть сквозной и соответствовать требованиям безопасности.
- Для регуляторной отчетности полезно предусмотреть две параллельные версии Taxonomy на период перехода, чтобы обеспечить uninterrupted сдачу.
Key takeaways
- Архитектура XBRL-отчетности в страховании должна строиться вокруг единообразного канала данных, контекстов и единиц измерения, соответствующих Taxonomy Solvency II.
- Модульная и версионируемая инфраструктура упрощает внедрения новых версий Taxonomy и изменений регуляторных требований.
- Валидация на каждом этапе конвейера критически важна: синтаксис, контексты, единицы и бизнес-правила должны проходить тестирование до сдачи регулятору.
- Интеграции требуют устойчивого стека: конвейер данных, брокеры сообщений, API-шлюзы и безопасные каналы передачи.
- Практические кейсы демонстрируют важность планирования миграций, контроля версий и минимизации downtime при обновлениях Taxonomy.
- Open-source решения типа Arelle могут служить опорой для обработки XBRL, но их интеграция требует аккуратной адаптации под локальные регуляторные требования.
- Эффективная стратегия внедрения включает CI/CD, мониторинг конвейера и продуманную политику аудита и подписания документов.
FAQ
- Что именно представляет собой Solvency II в контексте XBRL-отчетности?
Solvency II - это рамки регуляторной отчетности для страховых компаний в Европейском союзе, где требования к представлению финансовых и рисковых данных в формате, совместимом с Taxonomy и XBRL. В контексте XBRL-отчетности это означает точное сопоставление внутренних данных с концепциями Taxonomy, привязку фактов к контекстам, единицам измерения и периодам, а также формирование корректных экземпляров XBRL для сдачи регулятору. Архитектура должна обеспечить не только корректность, но и повторяемость процессов и возможность обновления под новые версии Taxonomy.
- Какие ключевые концепции Taxonomy важны для Solvency II?
Ключевые концепции включают блоки, соответствующие активам и пассивам, резервам, рискам, расчетам риска и капиталу. В контексте XBRL важно обеспечить соответствие каждого факта конкретной концепции Taxonomy, корректную привязку к контексту (периоду, сущности и единице измерения) и правильное использование единиц (например, валюты). Расширения Taxonomy могут понадобиться для локальных требований, но они должны быть документированы и совместимы с базовой Taxonomy SOLVENCY II.
- Как обеспечить надежную интеграцию источников данных в цельную XBRL-отчетность?
Необходимо внедрить canonical data model (CDM) как единый слой данных, который унифицирует данные из разных систем (финансовый учет, риск, активы/обязательства, резервы, актуарии). Из CDM выполняются трансформации в факты XBRL по правилам сопоставления, что минимизирует дублирование логики и облегчает обновления при изменении Taxonomy. Интеграционные паттерны включают конвейеры данных, очереди сообщений и API-гейтвей, обеспечивающие детерминированную и повторяемую подачу.
- Какие подходы к валидации применимы в Solvency II-отчетности?
Подходы включают синтаксическую валидацию XML/Schema, проверку контекстов на соответствие периодов и единицам, тесты на соответствие линкбэйсам и бизнес-правилам, а также регуляторные проверки по конкретным блокам (QRT). Важно, чтобы валидация была модульной и имела возможность повторной проверки после обновления Taxonomy или правил. Рекомендуется автоматизация тестов в CI/CD и поддержка откатов на прошлые версии Taxonomy.
- Какой технологический стек предпочтителен для реализации?
Рекомендуется модульная архитектура с контейнеризацией и оркестрацией (например, Kubernetes), сотрудничество между Taxonomy Manager, Instance Generator, Validation Service и Submission Service, использование брокеров сообщений для устойчивого конвейера и CI/CD-пайплайнов для обновления Taxonomy. В части open-source решений можно рассмотреть Arelle как движок обработки XBRL, но интеграция требует адаптации под требования регулятора и локальных правил.
- Какие риски наиболее критичны при реализации?
Критические риски включают неправильный маппинг концепций Taxonomy к внутренним данным, ошибки в контекстах и единицах, задержки в обновлениях Taxonomy, сложности с миграцией между версиями Taxonomy, а также риски безопасности и аудита данных. Управление этими рисками требует четкой регламентации процессов обновления Taxonomy, тестирования на жизненном конвейере, а также политики обеспечения безопасной сдачи и доступа к данным.
- Как минимизировать downtime при миграции Taxonomy?
Рекомендовано внедрять параллельную обработку двух версий Taxonomy: старой и новой, с отложенной конвертацией данных и параллельной сдачей, чтобы регулятор мог проверить корректность новой версии до полного перехода. Можно использовать «адаптер»-слой или версионированные конвейеры, позволяющие откатываться к старой версии без потери данных и времени на восстановление.
- Какие открытые инструменты стоит рассмотреть для старта?
Open-source инструмент Arelle может стать основой для обработки XBRL и тестирования соответствия Taxonomy. Важна интеграция с внутренними потоками данных и регуляторными требованиями, поэтому инструмент должен быть адаптирован под локальные правила, иметь поддержку обновлений Taxonomy и возможность расширения под ваши сценарии. Для регуляторной сдачи можно рассмотреть готовые коннекторы к XML-бакам регулятора, если они доступны в вашей юрисдикции.
- Как измерять успешность проекта XBRL-архитектуры под Solvency II?
Успех можно измерить по нескольким направлениям: точности сдачи (количество прохождений без ошибок), скорости конвейера (время от источника данных до сдачи), гибкости в отношении обновлений Taxonomy, уровню автоматизации в тестировании и аудите, а также устойчивости к изменениям регуляторных требований. Важно иметь прозрачный набор KPI на уровне каждого сервиса и конвейера.
- Какие организационные изменения сопровождают переход к XBRL-отчетности?
Необходима формализация ролей вокруг Taxonomy management, архитектуры данных, процессов валидации и подачи. Важно обеспечить взаимодействие между такими подразделениями, как финансовый учет, риск-менеджмент, ИТ-архитектура и комплаенс. Внедрение DevOps-подходов, расширение компетенций по XBRL и Taxonomy, а также обучение сотрудников по новым регуляторным требованиям способствуют устойчивому успеху проекта.


