

Валидаторы и проверки XBRL: формулы, расчеты, связность и качественные проверки
Формирование качественной регуляторной отчетности по XBRL требует не только корректной загрузки фактов, но и последовательной, надёжной и воспроизводимой проверки данных на всех этапах цикла отчетности. Валидаторы XBRL выступают в роли связующего звена между Taxonomy, Linkbases и фактическими данными, обеспечивая корректность формул, расчётов и связей между элементами. В банковской и страховой индустриях такие проверки становятся критически важными: регуляторы требуют прозрачности, а бизнес - устойчивости к изменениям в стандартах и множеству регуляторных требований. Глава рассматривает архитектурные принципы построения валидаторов, подходы к реализации формул и расчётов, механизмы обеспечения связности и качества данных, а также практические рекомендации по внедрению в крупные IT-ландшафты.
В рамках курса выделяется три основные аспекта: архитектура валидаторов, технические подходы к реализации формул и расчётов, а также качество данных и управленческие процессы. Предложенная схема охватывает как концептуальные основы, так и практические элементы внедрения: от выбора протоколов обмена и механизмов интеграции с существующими источниками данных до организации тестирования формул и мониторинга качества.
- Краткое содержание главы
- Архитектура валидаторов XBRL: слои, взаимодействие и управляемые процессы.
- Типы проверок: формулы, расчеты, связность и качественные проверки, их принципы и методы реализации.
- Интеграционные и эксплуатационные аспекты: протоколы, рынок инструментов, тестовая среда и операционный цикл.
- Практические архитектурные решения и примеры внедрения в банковской и страховой области.
Архитектура валидаторов XBRL
Архитектура валидаторов XBRL строится вокруг разделения ответственности между слоями обработки, управления правилами и обеспечения качества. Центральной является движок валидации, который принимает на вход XBRL-экземпляр (instance document) и Taxonomy/Linkbases, выполняет линковку сущностей и далее применяет сформулированные правила. Важнейшей задачей является обеспечение воспроизводимости и управляемости: каждая проверка должна иметь детальный журнал (audit trail), версионность правил и возможность повторного запуска в изолированной среде.
Основные слои
- Ингестинг и нормализация данных. На этом слое происходит загрузка инстансов XBRL, терминологий Taxonomy и вспомогательных файлов (linkbases). Важна детальная нормализация форматов, привязка прецедентов и единиц измерения, а также проверка целостности входных файлов.
- Управление формулами и правилами. В категорию попадают формулы XBRL Formula, а также пользовательские правила на уровне данных (проверки на полноту, уникальность, диапазоны значений). Хранилище правил должно поддерживать версионирование, откат и тестовую среду.
- Валидация факт-данных и расчёты. Сердце движка - модуль проверки фактов и их связей через Calculation Linkbase. Здесь реализуется Evaluation Engine, который обрабатывает правила, находит зависимости между фактами и вычисляет агрегаты.
- Контекст, единицы измерения и связность. Этот слой отвечает за корректную интерпретацию фактов с учётом контекстов (temporal, entity) и единиц измерения, а также за контроль связности между элементами Taxonomy и Linkbases: прямая и косвенная связность между концептами, измерениями и единицами.
- Отчётность и журнал ошибок. По итогам проверки формируются отчёты об ошибках, предупреждениях и статусе прохождения валидации. Журнал должен быть детализированным и позволять трассировать причину ошибки в контексте Taxonomy и инстанса.
- Мониторинг, аудит и безопасность. Включает журналы доступа, контроль изменений правил, защиту от несанкционированного доступа к данным и поддержание цепочки доверия к источникам Taxonomy и Linkbases.
- Интеграционные интерфейсы. Взаимодействие с внешними системами через API, очереди сообщений и обмен файлами. Важна поддержка форматов XML/JSON, протоколов REST и безопасных каналов коммуникации.
Компоненты валидатора и их взаимодействие
- Правилник (Rule Catalog). Центральный регистр формул и качественных правил с версионированием и описанием предназначения. Он обеспечивает единообразие проверок и упрощает тестирование.
- Формульный движок. Выполняет чистовую интерпретацию формул XBRL на данных экземпляра. В случаях сложной логики допускается частичное параллелирование по разделам Taxonomy или по контекстам.
- Движок расчётов. Реализация Calculation Linkbase: проверка и верификация агрегатов между элементами, обеспечение согласованности между родительскими и дочерними значениями.
- Трактователь связности. Проверяет корректность ссылок между элементами Taxonomy, контекстами, единицами и связями между группами фактов.
- Генератор ошибок и отчётов. Превращает результаты в понятные регулятору и бизнес-пользователям сообщения с указанием происхождения ошибки.
- Платформа интеграции и оркестрации. Обеспечивает передачу данных между источниками, расписание и мониторинг выполнения, обработку ошибок и повторные запуски.
- Репозиторий данных и аналитика. Хранение результатов, версий правил и метаданных: версии Taxonomy, версии инстансов, версии правил, метрики качества.
Принципы реализации и развития
- Версионность и совместимость. Правила и формулы должны быть привязаны к конкретной версии Taxonomy. Любые изменения должны сопровождаться регламентированным процессом тестирования и миграции.
- Тесты и среда снапшотов. Наличие изолированного тестового окружения, где можно запускать регрессионные тесты на валидаторах с заранее заданными примерами ошибок и граничных сценариев.
- Модульность и расширяемость. Архитектура должна позволять добавлять новые правила, дополнительные источники данных и новые форматы инстансов без воздействия на существующие пайплайны.
- Производительность и масштабирование. Валидаторы должны эффективно работать в условиях большого объёма данных, поддерживать параллельную обработку и кэширование Taxonomy/Linkbase для ускорения повторных запусков.
Примеры технологий и подходов
- В качестве открытой базы для обработки XBRL можно использовать популярный открытый процессор Arelle, который поддерживает загрузку Taxonomy, валидацию инстансов и базовую формулу-движку. Это даёт получателю базовую устойчивость к изменениям форматов и регуляторным требованиям, а также возможность расширения через собственные модули.
- Для оркестрации процессов можно применить подходы на базе современных рабочих потоков: оркестраторы данных (например, orchestration-системы или контейнерные решения) позволяют организовать цепочку от загрузки инстансов до формирования отчётов и уведомлений.
Типы проверок: формулы, расчеты, связность и качественные проверки
Проверки XBRL можно разделить на несколько взаимодополняющих категорий: формулы, расчеты, связность и качественные проверки. Каждая категория выполняет свою роль в обеспечении целостности регуляторной отчетности и требует соответствующего подхода к реализации.
Формулы XBRL
Формулы применяются к инстансам для проверки бизнес-логики и регуляторных правил. Они могут зависеть от контекстов, диапазонов и взаимосвязей между фактами. Основные принципы: детализировать правила до минимальной доли ошибок, обеспечивать объяснимость результата и поддерживать тестовую инфраструктуру для регрессионного тестирования каждого изменения.
Архитектурно формульный модуль делает следующее:
- загружает определения переменных и констант из Rule Catalog и привязывает их к фактам инстанса;
- обрабатывает временные контексты и пространственные ограничения, если формула зависит от периода, сектора или подразделения;
- регистрирует выходные сообщения с указанием конкретной проверки и места ошибки в Taxonomy и инстансе.
/* Псевдокод: базовая проверка на неотрицательность выручки */
IF Revenue.contextRef IN (ctx_financial) AND Revenue.value >= 0 THEN PASS
ELSE REPORT_ERROR("Revenue must be non-negative for ctx_financial")
Ключевые аспекты реализации:
- точная идентификация входных переменных. Переменные должны быть явно объявлены и связаны с конкретными концептами Taxonomy.
- управляемость ошибок. Сообщения должны содержать контекст, ссылку на правила и идентификатор факта.
- тестируемость. Формулы должны иметь набор тестов, покрывающих нормальные случаи, крайние значения и невалидные данные.
Расчеты
Расчёты проверяют согласованность между фактами и их агрегатами через Calculation Linkbase. Здесь важно не просто проверить отдельные значения, но и соответствие сумм, долей и коэффициентов между элементами, а также корректность агрегирования в рамках контекстов.
Ключевые принципы:
- корректность агрегирования. Все суммы и доли должны следовать указанной иерархии и правилам Taxonomy.
- предотвращение дублирования. Повторные значения не должны создавать противоречивые выводы, поэтому необходима нормализация идентификаторов фактов.
- зависимость от контекста. Расчёты могут зависеть от региона, временного периода или сегмента, поэтому контекст должен являться частью вычисления.
Связность
Связность обеспечивает, что данные согласованы между Taxonomy, Linkbases и фактическими данными. Сюда относятся проверки следующих аспектов:
- единицы измерения. У каждого концепта должна быть валидная единица; несоответствие единиц между связанными элементами приводит к некорректной интерпретации значений.
- соответствие контекстов. Факты должны попадать в адекватные контексты и периоды; несоответствия должны приводить к предупреждениям или ошибкам.
- целостность ссылок. Проверяется, что все ссылки между концептами, группами и измерениями корректны и не ведут к «битым» или устаревшим ссылкам.
Эти проверки часто требуют кросс-платформенного подхода: совместное использование Taxonomy-версий, контроль версий Linkbases и мониторинг изменений в составах инстансов по периодам.
Качественные проверки
Качественные проверки охватывают полноту и согласованность данных, помимо формализованных правил. Примеры включают:
- полнота данных. Наличие всех требуемых фактов для заданного набора контекстов и сегментов.
- устойчивость к аномалиям. Обнаружение редких или некорректных значений, которые могут свидетельствовать о проблемах в источнике данных или неправильной миграции.
- дублирование и уникальность. Поиск повторяющихся записей, которые могут искажать итоги.
- устойчивость к регуляторной изменчивости. Обеспечение возможности быстрой адаптации к новым регламентам без разрушения существующих пайплайнов.
Обеспечить качественные проверки можно через сочетание правилам и качественных скриптов на уровне данных, а также через автоматическое тестирование изменений в Taxonomy и Linkbases до их применения в продуктивной среде.
Интеграционные и эксплуатационные аспекты
Эффективная реализация валидаторов требует тесной интеграции с источниками данных, Taxonomy и существующими платформами предприятия. Ключевые направления включают обмен данными, безопасный доступ к ресурсам и управление версиями.
- Протоколы и каналы обмена. В зависимости от архитектуры организация может использовать REST API для запросов на валидацию, очереди сообщений (Kafka, RabbitMQ) для передачи инстансов и уведомлений, а также обмен файлов по надёжным каналам. Важно обеспечить целостность и конфиденциальность данных на всем пути передачи.
- Управление Taxonomy и Linkbases. Архитектура должна поддерживать кэширование Taxonomy, автоматическое обновление линков и проверку совместимости версий, чтобы валидатор мог быстро адаптироваться к изменениям в регуляторных требованиях.
- Архитектура данных. Рекомендуется использовать разделение структур данных: инстансы, Taxonomy, правила и логи валидирования хранятся в отдельных репозиториях, облегчая масштабирование и аудиты.
- Безопасность и аудит. Валидация регуляторной отчетности затрагивает чувствительные данные. Необходимо внедрить роль-ориентированную доступность, аудит действий и журнал изменений в правилах, а также защиту от изменяющегося окружения.
- Мониторинг и качество сервиса. Включение метрик времени отклика, числа прошедших проверок и количества ошибок позволяет быстро реагировать на деградацию сервиса и планировать масштабирование.
Производительность и масштабирование
На практике валидаторы XBRL подпадают под требования больших организаций: обработка больших объёмов данные, частые обновления Taxonomy и необходимость регуляторной адаптации. Для достижения требуемой производительности применяются следующие принципы.
- Параллелизация по контекстам и по набору формул. Разделение работы по независимым контекстам позволяет эффективнее использовать ресурсы и ускорять общий цикл валидации.
- Кэширование Taxonomy и Linkbases. Долгосрочное кэширование снижает задержки на старте и повторные проверки, но требует механизмов обновления и контроля валидности кэшей.
- Инкрементная валидация. При изменении части Taxonomy или отдельных правил валидатор должен поддерживать частичное повторное валидацию без пересмотра всего объёма инстансов.
- Управление ресурсами. Важно предусмотреть ограничение потребления памяти и CPU, чтобы устойчиво работать под пиковыми нагрузками и в условиях ограниченных вычислительных мощностей.
- Наблюдаемость и регрессия. Развитие архитектуры требует четких тестовых сценариев, регрессионных тестов и постоянного мониторинга показателей качества.
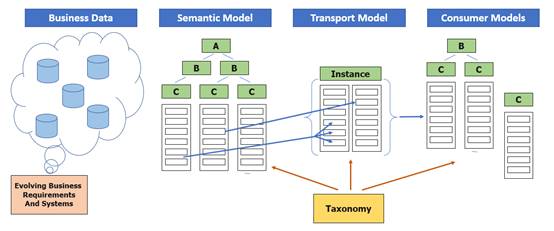
Примеры архитектурных решений
Этап проектирования обычно начинается с выбора базовых компонентов и их взаимодействий. Ниже приводятся ориентировочные сценарии, которые можно адаптировать под специфику банка или страховой компании.
- Пример 1. Интегрированная платформа валидаторов (банк).
Инстансы поступают через безопасный API или через загрузку в защищённый хранилищный слой. Taxonomy и Linkbases кэшируются локально, обновления происходят по расписанию с автоматическим тестированием на стенде. Формульный движок и движок расчётов работают в отдельных микросервисах, взаимодействуя через сообщение в очередь иREST API для статусов проверки. Результаты отправляются в аналитический слой и архивируются. - Пример 2. Валидация в инфраструктуре страховой компании.
Архитектура ориентирована на мультиструктурные данные и множество сущностей. Валидатор обеспечивает отдельный поток на каждом сегменте страхования (Life, Non-Life), но общие правила хранятся в едином правиле-каталоге. Валидации выполняются пакетно в конце отчетного периода, а также в реальном времени для критических расчётов. Поддерживается детальная детализация ошибок и автоматическая эскалация при критических проблемах.
Оба примера используют открытое ядро обработки XBRL (например, Arelle) как базовую платформу для парсинга и базовой формульной логики, что позволяет сосредоточиться на интеграции, масштабировании и управлении качеством. Важна гибкость конфигурации, чтобы можно было адаптировать систему к меняющимся регуляторным требованиям и внутренним процессам.
Key takeaways
- Валидаторы XBRL являются ключевым узлом обеспечений качества регуляторной отчетности и требуют целостной архитектуры, охватывающей формулы, расчёты и качественные проверки.
- Архитектура должна быть модульной, версионируемой и поддерживать инкрементальные обновления Taxonomy, чтобы минимизировать регрессию при изменениях регуляторных требований.
- Формулы и расчёты требуют детального связывания с контекстами и единицами измерения, а также строгого журнала ошибок с трассируемостью.
- Связность между Taxonomy, Linkbases и фактическими данными должна быть проверяема на уровне единиц измерения, контекстов и ссылок, так как нарушения обычно приводят к критическим регуляторным проблемам.
- Производительность достигается за счёт параллелизации, кэширования и инкрементной валидации, при этом важно сохранять возможность полного повторного прогонки тестов.
- Интеграция валидаторов с источниками данных, протоколами обмена и системами аудита должна быть продуманной и согласованной с бизнес-процессами и регуляторной стратегией.
- Практические внедрения лучше осуществлять через микросервисную архитектуру, с детализированными тестами, живыми средами и контролируемыми релизами правил.
FAQ
- Что такое валидатор XBRL и зачем он нужен в банковской и страховой отрасли?
Валидатор XBRL - это система, которая проверяет соответствие представляемых данных требованиям Taxonomy, формулирует и контролирует правила на уровне формул, расчётов и связности, а также обеспечивает качественную и воспроизводимую регуляторную отчетность. В банковской и страховой среде это обеспечивает соответствие регуляторным нормам, прозрачность и возможность быстрого реагирования на изменения в стандартах.
- В чём разница между формулами XBRL и расчетами (calculation linkbase)?
Формулы XBRL используются для проверки бизнес-логики и правил валидации знаний, представленных в инстансах, тогда как расчёты (calculation linkbase) - это механизмы агрегирования и проверки связей между фактическими элементами, такими как выручка или активы. Формулы оценивают корректность данных, а расчёты проверяют математическую согласованность и правильность агрегаций.
- Какие данные участвуют в валидаторах и какие источники используются?
Валидаторы работают с XBRL инстансами, Taxonomy и Linkbases, а также с контекстами, единицами измерения и фактическими значениями. Источники данных могут включать ERP/GL, бизнес-операционные системы и регуляторные архивы. Важно обеспечить доступ к версии Taxonomy и к актуальным Linkbases, чтобы обеспечить корректность валидации.
- Как обеспечить качество данных на входе валидатора?
Важна полноценная стадия подготовки данных, включающая очистку, нормализацию единиц измерения, проверку полноты контекстов, единиц и признаков сегментов, а также тестовую проверку с использованием тестовых инстансов. Наличие контрольных точек и журналов ошибок позволяет быстро выявлять источники несоответствий.
- Как архитектура валидатора взаимодействует с Taxonomy и Linkbases?
Архитектура должна поддерживать загрузку и кэширование Taxonomy и Linkbases, автоматическое обновление версий и совместимость между ними. Обеспечение целостности линков между концептами, контекстами и единицами критично: любые изменения должны проходить через регламентированный процесс тестирования и миграции.
- Какие показатели эффективности валидатора полезно мониторить?
Время на инстанс, доля успешно пройдённых проверок, число ошибок по типам (формула, расчет, качественные проверки), скорость обновления Taxonomy, время обновления Rule Catalog, частота сбоев, а также число регламентно повторных прогонов после изменений.
- Как обеспечить безопасность и соответствие регуляторным требованиям?
Необходимо реализовать управление доступом к данным, аудит действий и версий правил, контроль изменений в Taxonomy и Linkbases, а также защиту данных при передаче между системами и хранении. Встроенные процессы оповещений и эскалации помогают поддерживать соответствие требованиям.
- С чего начать внедрение валидаторов XBRL в крупной организации?
Начните с определения бизнес-правил и регуляторных требований, затем сформируйте каталог правил и пилотный набор формул. Разработайте архитектурную дорожную карту с этапами миграции, тестирования и внедрения, выберите базовые инструменты для обработки XBRL (например, открытые процессоры) и планируйте интеграцию с существующими источниками данных. Постепенно расширяйте функциональность, добавляйте индикаторы качества и развивайте процесс регламентированного выпуска отчетности.
- Какие практические подходы минимизируют регрессию при изменениях в Taxonomy?
Внедрите версионирование правил и Taxonomy, используйте тестовые стенды и регрессионные тесты для проверки изменений, применяйте инкрементную валидацию, а также автоматическую миграцию и откат при необходимости. Поддерживайте чёткую документацию изменений и отслеживание зависимостей между правилами и элементами Taxonomy.
- Какой путь внедрения наиболее эффективен в банке и в страховой компании?
В обоих случаях эффективна модульная архитектура с разделением правок и контроля версий, параллельной валидацией по контекстам и стилизации ошибок. Для банка важна поддержка большого объёма данных и гибкость в интеграции с ERP. Для страховой компании - масштабируемость к многоподразделениям и возможность агрегации по сегментам бизнеса. В обоих случаях критична детальная трассируемость ошибок и готовность адаптироваться к новым регуляторным требованиям.


