

Математические основы XBRL: формулы, расчеты и правила валидации
Курс посвящен переходу от традиционных финансовых моделей к управляемой XBRL-отчетности в условиях цифровой трансформации. Глава фокусируется на математических основах формул, расчетов и правил валидации, необходимых для корректного формирования и проверки XBRL-отчетности из хранилищ данных(DWH). Рассматриваются архитектурные принципы, алгоритмы обработки и сценарии интеграции с существующими taxonomies, а также примеры реализации в рамках корпоративных тежехнологий.
Ниже приводится концептуальная карта темы, затем - последовательное раскрытие вопросов от модели к реализации и операционным аспектам.
- Что представляют собой математические формы и выражения в XBRL и как они интегрируются в DWH
- Как строится валидатор XBRL и какие проверки необходимы для целостности данных
- Какие архитектурные слои задействованы в реализации: данные, формулы, валидация, обмен и аудит
- Какие протоколы и подходы к интеграции применяются на практике
Архитектурные основы формул XBRL
Для формирования корректной XBRL-отчетности из DWH необходима ясная модель взаимодействия между тремя основными слоями: данные, формулы и правила проверки. В контексте DWH формулы не являются произвольными вычислениями; они привязаны к концептам таксономии и к контекстам времени. Архитектурно формулы выполняются в рамках вычислительного движка XBRL Formula, который обращается к фактам (facts), единицам измерения (units) и контекстам (contexts), определенным Taxonomy. В результате получаются производные факты, которые затем проходят этапы валидирования и экспорта в форматы XBRL/iiXBRL.
Ключевые компоненты архитектуры:
- Репозиторий таксономий и формул: хранит концепты, расчеты, зависимые связи и ограничительные правила. В корпоративной среде он обычно синхронизирован с центральной системой управления изменениями и включает процедуры управления версиями.
- Движок формул: осуществляет вычисления на основе входных фактов, поддерживает операторы арифметики, агрегирования, условий и функций, предусмотренных XBRL Formula. Он должен поддерживать последовательность вычислений и порядок применения вычислений, чтобы обеспечить согласованность результата.
- Модуль валидации: реализует синтаксическую и семантическую валидацию, включая пересечения между формулами и вычислениями Taxonomy, проверки единиц измерения, контекстов, периодичности и ограничений по диапазонам значений.
- Интерфейсы обмена данными: поддерживают стандартные протоколы и форматы экспорта (XBRL-IST, iXBRL, т. п.), а также механизмы шифрования, аудита и мониторинга.
- Интеграционные конструкторы: обеспечивают маппинг данных из DWH в факты XBRL, преобразование контекстов времени, конвертацию единиц измерения и подготовку инстансов для валидации и публикации.
Почему важно разделение слоев: поскольку математические формулы оперируют на уровне концептов и контекстов, их корректная работа требует строгой согласованности между концептами Taxonomy и данными, хранящимися в DWH. Ошибка на этапе маппинга может повлечь за собой неверные расчеты, что в итоге скажется на качестве представления отчетности, аудите и последующей регуляторной проверке.
Из практических аспектов следует отметить: архитектура должна обеспечивать прозрачность цепочек вычислений, возможность повторного воспроизведения расчетов и поддержку версионности формул в связи с обновлениями таксономий. В условиях большой корпоративной среде это требует сочетания управляемой среды для версий формул и прочной системы аудита вычислений.
Математические модели XBRL
XBRL моделирует финансовую реальность через набор концептов (concepts), фактов (facts), единиц измерения (units) и контекстов (contexts). Математически это можно рассматривать как множество структурированных данных, где значения фактов сопоставляются с концептами, а контексты определяют временной горизонт и географическую/правовую специфику.
- Концепты представляют собой абстракции экономических признаков: выручка, чистая прибыль, валовая маржа и т. д. Каждый концепт задает семантику и может иметь простые или составные свойства.
- Факты - конкретные значения значений концептов за заданный контекст времени и единиц измерения. В рамках DWH факты обычно хранятся в таблицах измерений, где каждая запись связывает концепт, контекст, единицы и значение.
- Контексты - период, сегментация и юрисдикция. Они позволяют различать периодические значения, например за год или за квартал, а также специфицировать агрегаты по отделам, регионам и т. д.
- Единицы измерения - обеспечивают единообразие измерений (например, USD, EUR, тыс. руб.). Валидация единиц критична для корректной агрегации и сопоставления данных из разных источников.
Математика формул в XBRL опирается на набор базовых операций: сложение, вычитание, умножение, деление, а также более сложные агрегирования и условные вычисления. В качественном дизайне формулы учитывают числовые ограничения, ошибки округления и требования к точности. Важной особенностью является связь между формулами и зависимостями в Taxonomy: вычисления часто строятся поверх уже существующих величин и могут зависеть от результатов промежуточных факторов.
Общая идея: формула - это функция от набора входных фактов к набору выходных фактов. В этом смысле формула реализует функциональную зависимость между переменными, где переменные - это факты, параметры - концепты и контексты, а результат - новые факты или уточнение значений существующих фактов в инстансе XBRL.
Формулы часто реализуются в виде правил, которые не только вычисляют числовые значения, но и проверяют наличие значений, соответствие диапазонам, связь между фактами. Поэтому роль валидатора не ограничивается простым вычислением; он должен проверить корректность структуры данных и соответствие ограничительным условиям Taxonomy.
Чтобы наглядно продемонстрировать идею, можно привести базовую схему вычислений:
- ввод: набор фактов по концептам и контекстам;
- обработка: применение формул к входным фактам, получение выходных фактов;
- вывод: формирование инстанса XBRL с обновленными фактами и записью логов валидации.
В условиях большой данных эффективная реализация требует параллелизма в движке формул, кеширования промежуточных результатов и детального журналирования, чтобы можно было повторно воспроизвести расчеты и отследить источник любого расхождения.
Выражения и формулы в XBRL Formula
XBRL Formula - это язык описания вычислений и валидаторов, который опирается на связи с концептами Taxonomy и физическим представлением фактов в инстанс-документах. В рамках практической реализации формулы чаще всего представляют собой выражения, которые:
- берут входные факты (например, NetIncome, Revenue) и, возможно, контекстные параметры (период, сегмент);
- применяют арифметические и агрегирующие операции;
- возвращают выходные факты, которые могут быть последовательно использованы другими формулами или экспортированы в отчет.
Типовые структуры формул включают:
- арифметические выражения: сложение, вычитание, умножение, деление;
- агрегаты по контекстам: сумма за год, среднее за период;
- расчеты пропорций и коэффициентов: маржа, рентабельность, рост;
- условия и фильтры: если значение выходит за пределы допустимого диапазона, возвращать предупреждение или корректировать значение.
Пример типичного расчета в концептуальном виде:
- NetProfitMargin = NetIncome / Revenue
- RevenueGrowth = (Revenue_Current - Revenue_Previous) / Revenue_Previous
- AssetTurnover = Revenue / AverageTotalAssets
Эти примеры иллюстрируют базовую идею: формулы связывают входные концепты с выходными фактами через зависимые отношения, которые распознаются Taxonomy и поддерживаются движком формул. В реальной системе формулы часто включают дополнительные условия по контекстам, например различение за год и за квартал, или охват нескольких сегментов бизнеса.
(Структура формулы, упрощенная для иллюстрации)
## Formula NetProfitMargin
Inputs: NetIncome (numeric), Revenue (numeric)
## Output: NetProfitMargin (numeric)
Definition: NetProfitMargin = NetIncome / Revenue
Context: Period = Year; Entity = Consolidated
Важно помнить: формулы не существуют в вакууме. Их корректность во многом зависит от точности маппинга входных фактов, согласованности единиц измерения и правомерности контекстов. Поэтому в рамках DWH-механизма следует обеспечить единообразие контекстов (например, одинаковое определение финансового года и сегмента). Любая несовместимость контекстов может привести к неверной агрегации и искажению валидируемых значений.
Валидаторы и правила валидации
Валидация в XBRL основывается на тройной логике: синтаксическая, семантическая и регламентная. Синтаксическая проверка оценивает корректность структуры инстанса (правильно заданные элементы, корректные идентификаторы, единицы измерения и контексты). Семантическая валидная проверяет соответствие между фактами и Taxonomy: корректность связи между концептами, зависимостями и агрегированиями, а также соответствие диапазонам значений и типам данных. Регламентная валидная проверка касается соответствия отчетности регуляторным требованиям: например, обязательные поля, презентационные правила, соответствие форме отчета и временным требованиям.
Контекстные и расчетные правила валидации:
- Диапазонные ограничения: значение факта должно находиться в пределах допустимого диапазона, установленного Taxonomy и бизнес-логикой компании.
- Типовые проверки единиц измерения: коэффициенты и агрегаты должны применяться к единицам измерения, которые согласованы между собой.
- Последовательность и зависимые вычисления: выходные факты, полученные с помощью формул, должны использоваться в последующих формулах корректно и без противоречий.
- Целостность контекстов: периодические и сегментные контексты должны быть определены и согласованы на уровне всей модели.
- Cross-fact validation: кросс-значения должны соответствовать отношению между собой (например, общая себестоимость не может быть меньше себестоимости отдельных компонентов без учета корректировок).
- Аудируемость: каждое вычисление должно оставлять след (traceability) - ссылка на входные факты, формулу и версию Taxonomy, чтобы можно было реконструировать порядок вычислений.
Особенности валидации в контексте DWH:
- Масштабируемость: валидаторы должны обрабатывать большое количество входных фактов и поддерживать параллельные проверки без потери точности.
- Интероперабельность: поддержка стандартных форматов экспорта и журналирования ошибок для последующего аудита.
- Обратная совместимость: при обновлениях Taxonomy валидаторы должны сохранять совместимость с существующими инстансами и корректно обрабатывать переходные состояния.
- Диагностика и исправления: при выявлении ошибок валидции система должна предоставлять понятную диагностику, указывать на конкретные концепты, контексты и формулы и предлагать варианты исправления.
Чтобы обеспечить надлежащую валидацию на практике, целесообразно внедрять три уровня проверки:
- уровень синтаксической валидации входных данных и структуры инстанса;
- уровень семантической валидации формул и зависимостей между фактическими значениями;
- уровень регламентной/контрольной валидации, который сопоставляет результаты с требованиями отчетности и регуляторными нормами.
Расчеты на уровне DWH: маппинг и схемы
Эффективная реализация маппинга XBRL-отчетности из DWH требует четкого определения схемы преобразования данных. Основной подход основан на связывании входных данных DWH с концептами Taxonomy через маппинг-таблицы: каждая запись в фактовой таблице DWH должна иметь свой соответствующий концепт, единицу измерения и контекст. В этом контексте важны три аспекта:
- достоверность маппинга: соответствие источников данным Taxonomy
- консистентность единиц измерения: приведение ко всем единицам в рамках одной инстанс-отчетности
- корректность контекстов: единая модель периодов, сегментов и организаций
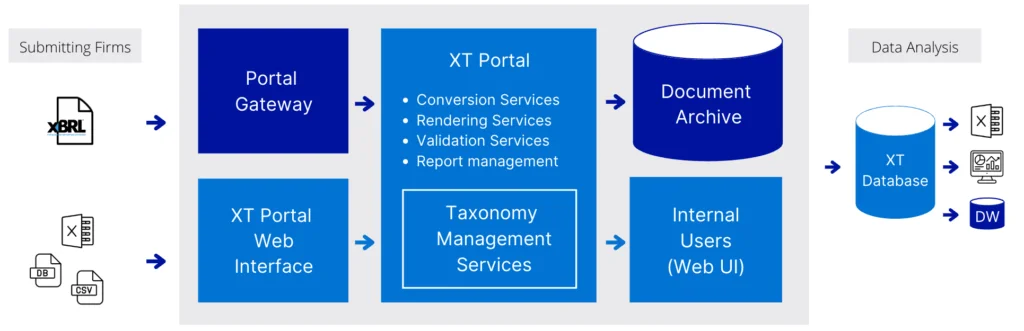
Стратегическая модель маппинга состоит из:
- карту концептов: сопоставление каждого концепта Taxonomy с полем/колонкой в DWH
- карту единиц измерения: согласование единиц в рамках отчета
- карту контекстов: определение периода, сегмента и юридического лица, к которым применяются факты
- правила нормализации данных: обработка пропусков и нечисловых значений, приведение к допустимым диапазонам, округление и обработки на уровне бизнес-логики
После маппинга формируется «инстанс» XBRL для экспорта и валидации. В этом процессе ключевую роль играют:
- выравнивание периода: период должен соответствовать отчетному циклу; для кварталов можно использовать контекст с соответствующими датами начала и окончания.
- консолидация: для консолидированной отчетности необходимо аккуратно агрегировать данные, сохраняя след от отдельных источников и их долей участия.
- контроль качества данных: проверки на полноту, уникальность фактов и отсутствие дублей.
Архитектурно данные могут храниться в виде триггерной схемы:
- факт-таблица: концепт, значение, контекст, единица измерения
- контекст-таблица: период, сегмент, организация
- карта-концептов: соответствие Taxonomy полю источника
- факт-источник: привязка каждого факта к источнику данных в DWH
Такая структура позволяет разделить ответственность за данные и формулы, обеспечить трассируемость и упростить регламентную и аудиторскую проверку. В рамках реализации важно поддерживать возможность повторного воспроизведения расчета для конкретного периода и источника, а также поддерживать версионность Taxonomy и формул без нарушения существующих инстансов.
Интеграционные сценарии и протоколы
Интеграция XBRL-процессов в корпоративную IT-инфраструктуру обычно происходит через цепочку:
- сбор и нормализация данных из различных систем в DWH
- маппинг данных к концептам Taxonomy и подготовка контекстов
- выполнение формул движком и генерация выходных фактов
- валидация и экспорт инстансов XBRL (или iXBRL) для публикации и аудита
- журналирование и мониторинг ошибок, регуляторные уведомления
Протоколы и стандарты, активно применяемые на практике:
- XBRL Taxonomy и XBRL Formula: определяют семантику и поведение формул и валидационных правил
- iXBRL и XML-форматы: обеспечивают структурированное представление фактов и контекстов для публикации и анализа
- API-интерфейсы для взаимодействия с системами мониторинга и аудита
- Протоколы обмена данными внутри корпоративной архитектуры: REST, gRPC или брокеры сообщений для передачи данных между DWH, движком формул и валидатором
Интеграционные сценарии требуют четко настроенных обработчиков ошибок и ретраи, особенно в случаях обновления Taxonomy или изменений в цепочке расчета. Внедрение должно обеспечить двусторонний обмен: данные могут поступать в движок формул как исходные факты, а результаты вычислений - обратно в DWH или в инстанс XBRL, где они становятся доступными для регуляторной публикации. Важно обеспечить отслеживание версии Taxonomy и формул, чтобы каждый инстанс мог быть отнесен к конкретной версии и историзирован.
Соображения по реализации:
- модульная архитектура: разделение на модули маппинга, формул, валидации, экспорта и аудита
- управление версиями: версия Taxonomy, версия формул, версия инстансов
- мониторинг и аудит: детализированные логи и трассируемость для каждых вычислений
- безопасность и доступ: разграничение прав на изменение Taxonomy, формул и правил валидации
- производительность: параллельная обработка, инкрементные обновления и кэширование результатов
Примеры реализации: парсинг, расчеты и валидация
На практике формулы обычно реализуются в виде движков, которые читают формулы из конфигурационных файлов или из репозитория Taxonomy и выполняют вычисления над данными DWH. Важным является обеспечение детализированной трассируемости: каждое вычисление должно иметь источник входных фактов, формулу, версию Taxonomy и контекст.
Ниже приведен упрощенный псевдокод процесса вычисления формул и валидации на уровне движка. Он иллюстрирует логику, но не является готовым к внедрению кодом.
function evaluateFormulas(instances, taxonomy):
    for each formula in taxonomy.formulas:
        inputs = fetchInputs(formula.inputs, instances)
        // обработка контекстов и единиц измерения
        alignedInputs = alignContextsAndUnits(inputs, formula.contextRequirements)
        if not alignedInputs.valid:
            logWarning("Context/Unit mismatch", formula, alignedInputs.mismatches)
            continue
        result = applyExpression(formula.expression, alignedInputs.values)
        if not validateResult(result, formula.constraints):
            logError("Validation failed", formula, result, formula.constraints)
            continue
        storeDerivedFact(formula.outputConcept, formula.context, result)

function applyExpression(expression, values):
    // упрощенный пример: выражение поддерживает арифметические операции и функции
    return evaluateArithmetic(expression, values)

function validateResult(value, constraints):
    if constraints.range and not (constraints.range.min Такой подход обеспечивает прозрачность операций и упрощает последующий аудит. В реальных системах применяются более сложные механизмы:
- обработка ошибок на уровне входных данных; повторные попытки и корректировка данных
- управление зависимостями между формулами: порядок вычислений, обработка опорных и выходных фактов
- кэширование промежуточных результатов и повторное использование в последующих вычислениях
- поддержка параллельной обработки большого объема инстансов
Key takeaways
- XBRL формулы представляют функциональные зависимости между фактами, концептами Taxonomy и контекстами, и должны работать в согласованных архитектурах DWH.
- Точная маппинг-слоя между данными DWH и концептами Taxonomy критична для корректности расчетов и последующей валидации.
- Валидаторы должны охватывать синтаксис, семантику и регуляторные требования, обеспечивая трассируемость вычислений и аудит.
- Архитектура должна поддерживать версионность Taxonomy и формул, обеспечивать мониторинг, безопасность и производительность.
- Реализация требует модульности, прозрачности цепочки вычислений и детализированных журналов ошибок.
- Внедрение формул и правил валидации в DWH должно сопровождаться четкими сценариями интеграции, чтобы обеспечить устойчивость к изменениям источников данных и Taxonomy.
- Нормализация единиц измерения и контекстов является критическим фактором для корректного расчета и агрегирования.
FAQ
- Что такое XBRL Formula и зачем она нужна в рамках DWH?
XBRL Formula - это язык описания вычислений и валидаторов для XBRL, который позволяет описывать зависимости между концептами Taxonomy и входными фактами. В контексте DWH формулы служат мостом между данными в хранилище и семантическим значением, которое представлено в инстансе XBRL. Их основная роль - автоматизация расчетов, валидаций и преобразований в рамках отчетности, обеспечивая единообразие, прозрачность и воспроизводимость вычислений.
- Какие риски возникают при маппинге данных из DWH в концепты Taxonomy?
Ключевые риски включают несогласованность между источниками данных и концептами Taxonomy, различия во времени и единицах измерения, пропуски значений и ошибки преобразования. Любая ошибка маппинга может привести к некорректной отчетности, что повлечет регуляторные и аудиторские последствия. Поэтому крайне важно внедрять строгие проверки на уровне маппинга, журналирование изменений и повторяемые процедуры тестирования.
- Какие архитектурные принципы помогают обеспечить масштабируемость формул?
Необходимо разделение на слои: данные, формулы, валидация и экспорт. Архитектура должна поддерживать параллельную обработку, кэширование промежуточных результатов, версионность Taxonomy и формул, детальную трассируемость вычислений и эффективное управление изменениями. Әлементами масштабируемости являются горизонтальное масштабирование движка формул, распределенные очереди задач и мониторинг с алертами.
- Как реализуются контексты в XBRL и почему это важно?
Контексты определяют период, сегмент и организационную принадлежность фактов. Их корректная реализация критична для точности вычислений и соответствия регуляторным требованиям. Важно обеспечить единообразие форматов контекстов между DWH и Taxonomy, ясную датировку и корректное определение сегментов, чтобы расчеты и агрегации были консистентны.
- Какие подходы к валидации применяются в рамках XBRL?
Существуют три уровня валидации: синтаксическая (структура инстанса), семантическая (соответствие формул и зависимостей Taxonomy) и регламентная (соответствие требованиям отчетности и регуляторов). Эффективная система валидаторов обеспечивает трассируемость вычислений, детальные сообщения об ошибках и возможность быстрого исправления данных и формул.
- Как обеспечить аудитируемость процесса формирования XBRL из DWH?
Необходимо сохранять полную трассируемость: версию Taxonomy, версию формул, входные факты, контексты, единицы измерения и порядок вычислений. Журналы должны позволять реконструировать любой расчет: от входных данных до конечного выходного факта, включая дату и пользователя, который инициировал расчеты.
- Какие open-source решения используются для поддержки XBRL-процессов в технике и архитектуре?
Примеры: Apache Crunch или Apache Spark могут быть применены для параллельной обработки вычислений; OpenXBRL в качестве набора инструментов для некоторых функций, а также более узкоспециализированные движки формул. В рамках российского рынка можно рассмотреть решения, которые реализуют интероперабельность через iXBRL и соответствующие API. В любом случае выбор инструментов должен опираться на требования безопасности, совместимости и поддержки в рамках корпоративной инфраструктуры.
- Какие типичные ошибки возникают при внедрении формул в корпоративной среде?
Типичные ошибки включают несогласованность единиц измерения, неправильную настройку контекстов, несвоевременное обновление Taxonomy, нехватку журналирования и отсутствие детальных сообщений об ошибках, что затрудняет диагностику. Также часто возникают проблемы с производительностью при отсутствии оптимизированной инфраструктуры для параллельной обработки и кэширования.
- Какой подход к тестированию формул в рамках проекта?
Рекомендуется построить среду тестирования, где каждый входной факт и формула тестируются на соответствие конкретным кейсам: базовые сценарии, граничные значения, обработки пропусков и регуляторные требования. Тесты должны повторно воспроизводить вычисления, фиксировать версии Taxonomy и формул, а также обеспечивать тестовые данные для каждого контекста и единицы измерения.
- Какие шаги к реализации можно предложить начинающим проектам?
Начать с четкой архитектурной карты: определить слои данных, формул, валидации и экспорта; создать карту маппинга между DWH и Taxonomy; внедрить базовый движок формул и набор простых валидаторов; настроить журналирование, версии Taxonomy и формул; реализовать сценарии интеграции с существующими системами и обеспечить аудит; постепенно расширять набор формул, тестов и функций мониторинга.


