

Жизненный цикл проекта XBRL: требования, проектирование архитектуры, внедрение, эксплуатация
В условиях модернизации финансовой отчетности предприятия и необходимости соответствовать регуляторным требованиям ключевую роль играет интеграция процессов формирования XBRL-отчетности с данными из хранилища данных (DWH). Глава рассматривает полный жизненный цикл проекта: от определения требований до эксплуатации и эволюции архитектуры с учетом изменений таксономий, верификации качества данных и управляемости изменений. Особое внимание уделяется архитектурным решениям, протоколам интеграции, алгоритмам трансформации и подходам к автоматизации валидации, обеспечивающим устойчивую и повторяемую выработку XBRL-отчетности.
Формирование XBRL-отчетности из DWH требует не только технического решения, но и управленческого подхода: эффективное управление изменениями таксонций, настройка процессов тестирования и валидации, обеспечение прозрачности происхождения данных и возможность аудита. В современной практике архитектура должна быть модульной, масштабируемой и способной адаптироваться к частым обновлениям таксономий и требованиям регуляторов. В этой главе представлены принципы проектирования, набор архитектурных паттернов, сценарии внедрения и операционной эксплуатации, подкрепленные практическими примерами и инженерными решениями.
- Определение требований к данным и целям проекта, выбор таксономий и форматов вывода.
- Архитектура потока данных: интеграция DWH, маппинг-слой, генератор XBRL-инстансов, валидация и оркестрация.
- Внедрение и интеграции: CI/CD для трансформаций, управление таксономиями, контроль версий и безопасность.
- Эксплуатация: мониторинг качества данных, обработка обновлений таксономий, управление изменениями и поддержка пользователей.
Краткое содержание главы
- Определение требований к проекту, регуляторные рамки и целевые форматы вывода, забота о полноте и достоверности данных.
- Архитектура решения: слои данных, маппинг-логика, управление таксономиями и валидация на уровне инстансов XBRL.
- Внедрение и интеграции: выбор инструментов, настройка пайплайнов, обеспечение повторяемости и тестирования.
- Эксплуатация и управление изменениями: мониторинг, обновления таксономий, аудит и документация.
Требования и контекст проекта
Формирование XBRL-отчетности из DWH начинается с ясной постановки целей и ограничений. В этом разделе описаны ключевые требования, которые должны быть отражены в техническом задании и в архитектурном плане.
- Регуляторный контекст и охват. Определение перечня отчетности, которая подлежит конвертации в XBRL, локализации и необходимых версий таксономий. В рамках проекта важно зафиксировать требования к поддержке iXBRL и/или XBRL-XML инстансов, а также к межрегиональной совместимости.
- Объем и качество данных. Определение источников в DWH, полноты и точности данных, требования к lineage и атрибуциям (unit, period, dimension). Необходимо учесть требования к агрегации на уровне консолидированной отчетности и к параллелизму обработки.
- Управление таксономиями. Выбор базовой таксономии (например, IFRS, US GAAP) и необходимость локализаций. Важна процедура обновления таксономий, синхронная или асинхронная интеграция изменений и стратегия кэширования концептов.
- Модель данных и маппинг. Определение словаря соответствий между полями DWH и концептами XBRL (concepts). Необходимо учитывать типы данных, единицы измерения, точность, формат дат и правила округления.
- Безопасность и соответствие. Определение уровней доступа к данным, защиты конфиденциальной информации, журналирование изменений и аудит.
- Производительность и масштабируемость. Требование к времени генерации инстансов, объему обрабатываемых данных и устойчивости к пиковым нагрузкам.
- Эталон тестирования и валидации. Набор тестов на функциональные и бизнес-правила, критерии приемки, методики регрессионного тестирования и контроля качества.
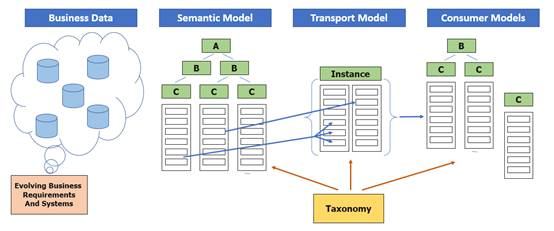
Для практической реализации важны решения по взаимодействию между DWH и трансформационным слоем: выбор протоколов передачи данных, форматов обмена и уровней абстракции. В качестве ориентира можно рассмотреть схему, где данные из DWH через слои ETL/ELT подаются в трансформационный сервис, который, опираясь на актуальную таксономию, формирует XBRL-инстанс и передает его в валидатор и архив. В качестве инструментов можно упомянуть открытые решения, такие как Arelle для проверки XBRL-инстансов и трансформационные конвейеры на основе Apache NiFi или Talend, обеспечивающие потоковую интеграцию.
- Важным является определение бизнес-правил, которые будут использоваться для маппинга. Это включает соответствие по концептам, единицам измерения, валютам, периодам и правилам округления.
- Необходима стратегия управления изменениями в таксономиях: периодические обновления, регламент по принятию изменений, тестовые стенды для проверки совместимости маппинга с новыми концептами.
- Также нужно продумать инфраструктуру аудита и трассируемости: кто и когда изменял маппинг, какие версии таксономий применялись, какие инстансы были сгенерированы.
Архитектура решения: слои, протоколы и интеграции
В техническом плане архитектура проекта XBRL должна быть модульной и поддерживать строгую сегрегацию обязанностей между слоями. Ниже приведена рекомендуемая структура слоев и ключевые принципы их взаимодействия.
- Слой источников и загрузки данных (DWH). Этот слой обеспечивает извлечение данных из корпоративного хранилища, включая исторические данные и консолидированные сборки. Здесь реализация может опираться на ELT-подход: извлечение данных в промежуточный слой, нормализация и подготовка к маппингу. Взаимодействие осуществляется через ускоряющие коннекторы и безопасные протоколы доступа (OAuth, Kerberos, TLS).
- Слой маппинга и правил трансформации. Центральная часть архитектуры, которая сопоставляет поля источников с концептами XBRL. Здесь применяются правила типизации, валидации типов данных, единиц измерения и форматирования. В рамках технической реализации полезно определить DSL (доменный язык трансформации) или использовать конфигурационные файлы, которые можно версионировать и тестировать.
- Слой генерации и упаковки XBRL. На основе сопоставления формируются XBRL-инстансы, упакованные в требуемый формат (XBRL-XML, iXBRL, ZIP-архив). Вариант iXBRL полезен, если требуется визуализация и более широкая совместимость с регуляторами и налоговыми органами. Этот слой также отвечает за привязку контекста, единиц измерения и периодов.
- Слой валидации и контроля качества. Выполняется синтаксическая и семантическая валидация инстансов: соответствие схемам XBRL, проверка линков, физическая целостность, корректность контекстов, валидность таксономий и базовых правил.
- Слой оркестрации и интеграций. Реализуется через сервисы или контейнеризованные микросервисы: REST/gRPC API для запуска генерации, очереди сообщений (Kafka, RabbitMQ) для событий и интеграции с существующими ETL-процессами. Важна поддержка повторных попыток, мониторинга и трассировки.
- Слой хранения и аудита. Архив инстансов, версии таксономий, логи трансформаций и атрибутивные метаданные. Обеспечивает возможность аудита, отката и регламентированного хранения. В идеале обеспечивает интеграцию с системой управляемых записей и журналов изменений.
- Слой безопасности и управления доступом. Гарантирует конфиденциальность и целостность данных, применение ролей, аудита доступа и соответствие требованиям регуляторов. Встраиваются политики шифрования в покое и в передаче.
Протоколы и форматы обмена. Для эффективной интеграции применяются стандартные и индустриальные протоколы:
- REST/JSON или gRPC для управления заданиями и обмена метаданными между компонентами.
- TLS для защищенного канала передачи данных.
- Поддержка очередей сообщений (Kafka, RabbitMQ) для событийного подхода и обеспечения надежности.
- XML/XBRL для инстанс-документов и XSD-валидации, а также JSON-Representations для удобства тестирования и консолидации между слоями.
Алгоритмы маппинга и валидации. В основе архитектуры лежат следующие принципы:
- Сопоставление по семантике и формальным признакам: концепт XBRL связан с источником через ключевые поля (период, единица измерения, валюты, контекст).
- Валидация на разных уровнях: синтаксическая ( XSD для инстанса ), семантическая (контекст времени, валюта, объем), правиловая (бизнес-ограничения и ограничения регулятора).
- Регрессия и тестирование: поддержка квитанций и контрольных тест-кейсов по каждому набору маппинга, чтобы обеспечить повторяемость и устойчивость изменений.
- Управление изменениями: версионирование правил маппинга, фиксация зависимости с версиями таксономий и поддержка параллельной работы над несколькими версиями.
## Пример простейшего правила трансформации (псевдокод)
## исходные поля DWH: revenue_amount, revenue_currency, period_id
## концепт XBRL: ifrs.Revenue
mapping = {
  "revenue_amount": "ifrs.Revenue",
}
def transform(row, taxonomy_version):
  instance = new XBRLInstance(taxonomy_version)
  for src, concept in mapping.items():
     value = row[src]
     if value is not None:
        instance.add_value(concept, value, unit=row.get("revenue_currency"), context=row.get("period_id"))
  return instance
В этом контексте важно четко определить, какие концепты будут использоваться, и как они соотносятся с единицами измерения и контекстами. Пример выше иллюстрирует принцип сопоставления бизнес-данных с концептами таксономии и формирования валидного инстанса XBRL.
Архитектура, управление таксономиями и валидация
Управление таксономиями и контентом - ключевой элемент устойчивой реализации XBRL. Таксономии должны проектироваться и обновляться в тесном сотрудничестве между бизнес-подразделениями и ИТ. В этом разделе рассмотрим организационные и технические аспекты.
- Управление версиями и обновлениями. Внедряется процесс регулярных обновлений таксономий, включающий тестирование изменений на стенде, регламент согласования и аудит изменений. Важна инфраструктура для параллельной поддержки нескольких версий таксономий, чтобы не прерывать текущие операции.
- Контент-менеджмент концептов. Создание и поддержка словаря концептов, уникальных идентификаторов и взаимосвязей между концептами. Необходимо фиксировать соответствие между полями DWH и концептами XBRL, включая префиксы, пространства имен и версии таксономий.
- Валидация инстансов. Валидация должна охватывать синтаксис XML, соответствие схемам XBRL, проверки линков и целостности контекста. В важном случае предполагается использование готовых валидаторов (например, встроенных в Arelle) и пользовательских правил, проверяющих бизнес-ограничения.
- Управление качеством данных. Встроенные механизмы контроля соответствия данных исходному источнику, выявление дубликатов, пропусков и несоответствий. Мониторинг задержек между обновлениями таксономий и их применением к маппингу.
- Безопасность данных и аудит. Реализация политик доступа, шифрование и аудит по каждому инстансу и изменению конфигураций маппинга и таксономий.
Интеграционные возможности. Архитектура должна поддерживать интеграцию с существующими инструментами автономного тестирования, его инфраструктурой и системами корпоративной отчетности. В открытом пространстве широко используются решения типа Arelle для валидации XBRL-инстансов и инструменты для потоковой обработки данных, такие как Apache NiFi или Talend, которые обеспечивают удобные коннекторы к DWH и системам хранения.
- Arelle демонстрирует открытый подход к валидации и анализу XBRL-инстансов и способен работать как часть конвейера проверки.
- Инструменты интеграции, например NiFi, позволяют реализовать визуальные маршруты обработки, упрощая оркестрацию и мониторинг.
Важно помнить, что архитектура должна быть ориентирована на масштабируемость: параллелизация маппинга, горизонтальное масштабирование сервисов и управление состоянием пайплайна. Это обеспечивает устойчивость к росту объема данных и частым обновлениям таксономий.
Внедрение: проектирование, интеграции и тестирование
Этап внедрения включает проектирование инфраструктуры, настройку пайплайнов и комплексную проверку готовности к эксплуатации. Основные аспекты.
- Прототипирование и пилот. В рамках пилота проверяется работоспособность ключевого конвейера: извлечение данных из DWH, маппинг, генерация инстансов и валидation. Пилот позволяет выявить узкие места и доработать требования к инфраструктуре.
- Инфраструктура и развёртывание. Использование контейнеризации и оркестрации (например, Docker + Kubernetes) обеспечивает повторяемость развёртываний, упрощает масштабирование и управление версиями компонентов.
- CI/CD для маппинга и таксономий. Включение автоматических тестов на каждом изменении правил трансформации и обновлений таксономий. Важна фиксация зависимостей между версиями правил и версий таксономий и поддержка тестовых стендов.
- Тестирование и приемка. Набор функциональных тестов на соответствие требованиям, регрессионные тесты по измененным концептам и контроль целостности контекста. Валидация на разных данных: реальные сценарии и синтетические данные.
- Интеграции и обмен данными. Поддерживаются сценарии интеграции с внешними системами (регулятор, аудит, корпоративные архивы). Реализация должна обеспечивать надёжность передачи документов и наличие журналов операций.
Ключом к успешному внедрению является грамотное управление изменениями: регламент принятия обновлений таксономий и логика миграции существующих инстансов под новые концепты. В техническом плане требуется соблюдение совместимости между версиями маппинга и таксономий, чтобы не возникало рассинхронов между инстансами и требованиями регуляторов.
## Пример шага CI/CD для маппинга (описательная схема)
- **Ветка main**: стабильная версия маппинга и таксономий
- **При каждом PR**: автономное тестирование маппинга на тестовом наборе данных
- **После мержа**: развёртывание в staging-среде, тесты интеграции
- **По результатам тестов**: апгрейд версии в продакшен после одобрения бизнесом
Эксплуатация и сопровождение
После развертывания система XBRL вступает в фазу активной эксплуатации. В этом разделе освещаются технологии мониторинга, поддержания качества, обновления таксономий и организационные аспекты.
- Мониторинг и операционная устойчивость. Включаются показатели времени обработки инстансов, скорость миграций, доля ошибок маппинга и валидности инстансов, а также время отклика API. Налаживаются триггеры оповещений и дашборды для оперативного управления.
- Обновления таксономий и регуляторные изменения. Процедуры планирования обновлений таксономий, тестирования совместимости и ускоренной адаптации маппинга без остановки текущего цикла отчетности. Важна прозрачная фиксация версий и регламент обновления.
- Управление изменениями и аудит. Встроенная система версионирования конфигураций, журнал изменений, аудиторские следы и возможность восстановления к предыдущим версиям. В рамках аудита поддерживаются режимы проверки целостности инстансов и источников данных.
- Масштабирование и производительность. При росте объемов данных и числа концептов возможно горизонтальное масштабирование конвейера маппинга, увеличение числа воркеров и использование кластерных решений для обработки параллельных запросов.
- Поддержка пользователей и операционная документация. Наличие руководств пользователя, документации по маппингу и правилам валидации, а также оперативной поддержки для бизнес-подразделений и регуляторов.
Практические примеры интеграций включают: кластеризацию вычислительных задач для параллельной генерации инстансов, использование ETL-инструментов для управления данными до стадии маппинга и обеспечение архивирования исторических инстансов для аудита. При этом технические решения выбираются с учётом прозрачности процессов и возможности повторной проверки.
Ключевые выводы
- Эффективная реализация XBRL из DWH строится на модульной архитектуре с четким разделением слоёв: загрузка данных, маппинг, генерация инстансов, валидация и оркестрация.
- Управление таксономиями - критически важный элемент проекта: версии таксономий, согласование изменений и поддержка параллельных конфигураций.
- Валидация должна осуществляться на разных уровнях: синтаксическая, семантическая и бизнес-правила, с использованием готовых валидаторов и собственных проверок.
- Автоматизация и повторяемость процессов достигаются через CI/CD для маппинга и таксономий, тестовые стенды и регламентные проверки на каждом этапе развёртывания.
- Инфраструктура должна быть масштабируемой и надёжной, с поддержкой мониторинга, журналирования, аудита и бизнес-обоснованных показателей эффективности.
- Важную роль играет выбор инструментов: открытые решения для валидации XBRL (например, Arelle) и инструменты для потоковой интеграции (NiFi, Talend), что позволяет снизить риск и ускорить внедрение.
- В рамках проекта необходимо установить четкие процедуры управления изменениями и контроль версий, чтобы обеспечить предсказуемость изменений таксономий и маппинга.
- Согласованность между бизнес-правилами, данными DWH и требованиями регуляторов требует тесного взаимодействия между бизнес, ИТ и юридическим подразделением.
- Не следует перегружать архитектуру лишними инструментами - выбор ограниченного числа проверенных решений повышает устойчивость и упрощает сопровождение.
- Этап пилотирования, стендовое тестирование и постепенная миграция позволяют минимизировать риски и обеспечить качественную эксплуатацию после запуска.
FAQ
- Что входит в понятие «жизненный цикл проекта XBRL» и почему он начинается с требований?
- Жизненный цикл начинается с формализации бизнес-требований и регуляторных контекстов, поскольку они определяют, какие таксономии, какие инстансы и какие правила валидности должны поддерживаться. Далее следует проектирование архитектуры, выбор технологических решений, внедрение и, наконец, эксплуатация. Без ясного определения требований невозможно обеспечить соответствие инстансов требованиям регуляторов и ожиданиям пользователей.
- Какие архитектурные слои являются необходимыми для формирования XBRL из DWH?
- Необходимы слои источников данных (DWH), маппинга и правил трансформации, генерации и упаковки XBRL-инстансов, валидации, оркестрации и интеграций, а также слой хранения и аудита. Эти слои обеспечивают разделение ответственности, масштабируемость и возможности аудита.
- Как организовать управление таксономиями и контентом?
- Управление таксономиями требует версиионирования и регламентированного обновления. Необходимо поддерживать несколько версий таксономий одновременно, обеспечить тестовую среду для новых версий, документировать соответствие между концептами и полями DWH и фиксировать зависимость между версиями таксономий и правилами маппинга.
- Какие подходы к валидации XBRL-инстансов предпочтительны?
- Рекомендуется сочетать синтаксическую валидацию (XSD), семантику (проверка контекстов, единиц измерения, корректности временных периодов) и бизнес-правила (проверки согласованности данных и регуляторных ограничений). В качестве инструмента можно использовать открытые валидаторы, внедренные в общий конвейер.
- Как обеспечить интеграцию XBRL-прохода с существующими ETL/ELT процессами?
- Через единый оркестрационный слой и гибкие коннекторы к DWH, используя протоколы REST/gRPC и очереди сообщений для координации. Ввод данных в конвейеры должен сопровождаться прозрачной идентификацией источников и версии трансформаций.
- Какие протоколы и инструменты подходят для обмена данными и мониторинга?
- Подходят TLS для защищенной передачи, REST/JSON или gRPC для управления, Kafka для событийного взаимодействия, инструменты валидации XBRL (например, Arelle) и средства мониторинга/логирования для аудита и анализа инцидентов. Не рекомендуется перегружать стек большим количеством инструментов, если можно обойтись меньшим набором зрелых решений.
- Какие риски существуют при масштабировании проекта и как их минимизировать?
- Риски включают несогласованность версий таксономий, задержки обновлений, узкие места в маппинге и недостаточную аудиторию тестирования. Их минимизируют через параллельную разработку версий маппинга, стенды тестирования, автоматизированные тесты, CI/CD, мониторинг производительности и план откатов.
- Как обосновать ROI проекта XBRL-за счет экономии и качества?
- ROI достигается за счет уменьшения ручного труда, ускорения выпуска отчетности, снижения ошибок и повышения прозрачности процессов аудита. Важную роль играют улучшение времени реакции на изменения таксономий и регуляторных требований, а также снижение рисков неправомерного представления данных.
- Какие критерии приемки проекта и как проводить демонстрацию бизнес-целей?
- Приемка основывается на достижении целевых SLA по времени генерации инстансов, корректной валидации, соответствия регуляторным требованиям и устойчивости к обновлениям таксономий. Демонстрации должны включать конкретные сценарии: обновления таксономий, регуляторные изменения, тестовые инстансы и результаты аудита.
- Как обеспечить соответствие требованиям конфиденциальности и безопасности?
- Необходимо внедрить многоуровневый доступ, разделение обязанностей, шифрование в покое и в передаче, аудит доступа и журналирование событий. Архитектура должна соответствовать требованиям корпоративной политики и регуляторных норм, включая хранение без лишних копий и защищенные каналы передачи.
Эта глава предоставляет подробное представление о жизненном цикле проекта XBRL и фокусируется на архитектурных принципах, протоколах и практиках внедрения, которые обеспечивают устойчивую, масштабируемую и проверяемую систему формирования XBRL-отчетности из DWH.


