

Источники данных для Task Mining: логи, события и взаимодействия
Task mining — это направление аналитики, которое делает явным то, как именно выполняются бизнес-задачи в реальных рабочих процессах. В основе любой попытки автоматически выявлять задачи, их последовательности и взависимости лежат данные: логи систем, события в информационных системах, а также взаимодействия сотрудников с интерфейсами приложений и сервисов. Источники данных для task mining можно разделить на несколько групп: системные логи и трассировочные данные, бизнес-события и транзакции, а также взаимодействия человека с цифровыми интерфейсами (клики, ввод данных, переходы по меню). Правильный выбор и обработка этих источников являются критическими для того, чтобы модели и визуализации任务 mining отражали реальную работу сотрудников, а не искажали её из-за пропусков или ошибок в данных.
Цель главы — дать новичку полное представление об источниках данных для Task Mining, их характеристиках, практических примерах сбора и интеграции, а также обсудить риски и ограничения внедрения. Мы рассмотрим теоретические основы, обсудим конкретные примеры инструментов, включая открытое ПО и российские решения, поделимся практическими рекомендациями по подготовке данных и организационным вопросам, чтобы старт пилотного проекта прошёл максимально гладко и принес ожидаемую пользу.
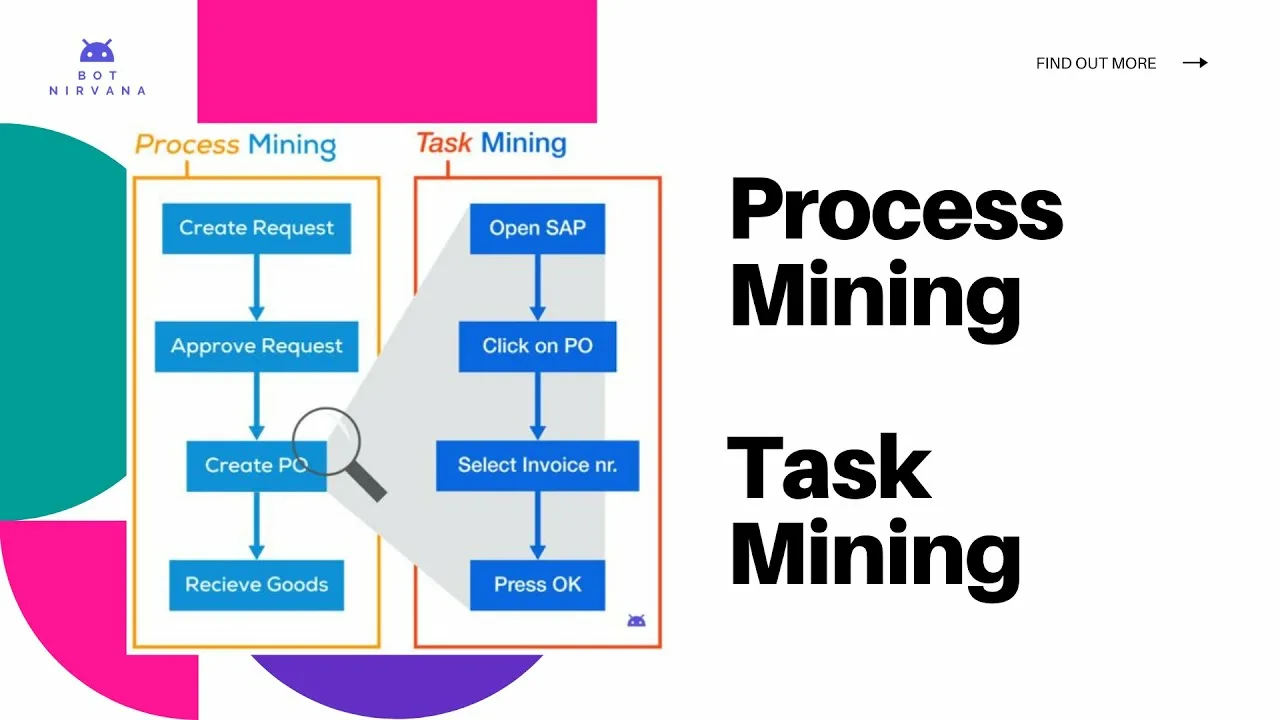
Что считается источником данных в Task Mining
- Логи и трассировки систем: это структурированные записи о событиях, которые происходят в приложениях, серверах и сетевых устройствах. Они фиксируют время, контекст и характер события: выполнение задачи, 오류, изменения статуса, доступ к данным и т.д. Примеры: логи ERP/CRM, логи веб-серверов, логи ETL-процессов, системные журналы ОС, события безопасности.
- Бизнес-события и транзакции: данные, фиксирующие конкретные бизнес-действия: создание заказа, подтверждение платежа, обработка талона обслуживания, закрытие кейса. Эти данные часто поступают из специализированных систем управления процессами (BPM), ERP, WMS, CRM, финансовых систем.
- Взаимодействия с интерфейсами и клиентскими приложениями: клики мыши, ввод в формы, навигация по меню, скриншоты и сессии пользователя. Эти данные характеризуют реальное поведение человека в рамках задачи и позволяют увидеть неформальные шаги, которые не всегда фиксируются в бизнес-событиях.
- Временные данные и контекст: временные метки, временные зоны, локальные настройки, принадлежность к конкретной роли или подразделению, версия процесса, изменения конфигурации. Без контекста аналитика может легко неверно интерпретировать последовательности действий.
- Внешние источники: данные из систем мониторинга процессов и инфраструктуры, API-логов, данные о загрузке каналов коммуникаций (электронная почта, мессенджеры в рамках регламентируемых сценариев). В некоторых случаях внешние события могут служить индикаторами задержек и зависимостей между задачами.
Основные концепции и термины
- Запись события (event): фиксированное событие с атрибутами, обычно содержит временную метку, тип события, идентификатор кейса (задачи, процесса), название активности и дополнительные атрибуты.
- Уровень кейса (case): единица анализа — совокупность связанных между собой событий, которые образуют выполнение конкретной бизнес-задачи. В одном кейсе может быть множество активностей, переходов и людей-исполнителей.
- Активность (activity): конкретное действие или шаг внутри процесса, который может соответствовать бизнес-операции или техническому действию.
- Контекст и атрибуты: дополнительные сведения, которые помогают различать похожие случаи: подразделение, тип клиента, версия приложения, регион, тип устройства и т.д.
- Формат данных и совместимость: существование стандартов или общих форматов, что упрощает интеграцию данных из разных систем. Примеры форматов — XES, CSV, JSON, Parquet, SQL-таблицы.
- Прозрачность и происхождение данных: трейсинг данных от источника до анализа (data lineage), чтобы можно было проверить, откуда пришла каждая запись и как она преобразовывалась на этапе ETL.
Методы сбора и интеграции данных
- Инструменты агрегации логов: сбор и нормализация логов из разных систем, привязка к единым временным меткам, устранение дубликатов и коррекция временных зон.
- Инструменты прослеживания и трассировки: корреляция событий между микросервисами, сбор трассов ап на уровне distributed tracing (например, OpenTelemetry). Эти данные помогают понять зависимости между активностями в сложной архитектуре.
- Интеграция с UI-взаимодействиями: instrumentation браузера или клиентских приложений для записи кликов, прокруток, заполнения форм. Часто реализуется через встроенные SDK или скрипты мониторинга пользовательских действий.
- Привязка к контексту: объединение данных из разных источников через общий идентификатор кейса и единый таймлайн. Важно обеспечить согласование временных зон и синхронизацию времени между системами.
- Обеспечение качества данных: валидация форматов, нормализация значений, обработка пропусков, удаление дубликатов, привязка внешних идентификаторов к внутренним ключам.
Важные подходы к обработке данных
- Нормализация и унификация схем данных: приведение разных форматов к единой схеме записей события, чтобы этапность и последовательность были сопоставимы.
- Привязка к процессной модели: сопоставление событий с определенным процессом, чтобы можно было увидеть, какие варианты исполнения существуют и какие шаги являются обязательными.
- Обеспечение конфиденциальности: минимизация использования персональных данных, применение принципов data minimization, маскирование PII, а при необходимости — анонимизация и псевдонимизация.
- Контроль качества и мониторинг потоков данных: регулярные проверки на полноту (coverage), точность (accuracy) и задержку (latency) данных, настройка оповещений в случае изменений в источниках.
- Правовые и регуляторные аспекты: соответствие требованиям локального законодательства о хранении и обработке данных, включая правила локализации данных, если речь идёт о российской среде.
Практические примеры
1) Пример с открытым ПО: PM4Py и ProM
- PM4Py — это популярная библиотека на Python для анализа процессов и обработки event logs. В реальной задаче можно импортировать набор событий в формате CSV или XES, затем строить процессные модели, проводить обнаружение процессов, сравнение моделей и моделировать варианты выполнения задач. В компании можно начать с небольшого пилота: собрать логи из одного бизнес-подпроцесса, привести их к единой схеме и запустить простой алгоритм обнаружения процесса, чтобы увидеть, есть ли отклонения между запланированными шагами и фактическими.
- ProM — это открытая платформа для анализа процессов, которая поддерживает различные техники обнаружения, конвергенции и соответствия моделей. Она полезна для экспертов, которые знакомы с BPM-аналитикой и хотят визуализировать древние и новые варианты исполнения. В ProM можно работать с XES-логами, визуализировать траектории кейсов и выявлять узкие места.
2) Пример с Apromore
- Apromore — это открытое ПО и коммерческая платформа для процессного интеллекта, ориентированная на анализ процессов в реальном времени и обнаружение аномалий. В контексте Task Mining Apromore позволяет загружать event logs, строить автоматически дерева процессов, сравнивать реальный поток работ с эталонной моделью и предлагать улучшения. Apromore поддерживает гибкую интеграцию с различными источниками данных и может использоваться как промежуточный слой между данными и аналитической визуализацией.
3) Российские решения и локальные подходы
- ABBYY Timeline — российский продукт от ABBYY, ориентированный на процессный интеллект. Timeline помогает извлекать и визуализировать процессные тропы, совмещать данные из разных систем и регистрировать фактические выполнения задач. В российской практике ABBYY Timeline часто применяют для анализа цифровых следов в финансовом секторе, 제조 и логистике, где важно сопоставить фактические процессы с регламентами и стандартами.
- Локальные решения на базе SIEM и логирования: во многих российских организациях используются собственные решения для агрегации логов и событий, которые затем подключаются к инструментам для анализа процессов. В качестве примера можно упомянуть использование Elasticsearch/Logstash/Kibana (ELK-стек) или Splunk в рамках локальных инфраструктур, где логи собираются, нормализуются и публикуются в аналитику через специальные коннекторы и панели. Такие схемы хорошо работают как база для Task Mining, когда требуется высокий уровень контроля над данными внутри корпоративной сети и регуляторные требования обязывают хранить логи локально.
4) Практические кейсы и сценарии внедрения
- Кейсы в производстве: сбор данных из MES и ERP, объединение с логами оборудования и систем мониторинга. Цель — увидеть полный цикл выполнения задачи, от заказа до отгрузки, выявить узкие места и задержки в утверждении документов.
- Кейсы в банковском секторе: объединение данных из ERP, CRM и систем обслуживания клиентов. Акцент на соблюдении требований по конфиденциальности и защите данных, но с возможностью анализа моделей обработки операций клиентов, чтобы улучшить скорость обработки заявок и снизить издержки.
- Кейсы в розничной торговле: анализ последовательности действий клиента в omni-channel среде — от интернет-магазина до офлайн-покупки через систему лояльности и службы поддержки. Цель — определить идеальные пути клиента, выявить задержки и оптимизировать обслуживание.
Форматы данных и схемы
- XES (eXtensible Event Stream) — стандартный формат для записи событий процесса. Он поддерживает атрибуты: кейс, активность, временная метка, ресурс, дополнительные атрибуты. XES удобен для алгоритмов обнаружения процессов, потому что обеспечивает единый контракт между системами.
- CSV/JSON/Parquet — чаще используются внутри компаний для простых наборов данных, особенно когда речь идёт об объединении логов из нескольких источников. В этом случае важно сохранять единые названия полей и единицы времени.
- SQL-базы и REST API — многие системы предоставляют данные через API или SQL-доступ, что позволяет напрямую формировать event log из бизнес-операций и последовательностей.
Архитектура сбора и обработки данных
- Агентские сборщики логов и SDK для фронтенда: агенты на серверах или внутри приложений фиксируют события и отправляют их в централизованный хранилище. Важно обеспечить безопасный канал передачи (TLS), корректную аутентификацию и контроль доступа.
- ETL/ELT-пайплайны: сбор, очистка и нормализация данных, обогащение дополнительными атрибутами, объединение источников в единый event log. Используются инструменты вроде Apache NiFi, Airflow, или собственные конвейеры на базе Python/Scala.
- Хранилище и обработка: data lake или data warehouse, где хранятся объединённые логи; аналитические инструменты для визуализации и моделирования процессов. При больших объёмах данных выбираются форматы с эффективной компрессией и возможностью быстрого запроса (Parquet, ORC).
- Защита данных: маскирование PII, разделение прав доступа на основе ролей, аудит доступа, хранение ключей шифрования и обеспечение соответствия требованиям локального законодательства и регуляторов.
Практические детали внедрения
- Тайм-синхронизация и временные зоны: для корректного сопоставления событий важно согласовать времена между системами (NTP, часовой пояс). Ошибки синхронизации приводят к неверной последовательности действий и неверной картины процесса.
- Нормализация имен и атрибутов: единые названия полей во всех источниках (case_id, activity, timestamp, resource) позволяют легко объединять данные.
- Качество данных и обработка пропусков: пропуски могут быть вызваны разными факторами — например, отсутствием событий в логах определённых систем. В таких случаях применяют эвристические правила и дополняющие источники, чтобы сохранить целостность процесса.
- Безопасность и соответствие: внедрение минимизации данных, анонимизация, контроль доступа к данным, журналирование операций анализа. В российских условиях это особенно важно из-за требований к локализации и защите персональных данных.
Как использовать данные для анализа и вывода
- Визуализация траекторий: по каждому кейсу строится временная линейка, показывающая последовательность активностей, задержки и взаимосвязь между участниками процесса.
- Анализ вариативности: обнаружение альтернативных путей выполнения задач, выявление узких мест и «бета-тест» вариантов оптимизации.
- Соответствие регламентам: сравнение фактического потока с эталонной моделью и выявление нарушений или отклонений.
- Эффективность и продуктивность: расчет времени цикла, времени на каждую активность, загрузки сотрудников и ресурсов, что позволяет направлять улучшения в процессы и обучающие мероприятия.
Риски и ограничения
Безопасность и конфиденциальность
- Работа с персональными данными требует строгого соблюдения принципов минимизации и защиты. Необходимо внедрять анонимизацию, блокировку PII и контроль доступа к данным.
- Хранение и передача логов внутри локальной инфраструктуры может увеличить затраты и сложность эксплуатации, но снижает риски утечки за пределы организации.
Качество данных и скрытые предвзятости
- Неполноты и пропуски в данных приводят к искажению выводов, особенно если источники данных без должной координации между системами.
- Привязка событий к кейсам может быть неустойчивой, если идентификаторы исчезают или не синхронизируются. Это требует внимательного проектирования конвейеров и регулярной проверки качества.
Интеграционная сложность
- Разные системы имеют различные форматы и доступ к данным может быть ограничен политиками безопасности или ограничениями API.
- Необходимость согласования временных зон и времени фиксации событий может потребовать сложной нормализации.
Ограничения руководства и организационные вызовы
- Внедрение Task Mining требует участия разных функций: IT, бизнес-подразделения, безопасность и комплаенс. Без поддержки руководства процесс может затянуться и столкнуться с сопротивлением персонала.
- Риск переоценки ценности анализа без ясной дорожной карты и KPI.
Риск зависимости от инструментов
- При использовании коммерческих продуктов существует риск зависимости от вендора, обновлений и ценовой политики.
- Open-source решения требуют технической компетенции и устойчивой поддержки сообщества или команды внутри компании.
Источники данных для Task Mining включают в себя широкий спектр источников: системные логи, бизнес-события, взаимодействия с интерфейсами и контекстная информация, которые объединяются в единый event log. Правильный выбор источников, их корректная интеграция и качественная обработка позволяют увидеть реальный ход выполнения бизнес-задач, выявлять узкие места и предлагать целевые улучшения. Важно учитывать практики безопасности и соответствия требованиям, а также навыки команды по работе с инструментами open-source и российскими решениями, такими как ABBYY Timeline. В процессе внедрения необходим четкий план пилота, набор KPI для оценки эффекта и последовательная работа над качеством данных и готовностью организации к изменениям. При правильном подходе Task Mining превращается из теории в реальный инструмент трансформации процессов и повышения эффективности.
- Источники данных для Task Mining должны рассматриваться как часть единой архитектуры данных, где каждый источник дополняет другие и создаёт полную картину выполнения задач.
- Важно ориентироваться на этические и правовые рамки, обеспечивая защиту личной информации и соблюдение регуляторных требований.
- Открытое ПО и российские решения дают гибкость и локализацию, позволяют настраивать конвейеры под конкретные бизнес-потребности, но требуют квалифицированной команды и устойчивой поддержки.
- Начальные пилоты лучше начинать с ограниченного набора кейсов, постепенно расширяя источники и проверяя качество данных на практике.
Вопрос–Ответ (FAQ)
1) Что такое источник данных для Task Mining и зачем он нужен?
Источник данных — это место, где фиксируются события, действия и взаимодействия в рамках бизнес-процессов. Он нужен для построения единого временного ряда событий, который позволяет моделировать процесс, выявлять отклонения и визуализировать реальное выполнение задач. Без источников данных Task Mining не сможет реконструировать последовательность действий и не даст руководство для улучшений.
2) Какие типы источников наиболее важны на старте проекта?
На старте обычно начинают с:
- бизнес-событий из ERP/CRM/OMS, которые фиксируют основные шаги процесса;
- системных логов и трассировок, которые показывают техническое выполнение операций;
- пользовательских взаимодействий с интерфейсами, чтобы увидеть неформальные шаги, такие как ручной ввод, проверки и согласования. Дальше можно добавлять внешние источники и данные мониторинга.
3) Какие форматы данных предпочтительнее для task mining?
Предпочтительны форматы, которые поддерживают единый набор атрибутов: case_id, activity, timestamp, resource и дополнительные атрибуты. XES является стандартом для event logs, но CSV, JSON и Parquet удобно использовать внутри компании для первоначальных этапов. В любом случае важна консистентность и возможность объединения данных из разных источников.
4) Какие инструменты открытого кода можно использовать для начала?
- PM4Py — для обработки event logs, анализа процессов и построения моделей.
- ProM — платформа для экспертов BPM с большим набором техник анализа.
- Apromore — платформа для процессного интеллекта с поддержкой интерактивной визуализации и сравнений моделей. Эти инструменты подходят для прототипирования и тестирования идей в рамках пилотного проекта.
5) Какие российские решения можно использовать в Task Mining?
ABBYY Timeline является одним из ключевых российских решений для процессного интеллекта и task mining. Оно хорошо подходит для сбора данных из разных систем и визуализации реальных траекторий процессов. В крупных организациях часто применяются локальные решения на основе ELK-стека или SIEM для сбора логов и обеспечения локализации данных, которые затем интегрируются с аналитикой процессов.
6) Как обеспечить качество данных и корректность анализа?
- Определить единый стандарт схемы данных и соблюдение консистентности между источниками.
- Внедрить процедуры очистки и нормализации, обработку пропусков и устранение дубликатов.
- Обеспечить синхронизацию времени и корректную привязку событий к кейсам.
- Регулярно проводить проверки данных на полноту и точность, учитывать возможность изменения в процессах и системах.
7) Какие риски стоит учитывать при внедрении?
- Проблемы конфиденциальности и защиты персональных данных, риск утечки информации.
- Недостаточное качество данных, пропуски и несогласованность источников.
- Сложности интеграции и зависимость от внешних инструментов и поставщиков.
- Сопротивление сотрудников изменениям и необходимость поддержки руководства.
- Законодательные требования локализации данных и регуляторные ограничения.
8) Как начать пилотный проект по Task Mining?
- Определите ограниченный набор процессов (например, один бизнес-подпроцесс) для пилота.
- Соберите и нормализуйте данные из нескольких источников, обеспечив стабильную синхронизацию времени.
- Выберите инструмент (open-source или российский продукт) и настройте конвейер сбора и объединения данных.
- Постройте первые визуализации и модели процесса, сравните с эталонной моделью.
- Измерьте KPI: время цикла, задержки, долю отклонений, экономию на исправлениях.
- По результатам итеративно расширяйте охват источников и масштабы проекта.
9) Какова роль регулятивных требований в Task Mining?
Регуляторные требования диктуют правила обработки данных, локализацию, хранение и защиту информации. В России это может включать требования к локализации данных, хранению в рамках страны и ограничение на передачу персональных данных за пределы страны. В проектах Task Mining необходимо внедрять политики доступа, маскирование и анонимизацию, а также документировать происхождение и трансформацию данных.
10) Как оценить эффект от внедрения Task Mining? Эффект может быть оценен по нескольким направлениям:
- экономия времени и снижение времени цикла задач.
- уменьшение числа ошибок и повторной работы.
- улучшение удовлетворенности клиентов за счет более быстрого обслуживания.
- повышение прозрачности процессов и снижение рисков через выявление узких мест.
- возможность автоматизации повторяющихся действий на основе выявленных паттернов.
Итогами можно считать, что источники данных для Task Mining — это ключ к пониманию того, как реально работают бизнес-процессы. При грамотном подходе к сбору, нормализации и анализу данных вы получаете не только карту процессов, но и конкретные пути улучшений, экономическое обоснование изменений и повышение эффективности всей организации.


