

Масштабируемое развертывание
Масштабируемое развертывание в контексте Process mining — это не просто установка инструментов на одном сервере, это создание устойчивой архитектуры, способной обрабатывать возрастающие объёмы данных из множества источников, поддерживать параллельные задачи анализа в разных бизнес-домениях и обеспечивать надёжную эксплуатацию в условиях реального предприятия. Для нового сотрудника или читателя книги важно понять, что process mining сначала рождается в виде концепции и алгоритмов, а затем превращается в комплексную платформу: единое хранилище событий, коннекторы к ERP, CRM и другим источникам, движок анализа, интерфейс для бизнес-пользователя и слой управления конфигурацией и безопасностью. Масштабируемость достигается за счёт правильно спроектированной архитектуры, стандартизированных процессов интеграции, продуманной политики хранения и версионирования данных, а также автоматизации развёртывания и мониторинга. В этой главе мы разберём теоретическую базу, методологии внедрения, практические примеры — от открытых инструментов до российских подходов — и риски, связанные с масштабированием.
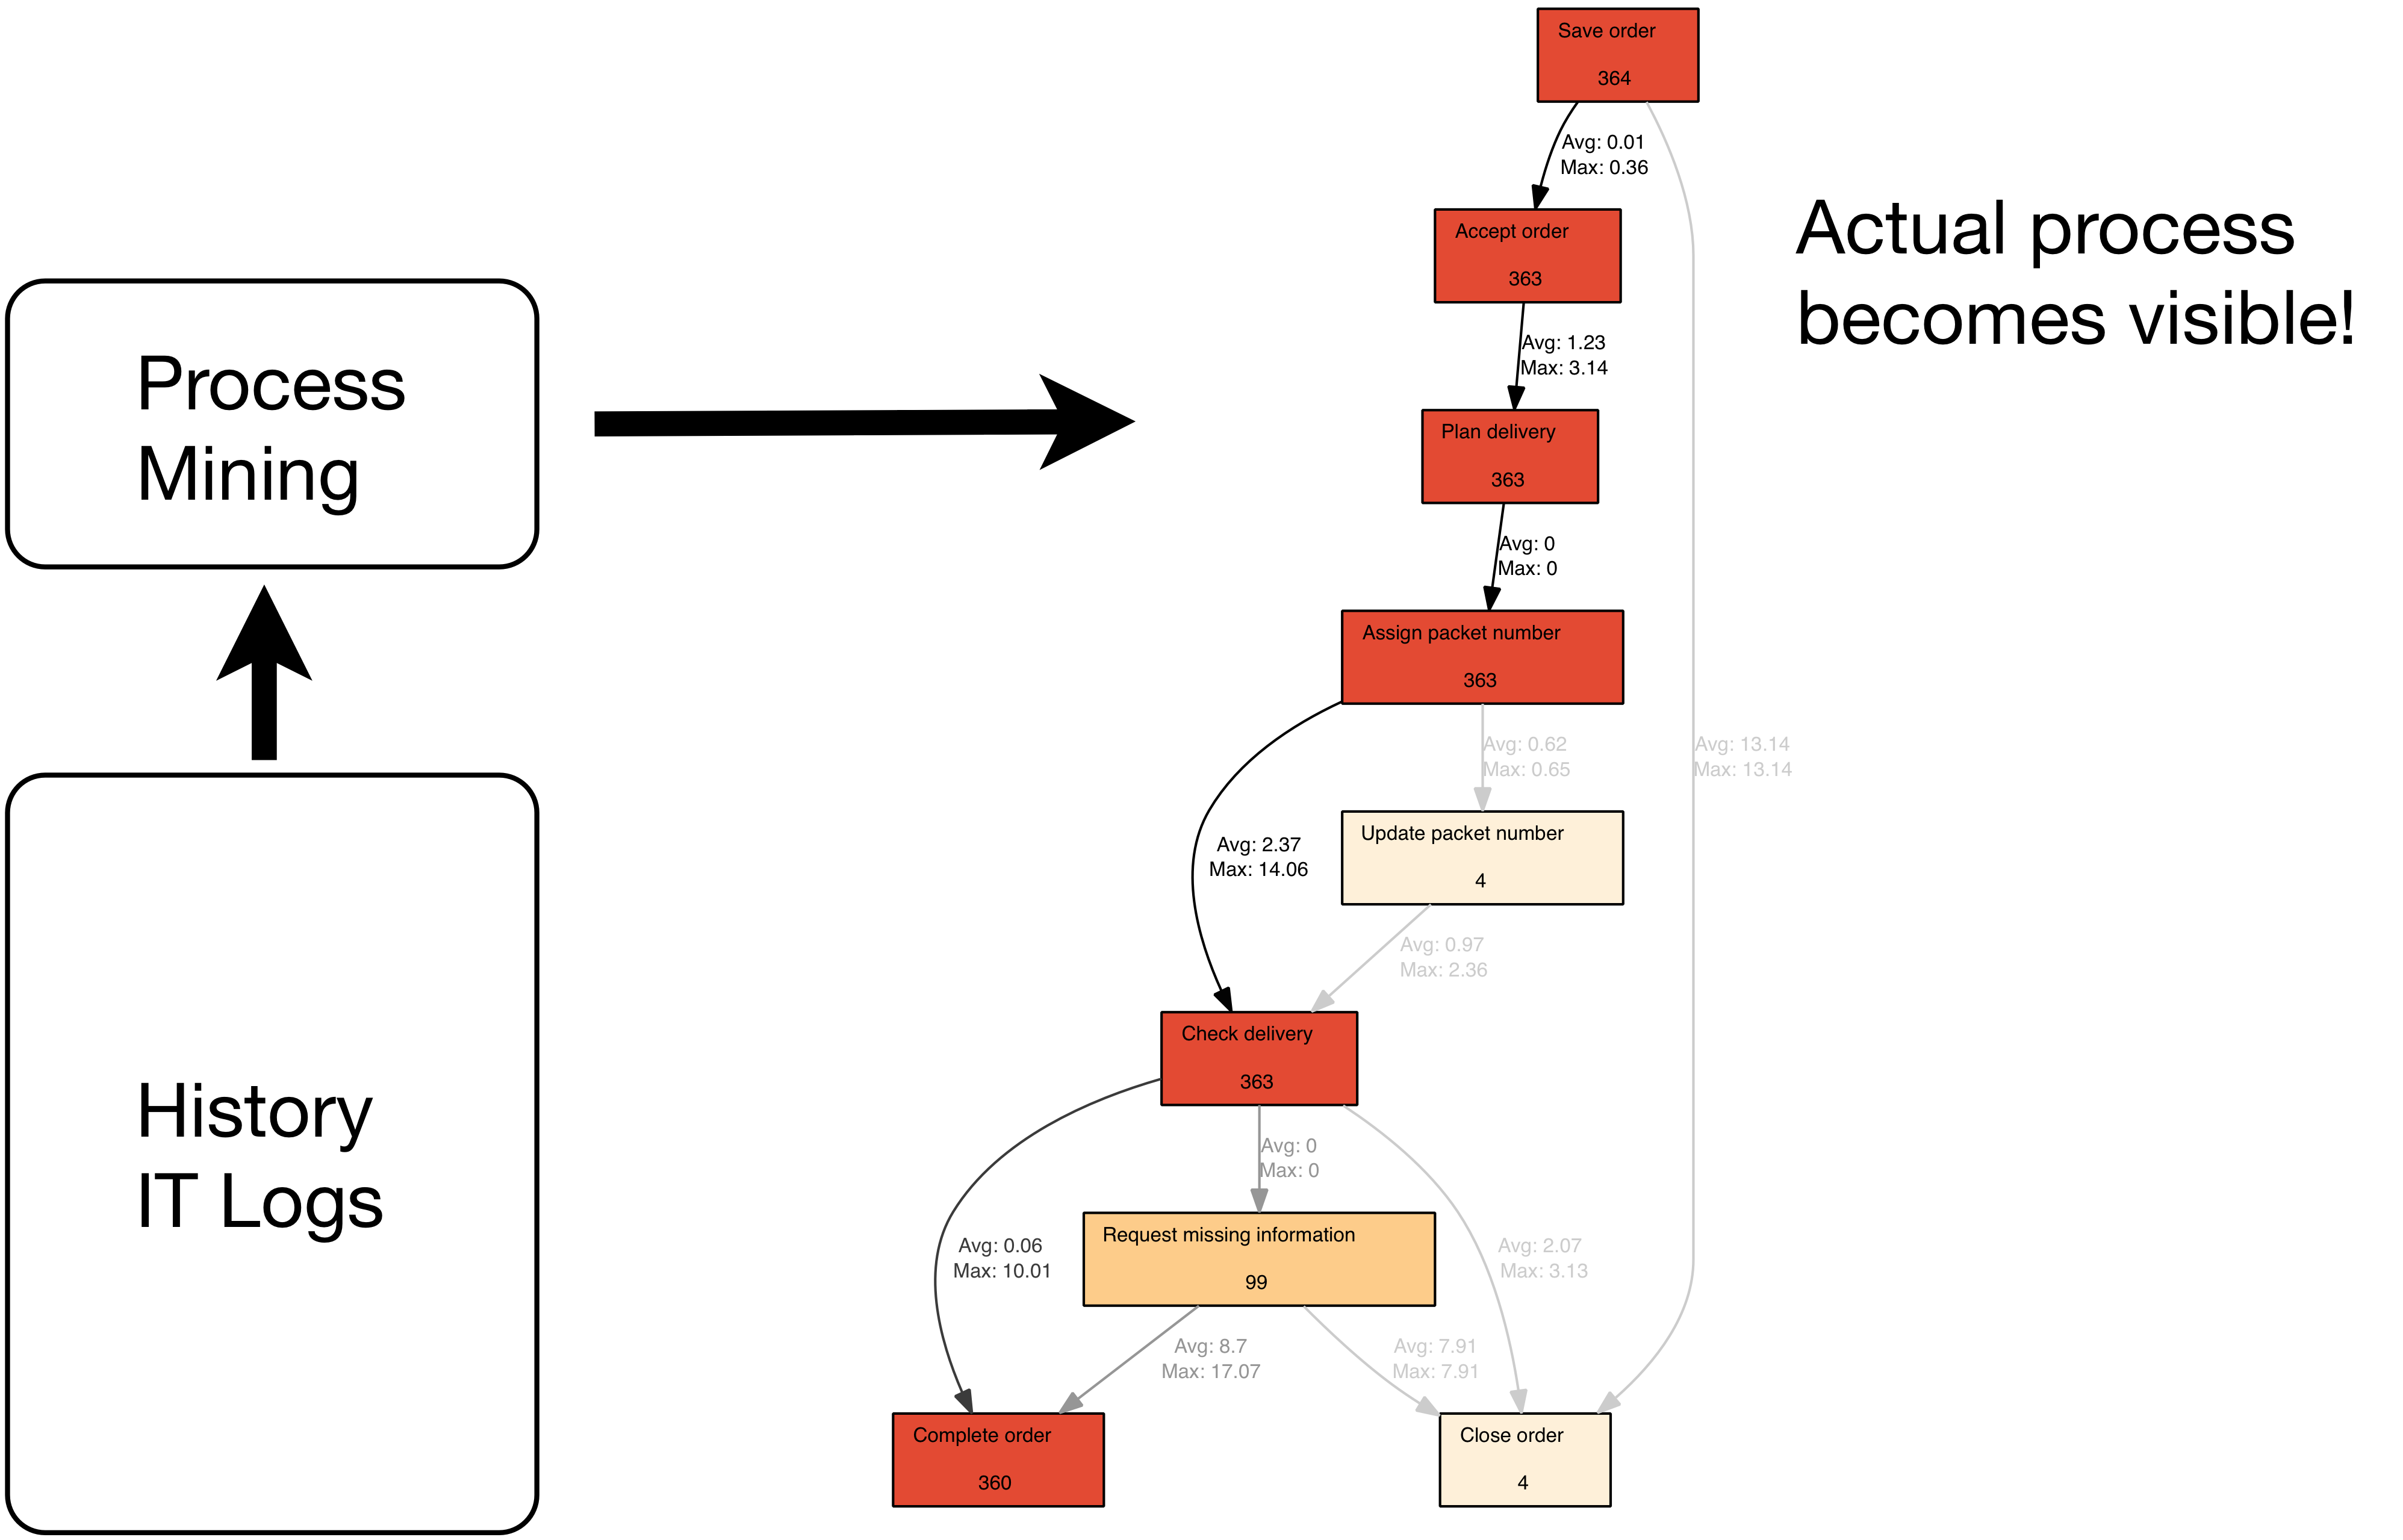
Архитектура масштабируемого развертывания
- Основная идея: процесс майнинг должен работать не на одном источнике данных, а как платформа, соединяющая множество источников событий: ERP, CRM, BPM-системы, системы финансового учёта, лог-файлы ETL/ELT-процессов, данные из сервисов и облачных приложений. В результате получается единое дерево событий, где каждый ряд соответствует конкретному событию с атрибутами: идентификатор дела (case_id), максимум временной метки, наименования активности, ресурс/пользователь и другие свойства.
- Архитектурные паттерны:
- монолитная развёртка vs распределённая: при росте объёма данных и числа доменов следует переходить к распределённой архитектуре на базе контейнеров и оркестратора, например Kubernetes.
- конвейеры данных: извлечение данных из источников, их трансформация в единый формат (например, XES или пригодный формат CSV/Parquet), загрузка в хранилище событий, последующий анализ и визуализация.
- мульти-аренда (multi-tenant): разные подразделения или домены бизнеса используют общую платформу, но с изоляцией данных и безопасностью на уровне ролей.
- режимы обработки: пакетная обработка для исторических наборов и потоковая обработка для новых данных в реальном времени или near real time.
- Технологический стек и принципы выборов:
- хранение данных: data lake на базе распределённых файловых систем (HDFS/облачные экосистемы) или колоночные хранилища (ClickHouse, Apache Parquet в дата-слое); базовые требования — хранение событий в неизменяемом виде, поддержка временных меток, тегов, индексов.
- обработка и анализ: открытые библиотеки для процесса майнинга (PM4Py, ProM) и графических интерфейсов (Apromore). Распараллеливание аналитических задач достигается через распределённые вычисления, например с использованием PySpark или задач в рамках кластера.
- интеграционные коннекторы: готовые адаптеры к ERP/CRM системам, SAP/Oracle/1C, СУБД, файловые коннекторы, API-интеграции. Важен единый формат экспорта и нормализации данных.
- оркестрация и мониторинг: Kubernetes как платформа для развёртывания сервисов; CI/CD для обновления компонентов; Prometheus/Grafana для мониторинга; ELK/OpenSearch для логирования.
- Безопасность и соответствие требованиям:
- контроль доступа: ролевая модель (RBAC), сегментация сетей, шифрование в покое и в транзите.
- защита персональных данных: минимизация личной информации в логах, удаление или псевдонимизация слабых данных, аудит доступа к данным.
- комплаенс: соответствие требованиям национального законодательства о защите данных (особенно для России — ФЗ-152 и локализация данных), возможность ведения аудита и журналирования изменений.
- Этапы внедрения и развитие масштаба:
- проектирование целевой архитектуры, согласование требований по задержке данных и дедупликации.
- пилотный развертывание с ограниченным набором источников и доменов.
- масштабирование на дополнительные домены, внедрение мульти-арендной среды и реструктуризация хранения.
- постоянное улучшение: управление версиями моделей и конвейеров, внедрение постоянного мониторинга, обновления инструментов и методик.
- Управление качеством данных и методология анализа:
- качество данных как ядро процесса: полнота, непротиворечивость и точность временных меток.
- предобработка данных: устранение дубликатов, согласование форматов, нормализация текстовых параметров, унификация кодировок.
- методологии анализа: discovery (обнаружение процессов), conformance checking (соответствие существующим моделям), enhancement (улучшение моделей дополнительной информацией), а также использование проверок fitness и precision для оценки качества моделей.
- Внедрение в условиях риска конфиденциальности и ограничений:
- локализация данных и оффлайн-охранение: важность возможности работать без выхода в глобальную сеть для чувствительных данных.
- стратегическая гибкость: возможность адаптироваться к законодательным изменениям и обновлениям в регуляторике.
- устойчивость к сбоям: резервирование, репликация, бэкапы, планы восстановления.
Термины и понятия
- процесс майнинг (process mining): прикладной подход к извлечению знаний из событийной информации о бизнес-процессах.
- событие (event): запись об одном происшествии в рамках дела (case), включает идентификатор дела, активность, временную метку и прочие атрибуты.
- журнал событий (event log): структурированная коллекция событий, используемая для анализа и построения процессов.
- α-алгоритм, Heuristics Miner, α+-алгоритм, и интерактивные методы: алгоритмы добычи процессов различной сложности для построения моделей процессов.
- конформанс-данные (conformance data): сравнение реального поведения с моделью процесса для оценки различий.
- fitness и precision: метрики качества соответствия найденной модели реальному поведению.
- enhancement: добавление информации к существующим моделям (например, роли участников, временные параметры).
- data governance: управление данными, их качеством, доступом и ответственностью.
- RBAC/ABAC: модели управления доступом, ограничивающие или разрешающие действия пользователей в системе.
- multi-tenant: архитектура, поддерживающая несколько пользователей или подразделений с изоляцией данных.
- data lake: централизованное хранилище нефильтрованных данных разной структуры.
- data provenance: трейс данных — как данные приходят в систему, какие трансформации на них применяются.
- локализация данных: хранение данных внутри определённой юрисдикции или территории.
- регуляторика и соответствие: требования законодательства и нормативных актов, влияющие на сбор, обработку и хранение данных.
Практические примеры
Общий подход к практическим примерам
- Рассматриваемые сценарии на примерах открытых инструментов демонстрируют типовую схему: сбор журналов событий, стандартизация форматов, хранение в дата-слое, запуск анализа на мощном узле или кластере, визуализация и выводы для бизнеса.
- В открытом контексте мы часто используем PM4Py и ProM для анализа и Apromore как визуализатор и конструктор моделей. Эти инструменты легко развернуть на локальном кластере или в облаке и настроить на работу с большими объёмами данных.
- В российских реалиях, помимо открытого программного обеспечения, практикуют локализованные развёртывания на отечественном оборудовании и в частных дата-центрах. В anonymized кейсах российские организации строят инфраструктуру на базе отечественных или локализованных решений для хранения данных и обеспечения регуляторной совместимости, чтобы обеспечить локализацию данных, контроль доступа, аудит и соответствие требованиям.
Пример 1. Архитектура на основе открытых инструментов (пилот)
- Источники данных: ERP-система, CRM, файловые логи, системы учёта.
- Конвейер данных: коннекторы собирают события, нормализуют их, сохраняют в формате журнала (XES или JSON/Parquet) в дата-слейке.
- Хранилище: дата-слой на базе ClickHouse или Hadoop-совместимого хранилища; для аналитических запросов используется индексация и агрегации по временным интервалам.
- Аналитика: PM4Py выполняет discovery и conformance checking на выборке исторических данных; Apromore предоставляет UI для бизнес-пользователей и для аналитиков.
- Визуализация и выводы: Grafana или встроенная панель Apromore для представления процессов, индикаторов задержек, узких мест и соответствий.
- Инфраструктура: Kubernetes, Docker-контейнеры, CI/CD для обновления инструментов, мониторинг через Prometheus и алертинг через Alertmanager.
- Безопасность: RBAC, шифрование на диске, TLS для передачи, аудит доступа к журналам.
Пример 2. Масштабирование в российской практике (анонимизированный кейс)
- Контекст: крупная финансовая организация внедряет процесс майнинг для подразделения по учетом рисков и комплаенсу.
- Архитектура: локальная дата-ферма внутри частного облака, чтобы обеспечить локализацию данных. Используется отечественный стек контейнеризации и оркестрации.
- Данные: журналы событий из ERP, банковской системы и внутреннего BPM-решения. Форматы нормализованы и приведены к единому стандарту.
- Инфраструктура: PostgreSQL/ClickHouse для хранения агрегированных журналов, Kafka для потоковой передачи событий, Airflow для оркестрации ETL/ELT-процессов, PM4Py и часть функциональности Apromore для анализа.
- Безопасность: строгие политики RBAC, сегментация сети, аудит и сертификация соответствующих компонентов; хранение персональных данных — с использованием псевдонимизации и минимизации данных.
- Результат: улучшение обнаружения узких мест, снижение времени цикла обработки выполнений операций и повышение прозрачности бизнес-процессов для регуляторов.
- Вывод: такой подход позволяет масштабировать обработку данных across多个 доменов и поддерживать требования локализации и защиты данных.
Пример 3. Пример интеграции с отечественными системами и отечественной инфраструктурой
- Контекст: служебная деятельность малого и среднего бизнеса, который хочет начать процесс майнинг с минимальными затратами на лицензии и максимальной адаптацией под локальные требования.
- Архитектура: использование открытых инструментов на открытой платформе в облаке, с возможностью переноса в локальный дата-центр. В качестве базы данных — смесь Parquet и PostgreSQL; обработка — PM4Py; UI — Apromore Community Edition.
- Конфигурация: коннекторы к ERP и системе документооборота, конфигурация слоёв данных и безопасной передачи.
- Итог: получение первых весомых выводов о узких местах и возможности расширения.
Форматы журналов и данные
- Журналы событий хранятся в единообразном формате: case_id (идентификатор дела), activity (название действия), timestamp (временная метка), resource/actor (исполнитель), дополнительные атрибуты (партия, сумма, регион и т.д.).
- Поддерживаются форматы XES, CSV/Parquet, JSON. В больших системах предпочтительно использовать Parquet для эффективного сжатия и быстрого доступа.
- Метки и атрибуты должны быть согласованы: единый набор атрибутов обеспечивает сопоставимость между источниками и упрощает последующий анализ.
Конвейеры и интеграция
- Интеграция с ERP/CRM и другими системами: чаще всего через коннекторы REST/SOAP, DB-звенья, или через ETL-инструменты, которые приводят данные к единому формату журнала.
- ETL/ELT-процессы: пакетная загрузка исторических данных и потоковая вставка новых событий. В режимах реального времени можно обрабатывать потоки через Kafka и обрабатывать события в микро-сервисах.
- Данные в дата-слое: данные хранятся в слое "журнала событий" или в промежуточном слое, откуда происходят выборки для конкретных задач анализа. Немаловажно обеспечить неизменяемость и аудируемость исходных данных.
Аналитика и инфраструктура
- Аналитика: использование PM4Py дляDiscovery (Alpha, Heuristics, Ínductive Miner) и Conformance Checking; Apromore для визуализации и интерактивной доработки моделей.
- Графический интерфейс: Apromore предоставляет удобный UI для бизнес-пользователя и для анализа качества модели; ProM — для отдельных алгоритмов и исследовательских целей.
- Масштабирование: горизонтальное масштабирование за счёт Kubernetes. Бесшовное масштабирование аналитических сервисов и коннекторов, управление версиями образов, мониторинг и логирование.
Безопасность и соответствие
- RBAC: строго заданные роли: аналитик, бизнес-оператор, администратор, регулятор; разграничение доступа к данным в рамках каждого домена.
- Шифрование: TLS для передачи; шифрование в покое на дисках; контроль доступа к ключам шифрования.
- Данные и регуляторика: минимизация персональных данных; псевдонимизация; аудит действий пользователей и изменение журналов, хранение истории изменений.
Процедуры развертывания и эксплуатация
- Контейнеризация сервисов и конфигураций; использование Helm-чартов или аналогов для упрощения развёртывания.
- CI/CD: автоматическое развёртывание обновлений инструментов; миграции схем журнала событий; тестирование на тестовой среде перед продакшеном.
- Мониторинг и устойчивость: Prometheus/Grafana, алертинг по задержкам обработки данных, загрузке CPU/memory; логирование через OpenSearch/ELK или аналоги.
Метрики эффективности
- Время цикла обработки (cycle time) по доменам; задержки между событием и регистрацией; полнота и точность журнала; доля узких мест, которые можно устранить через оптимизацию.
- Стоимость владения и окупаемость: анализ затрат на инфраструктуру, лицензии и ресурсы по сравнению с экономическими выгодами от выявления узких мест и повышения эффективности процессов.
Пул данных и качество
- Источники: ERP, CRM, финансовые системы, BPM. Все источники должны поддерживать синхронизацию и иметь сопутствующую документацию по данным.
- Качество: периодические проверки на полноту, консистентность и точность временных меток; устранение пропусков, повторов и несоответствий.
Пример конфигурации развёртывания
- Узловые сервисы: аналитические сервисы на базе PM4Py, UI Apromore, база журналов, коннекторы к источникам.
- Хранилище: дата-слой на основе ClickHouse или Parquet/HDFS, база данных для хранения метаданных и результатов анализа.
- Оркестрация: Kubernetes с горизонтальным масштабированием, REST-API для интеграции и управления конфигурациями.
- Безопасность: RBAC и аутентификация через корпоративную идентификацию, шифрование и аудит.
Примеры шагов миграции к масштабируемому решению
- Определение критичных доменов и источников; проектирование целевой архитектуры; пилот на малом объёме данных.
- Постепенное добавление новых доменов; настройка коннекторов и трансформаций; обеспечение согласованности форматов.
- Обеспечение безопасности и соответствия; настройка аудита и мониторинга.
- Постепенное расширение инфраструктуры: увеличение числа нод, переход к многопользовательской среде, внедрение мульти-аренды.
Риски и ограничения
Качество и полнота данных
- Неполные, дубликаты или несогласованные журналы приводят к искажению моделей и неверным выводам.
- Решение: установить процесс управления качеством данных, определить минимальный набор атрибутов, реализовать предобработку и нормализацию.
Безопасность и конфиденциальность
- Обработку персональных данных нельзя проводить вне регламентированного контекста, возможны риски утечек и нарушения конфиденциальности.
- Решение: минимизация данных, псевдонимизация, контроль доступа, аудит, соответствие требованиям регуляторов.
Регуляторика и локализация
- Нормативные требования к локализации данных, аудитам и управлению данными в российских дата-центрах могут повлиять на архитектуру.
- Решение: строить инфраструктуру внутри страны, поддерживать возможность локального хранения оригиналов и кэширования результатов.
Стоимость и ресурсы
- Масштабируемые решения требуют инвестиций в инфраструктуру, хранение, вычислительную мощность и обучение персонала.
- Решение: планировать бюджет на этапе пилота, внедрять поэтапно, оценивать экономическую эффективность после каждого этапа.
Интеграции и совместимость
- Разнообразие источников данных усложняет интеграцию и поддержание синхронности.
- Решение: использовать стандартные коннекторы и единый формат журнала событий, документировать изменения.
Технический управляемый риск
- Увеличение числа сервисов ведет к сложности эксплуатации, необходима дисциплина эксплуатации, мониторинг и устойчивые процессы обновления.
- Решение: формализовать SRE-процедуры, мониторинг и плана восстановления после сбоев.
Навыки и кадровый дефицит
- Нужны специалисты по данным, эксперты по process mining, инженеры DevOps/SE, специалисты по безопасности и регуляторике.
- Решение: развивать обучение сотрудников, привлекать внешних консультантов на старте, использовать обучающие материалы и курсы.
Этические и операционные аспекты
- Применение майнинга на земле бизнеса может вызывать вопросы конфиденциальности, прозрачности и доверия.
- Решение: открытые политики по использованию анализа, уведомления бизнес-пользователей и прозрачные отчётности.
Масштабируемое развертывание процесса майнинга требует продуманной архитектуры, дисциплины по данным и безопасности, а также ясной дорожной карты внедрения. В основе лежат единый журнал событий, стандартизированный конвейер обработки и современные технологии для анализа на уровне предприятия. Открытые инструменты, такие как PM4Py, ProM и Apromore, дают мощные средства для быстрого старта и последующего масштабирования, в то же время российские решения и локализованные архитектуры позволяют соответствовать требованиям локального законодательства, региональной локализации и специфическим условиям бизнеса. Важно помнить, что масштабирование — это не только увеличение числа серверов, но и повышения сложности управления данными, усиление политики безопасности, улучшение процессов и обмен знаниями внутри организации. Постепенное и планомерное внедрение в сочетании с контролируемыми рисками и эффективной организацией приведёт к устойчивому созданию ценности через глубокий анализ процессов и грамотное улучшение бизнес-процессов.
FAQ — Вопрос–Ответ
1) Что такое масштабируемое развертывание в Process mining и зачем оно нужно?
Ответ: Масштабируемое развертывание — это построение архитектуры и процессов, которые позволяют одновременно работать с множеством доменов и больших объемов журналов событий, обеспечивая устойчивую работу аналитики, безопасность и соответствие регуляторике. Это позволяет выявлять узкие места на уровне всей организации, а не только отдельных подразделений, и обеспечивает возможность расширяться по мере роста бизнеса.
2) Какие архитектурные паттерны лучше всего применять для масштабирования?
Ответ: Рекомендуются распределённые паттерны с контейнеризацией на базе Kubernetes, мульти-арендная изоляция, единый формат журнала событий, потоковая часть через Kafka или аналогичные системы, и хранение данных в дата-слое с поддержкой быстрых аналитических запросов (ClickHouse, Parquet). Важна гибкость конвейеров и возможность добавлять новые источники без переконфигурации всей платформы.
3) Какие инструменты и решения можно использовать в открытом доступе?
Ответ: На практике применяют PM4Py и ProM для алгоритмов анализа, Apromore для визуализации и работы с моделями. В качестве хранилища и конвейеров — дата-слой на базе ClickHouse, Apache Kafka, Apache Airflow, Spark/PySpark. Для мониторинга — Prometheus и Grafana. Эти инструменты позволяют быстро развернуть пилот и затем масштабировать платформу.
4) Как обеспечить безопасность и соответствие требованиям?
Ответ: Необходимо внедрить RBAC или ABAC для контроля доступа, шифрование данных на диске и в передаче, аудит действий пользователей, минимизацию и псевдонимизацию данных с учётом регуляторики. В России также важно учитывать требования локализации данных и возможность работать внутри локального дата-центра или частного облака.
5) Какие риски связаны с внедрением и как их минимизировать?
Ответ: Основные риски — качество данных, регуляторные требования, стоимость и сложность эксплуатации, интеграции и кадровый дефицит. Минимизировать их можно через планирование пилота, строгие политики качества данных, защиту конфиденциальности, поэтапное масштабирование и обучение сотрудников.
6) Какой набор метрик полезен для оценки эффективности масштабирования?
Ответ: Время цикла обработки, задержка данных, полнота/точность журнала, доля узких мест, экономическая окупаемость проекта, доступность сервисов и средняя задержка анализа. Эти метрики позволяют видеть как качество анализа, так и экономическую устойчивость проекта.
7) Как начать пилот и превратить его в масштабируемое решение?
Ответ: Начинать нужно с ограниченного набора источников и одного домена, определить целевые показатели и требования к задержкам. Постепенно добавлять источники, усиливать архитектуру и безопасность, внедрять мониторинг и CI/CD. В рамках пилота важно зафиксировать архитектуру, процедуры управления данными и принципы эксплуатации.
8) Какие есть российские подходы и чем они отличаются от открытых инструментов?
Ответ: Российские подходы часто ориентированы на локализацию данных, соответствие национальным требованиям к безопасности и регуляторике, а также совместимость с отечественным облачным и датацентрическим гиперскейл-решениям. В сочетании с открытыми инструментами это позволяет достичь баланса между функциональностью и соблюдением законодательства, а также позволяет использовать внутреннюю инфраструктуру без зависимости от зарубежных сервисов.
9) Какие требования к данным особенно критичны для масштабируемого развертывания?
Ответ: Необходимо обеспечить единый формат журнала событий, согласованность временных меток, полноту и точность данных, отсутствие дубликатов, корректное сопоставление между источниками. Также важны требования к защите персональных данных, аудит и журналирование изменений.
10) Что важно помнить при выборе стратегии развертывания?
Ответ: Важно выбрать стратегию, которая позволяет быстро запустить пилот, но при этом имеет план перехода к масштабируемой архитектуре, обеспечивает безопасность и соответствие и позволяет добавлять новые домены с минимальными усилиями. Гибкость архитектуры и дисциплина в управлении данными — ключ к успешному развёртыванию в условиях растущих объёмов и сложности данных.


