

Персонализация: концепции, сценарии и адаптивная подстройка
Персонализация в контексте CDP (Customer Data Platform) - это не просто выбор конкретного предложения для клиента. Это системное управление единым профилем клиента, его поведением и контекстом взаимодействия, превращающее массив данных в целевые, своевременные и релевантные коммуникации через все точки контакта. В продуктовой концепции CDP персонализация выступает как функция платформы, реализуемая через взаимосвязанные компоненты: единая идентификация и профиль, сегментацию, правила и модели принятия решений, контент- и оффер-менеджмент, а также поток активации в каналы. В рамках данного раздела рассматриваются не только принципы, но и конкретные продуктовые решения и практики внедрения, которые позволяют маркетингу и продажам действовать синхронно и эффективно.
Персонализация в CDP опирается на единый, обновляемый в реальном времени профиль клиента, объединяющий онлайн- и офлайн-истории, транзакции и взаимодействия. Целью является предложение наиболее релевантного контента, продукта или предложения в нужный момент и через подходящий канал, учитывая правовые рамки и предпочтения клиента. В продуктовой парадигме это достигается за счет архитектуры, где данные проходят через идентичную карту идентификаторов, проходят этапы очистки и нормализации, и затем направляются в движок персонализации, который принимает решения и активирует их в каналах коммуникации или в CRM-системе продаж. Такой подход требует четко выстроенной архитектуры, управляемых процессов и постоянного мониторинга качества данных.
- Краткое содержание главы
- Концепции персонализации и требования к данным в CDP
- Компоненты продукта CDP, обеспечивающие персонализацию
- Практические сценарии внедрения персонализации в маркетинге и продажах
- Адаптивная подстройка: модели, правила, мониторинг и управление рисками
- Управление данными, безопасность и соответствие требованиям
Концепции персонализации в CDP и требования к данным
Персонализация может быть реализована по нескольким парадигмам. В рамках CDP наиболее релевантны три:
- 1:1 персонализация, когда каждое взаимодействие подстраивается под конкретного пользователя;
- микро- или сегментационная персонализация, когда действие определяется для узкого сегмента внутри широкой аудитории;
- контекстная персонализация, учитывающая текущее окружение клиента (канал, устройство, время, география). Важно понимать, что чем глубже уровень кастомизации, тем выше требования к данным и к скорости обработки событий. Реальная мощь CDP проявляется в реальном времени: решение должно быть приняно за доли секунды, чтобы контент и офферы были актуальны в момент взаимодействия.
Единый профиль клиента - основа персонализации. Это не статический набор полей, а динамический объект, который эволюционирует по мере появления новых данных: поведения на сайте, просмотренных продуктах, покупках, отложенных корзинах, взаимодействиях в мобильном приложении, CRM-истории и оффлайн-досье (POS, колл-центр). Интегральной частью становится Identity Resolution и Identity Graph: сопоставление различных идентификаторов (email, GUID, мобильный номер, cookies, device IDs) и устранение дубликатов. Такой подход обеспечивает “правильного клиента” под нужный контекст, улучшает точность сегментации и снижает фрагментацию данных между каналами.
Ключевые архитектурные требования к данным для персонализации включают: качество данных, полноту и согласованность, управление коррекциями и версионностью профиля, а также управление согласиями и ограничениями на обработку персональных данных. Без прозрачной политики качества данных и эффективной защиты персональных данных любые попытки персонализации рискуют обернуться потерей доверия клиентов и штрафами. В product-подходе это означает наличие встроенных механизмов контроля качества данных, журналирования изменений профилей, а также четких политик хранения и удаления данных в соответствии с регуляторикой.
Гибкость и масштабируемость становятся критическими. Персонализация должна работать не только на одной канальной платформе, но и в кросс-канальном режиме: сайт, мобильное приложение, email, push-уведомления, SMS, соцсети и офлайн-каналы. Реалистичная подстройка учитывает не только поведение клиента, но и контекст взаимодействия, время реакции клиента и предиктивные сигналы. Наконец, соблюдение приватности - обязательный компонент: согласие на обработку данных, кросс-датная минимизация, обеспечение права на приватность, возможность отключения персонализации и обеспечения доступа к данным для аудитории.
В рамках продуктовой парадигмы CDP роль архитектуры - не только «хранилище», но и движок, который связывает данные с бизнес-правилами и моделями. Реализация требует ясной картины потоков данных: ingestion -> идентификация и унификация профилей -> сегментация -> правилно-логическая или ML-логика принятия решений -> активация через каналы -> измерение результатов, замыкание обратной связи.
- Важные аспекты architectural-багажа:
- единый профиль и граф идентичности, устойчивый к дубликатам;
- гибкое создание сегментов и триггеров;
- движок принятия решений (rule-based и/или ML-based);
- интеграции с системами активации и контента;
- мониторинг качества данных, соответствия и производительности;
- управление изменениями и аудит.
Компоненты продукта CDP, обеспечивающие персонализацию
Современная CDP-архитектура для персонализации опирается на набор взаимосвязанных компонентов, где каждый элемент закрывает конкретную функциональную потребность. В продуктовой парадигме они должны быть предсказуемыми, масштабируемыми и простыми в внедрении, чтобы заказчики могли быстро переходить к активной работе с персонализацией.
-
Единая карта идентичности и унифицированный профиль. Главный компонент, который обеспечивает консолидацию данных из разных источников в единый, обновляемый в реальном времени профиль клиента. В рамках архитектуры это реализуется через граф идентичности и слой сопоставления идентификаторов: email, телефон, cookies, идентификаторы устройств и CRM-идентификаторы синхронизируются и согласуются.
-
Сегментационный движок. Это ядро для создания сегментов на основе правил и предиктов, а иногда и ML-моделей. В продуктах чаще всего встречаются как простые правило-основанные сегменты, так и продвинутые динамические аудитории, которые обновляются на основе событий в реальном времени. Важно, чтобы движок поддерживал автоматическое обновление сегментов и их использование в активации в реальном времени.
-
Движок персонализации и решения. Он отвечает за принятие решений и подбор офферов, контента и канала активации. В продвинутом исполнении здесь присутствуют правила (policy-based) и ML-модели (ML-based decisioning), а также гибкая поддержка событий и контекста. В задачах движка - выбор конкретного оффера, подбор персонализированного контента и настройка условий активации.
-
Контент- и оффер-менеджмент. Управление креативами, шаблонами сообщений, продуктами и предложениями, которые будут выводиться клиенту. В некоторых продуктах это тесно связано с Content Management System (CMS) и рекламной платформой. Важна интеграционная совместимость с каналами и возможность динамического формирования контента под сегмент.
-
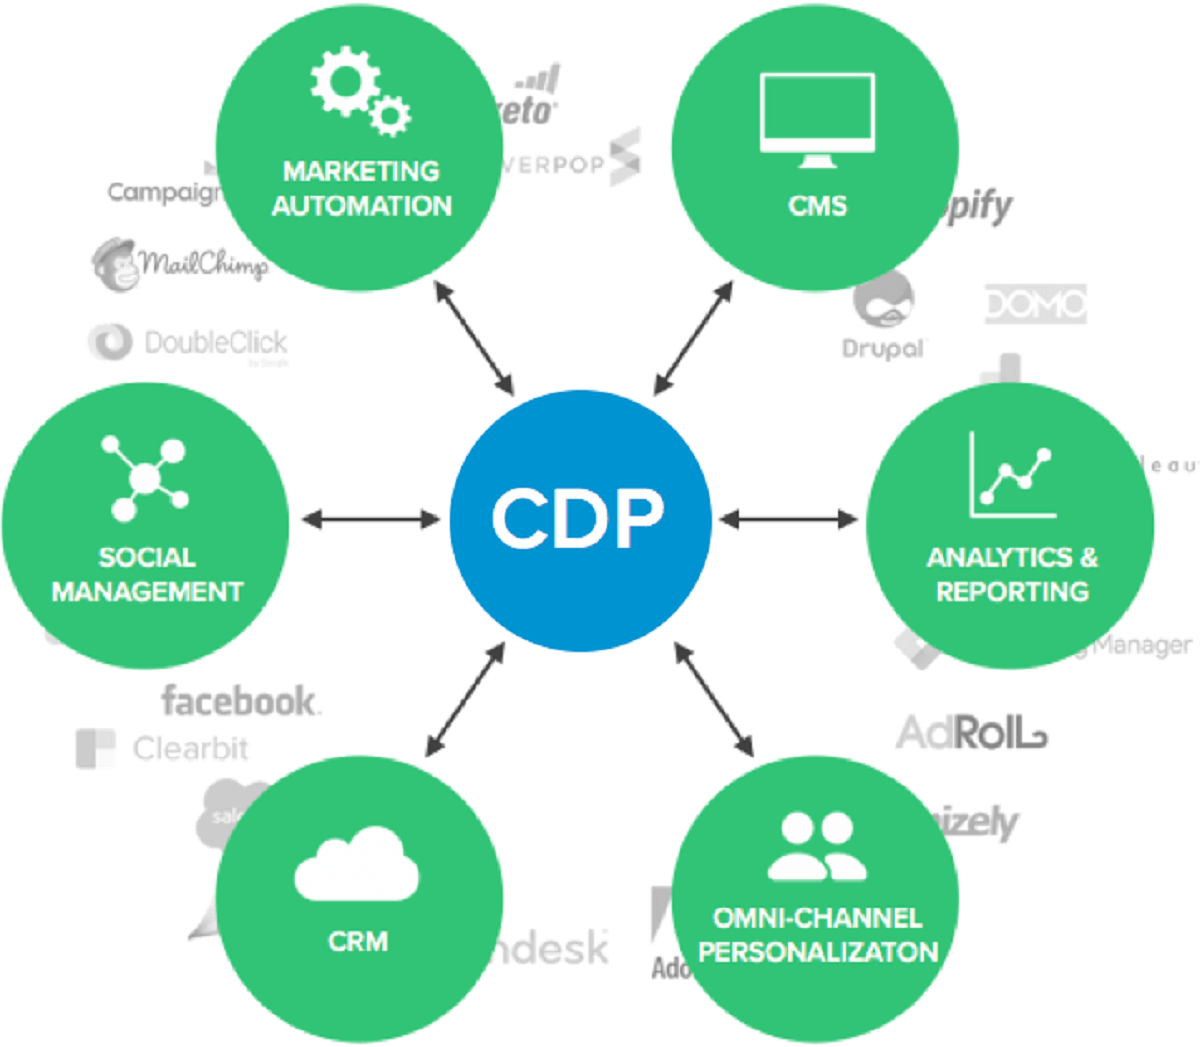
Активационные каналы и решения для оркестрации. CDP должна обеспечивать передачу персонализированных действий в email-, push-, веб- и офлайн-каналы, а также в CRM-систему продаж. Оркестрационная логика обеспечивает сценарии мультиточечного взаимодействия, управление последовательностями контактов (journeys) и задержки между шагами.
-
Аналитика, измерение и атрибуция. Платформа должна предоставлять показатели эффективности персонализации: конверсия, CTR, участие клиента, линейка атрибуции и ROI кампаний. В идеальном случае присутствуют дашборды для оперативной оценки и инструменты для ретроспективного анализа.
-
Управление данными и соблюдение требований. Компонент governance охватывает качество данных, lineage, контроль доступа, аудит изменений и управление согласиями. Встроенные политики защиты данных и механизмы удаления данных позволяют соблюдать регуляторику и требования клиента.
-
Инфраструктура и интеграции. Реализация на уровне продукта требует поддержки интеграций с источниками данных, системами CRM и маркетинговыми платформами. Инфраструктурные решения, как открытые проекты, часто участвуют в стеке: например, Apache Kafka обеспечивает ingestion и потоковую передачу событий, Apache Flink - обработку стриминговых вычислений и реального времени. Эти технологии, применяемые на уровне инфраструкутры, позволяют построить устойчивую, масштабируемую архитектуру под персонализацию в CDP.
В рамках примерной архитектуры продукта можно отметить, что CDP-решение зачастую строится на сочетании внутренних компонентов и внешних инструментов. В качестве инфраструктурной основы применяются открытые проекты, например Apache Kafka и Apache Flink, которые обеспечивают входящие события, их обработку и доставку в движок персонализации. Для аналитического слоя можно предусматривать адаптивную визуализацию и OLAP-исполнение, что упрощает мониторинг эффективности персонализации и управление данными. В контексте игроки на рынке часто выбирают модульную реализацию: профиль и идентификация - отдельно, сегментация - отдельно, активация - отдельно, но в рамках единого интерфейса и согласованных API.
На уровне Open Source примечание. Инфраструктурные решения часто строятся на открытых проектах. Например, Kafka обеспечивает потоковую передачу событий между системами, а Flink обеспечивает обработку стримов в реальном времени. Эти два компонента позволяют реализовать реальную адаптивную подстройку персонализации: события пользователей приходят мгновенно, движок принимает решения и в реальном времени активирует офферы или контент. В рамках продукта это означает, что интеграция с этими технологиями должна быть простой и поддерживаемой, с четкой схемой управления зависимостями и обновлениями.
Практические сценарии внедрения персонализации в маркетинге и продажах
Персонализация превращает данные в активный поток, который поддерживает как маркетинговые кампании, так и работу отдела продаж. Ниже представлены наиболее типовые и востребованные сценарии внедрения в рамках CDP.
-
Веб- и мобильная персонализация в реальном времени. На сайте и в мобильном приложении клиент видит контент и предложения, адаптированные под текущий контекст: поведение на сайте, предыдущие покупки, стадии жизненного цикла и географическое положение. Такой сценарий требует низкой задержки принятия решений и тесной интеграции с CMS/контент-ресурсами.
-
Персонализация email и push-уведомлений. Триггерные кампании строятся на событиях: уход из корзины, повторная активация, достижение порога лояльности. Важна согласованность данных между профилем и офферами, чтобы избежать несоответствия между каналами и обеспечить непрерывность клиентского опыта.
-
Персонализация в CRM и продажах. В продажах важна доступность персонализированной информации менеджерам: рекомендации, контекст предстоящих встреч, истории взаимодействий и актуальные предложения. Это повышает конверсию по продажам и сокращает цикл сделки.
-
cross-channel и journey orchestration. Эффективная персонализация требует не только отдельных сценариев в каждом канале, но и координации между каналами. Оркестрация позволяет держать клиента в курсе всех точек контакта, избегая дублирования офферов и противоречий в контенте.
-
A/B/C тестирования и адаптивные правила. Вставка новых персонализационных подходов требует проверки гипотез и мониторинга результатов. В рамках продукта это может быть реализовано через тестовую среду и управление версиями правил, а также через пороги для постепенного внедрения.
-
Интеграция с офлайн-данными и POS. В рамках CDP крайне полезна возможность объединения онлайн-данных с офлайн-историями клиентов и торговых операций. Это позволяет унифицировать профиль, формировать точные сегменты и предлагать релевантные офферы в магазинах и на кассе.
-
Управление предложениями и контентом. Контент-менеджеры и маркетологи получают удобные инструменты для настройки офферов, шаблонов писем и сценариев взаимодействия. Важно обеспечить возможность быстро адаптировать предложения к изменениям в спросе, сезонности и активности конкурентов.
-
Модели и правила адаптивной подстройки. В продуктовой реализации часто сочетаются правила (условия) и ML-модели. Редко встречаются чисто правило-ориентированные подходы для сложных контекстов, но ML-модели позволяют учитывать сложные зависимости и динамику спроса. Важно обеспечить прозрачность решений и возможность аудита моделей.
-
Мониторинг и качество данных. В рамках сценариев персонализации необходимо постоянное отслеживание качества данных и корректность поведения системы. Это включает мониторинг латентности, ошибок интеграций, согласованности профилей и контроль за регуляторикой.
Адаптивная подстройка: алгоритмы, правила и процессы
Адаптивная подстройка - это системная связка между правилами управления и ML-моделями, которая позволяет постоянно улучшать точность персонализации на основе обратной связи и изменений контекста. В продуктовой реализации это выражается в гибком движке решений, который может переключаться между режимами: rule-based, ML-based и гибридной стратегией.
-
Правила и политика принятия решений (policy-based). Правила задаются бизнес-лесами: по каким условиям активировать конкретный оффер, какие сегменты использовать в конкретном канале, какие контексты считать релевантными. Правила обеспечивают прозрачность и управляемость, особенно в ранних стадиях внедрения. Они позволяют быстро запустить персонализацию и быстро адаптироваться к требованиям регуляторов.
-
Машинное обучение и режим онлайн-инференса. ML-модели позволяют учитывать сложные паттерны поведения клиента и предсказывать реакции на офферы. В продуктах часто применяют модели, которые обучаются на собранных данных и применяются в реальном времени для выбора оптимального оффера. Важной частью здесь является регистр моделей, контроль версий и мониторинг качества предсказаний.
-
Гибридный подход. Часто наиболее эффективной оказывается комбинация правил и ML. Правила обеспечивают базовую устойчивость и контроль над рисками, тогда как ML-модели повышают точность и адаптивность в условиях изменяющейся реальности.
-
Валидация и оценка эффективности. Важно планировать процесс A/B-тестирования и мультивариантных экспериментов для оценки влияния адаптивной подстройки на ключевые KPI: конверсию, средний чек, вовлеченность и LTV. Результаты тестов должны внедряться через контролируемые релизы и версионирование сценариев.
-
Обратная связь и мониторинг. Системы должны собирать сигналы эффективности, Drift-мониторинг моделей и здравый смысл при сбоях. Контроль за шансами ошибок принятия решений и за рисками, такими как ошибка персонализации и несогласование с контекстом клиента, являются частью процессов управления.
-
Этические и регуляторные аспекты. Adaptive-подстройка должна учитывать ограничение на обработку персональных данных, политику согласий, минимизацию данных и возможность отзыва согласия. Встроенные механизмы аудита и прозрачности решений помогают снизить риск.
-
Метрики адаптивности. Важными метриками являются latency принятия решения, uptime движка, точность предиктов, uplift по KPI, rate of opt-out, и accuracy of profiling. Метрики должны быть привязаны к бизнес-целям и регулярно пересматриваться.
-
Архитектурные паттерны под адаптивность. Реализация может включать микросервисы движка принятия решений, сервисы управления правилами, модель-реестр и сервисы активации. Важна совместимость API между компонентами и поддержка версий правил и моделей, чтобы переход между режимами был безопасным и предсказуемым.
Управление данными, безопасность и соответствие требованиям
Персонализация в CDP опирается на обработку фокусированных и детализированных данных клиентов. Эффективное управление данными, безопасность и соответствие требованиям - основа доверия и устойчивости бизнес-процессов.
-
Качество данных и lineage. Для персонализации критично иметь ясную карту происхождения данных, их преобразований и зависимостей между источниками. Наличие lineage позволяет проводить аудит, определять источник ошибок и восстанавливать данные после инцидентов.
-
Управление идентификацией и дубликатами. Эффективная идентификация требует минимизации дубликатов и устойчивой консолидации идентификаторов. В рамках product-подхода следует поддерживать политики сопоставления и верификации идентификаторов, а также устойчивые механизмы обновления профиля.
-
Согласие, приватность и конкретизация. Управление согласием клиентов, согласование на обработку данных и обеспечение возможности отзыва - критически важны для соблюдения требований регуляторов. Предусматривается хранение записей согласий и политика “privacy by design”.
-
Безопасность и доступ. Контроль доступа, сегментация ролей и аудит действий - неотъемлемая часть CDP. Все сенситивные данные должны быть защищены соответствующими механизмами шифрования, мониторинга доступа и журналирования.
-
Хранение и удаление данных. Наличие политики хранения данных, периодов ретенции и процедур безопасного удаления - особенно важно в рамках договоров с клиентами и законами о персональных данных. В продуктивной архитектуре это реализуется через механизмы архивирования и удаления с подтверждением.
-
Соответствие требованиям и регуляторика. В зависимости от юрисдикции могут применяться регламентированные требования к хранению, кросс-дити, а также обязательные отчеты на уровне аудита. Архитектура должна обеспечивать легкость составления отчетности и доказательств соблюдения.
-
Примеры открытых инструментов и практик. При необходимости реализации собственных решений в части governance можно опираться на общепринятые подходы к данным и политикам. В рамках инфраструктуры Open Source часто применяют концепции репозитория политик и версий, позволяющие управлять изменениями правил персонализации без риска для операций.
-
Управление изменениями и обучением команды. Важность соотнесения бизнес-процессов с техническими решениями. Внедрение новых политик, обновление моделей и правил требуют методологической поддержки, обучения сотрудников и четких процедур релиза.
Key takeaways
- Персонализация в CDP строится вокруг единого обновляемого профиля клиента, который связывает данные из разных источников через единые идентификаторы.
- Архитектура продукта должна включать идентификацию, сегментацию, движок решений, контент/offer‑менеджмент и каналы активации, поддерживаемые интеграциями и governanсe.
- Адаптивная подстройка объединяет правила и ML-модели, обеспечивает обратную связь и мониторинг, учитывая требования по приватности и риски.
- Внедрение сценариев персонализации требует продуманной оркестрации across channels, контроля качества данных и возможность быстрого масштабирования.
- Инфраструктурные решения и open-source компоненты (например, Apache Kafka, Apache Flink) широко применяются для обеспечения реального времени и устойчивой архитектуры.
- Управление данными, безопасность и соответствие требованиям должны быть встроены еще на стадии проектирования продукта, чтобы обеспечить доверие клиентов и соответствие регуляторным требованиям.
- Эффективность персонализации оценивается по бизнес-метрикам (конверсия, CTR, LTV, ROI), а также по качеству данных и устойчивости системы к изменениям контекста клиента.
FAQ
- Что такое CDP и чем персонализация в CDP отличается от обычной маркетинговой персонализации?
CDP - это система сбора, унификации и активации клиентских данных из множества источников в единый профиль. Персонализация в CDP использует этот единый профиль и движок решений для создания релевантного опыта на разных каналах. Отличие состоит в системной интеграции данных, реальном времени и возможности осуществлять кросс-канальную активацию и адаптивную подстройку прямо на уровне платформы, а не в рамках отдельных инструментов.
- Какие ключевые компоненты продукта CDP необходимы для персонализации?
Ключевые компоненты включают единый профиль и граф идентичности, сегментацию, движок принятия решений (правила и/или ML), контент- и оффер-менеджмент, активационные каналы и оркестрацию, аналитику и управление данными. Важно, чтобы эти компоненты были интегрированы через единый API и имели механизмы governance и аудита.
- Как выбрать между правилной и ML-подходами к персонализации?
Правила обеспечивают предсказуемость, прозрачность и быстрый старт, особенно когда контекст и требования регуляторики ясны. ML-модели повышают точность и адаптивность в условиях сложной динамики поведения. В большинстве случаев эффективна гибридная архитектура: базовые правила + ML-решения для сложных случаев и постепенного повышения точности.
- Какие данные являются критическими для персонализации и как обеспечить их качество?
Ключевыми являются идентификаторы, поведенческие события, покупки, предпочтения и контекст взаимодействия по каналам. Качество данных обеспечивают очистка и нормализация, контроль изменений и lineage, а также управление согласиями и приватностью. Регулярное выявление и устранение дубликатов, а также мониторинг связанных с качеством показателей - критично для эффективной персонализации.
- Как интегрировать CDP с каналами активации и контентом?
Необходимо обеспечить унифицированные API для передачи персонализированных офферов и контента в email, push, веб, CRM и другие каналы. Важна согласованность контента и последовательности взаимодействий между каналами, а также возможность мониторинга эффективности по каждому каналу и сценарию.
- Какие архитектурные паттерны применяются для адаптивной подстройки?
Популярны паттерны: правилный движок решений, модельный реестр, сервисы управления правилами и сервисы онлайн-инференса. В рамках архитектуры допускается гибридный паттерн, где правила задают базовые поведенческие траектории, а ML-модели - предсказывают отклик и рекомендуют офферы. Важно обеспечить версионирование, тестирование и плавный релиз изменений.
- Как обеспечить приватность и соответствие требованиям в рамках персонализации?
Необходимо встроить политику согласий, минимизацию обработки данных, возможности отзыва согласия, а также аудит действий и журналирование. В архитектуре должны присутствовать механизмы доступа к данным по ролям, шифрование и контроль данных, а также процедуры для соблюдения местного и международного регулирования.
- Какие KPI наиболее информативны для оценки эффективности персонализации?
Ключевые KPI включают конверсию, CTR, средний чек, LTV, повторные покупки и удержание. Дополнительно важно отслеживать точность сегментов, скорость принятия решений и влияние на ROI кампаний. Не менее важно мониторить качество данных и устойчивость системы к изменениям контекста клиента.
- Как организовать команду и процессы внедрения персонализации?
Необходимо создать кросс-функциональные команды, объединяющие продуктовую, маркетинговую и техническую экспертизу: владельцев профиля, data-архитекторов, аналитиков, специалистов по контенту и операционный персонал. Важно выстроить процессы управления изменениями, планирование релизов, контроль качества данных и регулярные review KPI.
- Какие риски следует учитывать при внедрении персонализации в CDP?
Основные риски - ухудшение качества данных, несоблюдение приватности, непоследовательность контента между каналами, задержка в обработке событий и рост затрат на инфраструктуру. Управление этими рисками предполагает внедрение governance, мониторинга и чётких процедур тестирования новых сценариев.


