

Основы потоковых данных: термины, единицы измерения, задержки
Потоковые данные лежат в основе современных CDP-систем: они позволяют фиксировать каждое взаимодействие пользователя и преобразовывать его в непрерывную ленту информации, пригодную для анализа в реальном времени. Понимание базовых понятий, количественных характеристик и задержек конвейера потоков критично для проектирования устойчивых архитектур и эффективного внедрения в цифровой трансформации.
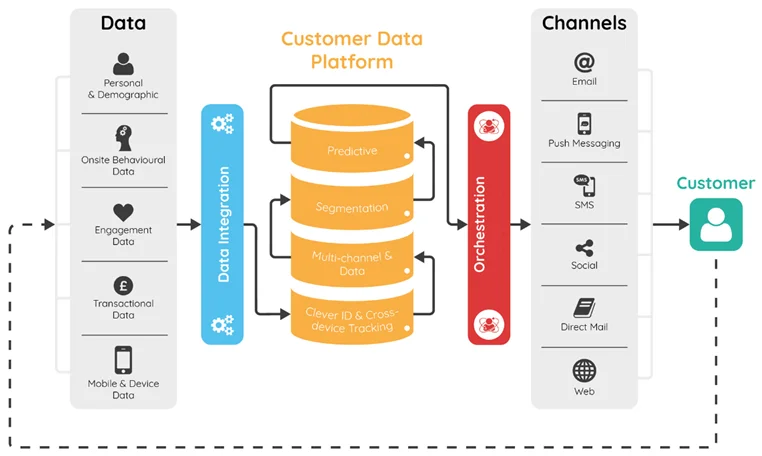
В контексте CDP потоковые данные выступают связующим звеном между поступающими событиями из каналов взаимодействия пользователя, их обработкой в реальном времени и обновлением профилей клиентов. Глубина понимания тем, таких как временные метки, сигналы времени, семантика доставки и архитектура обработки, позволяет принимать обоснованные решения по выбору технологий, настройке SLA и управлению качеством данных. В этой главе рассматриваются базовые термины, единицы измерения задержек, а также принципы проектирования конвейеров потоковых данных, применимые к реализациям CDP в рамках реального времени.
- Понимание основных концепций потоковых данных и их роли в CDP.
- Определение ключевых единиц измерения задержек, пропускной способности и временных окон.
- Освоение форматов сообщений, протоколов доставки и семантик обработки.
- Рассмотрение архитектурных слоев потоковых конвейеров и практических аспектов внедрения в CDP.
Краткое содержание главы
- Определения и контекст: что такое потоковые данные, события и потоки в CDP.
- Временные концепции: event-time, processing-time, watermark и их влияние на аналитику.
- Форматы, протоколы и семантики доставки: как выбрать подходящие технологии и гарантии доставки.
- Архитектура конвейера: ingestion, обработка, хранение и потребление в контексте CDP.
Концепции и основные термины
Потоковые данные представляют собой непрерывную ленту событий, происходящих в реальном времени или near real-time. В CDP такие события зачастую отражают взаимодействия пользователя: клики, просмотры, транзакции, изменения профиля. Важно различать несколько уровней понятий: сообщение как единица передачи, событие как смысловая единица внутри сообщения и поток как совокупность последовательностей сообщений, связанных между собой идентификатором пользователя или сессии.
Сообщение в потоковом конвейере может содержать множество полей: идентификатор события, тип события, временную метку, контекст устройства, дополнительные атрибуты. Эффективная организация схемы сообщений требует поддержки эволюции схем без нарушения совместимости потребителей, а также возможности повторного воспроизведения данных. В рамках CDP особенно значимы идентификаторы личности (identity resolution) и связывание событий с профилем пользователя, что обеспечивает корректную агрегацию поведения и построение единого view.
Разделение между физическим потоком и смысловым событием помогает управлять сложностью интеграций. Поток может состоять из множества параллельных источников: веб-аналитика, мобильные SDK, IoT-устройства, партнёрские системы. Каждый источник приносит данные в конвейер с собственной задержкой и характерными паттернами ошибок. Архитектура должна поддерживать согласование идентификаторов, обработку повторов и корреляцию между событиями, чтобы в профиле пользователя не появлялись дубликаты и данные оставались консистентными.
- Событие в CDP является единицей аналитики, которую можно агрегировать, коррелировать и использовать для персонализации в реальном времени.
- Сообщение - структурированная транспортная единица, обычно с ключом, временем и полезной нагрузкой.
- Поток - совокупность взаимосвязанных сообщений из одного или нескольких источников, формирующих непрерывную ленту данных.
Временные концепции: таймстемпы, события времени и задержки
Ключевым аспектом потоковой обработки является работа со временем. В CDP различают несколько типов временных меток и соответствующую обработку:
- event-time (время события) - момент, когда событие произошло в реальных условиях. Это критично для корректной доменной логики анализа поведения пользователей, особенно когда события поступают с задержками или из разных географических зон.
- processing-time (время обработки) - момент, когда событие обрабатывается внутри системы. Этот показатель зависит от загрузки конвейера и характеристик вычислительных ресурсов.
- ingestion-time (время ввода) - момент попадания события в потоковую систему. Он полезен для аудита и диагностики задержек на входе.
Watermark - сигнальная метка, используемая потоковыми системами (например, Apache Flink) для обозначения того, что данные до некоторого временного порога, возможно, уже поступили и могут быть агрегированы. Watermarks позволяют реализовать корректную обработку окон и обработку событий, приходящих с запаздыванием, минимизируя задержки и избегая преждевременных выводов по окнам.
Задержки потоков можно рассматривать на нескольких уровнях:
- end-to-end задержка (latency) - время от наступления события до момента, когда оно влияет на вывод в аналитических источниках (профили, сегменты, атрибутивные обновления).
- tail latency - верхняя граница задержки для наиболее задержанных событий, критична для SLA real-time аналитики.
- jitter - разброс задержек между событиями одного типа; высокий jitter усложняет синхронную агрегацию и требует устойчивых окон и стратегий коррекции.
Понимание этих различий помогает выбрать подходящие оконные стратегии, таймстемпинг и политики задержек в конкретной архитектуре CDP.
- Event-time обеспечивает корректность анализа поведения пользователя в условиях задержек и несогласованности источников.
- Processing-time упрощает своевременную обработку и детерминированность, но может искажать результаты при асинхронности.
- Watermarks - механизм безопасного прогноза завершения окна, который минимизирует риск потери данных и несогласованности.
Форматы данных, протоколы и гарантии доставки
Выбор форматов и транспортных протоколов напрямую влияет на компактность, эволюцию схем и устойчивость к повторной передаче. В CDP при работе с потоками часто применяются гибридные подходы: для передачи событий - JMS-подобные очереди или брокеры сообщений (Kafka, Pulsar, Kinesis) - и для хранения и передачи схем - серийные форматы.
- Форматы сообщений: JSON пригоден для читаемости и быстрой интеграции, но AVRO и Protobuf позволяют эффективную сериализацию с поддержкой эволюции схем и меньшего размера сообщений. При проектировании схем целесообразно предусмотреть обязательность ключа (id), временной метки и набора контекстных полей (профиль, устройство, география).
- Форматы данных для хранения: для долговременного хранения и аналитики часто применяют колонно-ориентированные форматы Parquet или ORC, которые оптимальны для ленточной загрузки в lake-хаусы или Data Lakehouse.
- Протоколы доставки: Kafka и Pulsar являются индустриальными стандартами для ingestion, каждая система обладает особенностями семантики доставки и управлением порядком сообщений. Kinesis - аналог на AWS, интегрируемый с сервисами облака.
- Семантика доставки: at-least-once гарантирует, что каждое сообщение будет получено по крайней мере один раз, но может повторяться; exactly-once достигается через транзакционные механизмы и idempotent-операции в обработке; at-most-once - риск потери сообщений, обычно менее предпочтителен для критически важных данных в CDP.
- Примеры торговых моделей: при проектировании важно выбрать подходящую модель доставки в зависимости от сценария, например, высокие требования к точности в профилировании и сегментации против более толерантной обработки событий в маркетинговых кампаниях.
В контексте CDP критически важно обеспечить совместимость между источниками и потребителями, обеспечить устойчивую схему эволюции данных и предусмотреть возможность повторной обработки для коррекции ошибок. Выбор технологий должен сочетать требования к латентности, пропускной способности и гарантии доставки с теми задачами, которые стоят перед персонализацией и аналитикой в реальном времени.
- В CDP необходимо обеспечить идентификацию пользователей и сопоставление событий с профилем, а значит поддерживать схему кем-то, кто отправляет события и кем-то, кто их потребляет, согласование по ключам и време́нным меткам.
Архитектура потоковых систем в CDP
Архитектура потоковых конвейеров в CDP формируется как набор слоёв: ingestion, обработка в реальном времени, хранение и доступ к данным для профилирования. В каждом слое присутствуют свои требования к нагрузке, задержкам и устойчивости к сбоям.
- Ингестирование и входной слой. Источники событий собираются с минимальной задержкой и приводят данные в брокер сообщений или потоковую службу. В CDP это может включать веб-аналитику, мобильные SDK, CRM-экспорт и партнёрские источники. Важен единый механизм санитизации и нормализации полей, чтобы последующая обработка не требовала специфических адаптеров под каждый источник.
- Обработка в реальном времени. На этом этапе применяется движок потоковой обработки: фильтрация, обогащение, агрегации, корреляция идентификаторов, вычисление временных окон и вычислительная логика персонализации. Часто применяются такие технологии, как Flink или Spark Structured Streaming, которые поддерживают event-time обработку и watermark.
- Хранение и доступ к данным профилей. Результаты обработки записываются в слои хранения: оперативные слои для реального времени и исторические слои для долгосрочной аналитики. В CDP критично обеспечить консистентность данных профиля и корректную агрегацию поведения на уровне пользователя.
- Интеграции с CDP и сервисами аналитики. В результате потоковых преобразований профиль пользователя дополняется новыми признаками и поведением, которые затем используются для сегментации, персонализации и downstream-аналитики. Плюс встраивание обработанных данных в витрину данных и сервисы рекомендаций.
Архитектурные решения должны поддерживать:
- масштабируемость и горизонтальную эластичность конвейера.
- устойчивость к сбоям и возможность повторной обработки в случае ошибок.
- корректное соединение событий с профилями и синхронизацию идентификаторов.
- мониторинг качества данных на каждом слое конвейера и фиксацию SLA.
Задержки и источники задержек в потоковых конвейерах
Задержка обработки и доставки в CDP формируется совокупно. Источники задержек можно условно разделить на внешние и внутренние:
- внешние задержки: сетевые задержки между источниками и брокером, задержки от клиента (браузер или мобильное приложение), географическое распределение и т.д.
- внутренние задержки: сериализация/десериализация, партиционирование, группировка и агрегация внутри движков обработки, checkpointing и сохранение состояния, репликация данных для отказоустойчивости.
Ключевые механизмы минимизации задержек включают:
- правильный выбор партиционирования и ключей (для локализации обработки и уменьшения skews).
- минимизацию объёмов сериализации и использование эффективных форматов (AVRO/Protobuf против JSON там, где важна пропускная способность и эволюционная совместимость).
- адаптивное масштабирование и контроль backpressure для предотвращения перегрузки конвейера.
- стратегию оконной обработки: выбор фиксированных окон vs скользящих окон, использование watermark для обработки задержанных событий без потери точности.
Эти принципы позволяют поддерживать баланс между латентностью и точностью в длительных конвейерах, что особенно важно для real-time персонализации в CDP.
Практические аспекты внедрения в CDP
Успешное внедрение потоковых данных в CDP требует синхронной работы между командой данных, архитекторами и бизнес-единицами. Необходимы следующие аспекты:
- проектирование единых идентификаторов и модели профиля. Важно обеспечить сопоставление событий с единым идентификатором клиента, корректную работу Identity Graph и возможность повторной идентификации в разных системах.
- обеспечение качества данных через валидацию и уборку ошибок на входе конвейера, а также контроль за эволюцией схем.
- мониторинг и алертинг. Включает слежение за задержками, шума и аномалиями в потоках; наличие SLA на критические сценарии (например, обновление профиля в течение N секунд после события).
- тестирование потоковых конвейеров: симуляция пиковых нагрузок, тестирование на предмет дублирования сообщений, проверка устойчивости к сбоям и проверка корректности обработки event-time сценарием.
- обеспечение безопасности и соответствия требованиям по данным: управление доступом, шифрование в транзите и на хранении, аудит изменений и трассируемость потоков.
Ключевые технические решения и практики
- При выборе технологий для ingestion/processing можно ориентироваться на зрелые экосистемы, такие как Apache Kafka и Apache Flink, которые хорошо поддерживают event-time обработку, watermark и точную настройку семантики доставки. В контексте отечественных инициатив можно назвать такие решения как Apache Pulsar и соответствующие брокеры данных, которые часто применяются в региональных инфрастуктурах в рамках CDP-практик.
- Форматы сообщений и схемы должны поддерживать эволюцию без разрыва обратной совместимости. AVRO или Protobuf позволяют поддерживать строгую схему и аудиты, а JSON - для адаптации к быстрому прототипированию и интеграциям с внешними системами.
- Встроенная обработка ошибок и idempotent-логика критичны для точного обновления профиля. Применение idempotent-операций и повторной обработки без дублирования - базовая практика при обновлении профиля и агрегациях.
- Архитектура должна предусматривать план на случай ошибок. Чётко определённые политики повторной загрузки, ретрансляции и обработки задержанных событий помогают сохранять целостность профиля клиента и качество данных в CDP.
Примеры сценариев внедрения
- В веб-аналитике - потоковое обновление профиля на основе кликов и событий просмотра страниц. В реальном времени создаются сегменты, которые затем используются для показа релевантных предложений или персонализированных баннеров.
- В мобильной среде - события об устройстве и сессии синхронизируются с профилем в течение секунд после взаимодействия, что позволяет быстро адаптировать персонализацию и рекомендации для конкретного пользователя.
- В omnichannel-сценариях - потоковые данные об объединённых каналах (веб, мобильное приложение, офлайн-данные) связываются через единый идентификатор и обновляют профиль, поддерживая согласование атрибутов и поведения в реальном времени.
Практические советы по архитектуре и управлению
- Определяйте SLA по задержке для критичных сценариев использования CDP и проектируйте конвейеры так, чтобы эти требования удовлетворялись в большинстве случаев.
- Внедряйте мониторинг качества данных и корректности обновления профиля на основе тестовых прогонов, детального логирования и регулярной верификации агрегатов.
- Планируйте эволюцию схем сообщений и управляемую миграцию, чтобы минимизировать риски прерывания рабочих процессов.
- Разрабатывайте политики управления идентичностью и сопоставления событий с профилем так, чтобы минимизировать дубликаты и обеспечить консистентность данных.
- Учитывайте расходы и компромиссы между latency и throughput, особенно в условиях пиковых нагрузок и масштабирования инфраструктуры.
Key takeaways
- Потоковые данные позволяют строить реальное время персонализации и поведенческую аналитику в CDP, но требуют ясного определения времени событий, условий доставки и окон обработки.
- Event-time, processing-time и watermark критически влияют на корректность аналитики и выбор архитектуры конвейера.
- Форматы сообщений и семантика доставки (at-least-once, exactly-once) определяют устойчивость к ошибкам и консистентность профилей.
- Архитектура CDP должна балансировать между латентностью, пропускной способностью и надёжностью, с акцентом на идентификацию пользователя и согласованность данных.
- Внедрение должно включать дизайн идентичности, качественный мониторинг, планирование миграций схем и тестирование под реальные сценарии нагрузки.
- Практически важны выбор технологий, поддерживающих event-time обработку и эволюцию схем без нарушения совместимости, а также обеспечение безопасных и эффективных интеграций с CDP.
- Управление задержками требует стратегий минимизации сетевых задержек, оптимизации сериализации и продуманной политики оконной обработки.
FAQ
- Что такое задержка потока и почему она важна в CDP?
Задержка потока - это время между возникновением события и его влиянием на аналитическую или маркетинговую логику в CDP. Важна она для сетапа персонализации в реальном времени, SLA и качества данных. Непредсказуемые задержки приводят к рассогласованию профилей и неэффективной таргетированной коммуникации.
- Чем event-time отличается от processing-time, и как это влияет на аналитику?
Event-time - это реальное время события, которое может отличаться от времени обработки из-за задержек в сети или задержек источника. Processing-time - момент, когда событие обрабатывается системой. Различие влияет на точность временных окон и на корректность временной агрегации; использование event-time помогает избежать сдвигов в анализе поведения.
- Какие форматы сообщений предпочтительнее для CDP и почему?
AVRO или Protobuf предпочтительны, потому что поддерживают эволюцию схем, компактность и быстродействие сериализации. JSON удобен для прототипирования и интеграций, но требует дополнительных механизмов контроля схемы. Выбор зависит от требований к совместимости, скорости и объёма передаваемых данных.
- Какие протоколы доставки подходят для CDP и какие гарантии они обеспечивают?
Kafka, Pulsar и Kinesis являются основными решениями для ingestion. Они могут обеспечивать at-least-once или exactly-once семантику в сочетании с обработкой в движке потоковой обработки. Выбор зависит от требуемой точности, сложности обработки и инфраструктурной поддержки.
- Как выбрать семантику доставки для конкретного сценария?
Если критична точность и отсутствие дубликатов, выбирайте exactly-once с поддержкой idempotent-операций и транзакционной записи. В ситуациях, где пропускная способность важнее, а небольшие дубликаты допустимы, можно рассмотреть at-least-once с повторной обработкой и коррекцией на уровне профиля.
- Какую роль играют watermark и окна в потоковой обработке?
Watermark позволяет двигаться к завершению окна даже при задержанных событиях, минимизируя задержку и избегая потери данных. Окна (t-горизонты) позволяют агрегировать данные за фиксированные интервалы времени или по скользящим паттернам, что важно для аналитики в реальном времени и персонализации.
- Какие типичные источники задержек встречаются в CDP и как их уменьшать?
Сетевые задержки, задержки источников, сериализация/декодирование, партиционирование и checkpointing в движке потоковой обработки. Уменьшать можно за счет правильного партиционирования, выбора эффективных форматов, уменьшения размера сообщений, а также использования горизонтального масштабирования и адаптивного backpressure.
- Как интегрировать потоковые данные в единый профиль пользователя в CDP?
Необходимо наличие общего идентификатора клиента, согласованной модели идентичности и стратегии корреляции событий с профилем. Важно предусмотреть стадии deduplications и обработки повторов, а также обеспечить консистентность между входными данными и состоянием профиля.
- Какие метрики важно мониторить в потоковой архитектуре CDP?
Задержка end-to-end, задержка на входе, throughput, процент дубликатов, процент ошибок сериализации/десериализации, время обработки окон, точность обновления профиля и SLA по критическим сценариям.
- Какие практики тестирования потоковых конвейеров эффективны для CDP?
Симуляции пиковых нагрузок, тесты на устойчивость к сбоям, регрессионное тестирование схем и повторная обработка событий. Включение тестовых данных с заранее известными результатами позволяет проверить корректность профиля и точность сегментации под различными сценариями.
Глава рассчитана на сочетание архитектурного и методологического подходов к потоковым данным в CDP. Она может служить базой для проектирования реальных конвейеров, определяющих качество и скорость персонализации, а также для формирования организационных процессов, ориентированных на устойчивые и прозрачные потоки данных в рамках цифровой трансформации.


