

Управление качеством данных: профилирование, очистка и подготовка
Качество входных данных определяет реальную применимость и интерпретируемость метрик прогноза спроса, таких как MAPE, Bias и Forecast Accuracy. Без системного профилирования, очистки и подготовки данные теряют консистентность, иллюзия точности возрастает за счет артефактов и сбоев в производственном процессе. Эта глава фокусируется на техническом проектировании и реализации цепочек качества данных, которые поддерживают устойчивые модели спроса, позволяют корректно интерпретировать результаты и управлять рисками во всей экосистеме цифровой трансформации.
Ключевая идея состоит в том, что управление качеством данных - это не одноразовая операция, а непрерывная дисциплина: профилирование помогает понять текущее состояние данных, очистка и подготовка приводят к единообразной и пригодной для моделирования поверхности данных, а интеграция в конвейеры обеспечивает повторяемость и соответствие требованиям регуляторов и бизнеса.
- Архитектура и контракты данных: как структурировать сервисы, отвечающие за качество на уровне данных и метаданных.
- Профилирование и проверки: какие метрики применять, какие методы использовать для обнаружения аномалий и несоответствий.
- Очистка и подготовка: практические подходы к очистке, стандартизации и обогащению данных, включая временные ряды и контекстные признаки спроса.
- Интеграция в цикл прогноза: как обеспечить мониторинг, управление версиями данных и процедуры отката.
- Технологии и инструменты: примеры инструментов и паттернов реализации, чтобы обеспечить воспроизводимость и масштабируемость.
Архитектура управления качеством данных для прогноза спроса
Эффективная архитектура качества данных строится вокруг разделения ответственностей между источниками данных, профилированием, проверками, очисткой и хранением, при этом поддерживает прослеживаемость и возможность аудита. В типичной промышленной среде для прогноза спроса это выглядит как несколько взаимосвязанных слоев:
- Источники данных и ингенсинг: CRM, POS-системы, корзиночные и промо-данные, погодные и ценовые источники. Входящие данные проходят первичные проверки на канал/формат и валидируются по базовым контрактам.
- Слой профилирования: периодические расчёты и сравнение текущего состояния данных с эталонными профилями, вычисление метрик качества и генерация предупреждений.
- Слой очистки и обогащения: устранение дубликатов, приведение к единому формату, дефляция и нормализация значений, обработка пропусков, коррекция временных штормов и нормализация векторных признаков.
- Валидаторы и конвейеры: правила проверок (rules engine), тесты качества и интеграционные проверки перед тем, как данные попадут в хранилище или в вычислительные пайплайны моделей.
- Хранилище и линейка данных: версии датасета, манифесты и логи происхождения данных, позволяющие повторно воспроизвести прогноз и отследить источник ошибок.
- Оркестрация и мониторинг: автоматизация задач, триггеры на сбои качества, дашборды по качественным KPI и механизмы отката.
Типичная архитектура поддерживает такие паттерны:
- Data contracts и schema validation на входе: строгие схемы и тесты совместимости между источниками данных и потребителями.
- Data lineage и metadata management: хранение информации о происхождении данных, версии схем и применяемых преобразованиях.
- Data quality gates: контроль на каждой стадии конвейера, позволяющий остановить прогон, если критичные качества нарушены.
- Observability и alerting: мониторинг задержек, пропусков, дубликатов, аномалий и согласованности признаков.
## Пример концептуального пайплайна качества данных
- Источник данных → Ingestion Service → Profiling Service → Cleansing & Enrichment → Validation Layer → Feature Store → Модели прогнозирования
При реализации следует учитывать интеграцию с существующими инструментами и стандартами: API-first подход, контрактная совместимость между сервисами и модульность компонентов, чтобы обеспечить гибкость изменений без разворачивания крупных изменений в продакшене. Для открытых решений полезны фреймворки типа Great Expectations для описания ожиданий данных, и dbt для тестирования качества в рамках трансформаций. Эти инструменты позволяют формализовать требования к данным и автоматизировать проверки без потери управляемости.
Профилирование данных: цели, метрики и алгоритмы
Профилирование - основа понимания текущего состояния данных и первичная детекция дефектов. В контексте прогноза спроса оно служит фундаментом для стабильности метрик MAPE, Bias и Forecast Accuracy, поскольку качество входных данных напрямую влияет на отклонения и интерпретацию ошибок.
Классический набор целей профилирования:
- Проверка полноты (completeness): доля непустых значений по ключевым признакам, включая дата, магазин, товар, атрибуты промоакций.
- Проверка актуальности и своевременности (timeliness): задержки между событием и попаданием записи в набор для моделирования.
- Проверка единообразия и валидности (consistency and validity): единый формат дат, единицы измерения, допустимые диапазоны значений.
- Проверка уникальности и целостности (uniqueness and referential integrity): отсутствие дубликатов ключевых комбинаций, корректные связи между фактами и справочниками.
- Распределение и корреляции (distribution and correlations): соответствие распределений признаков ожидаемым моделями, обнаружение смещений.
- Обнаружение аномалий (anomaly detection): выбросы, резкие сдвиги и пропавшие паттерны, которые не объясняются бизнес-логикой.
Алгоритмы и методы профилирования:
- Правила валидности и проверки согласованности (rule-based checks): набор порогов и ограничений на значения.
- Статистический профайлинг: агрегированные метрики по столбцам (mean, median, std, quantiles) и их сравнение с историческими эталонами.
- Поведенческий профилинг для временных рядов: сезонность, тренды, пропуски и задержки в поступлении данных.
- Непараметрический и буферный подход к детекции аномалий: локальные выборки, межквартильный размах (IQR), Z-оценки.
- Непосредственные проверки согласованности между источниками: сопоставление продаж по каналам, синхронизация по датам и магазинам.
- Эвристики и графовые связи: связь между ценой, акциями, спросом и промо-эффектами.
## Пример простого профилирования пропусков и базовых статистик в pandas
import pandas as pd

def profile_dataframe(df):
    result = {}
    for col in df.columns:
        s = df[col]
        result[col] = {
            "dtype": str(s.dtype),
            "missing": int(s.isna().sum()),
            "missing_pct": float(s.isna().mean()) * 100,
            "unique": int(s.nunique(dropna=True)),
            "min": s.min() if pd.api.types.is_numeric_dtype(s) else None,
            "max": s.max() if pd.api.types.is_numeric_dtype(s) else None,
            "q25": s.quantile(0.25) if pd.api.types.is_numeric_dtype(s) else None,
            "q50": s.quantile(0.5) if pd.api.types.is_numeric_dtype(s) else None,
            "q75": s.quantile(0.75) if pd.api.types.is_numeric_dtype(s) else None,
        }
    return result
Эффективная реализация профилирования часто опирается на специализированные инструменты. Great Expectations предоставляет декларативный способ описания ожиданий к данным (например, "кол-во пропусков по столбцу не bem внутри порога", "значения в диапазоне"). Это позволяет не только выявлять дефекты, но и автоматически валидировать новые наборы данных в пайплайне. dbt - инструмент для трансформаций и тестирования данных в стиле ELT - может включать тесты качества на уровне моделей. В рамках технической архитектуры полезно сочетать профилирование на уровне потоков данных и отдельные качества на уровне трансформаций, чтобы обеспечить устойчивые промо-циклы и воспроизводимость.
Важно определить пороги качества данных и способы реагирования:
- порог пропусков по критичным признакам (например, date, store_id, product_id) - значение, после которого данные не проходят в пайплайн;
- ограничение на размахи признаков и физическую валидность значений;
- параметризация уведомлений и автоматическое переключение на последний валидный датасет при обнаружении деградации качества.
Типовые сценарии использования профилирования:
- регулярное сравнение текущей выборки с историческим профилем (seasonality drift);
- мониторинг конверсий между источниками данных (несоответствия между продажами и товарами);
- раннее оповещение о деградации качества данных, влияющей на точность прогноза.
Очистка и подготовка данных: практики и протоколы
Очистка данных - это ряд последовательных операций, направленных на приведение данных к согласованной и воспроизводимой форме, пригодной для моделирования. В контексте прогноза спроса это означает не только базовую чистку, но и корректное обращение с временными рядами, промо-акциями, кросс-доменными связями и контекстами.
Основные этапы очистки и подготовки:
- исправление форматов и приведение типов: единицы измерения, форматы дат, категориальные признаки в кодированные представления.
- удаление дубликатов и консолидация ключевых комбинаций: уникальность по date/store_id/product_id, сохранение целостности исторических записей.
- обработка пропусков: простая импутация (среднее, медиана, моды) для неключевых столбцов, специфичные подходы для временных рядов (скользящие медианы, отраслевые корреляции).
- нормализация признаков: приведение значений к единым шкалам (например, лог- или z-нормализация для признаков спроса и цены).
- выравнивание временных рядов: регуляризация частоты, заполнение пропусков по датам в магазинах, согласование с календарями праздников и промо.
- обработка промо-данных и акций: нормализация цены, дискретизация по уровням акций, привязка к периодам действия.
- обогащение признаков: присоединение погодных условий, календарных факторов, сезонных индикаторов и ценовых стимулов.
- проверка согласованности после очистки: повторное профилирование на предмет отсутствующих нарушений.
Этап очистки может быть реализован как серия трансформаций в рамках ETL/ELT, с водителем White-List/Black-List допустимых значений и порогами для автоматического утверждения изменений. Важна ясная версия данных и повторяемость: каждое изменение в очистке должно сопровождаться манифестом версий и регламентами отката.
## Пример простого этапа очистки в pandas
## Удаление дубликатов по ключу и приведение даты к единому формату
df = df.drop_duplicates(subset=["date","store_id","product_id"])
df["date"] = pd.to_datetime(df["date"], errors="coerce")
## Импутация пропусков в продажах медианой по группе
df["sales"] = df.groupby(["store_id","product_id"])["sales"].transform(lambda s: s.fillna(s.median()))
Ключевые практики очистки включают стандартизацию единиц измерений (например, единицы SKU, валюты), консолидацию категориальных признаков и устранение ложных пропусков за счет контекстной импутации. При этом следует избегать чрезмерной агрессивной очистки, которая может удалить полезную сигнализацию. В Salesforce-подходах, в рамках цифровой трансформации, рекомендуется вести документированную политику очистки и регистры изменений, чтобы аудит и повторение действий были возможны в любой момент.
Обработка пропусков в контексте прогнозирования спроса требует специфики: пропуски в временных рядах можно трактовать как нулевые продажи или как неизвестность, что по-разному влияет на обучаемые модели. Часто предпочтительным является сохранение сигнала пропуска как отдельного признака (is_missing) и применение временно ориентированной импутации, которая учитывает сезонность и тренды.
В качестве инструментов и подходов можно отметить:
- Great Expectations для декларативного описания ожиданий и автоматических тестов;
- dbt для тестирования трансформаций и обеспечения качества на уровне моделей;
- специфические библиотеки временных рядов (например, Prophet или ARIMA-совместимые реализации) - для расчета признаков в контексте чистки и подготовки.
Интеграция качества данных в цикл прогноза и мониторинг
Качество данных должно быть встроено в цикл разработки и эксплуатации моделей. Это означает наличие процедур контроля качества на каждом этапе пайплайна, а также механизмов мониторинга и адаптации к изменяющимся условиям бизнеса.
Ключевые элементы интеграции:
- Data contracts: формализация контрактов между поставщиками данных и потребителями, включая SLA по задержкам, полноте и валидности.
- Версионирование данных и моделей: хранение манифестов версий, чтобы можно было воспроизвести прогноз и понять влияние изменений в данных на результаты.
- Validation gates: автоматические проверки после каждой стадии обработки, где данные не проходят-конвейер останавливается или помечается для ручной проверки.
- Мониторинг качества данных в проде: дашборды по пропускам, дубликатам, смещениям и деградации качества. Также мониторинг метрик, связанных с прогнозами (например, изменение MAPE после обновления данных).
- Управление откатом и регрессионный тестинг: сценарии отката к прошлым версиям данных и тестирование на устойчивость метрик после изменений качества.
- Мониторинг дрейфа и сезонности: отслеживание изменений в распределениях признаков и связи с бизнес-активностями.
Путь к внедрению обычно выглядит как последовательность шагов:
- Определение критичных признаков и соответствующих SLA для каждого источника данных.
- Разработка набора валидаторов и порогов качества на уровне таблиц, колонок и ключевых сочетаний.
- Интеграция валидаторов в конвейер с использованием CI/CD для дата-сценариев и развертывание в продакшене.
- Развертывание дашбордов и оповещений для команд по данным и моделям.
- Регулярные аудиты профилей и ревизии контрактов на основе бизнес-требований и законодательных изменений.
Технологически данный уровень интеграции часто реализуется через сочетание:
- Orchestration инструментов (Airflow, Dagster) для организации и мониторинга пайплайнов;
- Data quality фреймворков (Great Expectations) для декларативных ожиданий;
- Data catalog и lineage инструментов для прослеживаемости и аудита;
- Инструментов для мониторинга и alerting (Prometheus, Grafana) и систем журналирования (ELK/OpenSearch).
Особое внимание уделяется управлению версиями датасетов и воспроизводимости: чем лучше зафиксированы версии входных данных и преобразований, тем легче объяснить и проверить влияние на прогнозы. В контексте регуляторной и бизнес-ответственности необходимо обеспечивать прозрачность и возможность аудита данных, используемых для прогноза.
Практические аспекты реализации
Реализация комплексной системы качества данных требует продуманной инфраструктуры и дисциплины в командах, работающих с данными и моделями. Ниже приведены практические ориентиры для технического внедрения.
- Проектирование контрактов данных: формализуйте требования к каждому источнику данных и согласуйте KPI по качеству (например, допустимое количество пропусков и диапазоны значений). Документируйте правила обработки пропусков и агрегаций.
- Модульность и слои: разделите инфраструктуру на независимые модули (профилирование, очистка, валидаторы, шардирование и хранение). Это упрощает масштабирование и упрощает внесение изменений.
- Версионирование и воспроизводимость: храните версии схем, версий пайплайнов и манифесты данных, чтобы можно было повторно воспроизвести прогноз на конкретной конфигурации.
- Контекстные признаки и обогащение: добавляйте признаки, которые помогают моделям лучше объяснять спрос (календарные факторы, промо-акции, погодные условия). Однако не перегружайте модель слишком большим количеством признаков без обоснования.
- Контроль качества на проде: реализуйте gating и мониторинг качества, чтобы остановку пайплайна при критических сбоях можно было выполнять автоматически или вручную в случае необходимости.
- Обучение и изменения в организации: внедрите культуру совместной ответственности за данные между командами Data Engineering, Data Science и бизнес-аналитикой. Регулярно обновляйте процессы на основе обратной связи и новых требований.
В практическом плане можно рассмотреть интеграцию с открытыми инструментами:
- Great Expectations: для описания ожиданий к данным и автоматической проверки в пайплайне.
- dbt: для тестирования и контроля качества на уровне трансформаций и моделей.
Эти инструменты позволяют внедрить декларативные проверки, которые не зависят от конкретного технологического стека и обеспечивают совместную работу между командами.
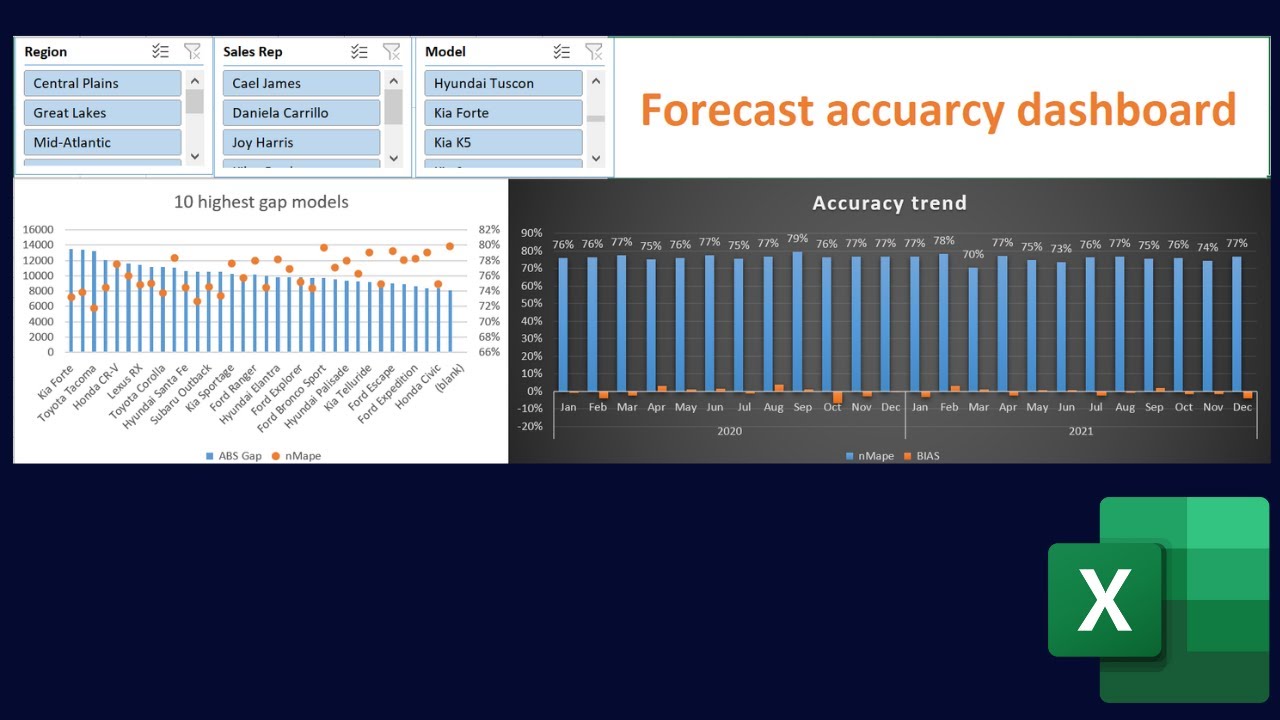
Примеры реализации и ориентиры по архитектуре
- Архитектурная карта: источник данных** - Ingestion - Profiling - Cleansing - Validation - Feature Store - Модели прогноза - Мониторинг. Такой подход обеспечивает четкую прослеживаемость и возможность отката.
- Вариант с курсом на монорельс: профилирование и валидаторы работают как отдельные сервисы, которые могут быть заменены или расширены без влияния на сам процесс прогноза.
- Пример тестирования на уровне данных: «expect_field_not_null» для критичных столбцов и «expect_value_in_range» для признаков спроса и цены; интеграция с Great Expectations позволяет автоматически запускать проверки во время ETL/ELT.
Key takeaways
- Качество данных - фундамент для корректной интерпретации метрик прогноза спроса и устойчивой точности прогнозов.
- Эффективная архитектура управления качеством данных разделяет ответственность между источниками данных, профилированием, проверками, очисткой и хранением, обеспечивая воспроизводимость и аудит.
- Профилирование данных выявляет пропуски, несоответствия и аномалии, позволяя заблаговременно реагировать на деградацию качества.
- Очистка и подготовка данных превращают «грязный» вход в консистентную и воспроизводимую поверхность для моделирования; им управляют через политики, версии и документацию.
- Интеграция качества данных в цикл прогноза требует контрактов данных, контроля качества на проде и мониторинга, чтобы быстро идентифицировать и устранить влияние на метрики.
- Инструменты как Great Expectations и dbt помогают формализовать ожидания к данным и внедрить воспроизводимые тесты качества.
- В контексте бизнес-целей и регуляторных требований важна документированность процессов, возможность отката и прозрачность происхождения данных.
FAQ
- Что такое профиль данных и зачем он нужен в прогнозировании спроса?
Профилирование данных - это систематический сбор и анализ характеристик входных данных: полнота, валидность, единообразие форматов, распределения признаков и взаимодействие между источниками. В прогнозировании спроса это помогает выявлять проблемы до обучения моделей: пропуски и некорректные значения приводят к искажению признаков и, как следствие, к неверной оценке ошибки прогноза (MAPE, Bias). Регулярное профилирование позволяет заранее обнаружить деградацию качества данных, связать её с изменениями в бизнес-процессах (например, новые каналы продаж) и скорректировать пайплайн.
- Как качество входных данных влияет на метрики MAPE и Bias?
MAPE и Bias чувствительны к систематическим отклонениям и неравномерности данных. Пропуски и пропуски по ключевым признакам могут приводить к искусственным занижениям или завышениям ошибок, особенно в периоды пикового спроса. Несогласованные единицы измерения, задержки в поступлении данных и деградация полноты данных по магазинам или товарам приводят к смещению прогноза и неправильной интерпретации ошибок. Поэтому единый процесс профилирования и очистки необходим для корректной интерпретации метрик и принятия управленческих решений.
- Какие этапы входят в цикл профилирования и как их организовать в продакшене?
Цепочка включает: (1) сбор и нормализацию метаданных источников, (2) расчет локальных метрик по столбцам и записям, (3) обнаружение аномалий, (4) сравнение с эталонами и историческими профилями, (5) формирование предупреждений и (6) интеграцию результатов в мониторинг пайплайна. В продакшене это реализуется через сервисы профилирования и валидаторы, которые работают в рамках CI/CD пайплайна и запускаются на расписании или по событиям. Важна неизменность контрактов и прозрачная история изменений.
- Какие практики применяются для очистки данных в контексте прогноза спроса?
Практики включают устранение дубликатов, приведение форматов и единиц измерения к единому стандарту, обработку пропусков подходящими стратегиями (импутации, оставление нулей там, где это бизнес-логично, или отметка пропусков как отдельного признака), нормализацию и обогащение признаков, а также корректную обработку временных рядов, учитывая сезонность и промо-акции. Важно сохранять возможность отката и документировать каждое изменение через версии данных и трансформаций.
- Какие инструменты лучше использовать для реализации контроля качества данных?
Рекомендованы инструменты, обеспечивающие декларативное описание ожиданий и автоматический запуск проверок: Great Expectations для описания и автоматизации ожиданий к данным, dbt для структурирования трансформаций и тестирования, а также стандартные средства оркестрации (Airflow, Dagster) и мониторинга (Prometheus/Grafana). Количество инструментов должно быть минимальным, но достаточным для поддержания повторяемости и прозрачности процессов.
- Как организовать мониторинг качества данных в продакшн-среде?
Необходимо внедрить дашборды по пропущенным значениям, дубликатам, смещениям и деградации качества, а также автоматические оповещения для ответственных лиц. Мониторинг должен быть связан с циклом обновления моделей: если качество данных падает, может потребоваться повторное обучение или регенерация сеансов данных. Важно обеспечить прослеживаемость изменений и возможность отката.
- Как связать данные качества с бизнес-результатами и регуляторикой?
Связь достигается через контракты данных и документирование трансформаций, чтобы бизнес-аналитики и регуляторы могли проследить происхождение и влияние каждого признака. Регулярная валидация соответствия данным и хранение версий позволяют объяснить, почему прогноз имеет ту или иную точность, и как она изменяется после изменений в данных. Это критично для аудитов и объяснимости моделей.
- Какие типичные риски возникают при управлении качеством данных и как их минимизировать?
Риски: деградация качества данных без своевременного обнаружения, неполное документирование изменений, слишком агрессивная очистка, приводящая к потере сигнала, и несовместимость между источниками данных. Минимизация достигается через внедрение контрактов данных, строгие gates на пайплайнах, регламентированные версии данных, аудит изменений и регулярное обновление профилей в ответ на бизнес-события.
- Какие рекомендации по организационной структуре для поддержки качества данных?
Рекомендуется сформировать совместный центр компетенций Data Quality, включающий инженеров по данным, Data Scientists и владельцев бизнес-данных (PO/BD), с четкими SLA и правилами эскалации. Внедрить процессы Governance и Metadata Management, чтобы обеспечить единообразие терминов, трактовок и процедур. Регулярные ревью и обучение по качеству данных должны стать частью культуры проекта.
- Как адаптировать подход к качеству данных в условиях масштабирования и изменений в бизнесе?
Необходимо предусмотреть модульную архитектуру, где можно добавлять новые источники данных и новые правила в целях поддержания точности прогноза. В условиях роста бизнес-объемов важна автоматизация профилирования и валидирования, а также инструментальная поддержка для управления версиями и мониторингом. Регулярные аудиты и обновления контрактов данных позволяют быстро адаптироваться к изменениям в ассортименте, промо-акциях и каналах продаж.
Глава завершена: управление качеством данных для прогноза спроса - это не только техническое задание, но и организация процессов, требующая дисциплины, прозрачности и тесного взаимодействия между бизнесом и инженерной средой. Правильно выстроенная система профилирования, очистки и подготовки обеспечивает устойчивость моделей, снижает риск ошибок и повышает доверие к принятым на основе данных решениям.


