

Импорт данных через Spark Load: использование внешних ресурсов
Импорт данных через Spark Load в StarRocks позволяет реализовать эффективную и масштабируемую конвейерную загрузку данных из разнообразных внешних хранилищ. Эта глава фокусируется на архитектуре интеграции, схемах импорта, настройке внешних ресурсов и практиках эксплуатации. Рассматриваются сценарии, где вычислительная мощность Spark обрабатывает данные, а StarRocks обеспечивает быстрый анализ и интерактивные запросы к консолидированным данным.
Spark Load выступает как связующее звено между источниками данных и аналитической базой. Он позволяет перенести обработанные данные из большинства современных хранилищ - объектового хранилища в облаке, HDFS, локальных файловых систем - в таблицы StarRocks с сохранением структуры и типов данных. Такой подход снимает необходимость постоянной переработки данных внутри StarRocks и позволяет использовать вычислительные возможности Spark для трансформаций, агрегаций и форматирования перед загрузкой.
Ключевая идея состоит в том, чтобы обеспечить прозрачную интеграцию между двумя мирами: гибкость и богатый набор преобразований Spark и высокую скорость аналитических запросов StarRocks. В этом контексте внешние ресурсы служат единым интерфейсом доступа к данным, а Spark Load обеспечивает законченную форму загрузки - от извлечения данных до их размещения в целевой таблице StarRocks. Важной целью является достижение предсказуемости выполнения, идемпотентности и воспроизводимости конвейера даже в условиях частых изменений схем и больших объемов данных.
-
В этом разделе будут разобраны архитектура и протоколы взаимодействия, подготовка и настройка внешних ресурсов, процедуры загрузки и управление операциями, а также практические рекомендации по мониторингу, тестированию и безопасности.
-
Особое внимание уделяется сценариям, которые часто встречаются на практике: данные-драйверы в S3/HDFS, промежуточные staging-области, обработка форматов Parquet/ORC/CSV, а также стратегия распределения загрузок и выбора между потоковой и пакетной загрузкой.
-
В результате читатель получает целостное представление о том, как проектировать конвейеры импорта через Spark Load с внешними ресурсами, какие архитектурные решения выбирать под конкретные задачи и как избегать распространенных ошибок.
Краткое содержание главы
- Архитектура Spark Load и роль внешних ресурсов в конвейере загрузки данных.
- Конфигурация и безопасная интеграция внешних ресурсов (S3, HDFS, GCS и др.).
- Процессы загрузки: от источника к целевой таблице, с учетом форматов данных и схем.
- Мониторинг, диагностика и методы обеспечения устойчивости загрузки.
- Практический сценарий End-to-End: от источника данных до вкладки в StarRocks.
Архитектура и протоколы интеграции
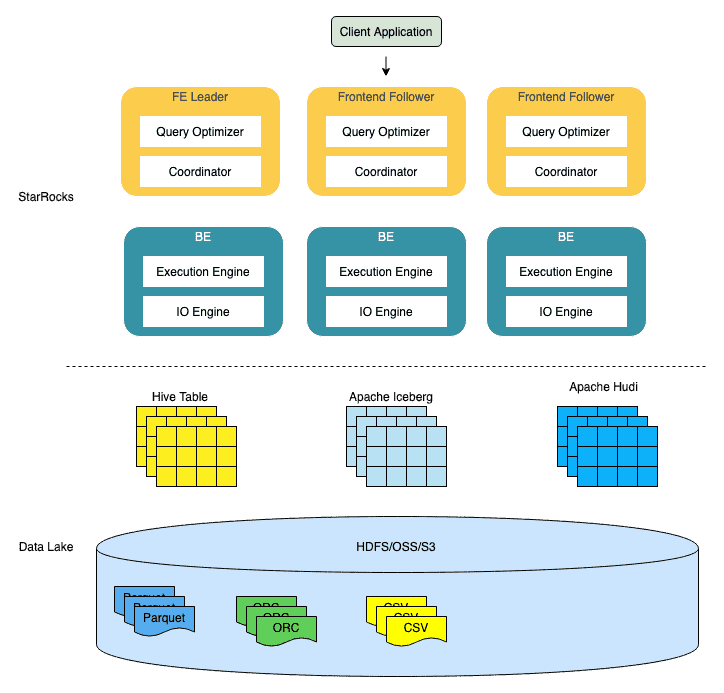
Архитектура Spark Load в контексте внешних ресурсов образуется вокруг трёх основных узлов: Spark-кластер, StarRocks FE/BE-кластер и внешнее хранилище данных. Spark выполняет ETL-преобразования и формирует поток данных в пригодном для загрузки формате. Далее данные передаются в StarRocks через механизм загрузки, который может опираться на разные пути передачи: через REST-API загрузки, через брокер-слой или через прямые вызовы конвейера загрузки. Вариант с использованием внешних ресурсов поддерживает сценарии, когда файлы хранятся на S3, HDFS, GCS или аналогичных системах, и именно оттуда осуществляется чтение и предварительная обработка.
Ключевые аспекты архитектуры:
- Разделение вычислений и хранения. Spark отвечает за обработку, StarRocks - за быстрый доступ к данным в аналитических запросах.
- Единая точка входа к данным через внешний ресурс. StarRocks может опираться на данные, размещенные в облачных хранилищах, не копируя их в локальные ресурсы.
- Уровни согласованности. При потоковых загрузках применяются техники поддержания идемпотентности и повторной загрузки, например, через маркеры импорта и контроль версий файлов.
- Форматы данных. Наиболее распространены Parquet, ORC, CSV и JSON; Spark выполняет конвертации и нормализации форматов под целевую схему StarRocks.
- Безопасность и доступ. Взаимодействие с внешними ресурсами требует управляемых учетных данных, ролей и политик безопасности (IAM, ключи доступа, временные креденшиалы).
Протокольный обмен и интеграционные соглашения целесообразно формализовать в виде следующих схем:
- Spark читает данные из внешнего ресурса и преобразует их в строки и столбцы, соответствующие типовому набору StarRocks.
- Spark Loader инициирует загрузку в StarRocks через единый механизм загрузки, учитывая схему таблицы и требования к данным.
- StarRocks использует механизм контроля целостности загрузки, фиксирует время загрузки, статус и возможные ошибки, что позволяет оперативно реагировать на сбои.
- В случае ошибок система должна возвращать понятные сообщения и позволять повторную загрузку, не вызывая дублирование.
Вопросы архитектуры тесно связаны с выбором между пакетной и потоковой загрузкой. В сценариях, где требования к задержке невысоки и объем данных велик, пакетная загрузка через Spark Load с промежуточными staging-областями оказывается предпочтительной. В случаях, когда данные требуют минимальной задержки, возможно применение потоковой загрузки, где Spark в реальном времени подготавливает микропартии и отправляет их в StarRocks. Важно помнить, что потоковая стратегия требует более сложного мониторинга и обработки повторных попыток, чтобы избежать непреднамеренного повторного внедрения одних и тех же данных.
Примечание: архитектура и протоколы могут варьироваться в зависимости от версии StarRocks и наличия конкретных коннекторов Spark. Всегда следует опираться на официальную документацию и рекомендации по версии.
Поддерживаемые внешние ресурсы и интеграционные сценарии
- Облачные объекты: S3 (AWS), GCS (Google Cloud), Azure Blob Storage. Эти ресурсы часто реализуются через единый интерфейс доступа в StarRocks, и Spark может обращаться к ним напрямую через соответствующие коннекторы.
- Распределённые файловые системы: HDFS, локальные кластеры HDFS. В таких сценариях часто применяется локальная топология кластера Spark и узлы StarRocks в одном дата-центре или в близком сетевом окружении.
- Логические источники: параллельная запись в несколько файловых участков, форматирование файлов и последующая загрузка в одну целевую таблицу.
Важная деталь: для каждого внешнего ресурса следует точно определить параметры доступа, методы аутентификации и политики безопасности. Это обеспечивает предсказуемость поведения загрузки и упрощает диагностику в случае сбоев.
Конфигурация внешних ресурсов и схем импорта
Работа с внешними ресурсами начинается с конфигурации в StarRocks. В базовом сценарии создаются ресурсы, адаптированные под конкретный источник данных, и затем указывается соответствующая схема импорта. В случае S3, например, создаётся ресурс типа S3, в который включаются регион, endpoint, ключи доступа и параметры безопасности. Аналогично на уровне HDFS указываются Namenode/Resource Manager и конфигурации аутентификации.
Основные принципы конфигурации:
- Ясная спецификация источника данных и соответствующих атрибутов доступа. Это позволяет централизованно управлять учетными данными и обновлять их без косвенного воздействия на конвейер.
- Указание форматов данных и соответствий схем. Важно обеспечить согласование типов между Spark-выводом и целевой таблицей StarRocks. При необходимости выполняются временные преобразования типов, нормализация дат и форматов времени.
- Настройка параметров загрузки. Включает режим загрузки (пакетная или потоковая), разделение на партиции и параллелизм загрузки (кол-во параллельных задач, размер партий).
- Безопасность и доступность. Использование временных креденшиалов, шифрование данных в пути и на хранении, управление ролями и политиками доступа.
Пример типичной конфигурации ресурса для S3 (псевдокод, читаемая форма):
CREATE RESOURCE s3_resource PROPERTIES ( "type" = "s3", "region" = "us-west-2", "endpoint" = "https://s3.us-west-2.amazonaws.com", "aws_access_key" = "", "aws_secret_key" = " ", "iam_role" = "arn:aws:iam::123456789012:role/StarRocksLoadRole" );
- Важно отметить, что конкретная синтаксисная форма может варьироваться в зависимости от версии StarRocks. В документации по вашей версии описаны точные поля конфигурации и требования к формату ключей.
После определения ресурса следует привязать источник к целевой таблице. Процедура обычно включает создание схемы в Spark и StarRocks, согласование имен столбцов и типов, а также выбор стратегии загрузки. Для корректной миграции больших массивов данных целесообразно предусмотреть этапы валидации: контрольные суммы файлов, количество записей, сравнение статистик до и после загрузки.
Чтобы минимизировать риски несовпадения схем, целесообразно внедрить механизм эволюции схем. StarRocks поддерживает определённые сценарии изменения структуры столбцов без остановки сервиса, однако требуется аккуратная координация изменений между Spark-предобразованием и целевой схемой. В случаях активных изменений схем полезно внедрять версионирование таблиц или временные схемы загрузки, чтобы не прерывать текущие отчеты.
Процессы загрузки: от источника к целевой таблице
Процесс загрузки состоит из нескольких ключевых фаз, и каждая фаза должна быть задокументирована и повторяема:
- Подготовка источников. Spark-кластер должен иметь доступ к внешним ресурсам и необходимым файлам. Форматы файлов подготавливаются к чтению и агрегируются в партиях, размер которых согласован с параметрами загрузки StarRocks.
- Трансформация и нормализация. В Spark выполняются преобразования, преобразование типов данных, обработка пропусков и приведение к единой временной зоне. В результате формируется набор строк и столбцов, соответствующих целевой таблице.
- Построение конвейера загрузки. В зависимости от стратегии выбираются механизмы загрузки: через REST-API StarRocks загрузки, брокер-загрузку или иной механизм, доступный в версии. Важно обеспечить идемпотентность загрузки, чтобы повторные попытки не приводили к дубликатам.
- Выполнение загрузки. Загрузка может быть выполнена пакетно или частично по блочным партиям. При пакетной загрузке стратегически важна детерминированная последовательность файлов и корректное управление консистентностью. При потоковой загрузке поддерживается обработка непрерывной ленты данных.
- Верификация и пост-обработка. Проверяется целостность загрузки: количество строк, контрольные суммы, метрики партиционирования. Для устойчивых конвейеров следует реализовать сигналы об успехе или неудаче и автоматическую повторную попытку в случае ошибок, с сохранением детализированных логов.
Практическая рекомендация: по мере роста объема данных целесообразно внедрять многоуровневый подход к очистке, разделяя метаданные и данные между Spark-уровнем и StarRocks. Это позволяет работать с различными источниками и форматами, минимизируя влияние ошибок на конвейер. В реальных проектах часто применяются staging-пути: Spark записывает временные данные в промежуточную область в внешнем хранилище, после чего StarRocks инициирует финальную загрузку в целевую таблицу.
Мониторинг, диагностика и устойчивость загрузок
Эффективная эксплуатация Spark Load требует прозрачного мониторинга и быстрой диагностики. В качестве ключевых элементов мониторинга рассматриваются:
- Метрики Spark и загрузки. Включают время выполнения, задержку между чтением и загрузкой, коэффициенты пропускной способности и загрузки партий. Важно иметь дашборды, объединяющие эти метрики с состоянием внешних ресурсов.
- Статусы загрузки в StarRocks. Команды мониторинга, такие как SHOW LOAD, позволяют видеть текущее состояние загрузки, детали ошибок и время выполнения. Рекомендуется автоматизированный сбор и алерты на отклонения от SLA.
- Проверка согласованности. После загрузки нужно подтвердить, что данные соответствуют ожиданиям: количество строк, уникальные идентификаторы, распределение по партициям и статистика столбцов.
- Диагностика ошибок. Частые проблемы - несовпадение схем, недоступность внешнего ресурса, проблемы с аутентификацией, нехватка прав на чтение файлов, форматируемые поля и пропуски. Важной практикой является централизованное логирование и трассировка задач Spark, чтобы быстро локализовать источник проблемы.
- Безопасность и доступ. Мониторинг учетных данных, своевременное обновление секретов и соблюдение политик минимальных прав доступа. Регулярные аудиты и обновления политик доступа снижают риск компрометации данных.
Порядок действий при инциденте загрузки может быть следующим:
- Проверить статус источника данных и доступность внешнего ресурса.
- Анализировать логи Spark и StarRocks на предмет ошибок преобразования и несоответствия схем.
- Убедиться в корректности конфигурации ресурса и форматов.
- Осуществить повторную загрузку с учетом идемпотентности и контроля версий файлов.
- В случае необходимости - вернуться к предыдущей успешно загруженной версии данных.
Практический сценарий End-to-End: от источника к целевой таблице
Рассматривается сценарий, когда данные хранятся в S3 в формате Parquet и необходимо загрузить их в таблицу StarRocks с сохранением разделения по дням и региону. Общий поток включает следующие шаги:
- Определение целевой таблицы в StarRocks. Таблица должна иметь схему, соответствующую полям файлов Parquet и поддерживать разделение по полям, например, датам и регионам.
- Создание внешнего ресурса S3 и настройка безопасного доступа. Включаются регион, точка доступа, и креденшиалы. При необходимости - роли IAM и временные креденшиалы.
- Подготовка Spark-кластера. Установка Spark-приложения или пайплайна, который будет читать Parquet-файлы из S3 и применять необходимые преобразования для согласования со схемой StarRocks.
- Реализация пайплайна в Spark. Преобразование данных, приведение типов, обработка пропусков и, при необходимости, агрегация на этапе предзагрузки.
- Загрузка в StarRocks. Выбор подходящего механизма загрузки: пакетная загрузка через REST-API StarRocks или через Spark Connector, который может осуществлять пакетную загрузку в целевую таблицу. Учитывается идемпотентность и возможность повторной загрузки.
- Валидация. Сравнение количества строк, контрольных сумм и распределения данных до и после загрузки. Повторная загрузка выполняется в случае расхождений, с сохранением идентификаторов загрузок.
- Эксплуатация и мониторинг. Настройка дашбордов для мониторинга загрузок, автоматические алерты и процессы ретраев при сбоях. Обеспечение безопасного доступа к ресурсам и регламентированных процедур резервного копирования.
Этапы могут быть адаптированы под конкретную инфраструктуру: наличие локального кластера Spark, варианты размещения Sever-FE/BE StarRocks и требования к задержке данных. В реальных проектах следует внедрять детальные SOP (standard operating procedures) для каждого шага конвейера и регулярно обновлять их в зависимости от изменений в источниках данных, форматах и версиях инструментов.
Key takeaways
- Spark Load позволяет переносить данные из внешних ресурсов в StarRocks, используя вычисления Spark для трансформации и последующую загрузку в целевую таблицу.
- Архитектура должна обеспечивать четкое разделение ответственности между источником данных, конвейером преобразований и аналитической базой, с предсказуемым временем задержки и возможностью повторных попыток.
- Конфигурация внешних ресурсов требует строгого управления учетными данными, схемами и форматами данных, а также стратегии загрузки и разделения по партициям.
- Важными аспектами являются мониторинг загрузок, диагностика ошибок, обеспечение идемпотентности и устойчивости к сбоям, а также безопасность передачи и хранения данных.
- Эффективная реализация End-to-End включает детальное планирование, верификацию данных и устойчивые операционные процедуры, которые включают тестирование, мониторинг и документирование.
- При проектировании конвейера полезно использовать staging-области и строго контролировать миграции схем, чтобы минимизировать риски дублирования данных.
- Выбор между пакетной и потоковой загрузкой зависит от требований к задержке, объему данных и инфраструктурных ограничений; каждую стратегию следует сопровождать четкими SLA и соответствующим мониторингом.
FAQ
- В чем преимущество использования Spark Load по сравнению с прямой загрузкой через REST API StarRocks?
- Spark Load выгоден, когда данные требуют значительных преобразований перед загрузкой и находятся в формате, не мгновенно пригодном для прямой загрузки. Spark позволяет централизованно обрабатывать данные, консолидировать их из разных источников и затем загружать в StarRocks в готовом виде. REST API StarRocks эффективнее для повторной загрузки простых наборов данных и небольших партий, но может потребовать дополнительных шагов для преобразования и агрегаций.
- Какие внешние ресурсы поддерживаются на практике и какие особенности безопасности?
- На практике поддерживаются S3, GCS и Azure Blob Storage, а также HDFS и локальные файловые системы. Безопасность достигается через управление учетными данными (ключи доступа, временные креденшиалы), использование ролей IAM и шифрование трафика и данных. Выбор подходящей стратегии segurança зависит от требований к соответствию и политик организации.
- Как обеспечить согласованность схем между Spark и целевой таблицей StarRocks?
- Необходимо явно синхронизировать имена столбцов и их типы между Spark-предобразованием и целевой схемой StarRocks. При необходимости применяются преобразования типов и нормы значений до загрузки. В случаях эволюции схем рекомендуется внедрять версионирование таблиц или staging-область с последующим маппингом в целевую схему.
- Какие типичные ошибки встречаются при импорте через Spark Load и как их решать?
- Частые проблемы включают несовпадение форматов, ошибки преобразования типов, недоступность внешних ресурсов, неверные credentiels и проблемы с правами доступа. Решение - централизованный мониторинг, точечная диагностика по логам Spark и StarRocks, повторная загрузка с корректной подготовкой данных и корректным разрешением конфликтов схем.
- Как выбирать между пакетной и потоковой загрузкой в рамках Spark Load?
- Пакетная загрузка предпочтительна, когда требуется максимальная производительность и обработка больших объемов данных за один проход, с заранее известной схемой и периодичностью. Потоковая загрузка лучше для низкой задержки и непрерывного потока данных. Решение должно основываться на SLA, объеме данных, доступной инфраструктуре и устойчивости к сбоям.
- Какие параметры конфигурации внешних ресурсов критичны для производительности?
- Критичны параметры доступа (регион, endpoint, креденшиалы), параметры форматирования и согласование схем, настройки параллелизма загрузки, размер партий и политики повторных попыток. Необходимо определить баланс между размером партий и количеством параллельных задач, чтобы не перегрузить сеть и не перегрузить StarRocks BE.
- Как обеспечить воспроизводимость загрузок в продакшене?
- Важно иметь детальные логи, уникальные идентификаторы загрузок, параметры конвейера и версии используемых компонентов. Резервное копирование конфигураций, конфигурационные файлы как код и автоматическое тестирование конвейера позволяют повторить загрузку в случае сбоев.
- Как проверить корректность данных после загрузки?
- Сверку количества строк, проверку контрольных сумм и сравнение статистик столбцов по исходному источнику и целевой таблице. В идеале - автоматизированные тесты согласованности и проверки выборок.
- Какие требования к операционной практике для поддержки Spark Load?
- Наличие документированных SOP по созданию ресурсов, конвертации схем и планирования загрузок; набор дашбордов мониторинга; процессы релизов и обновления версий инструментов; регламенты безопасности и управления доступом; и регулярные аудиты для обеспечения соответствия политик.
- Какова роль staging-областей и как их выбирать?
- Staging-область служит промежуточным хранилищем для подготовки данных к окончательной загрузке. Использование staging помогает снизить риск влияния форматирования на целевую схему и обеспечивает повторяемость загрузок. Выбор места хранения зависит от доступности и пропускной способности, а также от политики безопасности и затрат.
Это руководство обеспечивает прочную основу для проектирования, реализации и эксплуатации конвейеров импорта через Spark Load с использованием внешних ресурсов в рамках StarRocks.


