

Архитектура CDP: слои, компоненты и принципы взаимодействия
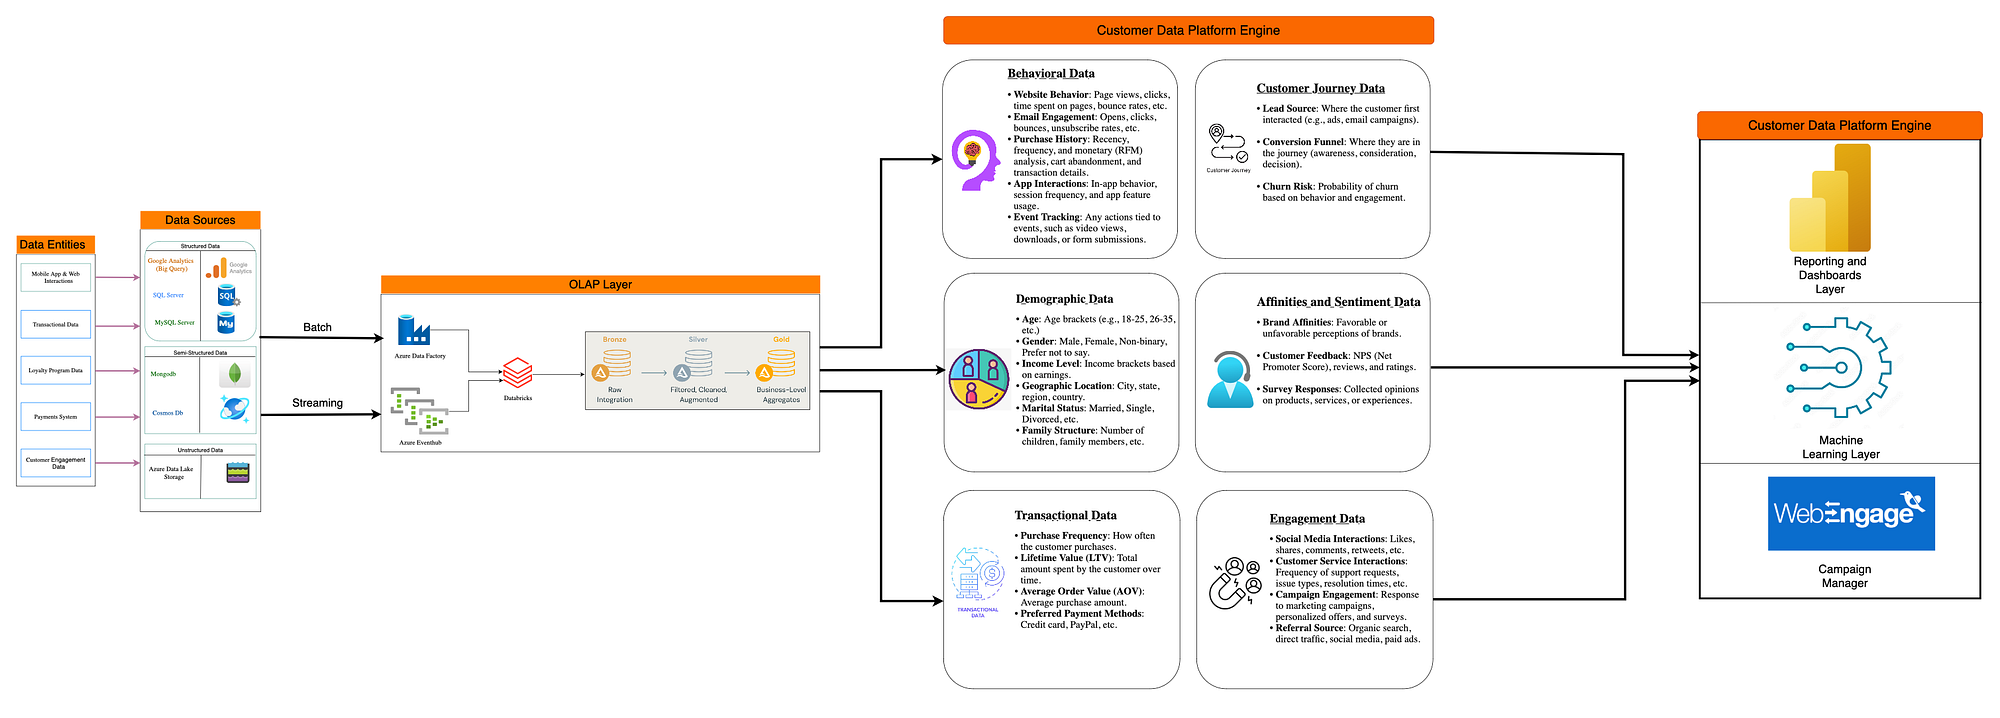
CDP (Customer Data Platform) представляет собой интегрированную инфраструктуру для сбора, унификации и активации клиентских данных в реальном времени. Архитектура CDP должна обеспечивать непрерывную инференцию профилей, корреляцию событий из разных источников, масштабируемое хранение и оперативное использование данных в маркетинге, продажах и сервисе. В контексте потоковых данных ключевое значение имеет ориентация на обработку событий в режиме реального времени, минимизацию задержек и устойчивость к отказам при больших нагрузках. В этой главе рассматриваются слои CDP, их компоненты, принципы взаимодействия и практические подходы к реализации архитектуры, ориентированной на streaming analytics.
CDP-архитектура опирается на модульность и разделение компетенций: от источников событий до активностей в downstream-системах. Основной целью является обеспечение единообразной идентификации клиентов, сопоставление профилей из различных каналов, обогащение данных в режиме реального времени и возможность оперативной активации сегментов. В рамках технического подхода важны выбор протоколов обмена, форматов данных, управление схемӗ и обеспечение согласованности между слоями, чтобы минимизировать дублирование и задержки.
- Краткое содержание главы
- Опора на модульную архитектуру и разделение слоев CDP, взаимодействие через четко оформленные контракты и протоколы.
- Компоненты CDP: источники событий, identity graph, lakehouse/хранилище, сегментация и активация, API и интеграции.
- Паттерны реализации потоковой аналитики: обработка событий, exactly-once semantics, схемы и конвейеры обработки.
- Безопасность, приватность и соответствие: контроль доступа, шифрование, линейка данных и аудит.
- Эволюция архитектуры и сценарии внедрения: облако, мультиоблачность, data mesh и эволюционные шаги.
Архитектура CDP: слои и принципы модульности
Эта часть описывает слои CDP и их функциональные границы, а также принципы взаимодействия между ними.
-
Ингестинг и источники данных
Ингест Layer собирает события из веб- и мобильных приложений, CRM, ERP, оффлайн-источников и внешних каналов. Важной задачей является унификация форматов на входе и поддержка протоколов реального времени (например, AVRO/JSON поверх Kafka) с минимальными задержками. Реализация часто опирается на коннекторы для Kafka Connect или Debezium для CDC-источников баз данных, что упрощает подключение к существующим системам и поддерживает эволюцию схем без потери совместимости. -
Identity и Profile Layer
В этом слое формируется единый профиль клиента через Identity Graph: сопоставление устройств и идентификаторов, объединение событий по одному пользователю, разрешение дублей и управление политиками приватности. Основной задачей является создание устойчивого, линейного представления клиента, которое остается корректным в условиях смены идентификаторов (cookie, device_id, email и т. п.). Важна поддержка privacy-by-design: псевдонимизация, хранение минимально необходимого набора PII и возможность удаления по запросу. -
Processing и Enrichment Layer
Обработка событий в потоке требует поддержки event-time и watermarking, оконной агрегации, соединения потоков и корреляций между различными источниками. Здесь реализуются правила обогащения: добавление атрибутов профиля к каждому событию, вычисление параметров поведенческого рейтинга, нормализация признаков и генерация метрик в реальном времени. В качестве технологий часто применяются потоковые движки: Apache Flink, Kafka Streams или Spark Structured Streaming. -
Storage Layer (Data Lakehouse / Хранилище)
Архитектура CDP предусматривает разделение сырой и подготовленной зон хранения. Raw-потоки и CDC-данные сохраняются в ленивом виде, затем формируются curated-слои и feature store. В современных решениях применяется концепция lakehouse: Parquet/ORC-файлы в сочетании с метаданными и схемами. Это обеспечивает совместимость аналитических запросов, возможность повторного воспроизведения конвейеров и поддержку гибридной аналитики. -
Activation Layer
Актуальные сегменты, аудитории и персонализированные профили становятся доступными для маркетинговых и сервисных систем через API, дампы или интенты запуска кампаний. Включает push-уведомления, activation через DSP/CRM и синхронизацию с рекламными платформами. Важна скорость обновления сегментов и прозрачность жизни аудитории (retention, churn, propensity models). -
Governance, Security и Compliance Layer
Управление данными, каталогизация, lineage, политика доступа и соответствие требованиям (регулятивные и корпоративные) образуют опорный слой. Включает контроль версий схем, журналирование изменений, аудит использования данных и мониторинг нарушений. Этот слой обеспечивает прозрачность операций и соблюдение нормативов по приватности и защите данных. -
Принципы взаимодействия между слоями
Взаимодействие слоев в CDP строится на контрактной основе: каждый слой публикует и потребляет данные через определенные интерфейсы и схемы. Важны: согласование форматов данных (например, Avro с зависимыми схемами), версияция API и событий, поддержка схематической эволюции без нарушения существующих пайплайнов, и поддержка идемпотентности при повторной обработке. Контракты должны включать требования к задержке, дедупликацию, требования к ретрансляции и политики хранения. Обеспечение единообразного управления идентификацией и профилями в условиях распределенного исполнения достигается за счет общей Identity Graph и согласованных правил сопоставления идентификаторов.
Компоненты CDP: функции и интерфейсы
Эта часть фокусируется на ключевых компонентах, их ролях и взаимоотношениях в рамках архитектуры.
-
Потоки событий и коннекторы
Источники предоставляют потоковые события в виде единых абстракций. Kafka является типичной технологической основой для транспортировки потоков, поскольку она обеспечивает горизонтальное масштабирование, устойчивость к сбоям и богатые механизмы репликаций. Для CDC-потоков часто применяют Debezium, который умеет преобразовывать операции изменений в событийные сообщения и публиковать их в топики. Сверх этого могут применяться коннекторы к CRM, мобильным SDK и веб-аналитике, поддерживающие форматы тела события и метаданные источника. -
Identity Graph и профилиране
Единственный профиль клиента строится через граф идентификаторов: сопоставление устройств и каналов, нормализация атрибутов и сопоставление дублей. Граф обеспечивает единообразие данных и позволяет быстро обновлять сегменты, когда обновляются профили или атрибуты. Чем более точная идентификация, тем выше качество персонализации и точность рекомендаций. В практических решениях применяются эвристики сопоставления и правила фузии, поддерживающие защиту приватности и конфиденциальности. -
Lakehouse, Data Store и Feature Store
Хранилище обеспечивает разделение между «сырая» и «обработанная» зоны. Lakehouse-архитектура обеспечивает совместимость аналитических запросов и операционных рабочих процессов, позволяя выполнять машинное обучение и персонализацию на единых данных. Feature Store - механизм хранения актуальных признаков для моделей и сегментов; он упрощает повторное использование признаков между различными сценариями и сервисами. -
Сегментация, активация и API-интеграции
Актуализация сегментов и передачa активированных данных в downstream-системы (рекомендательные сервисы, DMP, CRM) реализуется через API и очереди. Эффективность активации определяется задержкой и точностью синхронизации между CDP и внешними системами. Быстрые и надёжные API-слои, а также поддержка push-каналов, обеспечивают оперативное предложение и персонализацию в реальном времени. -
Контролируемая безопасность и аудит
Встроенные механизмы контроля доступа, аудита и контроля использования данных позволяют обеспечить соответствие нормам и внутренним политикам. Важны такие элементы, как роль-основной доступ, шифрование в транзитe и на диске, маскирование PII и журналирование действий пользователей и сервисов. -
Примеры технологий (с умеренным использованиемOpen Source)
- Kafka для транспортировки потоков и брокера событий.
- Apache Flink или Kafka Streams для обработки в реальном времени.
- Apache Parquet/Delta Lake или Apache Iceberg для хранения в lakehouse.
В рамках проекта можно рассмотреть применение Debezium на CDC-источниках и Kafka Connect для стандартных коннекторов, что сокращает время до внедрения и упрощает поддержку.
Принципы взаимодействия между слоями
Эта часть конкретизирует правила обмена данными, форматы, версии схем, управление идентификацией и вопросы соблюдения регуляторных требований.
-
Контракты форматов и схем
Установление и поддержание схемного контракта между слоями минимизирует несовместимости и упрощает эволюцию данных. На практике применяются схемы сериализации (Avro, Protobuf) с реестром схем, который управляет версиями и миграциями. Это позволяет безопасно внедрять изменения без прерывания существующих пайплайнов. -
Эволюция схем и совместимость
Подходы backwards- и forwards- совместимости необходимы для плавной эволюции данных. Важно поддерживать "несовместимые изменения" через миграцию и версионирование, чтобы старые потребители не ломались при обновлениях. Регулярное тестирование совместимости и мониторинг ошибок помогают поддерживать устойчивость архитектуры. -
Идентификация и соответствие
Мастер-данные по клиенту и Identity Graph должны охватывать cross-channel сопоставление идентификаторов. Это требует стратегий борьбы с дубликатами и устойчивости к потере идентификаторов, а также политики приватности и согласия пользователя. В рамках архитектуры следует поддерживать право на удаление данных и переносимость данных в рамках юридических требований. -
Безопасность и соответствие
Шифрование в транзите и на диске, контроль доступа на уровне сервисов, аудит изменений и управление данными по регулятивным требованиям (например, GDPR/локальные нормы) являются критическими для архитектуры CDP. Применение маскирования и псевдонимизации там, где это возможно, снижает риск утечки данных. -
Наблюдаемость и операционная зрелость
Логирование, метрики и трассировка запросов и пайплайнов обеспечивают возможность быстрого реагирования на инциденты и оптимизацию конвейеров. OpenTelemetry и совместная панель мониторинга позволяют увидеть задержки, throughput и пропускную способность across слои.
Архитектурные паттерны и практические реализации
Эта секция описывает практические паттерны, которые применяются для обеспечения масштабируемости, устойчивости и производительности.
-
Архитектура, ориентированная на события (Event-driven)
CDP строится вокруг потоков событий и асинхронной коммуникации между сервисами. Это поддерживает гибкую интеграцию источников, расширение функциональности и упрощает добавление новых каналов. Такой подход совместим с микросервисной архитектурой и упрощает масштабирование. -
Обработка в реальном времени и оконная аналитика
Системы обработки событий должны поддерживать обработку в реальном времени, корректное управление временем событий (event-time), задержек и приходящих упорядочиваний. В случаях необходимости возможно применение оконной агрегации для расчета поведенческих индикаторов и оперативных метрик. -
Exactly-once и идемпотентность
Для критических конвейеров рекомендуется достижение semantics "exactly-once" на уровне источника данных и обработки. Это предполагает использование детерминированных идентификаторов, транзакционных конвейеров и идемпотентной обработки, чтобы повторная доставка не приводила к дублированию результатов. -
Контракты между слоями и схемы обмена
Важна строгая спецификация форматов и версий схем, поддержка схемной эволюции, и чёткая декларация того, какие поля являются обязательными, а какие допускают отсутствие. Это уменьшает риск несогласованности между командами. -
Роль коннекторов и конвейеров интеграции
Коннекторы заказчиков и open-source коннекторы позволяют ускорить подключение к существующим источникам. Debezium, Kafka Connect и аналогичные решения снижают сложность интеграции и обеспечивают повторяемость пайплайнов. -
Примеры реализации
// Пример упрощенного конвейера: соединение потока событий с профилями // Приведено в упрощенном виде для иллюстрации паттерна enrichment ## Properties props = new Properties(); props.put("application.id", "cdp-enrichment"); props.put("bootstrap.servers", "kafka-broker:9092"); StreamsBuilder builder = new StreamsBuilder(); KStream<String, String> events = builder.stream("raw-events", Consumed.with(Serdes.String(), Serdes.String())); KTable<String, String> profiles = builder.table("profiles", Consumed.with(Serdes.String(), Serdes.String())); KStream<String, String> enriched = events.leftJoin(profiles, (eventJson, profileJson) -> enrichEvent(eventJson, profileJson), Joined.with(Serdes.String(), Serdes.String(), Serdes.String()) ); enriched.to("enriched-events", Produced.with(Serdes.String(), Serdes.String())); KafkaStreams streams = new KafkaStreams(builder.build(), props); streams.start(); -
Интеграции и совместимость
Применение стандартных коннекторов и конвейеров, поддержка CDC-источников, позволяет быстро адаптировать архитектуру к изменяющимся источникам. В реальных проектах часто сочетаются CDC-системы (для баз данных) с потоковой обработкой и архитектурой lakehouse, что обеспечивает непрерывную актуализацию как в реальном времени, так и в аналитических режимах. -
Архитектурные практики для устойчивости
Включение стратегий дедупликации, резервирования и ретрансляции сообщений обеспечивает отказоустойчивость и устойчивость к перегрузкам. Важно иметь возможность масштабирования отдельных слоев независимо друг от друга и поддерживать достаточную резервацию ресурсов.
Безопасность, приватность и управление данными
Согласование приватности и защиты данных является неотъемлемой частью архитектуры CDP.
-
Управление доступом и аудит
Реализация принципа минимума привилегий, ролей и политик доступа к данным, а также полноценных журналов аудита операций пользователей и сервисов. Это позволяет отслеживать, кто получает доступ к каким данным и какие операции выполняются. -
Приватность и маскирование
Псевдонимизация и маскирование ключевых полей (PII) по мере необходимости позволяют снизить риск утечки данных. В рамках Identity Graph применяются методы токенизации и безопасного хранения идентификаторов. -
Шифрование и защита данных
Шифрование данных в транзите и на диске является базовым требованием. Критично важно настроить управление ключами и безопасное хранение ключей (KMS) с аудитом использования. -
Соответствие требованиям
Архитектура должна поддерживать процедуры удаления или аннулирования согласий пользователя, переносимость данных и соблюдение локальных нормативов. Встроенные механизмы планирования retention и резервного копирования помогают соблюсти требования к хранению.
Эволюция архитектуры CDP: направления и практические шаги
Современная архитектура CDP должна быть гибкой и адаптируемой к изменяющимся условиям бизнес-потребностей и технологическим трендам.
-
Облачная и мультиоблачная архитектура
Облачная реализация упрощает масштабирование и ускоряет внедрение новых компонентов. Мультиоблачная постановка обеспечивает устойчивость к рискам поставщиков и позволяет использовать сильные стороны разных платформ. -
Lakehouse как базовая платформа
Современная архитектура CDP склонна к lakehouse-решениям, которые объединяют обработку in-place и аналитическую обработку в единообразной среде. Это позволяет использовать единые данные для аналитики и ML/AI-проекты. -
Data Mesh vs Data Lakehouse
Поворот к распределенной организации данных на уровне бизнес-додсистем требует согласования политики, управления качеством данных и совместного владения данными между командами. В CDP это может принимать форму соглашений об обмене данными между доменами и центрами компетенций. -
Внедрение и трансформация процессов
Внедрение CDP как продукта требует методики внедрения, включающей пилотные проекты, управление изменениями, обучение команд и развитие культуры совместной ответственности за данные.
Key takeaways
- Архитектура CDP строится на слоистой модульности: ингестинг, identity, обработка и обогащение, хранилище, активация и управление данными.
- Реализация в реальном времени требует выбора потоковых технологий (Kafka, Flink), форматов данных и стратегий схемной эволюции.
- Единая Identity Graph и согласованные контракты между слоями критичны для качества профилей и точности сегментации.
- Безопасность и соответствие важны на каждом уровне: доступ, аудит, маскирование и управление данными.
- Практические паттерны включают event-driven архитектуру, обработку в реальном времени с поддержкой exactly-once и повторной обработкой, использование lakehouse и feature store для поддержки аналитики и ML.
- Интеграции с источниками данных и коннекторами упрощают внедрение и обеспечивают масштабируемость проекта.
- Эволюционные шаги должны учитывать переход к облачным и гибридным средам, а также возможность перехода к mesh-архитектурам для управления данными доменов.
FAQ
- Что отличает архитектуру CDP от обычной ETL-пайплайна?
- CDP ориентирован на управление единым профилем клиента и синхронную активацию в бизнес-приложениях в реальном времени. В нём присутствуют слои идентификации, потоковая обработка, управление данными и активные каналы для доставки персонализированных решений, тогда как классическая ETL чаще фокусируется на пакетной загрузке и поздних стадиях анализа без глубокой интеграции в операционные системы.
- Какие слои являются критическими для достижение реального времени?
- Ингестинг, Identity & Profile, Processing & Enrichment и Activation. Именно в этих слоях задержки минимизируются и данные становятся доступными для моментальных действий в сервисах и маркетинговых платформах.
- Как обеспечить точность идентификационных профилей в условиях мультиканальной активности?
- Необходима единая Identity Graph, поддержка нескольких идентификаторов и механизм разрешения дубликатов. Важна постоянная проверка согласования идентификаторов, а также политики приватности и согласия пользователей. Применение deterministic и probabilistic методов в сочетании с контролем доступа улучшает качество профилей.
- Какие сложности возникают при обеспечении exactly-once semantics в потоках?
- Диспатчерство и управление состоянием, обработка повторной доставки сообщений, гарантия согласованности между источником и обработчиком. Решения включают транзакционные конвейеры, использование idempotent-операций и аккуратный контроль ошибок, а также использование механизмов повторной отправки с детерминированными идентификаторами.
- Какие форматы данных и схемы наиболее практичны для CDP?
- Avro или Protobuf для форматов сообщений в потоках (Kafka), Parquet/Orc или Delta Lake для хранения; Schema Registry для управления версиями схем. Эти форматы обеспечивают компактность, качество схем и возможность эволюции без потери совместимости.
- Как обеспечить безопасность и приватность в CDP?
- Маскирование и псевдонимизация персональных данных, шифрование в транзитe и на диске, контроль доступа на уровне ролей, аудит и мониторинг. Учитывайте требования GDPR/локальных регламентов и предоставляйте пользователям права на доступ, удаление и перенос данных.
- Какие требования к мониторингу потоковых конвейеров?
- Непрерывный мониторинг задержек, throughput, ошибок и пропускной способности, трассировка цепочек обработки, системные алерты и dashboards. Используйте OpenTelemetry или аналогичные инструменты для унификации наблюдаемости.
- Какие типичные интеграции играют ключевую роль в CDP?
- Интеграции с источниками событий (веб, мобильные SDK, CRM/ERP), CDC-интеграции для БД, коннекторы к рекламным платформам и CRM-системам, а также интеграции с аналитическими и ML-платформами через lakehouse и API.
- Какова роль data governance в CDP?
- Data governance обеспечивает каталогизацию, контроль версий и lineage, а также аудит использования данных. Это критично для прозрачности процессов и соблюдения регуляторных требований, особенно по части приватности и удаления данных.
- Как начать практическое внедрение архитектуры CDP?
- Определение бизнес-целей и сценариев активации, выбор базовых слоев и технологий, определение контрактов и форматов, пилотный запуск в ограниченном домене, развитие модели управления данными и zasad совместной ответственности, и постепенная эволюция к lakehouse и расширенным интеграциям.


