

Будущее Hadoop: горизонты совместимости и инноваций
Глобальная динамика данных требует от Hadoop не только сохранения традиционных функций, но и способности интегрироваться с современными архитектурами хранения и вычислений. В условиях перехода к data lakehouse, облачным и гибридным развёртываниям, горизонт совместимости становится не столько консервацией старого, сколько драйвером инноваций. Эта глава исследует, какие направления развития обеспечат долгосрочную жизнеспособность Hadoop: от архитектурной модульности и федерации метаданных до внедрения новых форматов данных, объектного хранения и облачных коннекторов. Рассматриваемые концепции раскрываются с акцентом на архитектуру, протоколы, интеграции и практические сценарии внедрения.
Hadoop продолжает эволюционировать в сторону более гибкой и устойчивой платформы для обработки больших данных. Современные требования к отказоустойчивости, масштабируемости и совместимости с облачными сервисами приводят к переосмыслению роли Namenode, вычислительных движков и форматов данных. Вместе с тем сохраняются базовые принципы: единый интерфейс доступа к данным, согласованные принципы безопасности и управляемость в условиях многокластерной инфраструктуры. В этой главе ключевые идеи соединяются в цельную конструкцию: какие инновации становятся необходимыми, какие протоколы остаются базовыми, и какие практики перехода применяются на этапах зрелой эксплуатации.
Краткое содержание главы
- Совместимость и протоколы Hadoop: что сохраняется, а что модернизируется в контексте HCFS и API.
- Архитектура будущего: NameNode federation, модульность, Ozone и безопасность.
- Инновации вычислений и хранения: Data Lakehouse, ACID-форматы Iceberg и Hudi, интеграции с облачным стеком.
- Развертывание и интеграции: Kubernetes, коннекторы к облачным хранилищам, гибридные сценарии.
- Практические подходы к переходу: стратегия миграции, пилоты, планирование устойчивой эволюции кластера.
Эволюция совместимости и протоколов
Совместимость Hadoop традиционно опирается на единый набор API и абстракций доступа к данным, которые позволяют внешним инструментам и компонентам взаимодействовать с файловой системой, метаданными и вычислениями. В перспективе главным становится не столько «копирование» старых механизмов, сколько построение устойчивых слоёв совместимости с современными протоколами и форматами.
Прежде всего сохраняется базовый интерфейс доступа к данным через Hadoop FileSystem API и совместимые реализации HCFS (Hadoop-compatible File System). Однако вокруг него формируются новые слои абстракций, которые позволяют разделять ответственность между хранением и вычислениями, не ломая существующие приложения. Протоколы доступа, такие как REST через WebHDFS, RPC/IPC-оптимизации и адаптеры к объектным хранилищам, остаются фундаментом, но дополняются коннекторами к облачным сервисам и локальным объектным хранилищам. Важнейшими примерами являются коннекторы к Amazon S3 (S3A), Microsoft ADLS/ABFS и аналоги, которые позволяют Hadoop-кластеру работать как единой точке доступа к данным, независимо от места их физического хранения.
Причина такого подхода проста: современные аналитические сценарии требуют глобальной доступности данных и единых политик управления, независимо от того, где они лежат. Поэтому совместимость превращается в гибкую архитектурную стратегию: сохранить стабильность API и контрактов, но внутри обеспечить лёгкое развитие и замену компонентов без нарушения существующих рабочих процессов. Добавляется и новая роль протоколов безопасности и аудита: единый путь аутентификации, согласование прав доступа и управляемая эволюция схем данных.
Важнейшую роль начинают играть современные форматы данных и объектные хранилища. В рамках Hadoop-экосистемы отмечается переход к поддержке ACID-подобной консистентности на уровне записей и операций над таблицами, что становится критическим для взаимодействия с инструментами data lakehouse. Такой переход требует архитектурной поддержки на уровне слоя хранения и планирования выполнения задач, чтобы обеспечить согласованность между исходными данными и вычислениями. В качестве примеров практик совместимости можно отметить внедрение поддержки Iceberg и Hudi как форматов таблиц поверх Hadoop, что даёт детерминированные транзакции, эволюцию схем и историю изменений.
В контексте практической эксплуатации это означает: сохраняется возможность работать с данными, размещёнными в традиционных HDFS, но появляется явная дорожная карта к совместимости с облачными хранилищами и новыми форматами для эффективной аналитики и data governance. Такой подход обеспечивает не только сохранение рабочих процессов, но и плавную миграцию в сторону гибридной и облачной архитектуры, минимизируя риск совместимости и снижая затраты на рефакторинг приложений.
-
Резюмируя: переплетение стабильности API с гибкостью модулей и коннекторов создаёт базу для устойчивого перехода к новым формам хранения данных и новым engines, не отказываясь от проверенных методов.
-
Примеры практик: внедрение S3A и ABFS как транспортных слоёв, поддержка WebHDFS как обратной совместимости, использование адаптеров для Spark и Flink, архитектура, поддерживающая NameNode federation.
Архитектура будущего Hadoop: модульность, NameNode federation, Ozone и безопасность
Будущее Hadoop опирается на три взаимодополняющих направления: модульность архитектуры, федеративный доступ к метаданным и объектное хранение внутри кластера. В сочетании они формируют основу для масштабирования, управляемости и устойчивости к отказам в условиях роста объёмов данных и множества вычислительных движков.
-
Модульность и расширяемость. Архитектура Hadoop должна поддерживать pluggable компоненты: вычислительный движок может выбрасывать конкретную реализацию, не ломая остальной стек. Такой подход упрощает внедрение новых технологий обработчика (например, Spark, Tez, Flink) без радикального пересмотра инфраструктуры хранения. В дополнение к этому разворачиваются легковесные плагины для логирования, мониторинга, безопасности и_SCHEMA эволюции, которые можно обновлять независимо от основных узлов кластера.
-
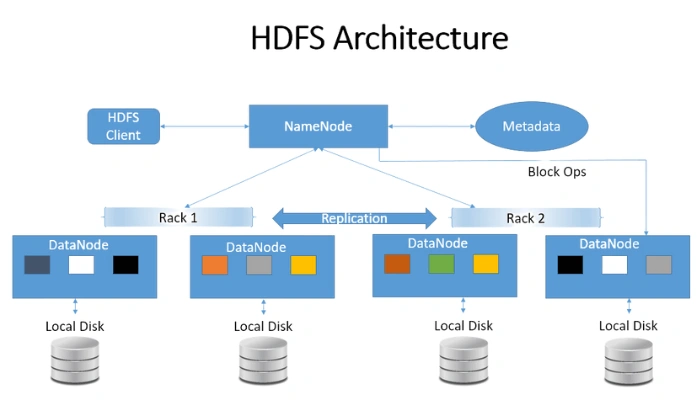
NameNode federation и масштабирование метаданных. Эволюция к федеративной архитектуре NameNode позволяет распараллелить метаданные по нескольким Namenodes, тем самым снизив давление на single point of failure и улучшив масштабируемость кластеров. Реализация федерации требует согласованной схемы конфигураций, репликаций журналов и синхронизации кластера. Это особенно актуально для больших кластеров и многокластерных сред, где одинаковые данные обслуживаются независимо в разных доменах.
-
Ozone как объектное хранилище внутри Hadoop. Apache Ozone выступает как масштабируемый объектный слой, оптимизированный для распределенного хранения больших объёмов данных и совместимой работой с существующими компонентами Hadoop. Ozone снижает нагрузку на NameNode за счёт делегирования части задач хранения и доступа к данным, обеспечивает эффективное хранение больших файлов и метаданные, и упрощает переход к облачным моделям хранения, сохраняя при этом единый контроль над политиками доступа. В контексте гибридности Ozone служит связующим звеном между локальным кластером и внешними объектными хранилищами.
-
Безопасность и управление доступом. Архитектура будущего Hadoop должна тесно интегрировать механизмы аутентификации и авторизации (например, Kerberos, а также централизованные сервисы управления ключами), обеспечивать аудит и соответствие требованиям регуляторов. Инструменты типа Apache Ranger и Atlassian Atlas (или их эквиваленты в отдельных реализациях) могут управлять политиками доступа, каталогами и схемами данных, обеспечивая централизованное наблюдение и соблюдение стандартов.
-
Интеграция с вычислительной средой. Архитектура должна быть открытой к интеграции с несколькими движками выполнения: Spark, Tez, Flink и т.д. Это означает не только совместимость API, но и эффективное планирование задач, обмен метаданными и общую стратегию кэширования. Модульная архитектура упрощает включение новых движков в будущем и снижает риск "vendor lock-in".
-
Роль открытых стандартов. В условиях эволюции инфраструктурных стеков, открытые форматы и протоколы служат мостами между Hadoop и альтернативными платформами. Iceberg и Hudi в составе архитектуры хранения становятся тесной связкой с Hadoop, поддерживая версионирование и транзакционные гарантии на уровне таблиц, что упрощает миграцию и обмен данными с внешними системами.
-
Примеры и ориентиры. Примером интеграции служит переход к Ozone в качестве основного слоя хранения, который можно использовать совместно с S3A или ABFS для гибридной архитектуры. В качестве архитектурной практики - развернуть федеративную схему NameNode в тестовой среде, затем разворачивать её постепенно по доменам данных и кластерам, чтобы минимизировать риск и обеспечить плавный переход.
Инновации вычислений и хранения: Data Lakehouse, ACID-форматы и экосистемные интеграции
Будущее Hadoop тесно связано с переходом к data lakehouse и поддержкой современных форматов, которые обеспечивают транзакционность, схему эволюцию и эффективное управление версиями данных. В этом контексте ключевыми становятся Iceberg и Hudi - проекты, которые позволяют Hadoop работать с таблицами тем же образом, как это делают традиционные реляционные СУБД, но на масштабах анализа больших данных.
-
Iceberg и Hudi как слои таблиц. Iceberg и Hudi предоставляют ACID-совместимость на уровне таблиц, поддержку схемной эволюции и версии данных, а также возможность эффективной обработки параллельными движками. Это означает, что аналитические запросы, выполняемые в Spark, Hive или других engines, получают предсказуемую и детерминированную видимость изменений данных. В рамках Hadoop они становятся логичным продолжением существующей архитектуры, позволяя объединять структурированные данные с полями и параллельной обработкой.
-
Data Lakehouse и единый доступ к данным. Переход к lakehouse-архитектуре означает, что Hadoop может служить как хранителем больших массивов данных, так и платформой для их анализа через современные движки. Включение Iceberg/Hudi в экосистему Hadoop снимает часть компромиссов между надежной загрузкой данных и высокими скоростями аналитики, обеспечивая ACID и лучшую совместимость между потоковыми и пакетными сценариями.
-
Интеграции с облачным стеком и ускорение вычислений. Распределённые вычисления в условиях гибридной инфраструктуры требуют тесной интеграции с облачными сервисами: совместимость с облачными константами хранения, механизмами кэширования и динамической аллокации ресурсов. Hadoop в этом контексте выступает как платформа, способная работать как внутри дата-центра, так и в облаке, при этом используя коннекторы к S3A, ABFS и аналогам для минимизации транспортных затрат и оптимизации latency.
-
Выбор двигателей и оптимизация плана выполнения. В современной реализации выбор вычислительного движка зависит от конкретной задачи и данных. Spark остаётся одним из самых распространённых движков в экосистеме, благодаря своей гибкости и мощной экосистеме, но запускается в связке с Hadoop через архитектурные слои планирования. Реализация Tez или Flink внутри Hadoop может оказаться предпочтительной для определённых рабочих нагрузок; модульная архитектура позволяет менять движок без глобальных изменений конфигурации.
-
Примеры и ориентиры. Примеры открытых проектов: Apache Iceberg и Apache Hudi как ключевые форматы таблиц, которые активно применяются в рамках Hadoop-экосистемы. В контексте интеграций - Alluxio (многоступенчатый кэш и абстракции доступа к данным) может выступать промежуточным слоем между вычислениями и хранением, снижая задержки доступа к данным.
Интеграции и развертывание: Kubernetes, облако и гибридные среды
Современная эксплуатация Hadoop требует готовности к работе в гибридных и облачных средах. Это влияет как на архитектуру кластера, так и на операционные процессы: развёртывание, мониторинг, безопасность и обновления.
-
Kubernetes и Hadoop. Развёртывание Hadoop в Kubernetes позволяет обеспечить динамическую оркестрацию вычислительных ресурсов, масштабирование под нагрузку и упрощение обновлений. Kubernetes-ориейнтированная инфраструктура упрощает интеграцию с облачными сервисами, а также облегчает управление несколькими кластерами за счёт стандартизированного подхода к развёртыванию. В этом контексте Hadoop становится одним из сервисов в большом контейнеризованном ландшафте, где каждый компонент - DataNode, NameNode, YARN - может быть адаптирован под контейнерную среду.
-
Облачные коннекторы и гибридность. Эволюция Hadoop в сторону облачных коннекторов обеспечивает доступ к данным, размещённым вне локального дата-центра. S3A и ABFS выступают как ключевые мосты между локальной инфраструктурой и облачным хранилищем, обеспечивая производительный и надёжный доступ к данным. Постепенная миграция к облаку не исчезает из повестки - она становится частью стратегии гибридной инфраструктуры, где данные и вычисления могут динамически перераспределяться между локальной и облачной средой.
-
Управление данными и наблюдаемость. Современные требования к управлению данными и мониторингу necessitate централизованные решения. Инструменты для аудита, соответствия и политики доступа (Ranger, Atlas) должны быть тесно интегрированы с архитектурой кластера, чтобы обеспечить единообразие политик и управляемость. Наблюдаемость и телеметрия помогают в раннем выявлении сбоев и своевременном масштабировании.
-
Безопасность и соответствие. Расширение безопасности до новейших слоёв хранения, контроля доступа и аудитирования становится критичным для индустриальных применений. В современных развертываниях используется многоуровневая модель: аутентификация, авторизация, шифрование данных на хранилищах и контроль доступа к данным на уровне таблиц и файлов. В этом контексте Hadoop ориентируется на единый набор политик и соответствие требованиям регуляторов, что особенно важно в отраслевых сценариях.
-
Практические аспекты внедрения. При переходе к Kubernetes-ориентированному стеку на практике следует начинать с пилотных проектов, минимизируя риск и инвестируя в мониторинг. Важны концепции «инфраструктура как код», повторяемые шаблоны развёртывания и безопасная миграция данных. Обратная совместимость становится важной: на первых этапах сохраняются существующие коннекторы и API, чтобы приложения не прерывались.
Практические сценарии внедрения и стратегия перехода
Переход к будущей архитектуре Hadoop требует стратегического планирования и управляемой эволюции. Эффективная дорожная карта сочетает в себе технические решения и организационные изменения.
-
Оценка текущего состояния. Необходимо провести аудит существующей инфраструктуры: какие данные и форматы используются, какие движки обработки применяются, какие требования к срокам отклика и согласованности. Это помогает определить точки внедрения новых форматов (Iceberg/Hudi), перекрестные коннекторы и зоны миграции, которые минимизируют прерывание рабочих процессов.
-
Этапность миграции. Рекомендуется реализовать поэтапный переход: начать с отдельных наборов данных и аналитических задач, которые можно перевести на Iceberg/Hudi и сопутствующие движки, затем расширять покрытие. Этот подход позволяет проверить производительность и корректность, а также выстроить governance-процедуры до того, как массово переносить данные.
-
Пилоты и показатели. В рамках пилотных проектов следует определить единые метрики эффективности: латентность доступа к данным, скорость обновления таблиц, транзакционные характеристики на уровне таблиц, устойчивость к сбоям и восстанавливаемость. Наблюдаемость и тестирование в условиях реальных рабочих нагрузок становятся критически важными.
-
Управление изменениями и обучение. Внедрение новых форматов таблиц и новых движков требует изменений в операционных процессах: обновления политик безопасности, новые процессы аудита, поддержка новых инструментов анализа. Дополняются программы обучения сотрудников и обновляется документация по эксплуатации.
-
Гибридность как устойчивость. Для предприятий со значительными инфраструктурными вложениями гибридная модель - оптимальный путь к эволюции. Возможность расчёта на локальном кластере и параллельный доступ к данным в облаке позволяют минимизировать риск и снизить стоимость миграций.
-
Риск-менеджмент и резервирование. Прогнозирование отказов, план резервного копирования метаданных NameNode и резервирования Ozone как слоя хранения позволяют снизить риски в процессе перехода. Поддержка multiple-Region и cross-cluster replication повышает отказоустойчивость и доступность.
Key takeaways
- Современное будущее Hadoop строится на сочетании стабильности API и гибкости архитектуры, позволяющей внедрять новые форматы и коннекторы без нарушения рабочих процессов.
- Архитектура будущего включает NameNode federation для масштабируемости метаданных, модульность компонентов и Ozone как объектное хранилище, что поддерживает гибридные и облачные сценарии.
- Инновации в хранении и вычислениях - переход к lakehouse-подходу с ACID-таблицами на базе Iceberg и Hudi, что упрощает интеграцию с современными аналитическими стекками.
- Интеграции с Kubernetes и облачными коннекторами обеспечивают гибкость развёртывания и упрощение управления многокластерными средами.
- Эффективная реализация требует поэтапной миграции, пилотов и внимательного управления изменениями с учётом governance, безопасности и мониторинга.
- Прозрачность и управляемость остаются критически важными: централизованные политики доступа, аудит и соответствие требованиям должны быть встроены в архитектуру с самого начала.
- Важно помнить о балансе между инновациями и стабильностью: внедряем новые форматы и движки осторожно, сохраняя обратную совместимость, чтобы минимизировать риски для бизнеса.
FAQ
- Что означает «горизонты совместимости» для Hadoop в ближайшие годы?
- Это концепция устойчивой совместимости через сохранение базовых API и контрактов при параллельном развёртывании новых форматов, коннекторов и архитектурных слоёв. Горизонты предполагают, что приложения, управляющие данными в Hadoop, будут продолжать работать, даже если инфраструктура переходит к новому стеку хранения и вычислений. Важной практикой является внедрение модульных слоёв, которые позволяют переходить к Iceberg/Hudi и к облачным коннекторам без переработки существующих приложений.
- Какие ключевые архитектурные изменения ожидаются в Hadoop?
- Основные изменения связаны с федерацией метаданных (NameNode federation), поддержкой модульной архитектуры, использованием объектного хранения (Ozone) и усилением безопасности и контроля доступа. Эти изменения позволяют масштабировать кластер и обеспечивать устойчивость к сбоям, сохраняя единый доступ к данным и управляемость.
- Зачем Hadoopу Iceberg и Hudi?
- Iceberg и Hudi предоставляют транзакционную целостность, эволюцию схем и версионирование таблиц в рамках большего набора данных. Это критически важно для data lakehouse-модели, где данные проходят частые обновления и требуется консистентность между чтением и записью. Они позволяют объединить гибкость Hadoop и спрос на управляемые, надёжные данные для аналитики.
- Как Hadoop интегрируется с Kubernetes?
- Kubernetes обеспечивает динамическое масштабирование и управление ресурсами, упрощает развёртывание компонентов Hadoop в облачных и гибридных средах. Это позволяет отделить вычисления от хранения, быстро адаптировать кластер под нагрузки и ускорить обновления без прерывания рабочих процессов.
- Какие вызовы требуют внимания при переходе на новые форматы?
- Основные вызовы - согласование схем, миграция существующих данных без потерь, управление версиями таблиц, миграция процессов ETL/анализов и обеспечение безопасного доступа к данным. Важна поэтапная стратегия миграции, тестирование на пилотных проектах и грамотное управление политиками безопасности.
- Какие шаги стоит предпринять в начале пути к будущему Hadoop?
- Провести аудит текущей инфраструктуры и потребностей в аналитике; выбрать пилотный набор данных для внедрения Iceberg/Hudi; настроить федерацию метаданных на тестовом кластере; внедрить S3A/ABFS-коннекторы и протестировать работу в гибридной среде; определить показатели производительности и безопасности; подготовить дорожную карту миграции и обучить команду эксплуатации.
- Как обеспечить безопасность и соответствие в условиях эволюции?
- Встроить централизованные политики доступа и аудита, интегрировать Kerberos и ключевые сервисы управления ключами, использовать Ranger и Atlas для governance и контроля версий данных, а также обеспечить журналирование и мониторинг безопасности на уровне кластера и таблиц.
- Какие ограничения существуют при переходе к Lakehouse в Hadoop?
- Основные ограничения связаны с необходимостью перестройки части рабочих процессов, совместимости существующих инструментов с новыми формами таблиц и необходимостью масштабирования инфраструктуры под новые требования к транзакционности. Однако умеренный и поэтапный подход, опирающийся на Iceberg/Hudi и модульную архитектуру, позволяет снизить риски и удовлетворить бизнес‑потребности быстрее.
- Можно ли сохранить текущее уникальное преимущество Hadoop при переходе?
- Да. Hadoop остаётся мощной платформой для хранения и обработки больших данных. Современный подход добавляет к нему гибкость, совместимость и инновационные форматы без отказа от существующих рабочих процессов. В результате предприятие получает устойчивую платформу, готовую к будущим требованиям к архитектуре данных и управлению ими.
- Какие признаки успешной реализации горизонтов совместимости?
- Признаки включают снижение времени отклика на аналитические запросы, устойчивость к сбоям и возможность плавной миграции данных и процессов, сохранение согласованности данных между различными средами, а также наличие централизованной governance и детальной наблюдаемости. Успешная реализация сопровождается прозрачной и понятной дорожной картой миграции и измеримыми бизнес-результатами.


