

Построение и использование планов: автоматизация оптимизации и rewrite
Глава посвящена тому, как управлять планами выполнения в хранилищах данных при работе с большими объёмами и аналитическими нагрузками. Рассматриваются архитектура планировщика, механизм rewrite, практики автоматизации оптимизации и подходы к внедрению управляемых изменений в процессы планирования. В центре внимания - интеграция между сбором статистики, моделями стоимости, правилами переписывания запросов и механизмами кэширования планов. Поставлена задача - обеспечить предсказуемость времени выполнения аналитических запросов при росте объёмов данных и сложности анализа, сохранив при этом гибкость внедрения новых методов оптимизации.
Во вводе описаны ключевые концепты: что именно оптимизирует система планирования, какие слои существуют в типичном DWH-оркестрации, и какие сценарии rewrite наиболее востребованы в больших средах. Далее излагаются принципы архитектуры, набор правил rewrite и примеры их применения, а также практики внедрения, мониторинга и управления изменениями. В конце - обзор кейсов и рекомендации по выбору инструментов и подходов.
- Краткое содержание главы:
- Архитектура планирования и rewrite: как устроены слои и интерфейсы между ними.
- Механизмы rewrite и типы правил: предикат-пушдаун, перестановка соединений, исключение CTE и использование MV.
- Инструменты, протоколы и интеграции: EXPLAIN, форматы планов, внешние движки и каталоги.
- Этапы внедрения и управление изменениями: как проектировать, тестировать и внедрять автоматизацию.
- Прикладной кейс: как применяются rewrite и автоматизация на реальной среде DWH.
Архитектура планирования и rewrite
Современный планировщик выполняет несколько последовательных функций: парсинг SQL-запроса, построение логического плана, выбор физических операторов и стратегий доступа к данным, оценку затрат и формирование окончательного плана. В контексте больших аналитических нагрузок требуется видение не только текущего запроса, но и его поведения в контексте статистик, контекста среды и наличия материалов, агрегатов и кешей. Архитектура должна поддерживать следующие ключевые элементы:
- сбор и актуализацию статистики: распределение значений, кардинальность, частотность, распределение по временным срезам. Статистика напрямую влияет на оценку стоимости операций сканирования, джойнов и агрегаций.
- cost-based optimizer: стоимость выполнения каждого оператора и конвейера, зависимость затрат от параллелизма, размера данных и текущих настроек окружения. В DWH-driven среде стоимость часто вычисляется с учётом распределённых операций, сетевых затрат и накладных расходов на репликацию.
- план-кэш и версии планов: хранение ранее сгенерированных планов, их версии и метаданных об условиях, при которых план считается валидным или устаревшим. Это обеспечивает детерминированность и повторяемость экспериментов.
- rewrite-модуль: набор правил и стратегий, которые могут изменять форму плана без нарушения семантики запроса. rewrite может происходить на уровне логического плана (например, развязка CTE) или физического плана (перестановка соединений, предикат-пушдаун, использование MV).
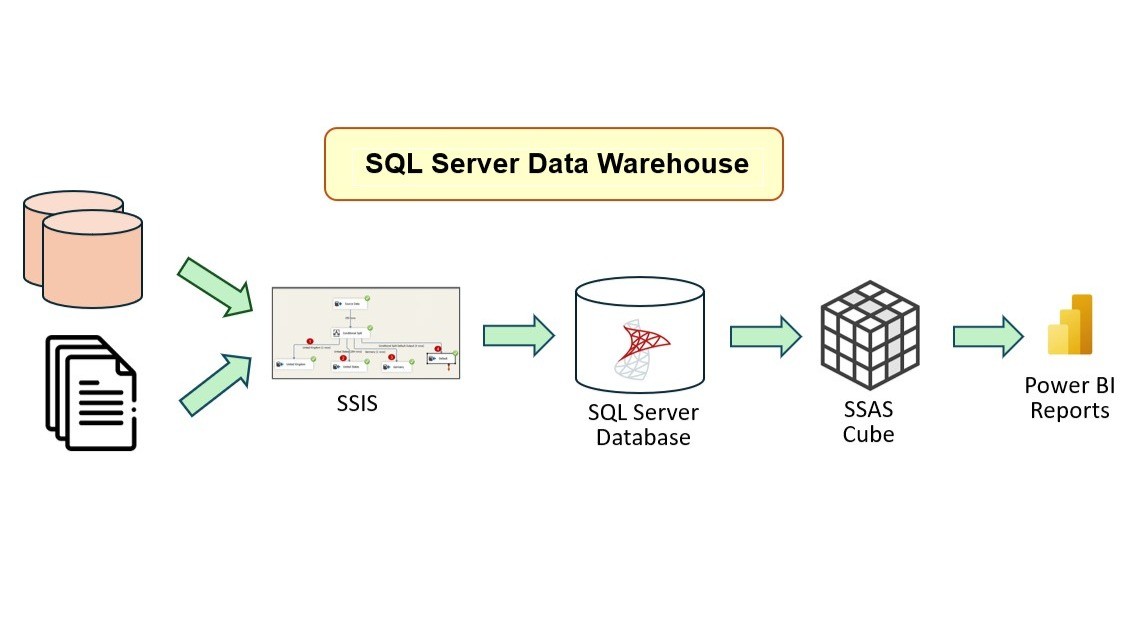
- интерфейс интеграции: механизм взаимодействия между планировщиком и внешними системами - каталоги данных, сервисы метаданных, ETL/ELT-слой и средства мониторинга. В много-двухплатформенных окружениях часто применяется абстракция через открытые слои, например на базе Apache Calcite как мостового слоя.
- мониторинг и безопасность: трассировка решений планировщика, хранение истории изменений, аудит принятых решений и механизмов rollback.
В контексте технической реализации архитектура может быть разделена на уровни: парсер и фабрика логических планов; cost-based optimizer с правилом rewrite; физический план с распределённой стратегией исполнения; и слой мониторинга, который регистрирует качество планов, влияние rewrite и эффективность изменений. Важным является создание контрактов между слоями: какие изменения допустимы в rewrite, как они влияют на господство главного плана, и какие метрики используются для оценки успешности автоматизации.
Механизмы rewrite и типы правил
Rewrite - это совокупность преобразований, которые изменяют форму плана без изменения семантики. Их цель - уменьшить корпус работы, увеличить предсказуемость времени выполнения и повысить устойчивость к изменениям в данных. Разделение на логический и физический уровень позволяет реализовать две группы правил:
- логические правила: упрощение и переупорядочение элементов запроса без привязки к конкретным реализациям доступа. Промежуточные результаты, временные таблицы и CTE могут быть заменены или inline, чтобы содействовать лучшему предикатному пушдауну и меньшей перегрузе планов.
- физические правила: конкретизируют выбор операторов доступа, стратегий сканирования, способов джойна и материализации. Здесь переписывания направлены на использование эффективной архитектуры чтения, предикат-пушдаун, выбор последовательного или параллельного сканирования, перераспределение вычислений и использование предагрегированных данных.
Ключевые rewrite-правила включают:
- predicate pushdown: перемещение фильтров как можно глубже к источникам данных - к сканам таблиц, в том числе к шардам в распределённых системах. Это позволяет уменьшить объем обрабатываемых данных на ранних этапах конвейера.
- join order optimisation: перестройка порядка соединений на основании оценок стоимости. Особенно важно в больших фактовых таблицах и пайплайнах, где ранний доступ к меньким размерностям может существенно снизить общую стоимость.
- projection/column pruning: исключение ненужных столбцов на стадии планирования, особенно важное для столбцов с большими типами данных и очень широких фактов.
- CTE elimination и inlining: удаление общих табличных выражений или их раскрытие внутри основного плана, чтобы избежать лишних материалов и потоков данных.
- использование материализованных представлений и агрегаций: переписывание запроса в форму, которая может обслуживаться MV или агрегатами, что уменьшает вычислительную нагрузку на фактальные таблицы.
- прослойки между слоями: переписывание к сценарию, когда данные свертываются или разворачиваются через промежуточные структуры, чтобы сократить сетевые траты и увеличить локальность вычислений.
- прайса-ориентированная фильтрация и денормализация стратегий доступа: выбор более дешевых путей доступа при наличии альтернатив, особенно в распределённых средах.
- сохранение детерминированности: правила rewrite должны быть детерминированы и воспроизводимы; они должны иметь чётко формализованные условия применения и тестовые сценарии.
Практика показала, что успешная автоматизация rewrite требует системного подхода: каждое правило должно быть явно ограничено по применимости, сопровождаться тестами регрессии и метриками влияния на стоимость выполнения. Ниже приведены примеры реализаций на концептуальном уровне.
// Псевдокод: правило predicate_pushdown
function rewrite(plan):
  for pred in plan.filters:
    if pred.canPushdown() and pred.applicableTo(plan.sources):
      plan.pushdown(pred)
  return plan
// Пример реального сценария: использование MV для ускорения типичной пары запросов
## CREATE MATERIALIZED VIEW mv_sales_q1 AS
SELECT date_id, region, SUM(amount) AS total_amount
FROM fact_sales
WHERE date_id BETWEEN 202101 AND 202103
GROUP BY date_id, region;

-- Далее запрос может быть переписан так:
SELECT s.date_id, s.region, s.total_amount
## FROM mv_sales_q1 s
WHERE s.region = 'EU' AND s.date_id >= 202101;
Эти примеры иллюстрируют две крайности rewrite: с одной стороны, перенаправление условий на источники данных, с другой - использование агрегированных структур для снижения объема вычислений. В реальных системах rewrite реализуется как цепочка правил, где каждый шаг учитывает текущее состояние плана и установленный бюджет по времени выполнения, чтобы обеспечить баланс между скоростью адаптации плана и стабильностью исполнения.
Порядок применения правил имеет критическое значение. В большинстве систем сначала применяют предикат-пушдаун, затем пытаются убрать избыточные операции над данными (например, ненужные CTE), далее - перестановки джойнов и выбор материалов. Важно поддерживать возможность отката к ранее валидной версии плана и наличие тестов на регрессию, чтобы исключить нежелательные побочные эффекты от rewrite.
Инструменты, протоколы и интеграции
Эффективная работа планирования невозможна без согласованной экосистемы инструментов и протоколов. В условиях крупных DWH-окружений необходимы средства, которые позволяют наблюдать процесс, версионировать правила, управлять форматами планов и поддерживать совместимость между различными источниками данных.
- Форматы планов и EXPLAIN: современные СУБД поддерживают форматы текстового и JSON-выводаExplain, что облегчает автоматическую обработку и сравнение планов. JSON-представления дают структурированную информацию для автоматизированного анализа, подсветки узких мест и тестирования rewrite.
- Каталоги и метаданные: единый источник информации о таблицах, их статистике, зависимостях и планах. Метаданные позволяют корректно определить, когда rewrite допустим, а когда необходимо сбросить кеш планов вследствие изменений в структуре данных.
- Интеграция с ELT/ETL: планировщик взаимодействует с процессами загрузки и трансформации данных. Наличие консистентных контрактов между слоями данных минимизирует риск рассогласования между планами и реальным содержимым хранилища.
- Протоколы доступа и интерфейсы: JDBC/ODBC, JDBC-прокси и API-уровни позволяют внешним инструментам запускать запросы и получатьExplain-вывод, что облегчает анализ планов и автоматическую валидацию rewrite.
- Open-source и современные подходы: Apache Calcite может выступать промежуточным слоем для нормализации SQL-диалекта и предоставления общего набора правил rewrite, совместимого между разными СУБД. В качестве примера коммерческих решений часто встречаются механизмы планирования внутри движков вроде PostgreSQL, Snowflake, ClickHouse, которые поддерживают свои форматы планов и правила оптимизации.
Таблица ниже иллюстрирует сопоставление форматов Explain и типичных сценариев применения:
| Формат Explain | Описание | Применение |
|---|---|---|
| FORMAT TEXT | Читаемый текстовый вывод плана | Быstriще диагностики, локальная работа разработчика |
| FORMAT JSON | Структурированный план в JSON | Автоматизированный анализ, визуализация, регрессия rewrite |
| FORMAT XML | Расширенные метаданные | Интеграции с внешними инструментами, которые ожидают XML-структуру |
В части интеграций крайне важна совместимость с внешними инструментами метаданных и каталогами. В реальных инфраструктурах часто применяются единая абстракция над планами и правила rewrite, чтобы обеспечить портируемость между средами: на этапе разработки - локальные планы, на этапе тестирования - консистентные окружения, на этапе прод - детерминированные версии с полной версией миграций.
Этапы внедрения автоматизации планов
Внедрение автоматизации планирования и rewrite - это не единовременная настройка, а управляемый процесс, включающий четыре основных шага:
- Диагностика текущего состояния: сбор статистики по выполнению запросов, анализ частоты и стоимости переработок планов, идентификация «узких мест» в источниках данных и схемах.
- Проектирование набора правил: выбор правил rewrite на основе реальных паттернов запросов и данных, документирование условий применения, ограничений и критериев успешности.
- Разработка и тестирование: создание тестовой среды, регрессионные тесты на наборе типовых запросов, оценка влияния rewrite на время выполнения и нагрузку на ресурсы, валидация повторяемости результатов.
- Внедрение и мониторинг: развёртывание в прод-окружение с управляемой версионизацией правил, мониторинг качества планов и влияния rewrite на SLA-метрики, регулярные аудиты и обновления набора правил на основе накопленных данных.
Особую роль играет продуманная политика версионирования планов и правил. Ввод версий позволяет:
- отслеживать влияние отдельных rewrite-правил на качество планов;
- проводить A/B-тестирование различных стратегий;
- откатываться к рабочей конфигурации при негативном влиянии изменений;
- поддерживать совместимость между версиями статистик, метаданных и структур данных.
Для внедрения рекомендуется использовать паттерны: «инкрементная выкладка» правил, ограничение по времени жизни кэшированных планов, автоматическое тестирование на контрольной выборке запросов и периодическую перенастройку порогов, связанных с порезкой планов. В крупных DWH-проектах полезно формировать центр экспертиз по rewrite и планированию - команда, ответственная за поддержание правил, мониторинг влияния на PERFORMANCE и согласованность с бизнес-цельями.
Прикладной кейс: rewrite в DWH на примере общих практик
Рассмотрим гипотетическую крупную аналитическую среду на базе распределённого хранилища данных. В этой среде регистрируется: рост объёмов по фактовым таблицам, несколько десятков размерностей и зависимостей между ними, регулярные ежемесячные и квартальные агрегации, а также периодические обновления статистики. В таких условиях rewrite-правила применяются по цепочке: сначала минимизируем объем данных на сканировании, затем - улучшаем порядок выполнения джойнов, после чего применяем MV-оптимизации там, где возможно. В процессе реализации важно сохранить прозрачность изменений для бизнес-подразделения и дать возможность тестирования новых правил в изолированной среде.
Примерные шаги внедрения в кейсе:
- сбор требований к SLA и целевых метрик по времени ответа и загрузке узлов;
- создание набора типовых запросов, охватывающих наиболее ресурсоёмкие сценарии;
- разработка набора rewrite-правил на основе анализа паттернов запросов: предикат-пушдаун для часто фильтируемых временных диапазонов, изменение порядка джойнов в пользу меньших таблиц, использование MV для часто запрашиваемых агрегатов;
- внедрение системы версионирования правил и мониторинга влияния rewrite на показатели;
- периодический ретестинг и обновление статистик, что обеспечивает корректное поведение планировщика с учётом изменений во внешних данных;
- внедрение политики отката и аудита, чтобы обеспечить безопасность изменений и устойчивость к ошибкам.
В качестве примера инструментов можно привести PostgreSQL как эталонную СУБД с развитыми механизмами планирования и EXPLAIN, а также Apache Calcite как мостовую технологию для интеграции различных источников и унификации правил rewrite. В реальных проектах чаще всего применяется гибридное решение: базовый rewrite внутри движка плюс внешний слой оптимизации через несколько инструментов анализа планов.
Key takeaways
- Планирование в DWH - многоуровневая система, гдеRewrite играет ключевую роль в сокращении затрат и времени выполнения аналитических запросов.
- Правильная архитектура планирования должна обеспечивать детерминированность, версионирование планов и четкую интеграцию с метаданными и каталоги данных.
- Rewrite-правила подразделяются на логические и физические; их применение требует последовательности и контроля за влиянием на стоимость и семантику запроса.
- Предикат-пушдаун, перестройка порядка джойна, исключение CTE и использование MV - базисные приемы, которые применяются в большинстве DWH-архитектур.
- Мониторинг и тестирование изменений критически важны: без регрессионных тестов и контроля версий rewrite может привести к нестабильности и непредсказуемым задержкам.
- Инструменты и протоколы должны обеспечивать единое представление о планах, удобство анализа и совместимость между средами (разработка, тестирование, прод).
- Практическая реализация требует баланса между автоматизацией и управлением изменениями: версионирование, A/B-тестирование, аудит и откаты.
- Материализованные представления и агрегации могут существенно ускорить повторяющиеся аналитические сценарии при грамотном управлении их обновлениями и очисткой.
- Важно сочетать теоретические подходы rewrite с реальными бизнес-целями: соблюдение SLA, контроль затрат и прозрачность для анализа бизнес-пользователями.
FAQ
- Какие основные типы rewrite-правил существуют и какие задачи они решают?
Основные типы включают предикат-пушдаун (сокращение объема данных на ранних стадиях), reorder-правила (перестановка джойнов для экономии стоимости), CTE-elimination и inlining (упрощение структуры запроса и уменьшение материалов), использование MV и агрегаций (ускорение повторяющихся аналитических задач). Каждый тип направлен на снижение объема обработки, уменьшение задержек и повышение предсказуемости результатов.
- Как выбрать стратегию rewrite: правило-базированный подход или более сложная cost-based оптимизация?**
В большинстве случаев целесообразно сочетать оба подхода. Правила позволяют гарантировать применение эффективных трансформаций в конкретных сценариях, тогда как cost-based оптимизация обеспечивает гибкость и адаптацию к изменяющимся данным и конфигурациям окружения. Важна прозрачность правил и регулярное тестирование их влияния на производительность.
- Какие риски связаны с автоматизацией планов и rewrite?
Основные риски - деградация производительности из-за неучтённых условий, потеря детерминированности, затруднения в аудит и откатах, а также возможное рассогласование между планами и актуальными данными. Эффективная миграция требует контроля версий, тестирования на регрессию и мониторинга влияния rewrite на SLA.
- Какие метрики следует изучать для оценки влияния rewrite?
Важны время исполнения, среднее и медианное время, вариативность времени выполнения (CV), нагрузка на узлы, затраты на сетевой обмен и использовании кэшей, частота использования определённых планов, а также доля планов, испытавших отклонения при изменении данных.
- Как организовать governance rewrite в крупной компании?
Необходимо сформировать центр экспертиз по планированию и rewrite, установить процесс согласования изменений, регламент версионирования и выпуска правил, внедрить автоматические тесты на регрессию, обеспечить прозрачность для бизнес-пользователей и чёткие политики отката.
- Какие инструменты лучше использовать для поддержания плана и rewrite в разных СУБД?
В технических условиях целесообразно рассмотреть Apache Calcite как мостовой слой и светлые примеры open-source решений. В случае конкретных СУБД - их встроенные механизмы EXPLAIN/FORMAT и поддержка MV. Не перегружайте архитектуру избыточными инструментами; выбирайте баланс между совместимостью, прозрачностью и стоимостью поддержки.
- Как протестировать rewrite перед внедрением в прод?
Разрабатывать набор регрессионных тестов на representative-массивах запросов, сравнивать планы и время выполнения до и после rewrite, выполнять A/B-тестирование на ограниченной выборке пользователей, отслеживать SLA и проводить нагрузочные тесты.
- Что делать, если rewrite привёл к непредвиденной деградации?
Быстро зафиксируйте изменения, вернитесь к рабочей версии, проанализируйте логи и метрики, воспроизведите кейсы на тестовой среде, скорректируйте правила и параметры cost-based моделирования, повторно запустите регрессию и аудит использования планов.
- Как учитывать новые источники данных и изменения схем?
Необходимо автоматическое обновление статистик и зависимостей, пересмотр набора правил rewrite с учётом новых характеристик источников, поддержка тестовых сценариев, охватывающих новые источники, и валидирование совместимости планов с обновлённой схемой.
- Какие сценарии лучше всего подходят для применения rewrite на практике?
Частые агрегации над большими фактскими таблицами, сценарии с повторяющимся паттерном запросов к MV или агрегированным представлениям, сценарии с ограниченным временем окна и фильтрами по двум-трем измерениям, а также случаи, когда предикаты часто ограничивают выборку по незначимым столбцам на ранних этапах обработки.


