

Функциональная data engineering - современная парадигма пакетной обработки данных
Пакетная обработка данных - более известная как ETL — крайне сложный, трудоемкий и времязатратный процесс. Кроме того, его достаточно сложно организовать, развивать и корректировать в случае возникновения каких-либо неисправностей.
В данной статье мы рассмотрим, как применение парадигмы функционального программирования к проектированию данных способно внести большую ясность в вышеупомянутый процесс. Здесь мы собрали лайфхаки, накопленные за время работы в Yahoo, Facebook, Airbnb и Lyft, а также добавили информацию исходя из более чем десятилетнего опыта работы с хранилищами данных и data engineering. Предлагаем начать с краткой вводной информации о функциональном программировании из Wikipedia:
В computer science функциональное программирование - это парадигма программирования или стиль построения структуры и элементов компьютерных программ, при котором вычисления рассматриваются как оценка математических функций, а также исключаются данные с изменяемым состоянием и мутабельные данные. Это декларативная парадигма программирования , то есть программирование осуществляется с помощью выражений[1] или деклараций[2], а не утверждений. В функциональном коде выходное значение функции зависит только от аргументов передаваемых функции, поэтому вызов функции f дважды с одним и тем же значением аргумента x приводит к одному и тому же результату f(x); в отличие от процедур, зависящих от локального или глобального состояния, которые могут давать разные результаты в разное время. Устранение побочных эффектов, т.е. изменений состояния, значительно облегчает понимание поведения программы, что является одним из ключевых мотивов развития функционального программирования.
Функциональное программирование вносит ясность во многие процессы. Когда функции являются "чистыми" - то есть не имеют побочных эффектов, - их можно писать, тестировать, аргументировать без необходимости понимать внешний контекст или историю событий, связанных с их выполнением.
По мере усложнения конвейеров ETL и роста числа специалистов, работающих с данными, использование методологий, обеспечивающих ясность процессов, становится первостепенной необходимостью.
Воспроизводимость (reproducibility)
Воспроизводимость является основой научного метода. Чем серьезнее требования, предъявляемые к аналитике, тем тщательнее должна быть проверка всего процесса. Для того чтобы данным можно было доверять, процесс получения результатов должен быть полностью прозрачным и воспроизводимым.
По мере постоянной эволюции бизнес-правил крайне важно изолировать изменения вычислительной логики от изменений данных и контролировать все «движущиеся части». Рассмотрим пример, когда в исходных данных, предоставленных другой компанией, обнаружены ошибки, и было принято решение повторно импортировать исправленные данные. Теперь мы знаем, что все структуры данных, полученные из этой таблицы для данного временного диапазона, должны быть переработаны. Теоретически мы можем применить точно такую же схему вычислений, как и в исходном проходе, поверх скорректированных данных. Отметим, что при этом важно добиться того, чтобы связанные наборы данных, используемые в расчете, были абсолютно идентичны тем, которые были у нас на момент первоначального расчета. Например, если один из последующих процессов присоединится к какому-либо измерению для обогащения данных, необходимо добиться того, чтобы это измерение было абсолютно идентично тому, каким оно было при вычислении исходного процесса. Если мы не можем дать такую гарантию, тогда выполнение одного и того же вычисления для одного и того же периода времени может давать разные результаты при каждом вычислении.
Аналогично, если мы хотим изменить бизнес-правило и выполнить обратное заполнение всех последующих вычислений, нам нужна гарантия того, что изменение логики - это единственная движущаяся часть. Нам также важно убедиться в том, что блоки данных, используемые в вычислениях, абсолютно идентичны тем, которые использовались при повторном запуске исходного процесса, или, другими словами, что источники не были изменены.
Проще говоря, неизменяемые данные и версионная логика являются ключом к обеспечению воспроизводимости.
Чистые задачи (pure tasks)
Чтобы сделать пакетную обработку функциональной, прежде всего, необходимо исключить любые побочные эффекты, выходящие за рамки поставленной задачи. Чистая задача должна быть детерминированной и идемпотентной - это означает, что при каждом запуске или повторном выполнении она будет выдавать один и тот же результат. В данном случае требуется применение подхода перезаписи, то есть повторное выполнение чистой задачи с теми же входными параметрами должно перезаписывать все предыдущие выходные данные, которые могли быть оставлены в результате предыдущего выполнения той же задачи.
Наличие идемпотентных задач крайне важно для обеспечения работоспособности конвейеров. При сбоях задач или при необходимости изменения логики вычислений по тем или иным причинам нам необходимо быть уверенными в том, что повторный запуск задачи безопасен и не приведет к двойным вычислениям или другим возможным неприятностям. Без этого предположения принятие решений о необходимости повторного выполнения требует полного контекста и понимания всех потенциальных побочных эффектов предыдущего выполнения.
Заметим, что в отличие от чистой функции чистая задача, как правило, не "возвращает" объект в программистском смысле этого слова. В контексте ставшего уже привычным подхода SQL ELT , это скорее всего будет только лишь перезапись части таблицы (раздела). Хотя это может выглядеть как побочный эффект, вполне можно считать, что этот вывод похож на неизменяемый объект, который возвращает обычная чистая функция.
Кроме того, отдельные задачи должны быть нацелены на один выход, подобно тому, как чистая функция не должна возвращать набор разнородных объектов.
В некоторых случаях может оказаться так, что избежать побочных эффектов сложно. Одно из возможных решений - переосмыслить размер единицы работы. Может ли задача стать чистой, если она включает в себя другие смежные задачи? Можно ли ее очистить, разбив на ряд более мелких задач?
Также важно, чтобы все переходные состояния внутри чистой задачи были изолированы, подобно локально скопированным переменным в чистых функциях. Несколько экземпляров чистой задачи должны быть полностью независимы в своем выполнении. Если используются временные таблицы или фреймы данных, то они должны быть реализованы таким образом, чтобы экземпляры задачи не могли мешать друг другу, что позволяет распараллелить их выполнение.
Разделы таблиц как неизменяемые объекты
Одним из способов реализации функциональной парадигмы программирования является использование неизменяемых объектов. Хотя функциональные языки предотвращают мутации путем принудительного использования неизменяемых объектов, вполне можно использовать функциональную практику даже в условиях, когда открытые объекты на самом деле являются изменяемыми.
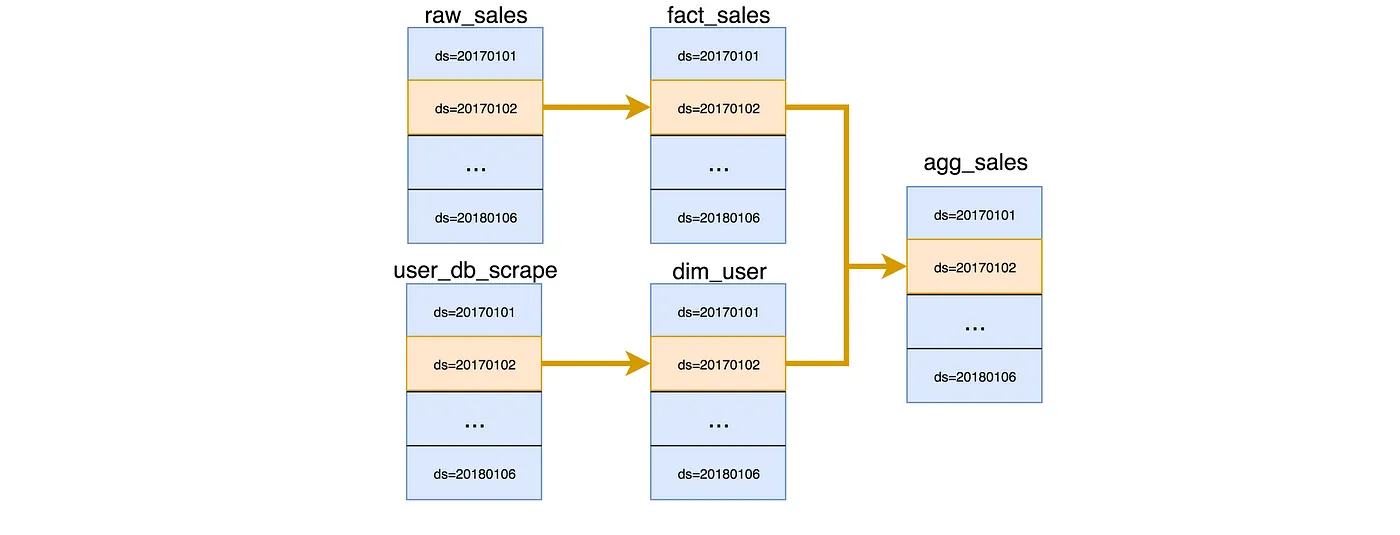
Хотя выбранная Вами база данных может позволять обновлять, вставлять и удалять данные на Ваше усмотрение, это не значит, что Вы обязаны это делать. Операции DML, такие как UPDATE, APPEND и DELETE являются мутациями, вызывающими побочные эффекты. Восприятие разделов как неизменяемых блоков данных и систематическая перезапись разделов - вот путь к функциональности Ваших задач. Чистая задача всегда должна полностью перезаписывать раздел в качестве своего выхода.
Возможно, в Вашем хранилище данных нет поддержки физических разделов, но это не мешает Вам использовать функциональный подход. Чтобы обойти это ограничение, можно реализовать собственную схему разбиения, используя в качестве выхода чистых задач различные физические таблицы, которые можно объединить с помощью ALL в представления, выполняющие роль логических таблиц. Результаты могут быть различными в зависимости от того, насколько "умным" является Ваш оптимизатор базы данных. В качестве альтернативы можно также логически разбить таблицу и систематически удалять данные перед INSERT, используя ключ разделения, отражающий параметры, используемые при инстанцировании задачи. Обратите внимание, что если операция TRUNCATE PARTITION обычно является "бесплатной" операцией с метаданными, то операция DELETE может быть достаточно дорогостоящей, и это стоит принять во внимание. Если Вы решите пойти по этому пути, то учтите, что на многих системах баз данных эффективнее сначала проверить, нужна ли операция DELETE, чтобы избежать ненужной блокировки.
Постоянная и неизменяемая staging area
Staging area - это концептуальная погрузочная платформа Вашего хранилища данных; если в случае реального физического склада Вы бы хотели использовать временную область для хранения товаров и пользоваться ей беспрепятственно, то в случае современных хранилищ данных Вам необходимо накапливать и сохранять там все свои данные, и хранить их в неизменном виде неограниченное количество времени.
При наличии постоянной неизменяемой staging area и чистых задач теоретически можно пересчитать состояние всего хранилища с нуля (но не факт, что это нужно делать) и прийти к точно такому же состоянию. Зная это, можно значительно сократить политику хранения производных таблиц, понимая тот факт, что по своему усмотрению можно восполнить исторические данные.
Изменение логики во времени
Бизнес-логика и связанные с ней вычисления имеют тенденцию изменяться со временем, иногда ретроактивно, иногда нет. При ретроактивном изменении можно считать, что существующее изменение делает существующие нижележащие разделы "грязными" и требует их повторного вычисления. Если изменение не имеет обратной силы, то логика ETL должна уловить его и применить соответствующую логику к соответствующему временному диапазону. Логика, изменяющаяся со временем, всегда должна быть зафиксирована внутри логики задачи и применяться условно при инстанцировании. Это означает, что в идеале логика в системе управления источниками должна описывать, как построить полное состояние хранилища данных во всех временных периодах.
Например, если вводится изменение в виде нового правила расчета налогов в 2018 году, которое не применялось до 2018 года, опасно просто обновить задачу. Если кто-то введет изменение, требующее "обратного заполнения" 2017 года, то он, сам того не осознавая, применит правило 2018 года к данным 2017 года. Решение заключается в применении условной логики в задаче с определенной датой вступления в силу, и в зависимости от вычисляемого фрагмента данных дополнительная налоговая логика будет применяться там, где это действительно необходимо.
Также следует учитывать и то факт, что во многих случаях изменения бизнес-правил с течением времени лучше всего выражать с помощью данных, а не кода. В таких случаях желательно хранить эту информацию в "таблицах параметров", используя даты вступления в силу, и иметь логику, которая соединяет и применяет нужные параметры для обрабатываемых фактов. Упрощенным примером может служить таблица "Ставки налогообложения", в которой подробно описываются ставки и периоды их действия, в отличие от жестко закодированных ставок, заключенных в условные блоки кода.
Как быть с размерами (dimensions)?
По своей природе размеры и другие ссылочные данные изменяются медленно, и очень удобно моделировать это с помощью UPSERT или другой методологии медленно изменяющихся размеров для отражения изменений с сохранением истории. Но как смоделировать это в функциональном хранилище данных без мутации данных?
На самом деле, довольно просто. С моментальными снимками (snapshots) размеров, когда новый раздел добавляется при каждом расписании ETL. Таблица размеров становится коллекцией снимков размеров, где каждый раздел содержит полный размер на определенный момент времени. "Но ведь только небольшой процент данных изменяется каждый день, это же слишком много дублирования данных!". Да, это действительно так, хотя обычно размер размерных таблиц пренебрежимо мал по сравнению с фактами. Кроме того, это поистине элегантный способ решения проблем типа SCD благодаря своей простоте и воспроизводимости. Сейчас, когда хранение и вычисления стоят очень дешево по сравнению со временем разработки, в большинстве случаев привязка размеров оправдана.
Хотя традиционный подход с медленно меняющейся размерностью второго типа концептуально обоснован и в целом может быть более эффективным с вычислительной точки зрения, он слишком громоздок в управлении. Процессы, связанные с этим подходом, такие как управление ключами для размерностей и выполнение поиска ключей при загрузке фактов, сопряжены с множеством ошибок и мутаций, трудно воспроизводимы.
В случае очень больших размеров может оказаться целесообразным или необходимым смешение подхода snapshot с методологией типа SCD. Хотя в общем случае достаточно иметь текущий атрибут только в текущем снимке и денормализовать атрибуты измерения в таблицу фактов там, где важен атрибут на момент события. В редких случаях, когда важность атрибута на момент события не была предусмотрена и не была денормализована в факте заранее, всегда можно выполнить более дорогой запрос, который соединяет факты с моментальными снимками измерений, относящимися ко времени, а не к последнему снимку.
Подход, основанный на "привязке к размеру", можно рассматривать как разновидность дальнейшей денормализации, которая имеет те же компромиссы, что и другие виды денормализации.
Другой современный подход к хранению исторических значений заключается в использовании сложных или вложенных типов данных. Например, если мы хотим отслеживать состояние клиента с течением времени для целей налогообложения, мы можем ввести столбец "state_history" в виде карты, где ключами являются даты вступления в силу, а значениями - состояние. Это позволяет отслеживать историю без изменения структуры таблицы, как это требует SCD второго типа, и является гораздо более динамичным, чем SCD третьего типа, поскольку не требует создания нового столбца для каждого элемента информации.
Единица работы (Work unit)
Также важна ясность в отношении единицы работы, она должна быть непосредственно привязана к выходу на один раздел. Это упрощает сопоставление каждой логической таблицы с задачей, каждого раздела - с частью задачи. Строгость в этой области значительно упрощает прямое сопоставление каждого раздела в хранилище данных с соответствующей логикой вычислений.
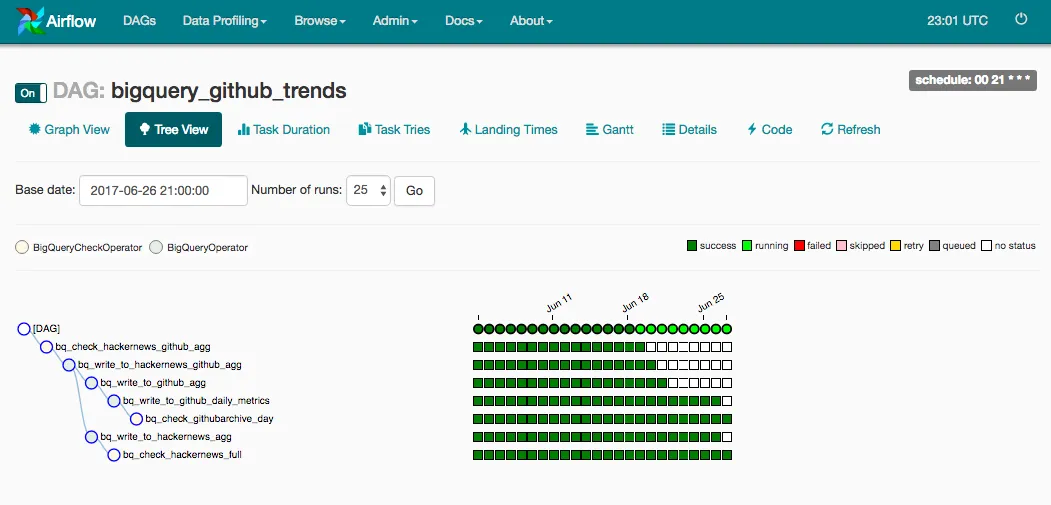
Например, в этом представлении Airflow, где квадраты представляют собой экземпляры задач в DAG во времени, каждая строка представляет cобой задачу, соответствующую таблице, а каждая ячейка - это экземпляр задачи, соответствующий разделу. В этом случае легко отследить, какой файл журнала соответствует тому или иному разделу. Учитывая тот факт, что задачи идемпотентны, повторный запуск любой из ячеек является безопасной операцией. Этот набор правил облегчает сопровождение, так как четкие рамки единиц работы делают процесс понятным и удобным для сопровождения.
В качестве примечания отметим, что Airflow был разработан с учетом функциональной инженерии данных и представляет собой надежную основу для оркестрации идемпотентных, чистых задач в масштабе. Здесь следует сказать следующее: автор этого поста является создателем Airflow, поэтому неудивительно, что его инструментарий хорошо сочетается с методологией, описанной в данной статье.
DAG
Хотя Вы точно можете представить себе рабочий процесс как направленный незацикленный граф (DAG) задач, а историю данных - как граф, состоящий из таблиц в качестве узлов, функциональный подход позволяет представить более точную картину, состоящую из экземпляров задач и разделов. В этом более детальном графе мы переходим от отдельных строк или ячеек, являющихся "атомарным состоянием", которое может быть изменено, к тому, что разделы являются наименьшей единицей, которая может быть изменена задачами.
Такой граф данных, состоящий из разделов, гораздо проще представить по сравнению с альтернативным вариантом, когда любая строка могла быть вычислена любой задачей. С таким графом разделов все становится более понятным. Линейка любой строки может быть привязана к конкретному экземпляру задачи через его раздел, и, следуя графу вверх по течению, можно понять всю линейку как набор разделов и связанных с ними экземпляров задач.
Прошлые зависимости (Past dependencies)
Чаще всего к увеличению " состояния сложности " приводит ситуация, когда раздел зависит от предыдущего раздела той же таблицы. Это приводит к линейному росту сложности с течением времени. Если, например, при вычислении последнего раздела пользовательского измерения используется предыдущий раздел этой же таблицы, а таблица имеет трехлетнюю историю с ежедневными снимками, то глубина результирующего графа переваливает за тысячу, а сложность графа растет линейно. Проще говоря, если нам нужно обработать данные за несколько месяцев назад, то может потребоваться обработка сотен разделов с использованием DAG, которая не может быть распараллелена.
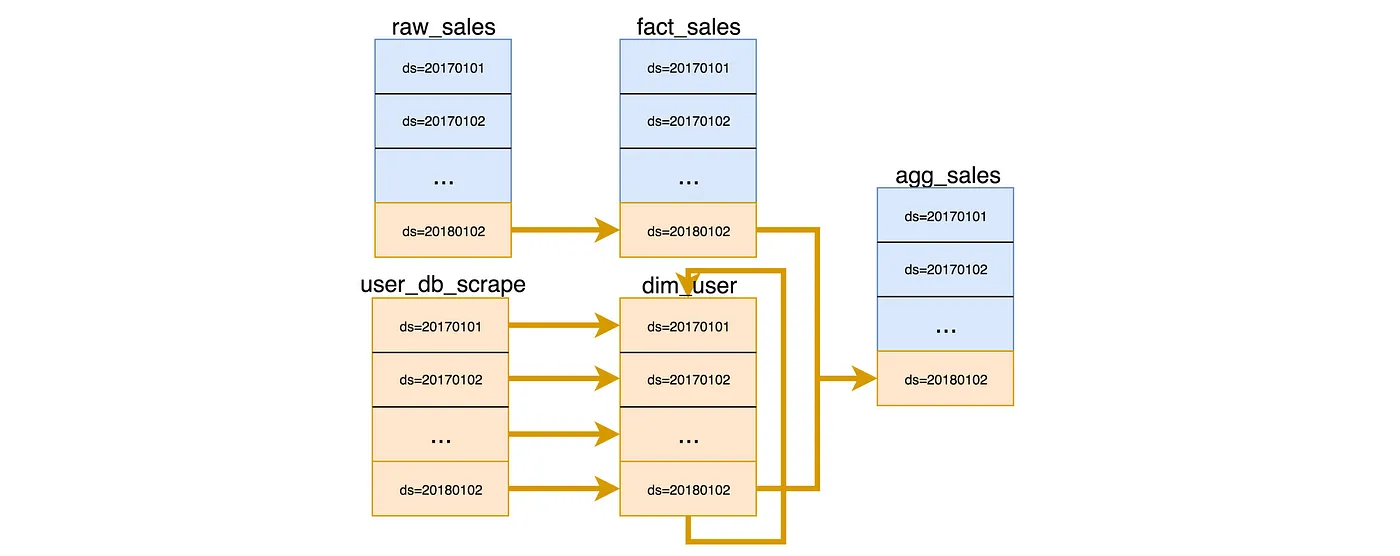
Учитывая тот факт, что обратное заполнение встречается достаточно часто и что прошлые зависимости приводят к созданию DAG большой глубины, желательно избегать моделирования с использованием прошлых зависимостей. В тех случаях, когда необходимы метрики кумулятивного типа (например, расходы клиентов в реальном времени), одним из вариантов может стать моделирование вычисления этой метрики в специализированном фреймворке или независимой модели, оптимизированной именно для этой цели. Фреймворк для кумулятивных вычислений вполне может стать темой для отдельной статьи, не будем углубляться в этот вопрос в рамках данного обзора.
Поздно поступающие данные (Late arriving facts)
К сожалению, поздно поступающие данные - довольно распространенное явление, особенно с учетом популярности мобильных телефонов и периодической нестабильности сетей.
Чтобы внести ясность в этот вопрос, необходимо прежде всего отделить время события от времени его приема или обработки. В тех случаях, когда существуют факты, поступающие с опозданием и требующие обработки, разделение времени всегда должно производиться по времени обработки события. Это позволяет высаживать неизменяемые блоки данных без задержек.
Таким образом, в аналитике появляются два тесно взаимосвязанных временных измерения, что позволяет проводить сложный анализ, учитывающий факты, поступившие с опозданием. Полезно знать, когда были сообщены события по отношению к тому, когда именно они произошли. Это позволяет отображать такие показатели, как "общий объем продаж в феврале по состоянию на 1 марта". Таким образом, фактически создается машина времени, позволяющая понять, как выглядела реальность в любой момент времени.
При определении схемы разбиения на основе времени обработки события означает, что Ваши данные больше не разбиты на разделы по времени события, а это значит, что Ваши запросы, которые обычно имеют предикаты по времени события, не смогут извлечь выгоду из разделов (когда база данных считывает только подмножество разделов). Очевидно, что это весьма дорогостоящий компромисс. Есть несколько способов нивелировать эту проблему. Одним из возможных вариантов является разбиение по временным измерениям, что должно привести к относительно низкому коэффициенту умножения разделов, но повысит сложность модели. Другим вариантом является составление запросов, в которых применяются предикаты как по времени события, так и по относительно более широкому временному диапазону обработки.
Также следует отметить и тот факт, что в некоторых случаях хранилища, оптимизированные для чтения, не сильно «страдают» от неспособности оптимизатора базы данных пропускать разделы путем обрезки, поскольку оптимизация движка выполнения может позволить достичь сопоставимой производительности. Например, если Ваш движок обрабатывает файлы ORC или Parquet, то выполнение будет ограничено чтением заголовка файла перед переходом к следующему файлу.
Стандартное отклонение (Standard deviation)
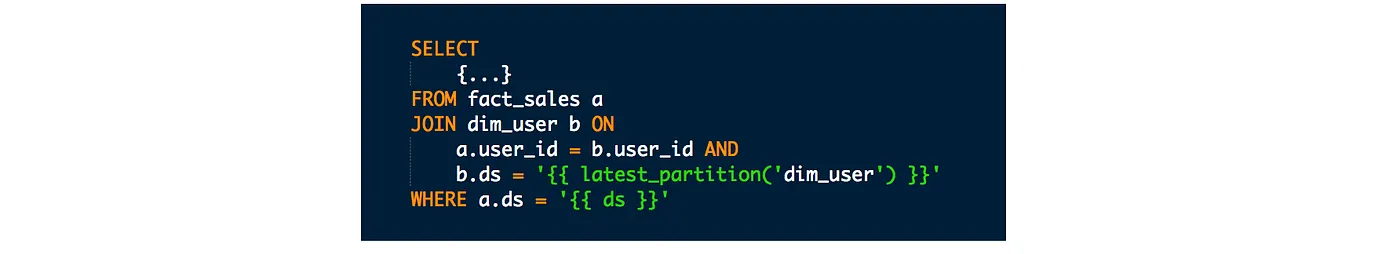
Правила созданы для того, чтобы их нарушать, и в некоторых случаях это более чем оправдано. Рассмотрим пример, когда мы хотим вычислить агрегаты, зависящие от пользовательского измерения, но это пользовательское измерение обычно появляется очень поздно. Возможно, мы нам важнее то, чтобы наш агрегат был получен в начале дня, чем его точность. Учитывая это предпочтение, можно присоединиться к самому последнему разделу, доступному на момент выполнения остальных зависимостей. Заметим, что это может быть легко ограничено определенным временным диапазоном (например, 2-3 разделами), чтобы обеспечить минимальный уровень точности. Конечно, это означает, что повторная обработка таблицы агрегации в будущем может привести к несколько иным результатам.
В ретроспективе
Несмотря на то, что данный пост является первым в формализации функционального подхода к проектированию данных, эти методы отнюдь не экспериментальные или какие-то совершенно новые. Крупные корпорации, управляемые данными и обладающие развитым аналитическим потенциалом, применяют эти методы уже много – много лет.
Очевидно, что функциональный подход противоречит множеству изданий и практикам по хранению данных. Можно со всей ответственностью утверждать, что данный подход в большей степени соответствует тому, как функционируют современные базы данных, оптимизированные для чтения, поскольку они, как правило, используют неизменяемые блоки или сегменты и обычно не допускают мутаций на уровне строк. Кроме того, в данной методологии хранение данных рассматривается как сравнительно недорогостоящий процесс, в то время как время, наоборот, как драгоценный ресурс.
Когда Ralph Kimball написал свою статью The Datawerouse Toolkit, базы данных, используемые для хранилищ данных, были очень подвижными, а команды специалистов по работе с данными - немногочисленными и узкоспециализированными. С тех пор ситуация сильно изменилась. Данных стало гораздо больше; хранилища, оптимизированные для чтения, теперь строятся на основе неизменяемых блоков; кроме того, наблюдается увеличение количества распределенных систем, а также количества людей, участвующих в "аналитическом процессе".
Поскольку данная методология приводит к созданию более управляемых рабочих нагрузок, она позволяет большим командам специалистов расширять границы возможного за счет использования воспроизводимых и масштабируемых практик.


