

Введение в тему: гранулярность фактов, бизнес-смысл данных и цели аналитики
Гранулярность фактов - это не просто техническое свойство таблиц. Это принцип, который определяет, на каком уровне детализации регистрируются бизнес-события, какие меры и метрики можно рассчитывать корректно, как меняются KPI и как быстро можно получить инсайты. Неправильно выбранная зернистость ведет к искажениям в аналитике: избыточная агрегация скрывает важные паттерны, слишком детальная регистрируемость приводит к перегрузке хранилища и задержкам в доступе к данным. В итоге аналитика теряет управляемость, а бизнес - доверие к цифрам. В этой главе рассматриваются принципы, которыми следует руководствоваться на этапе проектирования архитектуры данных, чтобы гранулярность фактов поддерживала бизнес-цели и оставалась гибкой к изменениям.
Говоря простым языком, гранулярность фактов определяется тем, каким образом бизнес-события представлены в системе и какой смысл несут соответствующие цифры. В контексте аналитики это означает: какие единицы измерения считаются фактами, какие параметры связаны с ними, какие роли играют измерения и как они взаимодействуют с измерениями-измерителями (дефинициями KPI, показателями эффективности, метриками клиента и т. д.). В итоге задача аналитики - сохранить бизнес-смысл данных на уровне зерна, который позволяет как строить точные однозначные KPI, так и поддерживать эволюцию отчетности без повторной переработки модели.
Далее следует логика, необходимая для практической реализации: как определить зерно фактов, как спроектировать схему данных, какие протоколы интеграции применяются для сохранения консистентности между источниками и целевым хранилищем, какие алгоритмы агрегации и какие меры контроля качества обеспечивают устойчивость аналитики к изменениям в бизнес-процессах. В техническом аспекте это означает разделение ответственности между слоем источников, слоем интеграции, слоем хранения и слоем семантики. В методическом плане - четкую договоренность об определении зерна, о конституирующих элементах фактов и о принципах эволюции схемы без потери исторической целостности.
Глава рассчитана на профессионалов, работающих в контексте цифровой трансформации и систем бизнес-аналитики. Здесь используются конкретные концепты и практические подходы, которые применимы как в классическом хранилище данных, так и в современных архитектурах данных (data lakehouse, data mesh и др.). В описании избегаются абстрактные логические схемы без привязки к бизнес-кейсам; каждое положение иллюстрируется примерами из реальных сценариев и сопровождается практическими рекомендациями по реализации.
-
В этой главе рабочие термины будут выделяться с помощью форматирования: гранулярность, зерно фактов, кросс-обоснование и конформность измерений, а также ключевые техники - roll-up, drill-down, материализованные представленияи CDC.
-
Вопросы соответствия и контроля будут рассматриваться в контексте качества данных, управляемости и рисков аналитики.
-
Краткое содержание главы
-
Как определяется гранулярность фактов и почему зерно критично для бизнес-аналитики.
-
Архитектурные подходы к моделированию фактов и измерений: звезда, снежинка, конформные измерения, SCD и семантика.
-
Прогнозирование и агрегации: как не потерять смысл при совокуплениях и временных срезах.
-
Интеграция источников, обработка и качество данных: протоколы, технологии и культурные практики.
-
Организация внедрения: роли, процессы и управление изменениями.
Гранулярность фактов: концепции и границы
Гранулярность фактов - это глубина детализации событий, регистрируемых в системе аналитики. Она определяется зерном факта - конкретной комбинацией бизнес-атрибутов, которые однозначно идентифицируют событие и позволяют корректно агрегировать показатели. В большинстве практик зерно формируют ключевые измерения и параметры: транзакции, события действия клиента, производственные операции и т. д. Правильное зерно позволяет достичь баланса между точностью и производительностью.
Основные принципы:
- Гранулярность должна соответствовать бизнес-целям. Например, если требуется анализ по каждой покупке, зерно должно учитывать order_id и line_item_id; для анализа по заказам может быть достаточно только order_id.
- Каждый факт должен иметь ясно сформулированное зерно и набор показателей, которые действительно отражают бизнес-цель. Не существует «универсального» зерна: оно определяется контекстом отрасли, моделью продаж, логикой расчета KPI.
- Избыточная детализация создает «плохую пропускную способность»: увеличение объема данных без адекватной пользы приводит к задержкам и усложняет поддержку. С другой стороны, слишком аггрегированное зерно ломает детальное понимание паттернов и ограничивает возможности анализа.
- Концепции конформности измерений и согласованности семантики критически важны. Если разные факты используют разные бизнес-ключи или дефиниции измерений, агрегаты будут некорректны.
Понимание границ зерна требует формального подхода к определению одного главного вопроса: каким должно быть зерно фактов для конкретного кейса и как обеспечить устойчивость к изменениям в бизнес-процессах. Приведем простой пример. В рамках онлайн-магазина зерно фактов может быть на уровне детализации «строка заказа» (order_id, product_id, quantity, price) или «сам заказ» (order_id, суммарная стоимость, дата заказа). Выбор зависит от того, какие KPI и сценарии анализа будут востребованы: отчеты по продажам по товарным позициям, по магазинам или по времени, а также потребность в детализированных операционных анализах (например, возвраты по строкам, скидки по позиции).
- Ключевые термины:
- зерно фактов: набор ключевых атрибутов, определяющий единицу измерения в фактах.
- факт: числовая мера или набор мер, связанных с зерном.
- размерность: атрибуты, которые описывают факт и позволяют выполнять группировки.
- конформность измерений: согласованность дефиниций измерений между различными фактами и источниками.
Чтобы проиллюстрировать практику, рассмотрим упрощённый сценарий из электронной торговли. Факт-таблица может быть рассчитана на уровне «строки заказа» с такими полями: order_id, product_id, store_id, date_id, quantity, revenue. Если же бизнес требует анализа по заказам без детализации по позиции товара, зерно можно сузить до уровня «заказ», используя: order_id, store_id, date_id, total_order_value. В первом случае аналитика позволяет детально анализировать продажи по каждой позиции товара и конкретному магазину; во втором - сосредотачивает внимание на глобальных результатах по заказам. Очевидно, что выбор зерна должен быть сделан на старте проекта и закреплен в данных контрактами.
CREATE TABLE fact_sales_line_item (
  order_id BIGINT NOT NULL,
  product_id INT NOT NULL,
  store_id INT NOT NULL,
  date_id DATE NOT NULL,
  quantity INT,
  revenue DECIMAL(18,2),
  PRIMARY KEY (order_id, product_id, date_id)
);
Этот пример демонстрирует, как зерно на уровне «строки заказа» задает составную уникальную запись факта и обеспечивает возможность точной агрегации по товарам, магазинам и датам. Важной практикой является документирование зерна и его влияние на доступные KPI, чтобы аналитики и инженеры данных не расходились во взглядах на то, что именно считается фактом.
- Важные аспекты при работе с гранулярностью:
- четкое определение зерна на старте проекта.
- поддержание согласованности между фактами разных источников (конформные измерения).
- документирование изменений зерна и стратегий миграции.
- учет семантики временных аспектов: временная гранулярность, политика хранения исторических данных.
Архитектура моделирования под гранулярность: факты, измерения и схемы
Эффективная архитектура требует четкого разделения между слоями источников, интеграции, хранения и семантики. Основные принципы:
- Определение зерна как константы дизайна. В рамках архитектуры должны быть зафиксированы зерно фактов и набор связанных измерений до начала активной разработки.
- Применение звездной схемы (star schema) как базового шаблона дизайна: факт-таблица в центре и ориентированные на нее размерности вокруг нее. Это упрощает агрегацию, ускоряет запросы и облегчает поддержку бизнес-логики.
- Использование конформных измерений. Когда несколько фактов требуют общей размерности (например, product, date, customer), конформные измерения обеспечивают единообразие расчета KPI и консистентность между модулями аналитики.
- Управление Slowly Changing Dimensions (SCD). В зависимости от бизнес-правил применяются типы изменений (SCD Type 1, 2, 3…), чтобы сохранить историю атрибутов размерностей (например, изменение категории товара или статуса клиента).
- Поддержка degenerate dimensions и bridging tables. Д degenerates позволяют включать в таблицу фактов атрибуты, которые не требуют отдельной размерности, а bridging-разделы обеспечивают связь между множеством кросс-связей.
- Управление метаданными. Важно обеспечить семантику, глоссарий, линейность данных и трассируемость изменений через lineage-метаданные.
Практическая часть - как это реализуется в реальной архитектуре. Рассмотрим кейс онлайн-ритейла: зерно фактов - «строка заказа»; размерности - product, customer, store, date; факты - quantity, revenue, discount_amount. Архитектура строится по принципу единых конформных измерений: product и date используются во всех фактах без дублирования семантики. Вопросы, связанные с изменением атрибутов продукта, решаются с помощью SCD Type 2: новая версия продукта создаёт новую запись размерности с новым surrogate_key, а связи с фактами сохраняются через ключи.
Со стороны хранения данных применяются две концепции: аналитическая база на уровне слоя хранения фактов (data vault или star schema) и слой семантики, который содержит бизнес-правила и метаданные. Внедрение инструментария для управления качеством- очереди событий, CDC-потоки, трансформации в dbt или аналогах-позволяет поддерживать согласованность между источниками и целевыми таблицами.
- Типичные технологии и практики:
- Star schema как базовый шаблон проектирования.
- Конформность измерений для единообразия KPI.
- SCD для сохранения истории атрибутов размерностей.
- Политика агрегаций и документирование под разные сценарии анализа.
- Metadata-driven подход: линейки данных, глоссарий, lineage.
Пример сценария. В рамках данных о продажах применяют две взаимодополняющие структуры: факт-таблица и набор размерностей. Факт может быть детализирован по строкам заказов, а некоторые агрегации создаются в виде дополнительных представлений или материализованных путей, чтобы ускорить часто используемые запросы. В случае необходимости появления новых атрибутов в размерностях - такое изменение должно происходить без нарушения существующих отчетов и без потери исторических данных.
-
Важные техники:
- Денормализация по мере необходимости для ускорения аналитики, при этом сохраняя консистентность размерностей.
- Индексирование по сочетанию ключевых полей зерна и часто запрашиваемых измерений.
- Материализованные представления и агрегаты для часто используемых комбинаций, с учётом политики обновления и времени задержки синхронизации.
-
Пример: если дата становится основным измерением обобщения, можно создать отдельную таблицу даты с предрасчитанными атрибутами (день недели, праздники, квантиль временных окон). Это позволяет быстро выполнять временные аппроксимации и расчеты KPI без повторной обработки в каждом запросе.
рамках архитектурной практики важно учитывать устойчивость к изменениям бизнес-процессов. Например, если запуск новой акции требует дополнительных атрибутов в факт-фильтре, схема должна адаптироваться без переработки существующих источников, гибко поддерживая новые измерения и новые KPI. Именно такие гибкие архитектурные решения позволяют не «сломать» аналитику при трансформации бизнеса.
- Примеры подходов к архитектуре:
- Взвешенный подход к зерну: фиксируем зерно на старте, но допускаем создание альтернативных зерен для конкретных сценариев (например, детальная аналитика по маркетинговым кампаниям).
- Использование bridging-таблиц для устранения многие-ко-многим связей между фактами и измерениями (например, связь между заказами и акциями).
- Внедрение политики версионности атрибутов размерностей и механизмов хранения истории.
Интеграция данных и протоколы обработки: от источников к фактам
Успех аналитики во многом зависит от того, как данные проходят путь от источников к фактам. Это включает в себя выбор технологий, протоколов, подходов к обработке и управлению качеством. В техническом плане ключевые вопросы включают:
- Как обеспечить консистентность и детальность данных при интеграции многочисленных источников (операционные СУБД, веб-лог, сторонние партнёры, внешние каталоги)? Роль здесь играет согласование бизнес-ключей, единых договорённостей об определении полей и использование CDC-потоков для минимизации пропусков в обновлениях.
- Как выбрать подход к обработке: ETL vs ELT. В агрессивной архитектуре данные сначала загружаются в «сырой» слой (data lake) и затем обрабатываются трансформациями в целевые структуры. Такой подход упрощает повторную обработку и адаптацию к новым требованиям, но требует более продуманной стратегии качества и lineage.
- Как организовать пайплайны и оркестрацию: использование инструментов для планирования, мониторинга и повторного выполнения заданий. В контексте практик открытого программного обеспечения часто применяют Apache Kafka для стриминговых данных, dbt для трансформаций в рамках ELT-подхода и Apache Airflow для оркестрации рабочих процессов. Эти примеры относятся к числу наиболее часто применяемых в индустрии и иллюстрируют, как синхронизируются потоки данных и как поддерживается консистентность через различные источники.
- Как обеспечить качество данных и контроль изменений: автоматизация проверок, валидаций после загрузки, контроль линий данных и прозрачность изменений. Встроенная работа с глоссарием и контрактами данных гарантирует, что бизнес-пользователи и инженеры данных общаются на одном языке и используют единые определения.
Практическая часть. Рассмотрим типичный цикл ETL/ELT: сбор источников, временной конвертер и загрузка в хранилище, затем трансформации в целевые структуры. CDC позволяет не ждать ночных окон для обновлений и поддерживать «поточность» фактов. В рамках архитектуры можно организовать два слоя: сырые данные (raw) и очищенные/структурированные данные (clean/ curated). На каждом слое могут применяться свои политики качества, но ключ - единая линейность и возможность проследить происхождение любого факта до источника. Важна интеграционная платформа, которая обеспечивает повторяемость, идемпотентность операций и возможности отката.
-
Примеры технологических пары:
- Kafka + Kafka Streams для стриминга изменений и передачи событий в конвейеры обработки.
- dbt для управления трансформациями и централизованной документации бизнес-логики.
- Любые современные дата-платформы, поддерживающие режим ELT и быстрый доступ к агрегированным данным.
-
Важные аспекты интеграции:
- данные должны приходить с четким временем создания и временем обработки, чтобы обеспечить корректные временные расчеты KPI;
- поддерживайте детерминированные идентификаторы событий и единые бизнес-ключи;
- планируйте политики обработки ошибок и повторной загрузки, чтобы обеспечить идемпотентность и устойчивость к сбоям.
Практическая рекомендация: внедряйте архитектуру, которая позволяет по запросу строить новые агрегаты и новые накладные представления без существенной переработки источников. Это достигается за счет модульной структуры конвейеров, четких контрактов данных и кеширования часто запрашиваемых агрегатов.
Алгоритмы агрегации и сохранение бизнес-смысла: как не потерять смысл при агрегировании
Агрегации являются не просто математическими операциями; они должны сохранять бизнес-смысл и позволять строить точные KPI. В этой части рассматриваются принципы и практики, которые помогают сохранить смысл при roll-up и drill-down, а также обеспечить правильно настроенные уровни агрегации.
-
Roll-up и drill-down. В звездной схеме агрегации часто осуществляются по уровням размерностей. Важно, чтобы каждый уровень соответствовал понятному бизнес-агрегату: из детализации по строкам заказа до суммарной выручки по дате или по товарной группе. Необходимо обеспечить корректность агрегатов на всех уровнях и поддержку drill-down для детального анализа.
-
Материализованные агрегаты и представления. Для ускорения часто выполняемых запросов применяются MV/aggregated views. Важно поддерживать синхронность между основными фактами и агрегатами и предусмотреть политику обновления материалов. Материализованные представления ускоряют аналитические запросы, но требуют распределения времени обновления и мониторинга.
-
Временная компонента и периодизация. Часто требуется анализ по времени: день, неделя, месяц, квартал, год. В этом случае использование оконных функций, временных таблиц и предрасчитанных фрагментов увеличивает скорость запросов и уменьшает риск ошибок в расчете.
-
Методы агрегации и качество. При расчете KPI следует учитывать особенности измерений: additive, semi-additive, non-additive. Например, сумма выручки по товару и магазину является аддитивной, тогда как количество товара в запасе - иногда не аддитивно во всех временных контекстах и может требовать отдельного подхода.
-
Управление историей агрегаций. В случае изменений зерна или обновления атрибутов измерений, агрегаты могут устареть. Необходимо поддерживать версионирование агрегационных правил и сценариев миграции без потери истории.
-
Пример. Рассмотрим кейс: нужно вычислять квартальную выручку по продуктам и магазинам. Основное зерно - строка заказа; для квартального анализа можно создать материализованное представление, которое агрегирует revenue по date_quarter, product_id и store_id. При изменении закона их времени хранения или при добавлении новых атрибутов в размерности агрегаты можно обновлять отдельно от основного_FACT_и. Такой подход позволяет чаще отвечать на запросы и не перегружать основной план обработки.
-- Пример SQL-агрегации для квартальной выручки SELECT DATE_TRUNC('quarter', date_id) AS quarter, product_id, store_id, SUM(revenue) AS revenue_q ## FROM fact_sales_line_item GROUP BY DATE_TRUNC('quarter', date_id), product_id, store_id; -
Важные выводы:
- агрегации должны быть предсказуемыми и воспроизводимыми.
- атомарность фактов и конформность размерностей критично для корректных агрегатов.
- документируйте логику агрегаций и их связь с KPI и бизнес-правилами.
-
Риски и управляемость. Несогласованность в трактовке семантики измерений может привести к различиям в расчетах KPI между подразделениями. Регулярные проверки консистентности и согласование трактовок KPI снижают этот риск. Важно обеспечить прозрачность для аудитории и единый источник «правил» для вычисления ключевых метрик.
Управление качеством данных и внедрение
Качество данных - основа доверия к аналитике. Гранулярность фактов усиливает требования к качеству, потому что ошибки на уровне зерна быстро распространяются на когорты, сегменты и KPI. Эффективная система качества данных строится на нескольких слоях: процессы управления данными, контракты данных, мониторинг качества и культура ответственности.
-
Контракты данных и глоссарий. Формулируются чёткие соглашения об определении полей, формате, допустимых значениях и сроках хранения. Глоссарий словарей и бизнес-правил должен быть доступен всем участникам проекта.
-
Мониторинг и предупреждения. Встроенные правила в пайплайны и конвейеры должны выдавать сигналы об отклонениях: пропуски, дубликаты, несоответствие форматов и несогласованность значений. Важна способность быстро локализовать источник проблемы.
-
Линейность данных (data lineage) и трассируемость. Возможно показать путь данных от источника до фактов и KPI, чтобы подтвердить, что расчеты происходят на корректной информации.
-
Роли и ответственность. Включение соответствующих ролей - data steward, data owner, data architect, аналитик - обеспечивает своевременную реакцию на качество данных и ускоряет решение проблем.
-
Культура изменений и миграций. В процессе цифровой трансформации можно столкнуться с изменениями в источниках, схемах и бизнес-правилах. Важно иметь процедуры управления изменениями, регламент версий и тестовые сценарии, чтобы миграции проходили без потерь исторических данных и без нарушения существующих KPI.
-
Роль данных mesh и дополнительных архитектурных концепций. В современных реалиях можно рассмотреть концепции data mesh и data fabric, где ответственность за качество и доступность данных распределена между доменами. Это позволяет учитывать специфику бизнес-подразделений, но требует четких договоренностей, контрактов и технических практик для сохранения консистентности на уровне всей организации.
-
Рекомендации по внедрению:
- начните с четко заданного зерна фактов и конформности размерностей.
- организуйте постоянный цикл проверки качества с автоматическими тестами на каждом этапе пайплайна.
- документируйте изменения в зерне и в метаданных для устойчивости к изменениям в бизнес-процессах.
- внедрите инструментальные средства для отслеживания lineage и контроля исполнения ETL/ELT-конвейеров.
Внедрение: практики и организационные аспекты
Внедрение подхода к гранулярности фактов требует не только технических решений, но и управленческих изменений. В рамках проекта можно рассмотреть следующую структуру:
-
Роли и ответственности. Назначение ответственных за зерно фактов и за конформность измерений, а также за качество данных и lineage.
-
Архитектурные паттерны. Применение звездной схемы как базового паттерна с поддержкой расширяемости через конформные измерения и bridge-таблицы.
-
Управление изменениями. Четкие правила эволюции схемы: как добавлять новые атрибуты, как мигрировать атрибуты размерностей и как управлять версиями агрегаций.
-
Инструментальная среда. Использование инструментов для оркестрации (например, Apache Airflow), управления трансформациями (dbt) и стриминга (Kafka) для поддержки гибкости и скорости реагирования на изменения.
-
Оценка эффективности. Метрики успешности внедрения: время до инсайта, точность KPI, устойчивость к изменениям в бизнес-процессах, доля доступа к данным в режиме близком к реальному времени.
-
Практические сценарии внедрения:
- В производственной компании зерно фактов может быть на уровне операции (production_run_id, line_id, date) с добавлением дополнительных атрибутов для контроля качества. Архитектура рассчитана на интеграцию данных из MES-систем, бухгалтерии и планирования. Аггрегации на уровне дня/партии позволяют анализировать эффективность производства и влияние изменений производственного плана.
- В розничной торговле зерно фактов - «строка заказа» или «заказ» с объемами, выручкой и скидками. Интеграции с CRM и логистикой обеспечивают анализ по цепочке поставки, а конформность измерений и SCD позволяют сохранять историю клиентов и обновления атрибутов продуктов.
- В SaaS-сервисах зерно фактов может включать события пользователи, подписки и использование услуг. В этом сценарии важны стриминговые конвейеры и возможность оперативной агрегации по пользователю и временным периодам.
-
Роль данных-менеджмента в цифровой трансформации. Наконец, грамотная организация работы с данными становится частью стратегической трансформации. Наличие единого подхода к зерну фактов, прозрачных контрактов данных, документации и постоянного актирования изменений позволяет достигать устойчивых результатов, уменьшать риск и ускорять принятие решений.
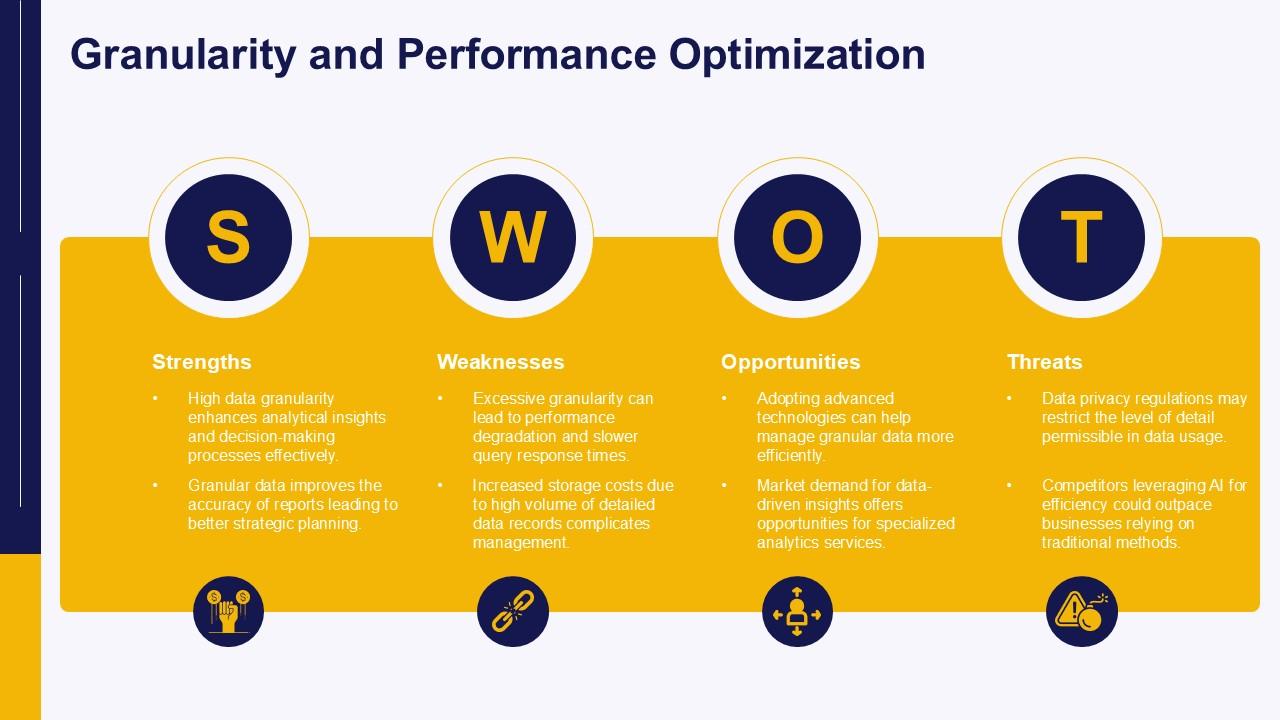
Key takeaways
- Гранулярность фактов - это фундамент формирования аналитических возможностей: правильное зерно обеспечивает точные KPI и гибкость в изменении бизнес-моделей.
- Архитектура данных должна фиксировать зерно на старте проекта, применяя конформные измерения и звездообразную схему, с поддержкой SCD и bridging-таблиц.
- Интеграция источников требует четких контрактов, управления линейностью данных и использования подходов ETL/ELT и CDC для сохранения целостности.
- Алгоритмы агрегации должны сохранять бизнес-смысл и поддерживать как детальность, так и производительность: roll-up, drill-down, MV и управляемые уровни временных сегментов.
- Качество данных - это не разовое действие, а системная практика: глоссарий, lineage, тесты качества и управление изменениями.
- Внедрение требует организационных изменений: роли, процессы, архитектурные паттерны и инструментальные решения должны работать в комплексе для достижения устойчивости аналитики.
- Баланс между детальностью и производительностью достигается через документирование правил, предсказуемость агрегаций и возможность эволюции без потери исторических данных.
FAQ
- Что такое гранулярность фактов и чем она отличается от детализации?
- Гранулярность фактов определяется зерном фактов - набором ключевых атрибутов, который однозначно идентифицирует событие и на котором строятся все агрегации. Детализация - это, фактически, уровень видимости данных: более детальная гранулярность разрешает глубокий анализ по отдельным событиям, менее детальная - обеспечивает быстрые агрегаты. Важно выбрать зерно, подходящее для KPI и сценариев анализа, чтобы не терять контекст при агрегации.
- Как выбирать зерно фактов на старте проекта?
- Основываются на бизнес-целях и сценариях отчётности. Необходимо определить KPI и ключевые бизнес-события, которые будут анализироваться, затем сформировать зерно так, чтобы все целевые агрегаты могли быть вычислены без необходимости переработки основных источников. Важно документировать зерно и привести примеры KPI, которые будут Calculated на основе него.
- Что делать, если бизнес меняется и появляются новые KPI?
- Введите модульную архитектуру, где зерно остается фиксированным, а новые KPI реализуются через дополнительные агрегаты, представления или концепции временных слоёв. При необходимости применяйте SCD и версионирование атрибутов размерностей, чтобы сохранение истории продолжалось корректно.
- Какие архитектурные схемы лучше для обеспечения конформности измерений?
- Звезда (Star) с конформными измерениями. Это позволяет использовать единые размерности во всех фактах и снижает риск несогласованности. В более сложных сценариях применяют снежинку (Snowflake) для экономии пространства и модульности, однако следует помнить о воздействии на сложность запросов.
- Как не перегружать аналитическую систему агрегациями?
- Разделяйте слой фактов и слой агрегатов. Используйте MV/материализованные представления для наиболее востребованных комбинаций, и держите детальные данные под слоем подготовки. Устанавливайте политики обновления агрегатов и мониторьте их актуальность. Документируйте, какие KPI зависят от каких агрегатов.
- Какие инструменты считаются стандартом в индустрии?
- На уровне трансформаций и контроля качества данных часто применяют dbt, оркестрацию процессов - Apache Airflow, стриминг - Apache Kafka. Для хранения и анализа - традиционные реляционные БД в комбинации с современными data lakehouse технологиями. В локальных условиях возможно использование российских решений, но в контексте этой главы мы ориентируемся на общеупотребимые примеры.
- Как обеспечить качество данных на разных этапах пайплайна?
- Внедрите контрактное тестирование данных и автоматические проверки на входе и выходе конвейеров. Соблюдайте lineage и журнал изменений, чтобы отслеживать источник ошибок. Устройте регулярные аудиты качества и голосуйте за единый набор показателей качества.
- Как избежать противоречий между операционными источниками и аналитическими слоями?
- Реализуйте единые бизнес-ключи и единое трактование измерений, избегая дублирования смыслов между системами. CDC-потоки и детальная документация помогают обеспечить синхронность и прозрачность изменений.
- Что означает «модульность» в контексте гранулярности?
- Модульность означает возможность добавлять новые зерна или новые агрегаты без переработки существующих источников. Это достигается строгими контрактами, четким разделением слоев и версионированием моделей данных.
- Как оценивать успех внедрения гранулярности?
- По KPI: время до инсайта, точность KPI, воспроизводимость отчетности и способность адаптироваться к изменениям бизнес-мроц. Также полезно оценивать время обновления агрегатов, устойчивость к сбоям и уровень доверия пользователей к данным.
- Вопросы и ответы выше иллюстрируют, как концепции гранулярности фактов и бизнес-смысл данных интегрируются в практические процессы и вносят вклад в устойчивую аналитику в условиях цифровой трансформации.


