

Исторический обзор: как CDC-инструменты и подходы развивались на практике
Широкую известность CDC получил после фундаментальной статьи Мартина Клеппмана 23 апреля 2015 года "Bottled Water: Real-time integration of PostgreSQL and Kafka" — я крайне рекомендую ознакомиться с ней для расширения кругозора. Клеппман популяризирует подход CDC через декодирование wal-лога PostgreSQL с последующей отправкой событий в Apache Kafka и выкладывает исходный код проекта «Bottled Water». В статье он приводит ссылки на пару уже существующих проектов: Databus от LinkedIn (2012) и Wormhole от Facebook (2013). В то время в описаниях этих проектов ещё не звучало название Change Data Capture, но усилиями Клеппмана понятие завоевало популярность.
Таким образом, работа Клеппмана популяризировала и сам CDC-подход в общем, и реализацию CDC через декодирование wal-лога в частности.
Вскоре после этой статьи на GitHub появилось примерно полтора десятка проектов, реализующих то же самое для MySQL — их даже собрали в единый каталог.
В основном сейчас там все проекты мертвые, но можно выделить:
- Maxwell, который развивается до сих пор,
- Сanal — разработку Alibaba, которая интегрирована с китайскими Apache-инструментами.
Спустя полгода после выхода статьи Мартина Клеппмана появился проект Debezium, подробнее о нём расскажу в следующем блоке.
Несколько реализаций CDC в опенсорсных база-неспецифичных проектах:
- Airbyte. Может поставлять CDC из MySQL/PostgreSQL/MSSQL, обещают добавить поддержку Oracle.
- Nifi. Реализует CDC для MSSQL, интегрируется с Debezium, также позволяет организовать CDC через временны́е метки на строках.
База-специфичные CDC:
- CDC в YDB. Есть нативный механизм создания CDC, но есть и интеграция с Yandex Data Transfer (об этом ниже).
- CDC в Google BigQuery.
- Oracle Golden Gate — CDC для баз данных Oracle.
- Dynamo DB Streams — CDC для DynamoDB.
- CDC для Аpache Ignite.
- Встроенный в MSSQL инструмент.
- CDC в CockroachDB.
- IBM Infosphere CDC.
Также механизм CDC реализован в закрытых инструментах некоторых облачных вендоров.
На просторах GitHub я нашел лишь один проект (и тот малоизвестный), который реализовывал бы CDC не через декодирование wal-лога, а через версии на строках. На современном рынке CDC-решений значительную часть занимает проект Debezium, основанный на декодировании wal-лога. Так что рассмотрим его подробнее.
Debezium — самая популярная реализация CDC
Debezium сегодня является стандартом де-факто в мире CDC. Он появился в 2015 году силами разработчиков из Red Hat и сейчас поддерживает 9 популярных источников: MySQL, MongoDB, PostgreSQL, Oracle, MSSQL, Db2, Cassandra, Vitess, Google Spanner. Изначально инструмент был только Kafka-коннектором, но в 2020-м появился проект Debezium Server, который умеет отправлять события во все популярные очереди.
Проект написан на Java, исходники лежат на GitHub под свободной лицензией Apache 2.0, в основном проекте 447 контрибьюторов.
Debezium поддерживает три формата сериализации событий: json (default), avro и protobuf. Сериализаторы модульны и параметризованы, и можно как настроить любой из существующих сериализаторов, так и написать свой. Поддерживаются интеграции с различными Schema registry. Также поддерживаются трансформации, интеграция с мониторингами, есть UI.
А ещё Debezium выдаёт формат данных, единый для всех БД. Таким образом, научившись обрабатывать дебезиумные потоки из MySQL, вы практически тем же кодом можете обрабатывать дебезиумные потоки и из любых других поддерживаемых Debezium баз данных.
В общем, проект уже достаточно зрелый, чтобы быть надёжным решением, но всё ещё быстро развивается, богат на фичи и интеграции, с обилием материалов и документации. Предоставляются удобные Docker-контейнеры с Debezium, которые позволяют ставить эксперименты за считанные минуты, к тому же есть замечательный официальный репозиторий с демо-примерами.
Как Yandex Data Transfer пришёл к CDC
Yandex Data Transfer появился как сервис миграции баз данных в облако. Когда пользователям необходимо заехать в облачную базу данных (managed database), как правило, у них уже есть база данных на железе (on-premise) и нужно мигрировать эти данные в облако.
Data Transfer решает задачу следующим образом: сначала переносится снапшот базы данных, после чего к базе-приёмнику применяются все изменения, произошедшие на базе-источнике с момента взятия снапшота. В итоге в облаке получается асинхронная реплика базы данных, остаётся только отключить пишущую нагрузку на базу-источник, подождать несколько секунд, пока реплика догонит мастера, и включить нагрузку уже на базу в облаке.
Таким образом можно мигрировать в облако с минимальным даунтаймом.
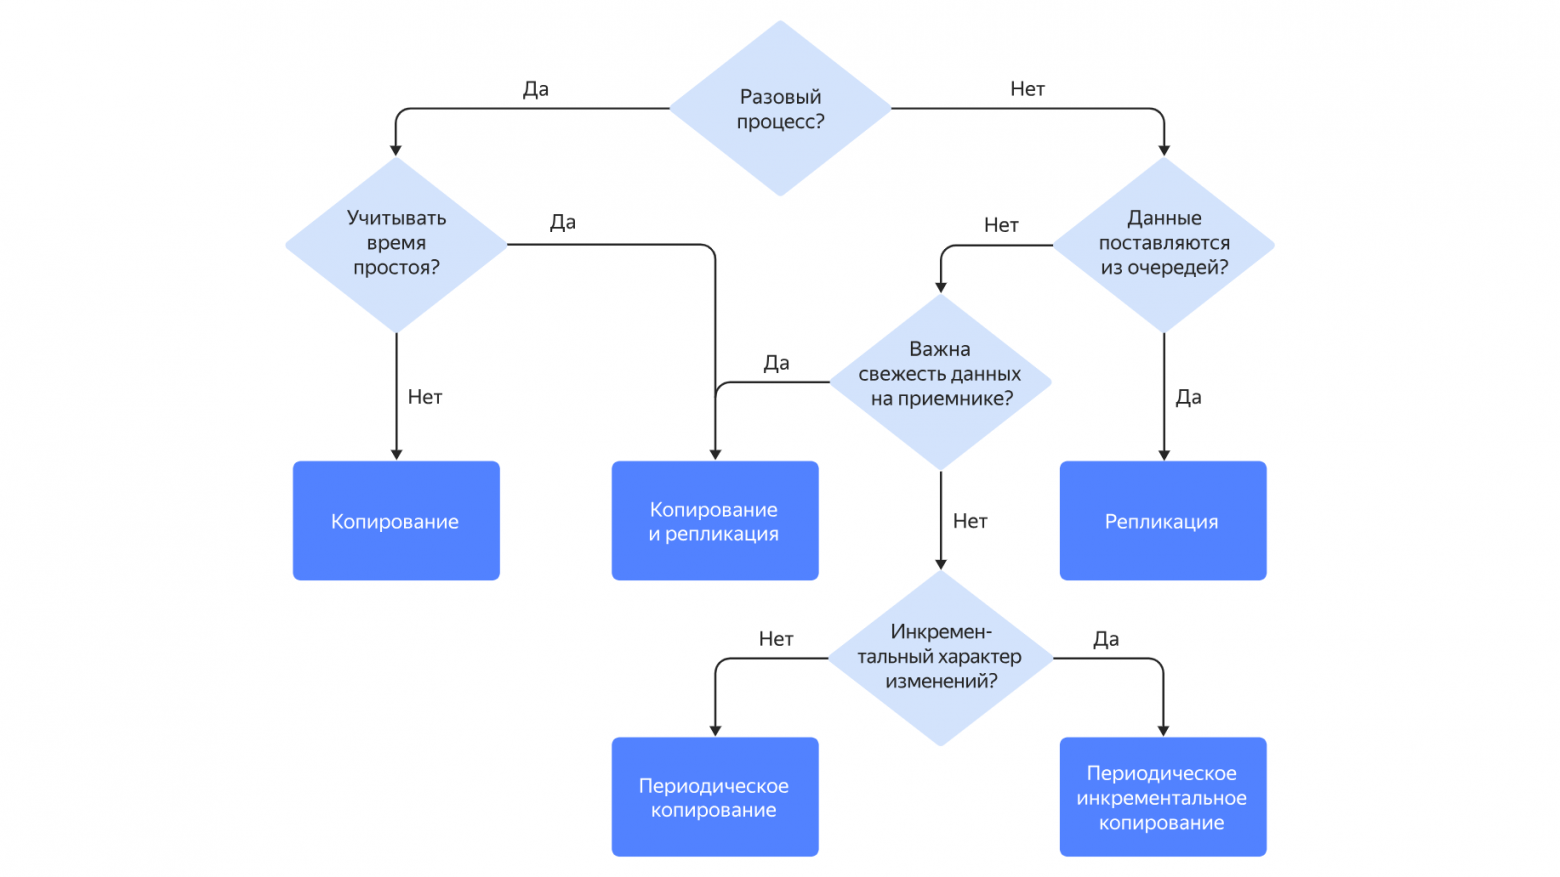
Со временем помимо задачи миграции сервис начал использоваться для переливания данных между разными БД, например, из транзакционной в аналитическую, а также между очередями сообщений и между базами данных и очередями. Если свести все поддерживаемые варианты трансфера в одну матрицу, видно, что Data Transfer сразу умеет работать и со снапшотами, и с репликационными потоками данных, горизонтально масштабируясь и шардируясь.
В терминологии сервиса есть две основных сущности:
- Эндпоинт — это настройки подключения + дополнительные настройки. Эндпоинт может быть либо источником, из которого выгружаются данные, либо приёмником, куда данные загружаются.
- Трансфер, который соединяет эндпоинт-источник с эндпоинтом-приёмником. Содержит собственные настройки, прежде всего тип трансфера: снапшот, репликация, снапшот+репликация.
После того как трансфер создан, его можно активировать разово, или же можно настроить активацию по расписанию. В случае снапшота таблицы переливаются, и затем трансфер деактивируется сам. В случае репликации запускается бесконечный процесс переноса новых данных из источника в приёмник.
Data Transfer написан на Go, работает как решение cloud-native — есть контрол-плейн, отвечающий за API и управление дата-плейнами, а на активацию пользовательских трансферов создаются дата-плейны в рантаймах. Например, среди поддержанных рантаймов есть Kubernetes (k8s) — т.е. на этом рантайме на активацию трансфера в k8s запускаются поды. Таким образом, это самостоятельный сервис, работающий поверх некоторого рантайма: помимо Kubernetes поддерживаются Yandex Cloud Instance Groups, YT и локальный рантайм. Data Transfer на активации трансфера создаст в рантайме виртуалки в нужном количестве и начнёт переливку данных. В несколько кликов можно настроить поставку данных на гигабайты в секунду.
Сервис уже несколько лет успешно эксплуатируется внутри Яндекса в боевых продакшнах с солидными объёмами данных. Вдобавок к тому, что сервис изначально горизонтально масштабируемый, мы научились параллелиться везде, где это возможно, и сейчас во внутренней инфраструктуре бежит почти две тысячи потоков данных, перенося гигабайты в секунду.
Помимо этого мы реализовали наиболее часто запрашиваемые ETL-преобразования, и возможности ETL в дальнейшем будут только расширяться. Настраивать можно как через удобный UI, так и через API и Terraform.
Всё это привело к тому, что Data Transfer стал универсальным сервисом переноса данных из любого источника в любой приёмник (с возможностями ETL-процессинга): как снапшотов, так и потоков данных — и пользователи помимо применения сервиса по прямому назначению придумали массу неочевидных способов использования. CDC является лишь одним способом применения сервиса Data Transfer из множества.
Как реализован CDC в Yandex Data Transfer
Поскольку Yandex Data Transfer с момента создания получал репликационный поток на уровне логической репликации, естественным шагом было научиться отдавать это пользователям. Именно это превращало Data Transfer в CDC-решение, работающее через обработку wal-лога.
Реализовывать отгрузку событий логической репликации в очередь мы начали по пользовательским запросам, и было принято решение порождать события в формате Debezium, чтобы мы могли стать drop-in replacement для Debezium. Так можно было бы в настроенном пайплайне подменить один CDC-продукт другим, и пайплайн остался бы рабочим. Таким образом и мы бы получили полезные интеграции, и в мире не появилось бы нового формата данных.
Соответственно нужно было сделать конвертеры из наших внутренних объектов в сериализованный Debezium-формат и покрыть это миллионом тестов, что мы и сделали.
На данный момент в Data Transfer сериализатор реализован для PostgreSQL и MySQL-источников, а недавно появилась поддержка YDB-источника. Теперь вы можете в несколько кликов настроить поставку CDC из ваших таблиц YDB в Apache Kafka и в YDS в формате Debezium.
Вскоре после поддержки YDB появилась и поддержка Schema Registry, что на порядок уменьшает объёмы передаваемых данных и даёт дополнительные плюшки. В планах получить ещё больше интеграций с различными опенсорс-сервисами.
Таким образом, для MySQL и PostgreSQL получился drop-in replacement для Debezium. Из крупных отличий: Data Transfer умеет переживать переезд мастера PostgreSQL (ситуация, когда реплика становится мастером) при включенном плагине pg_tm_aux, а также сервис умеет переносить user-defined types в PostgreSQL.
Также в Data Transfer реализовали возможность организовывать query-based CDC — в документации это называется «инкрементальные таблицы», а на внутреннем сленге мы этот режим исторически называем «доливочки».
Недавно у нас вышел вебинар по использованию Data Transfer в нетривиальных кейсах.
Реальные кейсы использования CDC через Data Transfer
Расскажу про популярные пользовательские кейсы.
-
Самый распространённый вариант — использование CDC для создания реплик транзакционных баз (PostgreSQL, MySQL, YDB) в аналитических хранилищах (ClickHouse, YTsaurus). Сохранение событий в очередь выгружает данные из транзакционной БД один раз, а аналитических баз-приёмников как правило по две — по одной в каждом дата-центре, чтобы гарантировать DC-1.
Проблема
Продакшн-процессы бегут в транзакционных базах данных, а бизнесу интересно получать аналитические отчёты, которые удобно делать через аналитические БД. Поскольку HTAP-базы — ещё экзотика, нужно каким-то образом перекладывать данные из транзакционной базы в аналитическую.
Было
Обычно все команды переливают данные из транзакционной базы в аналитическую через собственные ad-hoc скрипты или in-house решения снапшотами, в лучшем случае query-based CDC. Как правило, это не оформлено в продукт и неудобно для использования.
Стало
CDC позволяет удобным образом, например, через UI, организовать реплику транзакционной базы в аналитическую с отставанием реплики в районе единиц секунд.
-
Наши коллеги из Яндекс Маркета организовали схему, похожую на описанную, но с любопытными отличиями.
Проблема
Нужно было выгружать продакшн-данные из PostgreSQL в YTsaurus для аналитики, желательно с минимальным отставанием.
Было
Когда-то давно использовался самописный сервис на java, который раз в сутки выгружал снапшот.
Потом был написан ещё ряд скриптов для выгрузки, а после этого использовался ещё один внутренний сервис, который уже умел производить query-based CDC. Но заводить новую поставку данных было сложно.
Стало
Ребята организовали поставку инкрементальных таблиц в кросс-датацентровую очередь с регулярным запуском — это один трансфер, а два других трансфера с типом «репликация» — из очереди в YTsaurus. Два трансфера нужны для обеспечения гарантии DC-1 — каждый из этих двух трансферов поставляет данные в инсталляцию YTsaurus в отдельном дата-центре.
Сама очередь тут даёт дополнительный эффект: в транзакционную базу осуществляется один поход, а данные оказываются в двух аналитических базах.
В итоге у команды Маркета три трансфера: один сам запускается по расписанию и выгружает новые строчки, два бегут постоянно в режиме репликации, выгружая данные из очереди в аналитические хранилища.
-
Коллеги из Яндекс Недвижимости начали использовать CDC, чтобы обновлять поисковые индексы Elasticsearch, потом применили CDC для реактивного взаимодействия компонентов, и в конце концов — CDC стал неотъемлемой частью проекта.
Проблема
При изменении данных в MySQL нужно было обновлять индексы Elasticsearch.
Было
До CDC пришлось бы реализовывать transactional outbox pattern. Но поскольку с появлением задачи в Yandex Data Transfer уже был CDC — сначала реализовали отгрузку событий в очередь и сделали скрипт, обрабатывающий события из очереди.
Стало
Yandex Data Transfer позволил организовать процесс обновления поисковых индексов, после чего коллеги, оценив удобство организации реактивной инфраструктуры, нашли множество применений CDC. Теперь они с помощью CDC: отправляют пуши и нотификации, проксируют данные во внешнюю CRM, планируют задачи, реактивно реагируют на промокоды, и ещё много чего.
-
Коллеги из Яндекс Метрики превратили MySQL/PostgreSQL при помощи CDC-событий в потоковую базу данных, работающую поверх YTsaurus. Созданный инструмент назвали «инкрементальные материализованные представления».
Проблема
В метрике есть MySQL с настройками, в который множество сервисов ходит забирать эти настройки.
Было
Запускать все сервисы в MySQL — не вариант, поскольку это создавало серьезную нагрузку.
Сначала были организованы кеши — кеширующие сервисы периодически ходили за настройками в MySQL, и все остальные сервисы ходили в кеширующие сервисы.
Но со временем кеширующие сервисы стали потреблять много ресурсов и начали заметно отставать до пары десятков минут. А сервисы, ходящие за настройками, начали рестартоваться слишком долго, поскольку долго инициализировали свои кеши.
Стало
Была разработана потоковая база данных, потоковый аналог связки airflow+dbt, где DAG'и пересчитывают производные данные только для изменившихся строчек, реактивно реагируя на CDC-события.
В итоге кеши стали отставать в среднем на 5 секунд вместо десятков минут до этого. Сервисам удалось избавиться от локальных кешей, что сэкономило много RAM, и сервисы стали рестартиться быстро. Надеюсь, когда-нибудь коллеги расскажут об этом решении подробнее.
Подведём итоги
В статье мы рассмотрели Change Data Capture со всех сторон: история возникновения, теория, сценарии применения, опенсорс-практика, корпоративная практика и реальные пользовательские истории.
Отмечу, что Yandex Data Transfer — бесплатный сервис в Yandex Cloud.
Приходите пользоваться, оставляйте фидбек и фичареквесты.
Что ещё почитать по рассмотренным темам
-
CDC и Redis
Несколько докладов:
Пара примечательных статей:
-
Паттерны проектирования микросервисов
-
Обзорная статья для более глубокого понимания всех тонкостей отличия похожих паттернов друг от друга:
Distributed Data for Microservices — Event Sourcing vs. Change Data Capture
-
Полезное чтиво про outbox pattern и CDC:
Reliable Microservices Data Exchange With the Outbox Pattern
-
Полезное чтиво про CQRS:
DDD Aggregates via CDC-CQRS Pipeline using Kafka & Debezium
Building CQRS views with Debezium Kafka Materialize and Apache Pinot: part 1
Building CQRS views with Debezium Kafka Materialize and Apache Pinot: part 2
-
Полезное чтиво про Strangler:
Application modernization patterns with Apache Kafka, Debezium, and Kubernetes
- Хорошая статья про способы реализации в PostgreSQL:
- О реализации в блоге Debezium:
- О реализации в теоретической работе от Netflix:
-
Про метод «инкрементальных снапшотов» — очень нетривиальную и изящную технологию, позволяющую совместить перенос снапшота с репликацией и заодно не думать о росте wal.


