

Cloud agnostic или как правильно построить облачную платформу данных
Рассматриваете необходимость перехода к облачной среде? Если это так, то, скорее всего, основной сложностью станет выбор нужного Вам провайдера.
Важно понимать то, что, начав строительство облачной платформы с помощью инструментов, поставляемых определенной компанией, в будущем, возможно, будет сложно поменять провайдера. К счастью, существует проверенное решение в области построения облачной платформы, о которой мы поговорим в этой статье.
Что такое Cloud Agnostic?
Для того, чтобы выполнить «облачную» работу эффективно, важно выбрать подход PaaS (Платформа как Услуга). С его помощью Вы сможете значительно сократить расходы на поддержку и мониторинг Вашей платформы за счет использования облачных SQL баз данных, предоставляемых провайдером. Кроме того, Вы можете использовать микросервисы и контейнеризацию для оптимизации приложений. Используя движки баз данных, инструменты ETL и BI от облачных провайдеров, Вы сможете легко разрабатывать конвейеры данных, модели данных и озера данных.
Да, простой перенос виртуальных машин (ВМ) к определенному облачному провайдеру может обеспечить ряд преимуществ, но имейте в виду, что он также может и ограничить потенциал облака. Именно в этом случае на помощь приходит такое так называемое cloud-agnostic приложение.
Ориентированные на облако приложения часто создаются в формате cloud agnostic. Это означает, что приложение не тесно связано с конкретным поставщиком облака и может быть развернуто в любом общедоступном облаке. Такие приложения рассчитаны на работу с различными облачными платформами, не требуют разработки собственного кода и дорогостоящих модификаций, что позволяет организациям развертывать свои приложения и сервисы в любой среде.
Обработка данных
Для того, чтобы использовать всю мощь данных на благо Вашей организации, Вам необходимо как следует разбираться в том, как обрабатывать, хранить и использовать имеющиеся у Вас данные. Разобьем этот процесс на более мелкие шаги:
- Ввод данных (data ingestion) с помощью пакетных заданий или потоков. Этот процесс включает в себя извлечение данных из внутренних и внешних источников. Данные могут быть представлены в двух формах: пакетной и потоковой;
- Хранение данных в озере данных или хранилище данных. Необработанные данные хранятся в так называемом "бронзовом" слое озер данных, затем очищаются, дедуплицируются и преобразуются в общий формат данных;
- Вычисление аналитических функций и/или функций машинного обучения. Вычисления могут представлять собой комбинацию пакетной и потоковой обработки. Данные агрегируются и подготавливаются для аналитиков, специалистов по анализу данных и машинному обучению;
- Визуализация данных в дашбордах, наука о данных и машинное обучение. Данные визуализируются в виде дашбордов, отчетов и «потребляются» искусственным интеллектом/ML.
С помощью облачных решений эти задачи, необходимые для создания платформ данных, могут быть выполнены без каких-либо особых усилий.
Построение облачной платформы данных: Аргументы За и Против
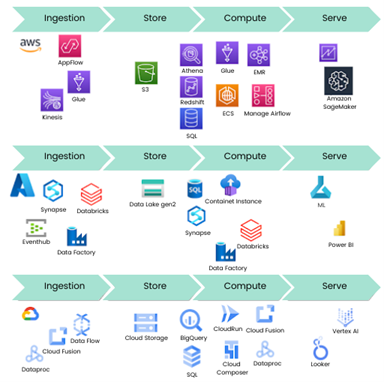
Благодаря бессерверной архитектуре мы можем быстро создать облачную платформу данных, используя нативные ресурсы облака.
На рисунке ниже показано сравнение облачных платформ данных для AWS, Azure и GCP. Используя эти компоненты, мы можем мигрировать из локальной среды в облако или от одного провайдера к другому. Такая гибкость позволяет нам выбрать платформу, подходящую для каждого конкретного случая, внедрить ее и обеспечить бизнес-ценность для наших клиентов/заинтересованных сторон, а также расширенные возможности аналитики.
Подход, описанный выше, звучит здорово, НО есть ли какие-либо минусы у представленной схемы? Есть и я готов с Вами ими поделиться, чтобы сформировать у Вас полную картину:
- Привязка к поставщику (vendor lock-in);
- В некоторых случаях разработчики могут быть знакомы только с одним поставщиком технологий;
- Издержки перехода к другому провайдеру могут быть непомерно высокими.
Эти недостатки не обязательно означают, что облачно-нативный подход не для Вас. Преимущества, которые может предложить конкретный провайдер, таковы:
- Простая интеграция облачных ресурсов;
- Доступ к широкой базе знаний разработчиков;
- Оптимизированное внедрение новых высокотехнологичных функций, разработанных облачным провайдером.
И все-таки, несмотря на это Вы хотите быть cloud agnostic, ОК, не проблема.
Как построить Cloud Agnostic платформу данных?
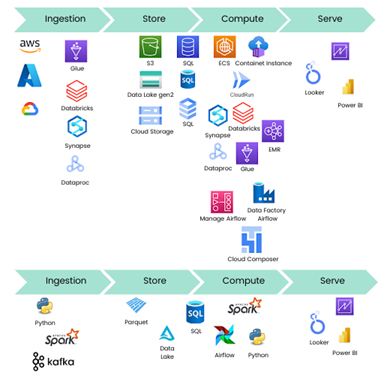
Для того, чтобы сделать облачную платформу данных cloud agnostic, необходимо определенное сочетание ПО, инструментов и языков программирования, которые доступны на других облачных платформах. Существует четыре основных универсальных языка: SQL, Python, Scala и Java. Наиболее популярной платформой для многопараллельной обработки данных является Apache Spark. Распространенным способом хранения и обработки данных являются реляционные базы данных, такие как MySQL, PostgreSQL, SQL Server и Oracle. Важно также отметить, что мы можем хранить данные в таких популярных форматах файлов, как Parquet, Avro, CSV и Delta.
Зная все это, мы можем ориентироваться на облачные ресурсы, построенные на этих технологиях. Альтернативным вариантом является использование ресурсов, доступных на всех трех облачных платформах, например Databricks и Snowflake. Databricks и Snowflake можно использовать на AWS, Azure и GCP, причем разница в стоимости, функциональных возможностях и расположении центров обработки данных, где они доступны, незначительна.
SQL
Мы можем хранить наши данные в облаке, используя популярные SQL движки. С помощью SQL или DBT мы можем создавать ETL процессы и сделать их портативными. Для построения традиционного хранилища данных можно использовать такие бессерверные сервисы, как AWS RDS, AWS Aurora, Azure Database и Cloud SQL. Среди предлагаемых cloud-agnostic баз данных можно выделить следующие:
- PostgreSQL
- MySQL
- SQL Server
- Oracle
- Snowflake
Решение, построенное на основе базы данных SQL, позволяет организации осуществлять резервное копирование и восстановление баз данных на одной и той же платформе.
ETL/ELT обработка данных
Apache Spark - это платформа, использующая вычислительный кластер для обработки данных. Она позволяет обрабатывать данные в пакетном и потоковом режимах. AWS, Azure и GCP имеют свои собственные реализации этого движка, такие как AWS Glue, AWS EMR, Azure Databricks, Azure Synapse Spark Pool и GCP Dataproc. Эти реализации позволяют использоватьPySpark для кластерной или бессерверной обработки данных. Есть небольшие различия в реализации, но мы можем использовать стандартный Spark, чтобы иметь возможность перенести его в будущем. Более того, Databricks доступен на всех трех платформах. Альтернативой является использование собственного кластера, но это может увеличить затраты на инфраструктуру.
Используя Python и другие языки программирования, мы можем создавать пользовательские сервисы для работы с данными, например, с помощью Pandas. Мы можем докеризировать наши микросервисы. Затем мы можем разместить их в ECS, Container instance или Cloud Run. Такой подход дает нам возможность без особых усилий переносить наши сервисы и инфраструктуру к другим провайдерам. Кроме того, поскольку мы используем код, а не инструменты для перетаскивания, мы можем создавать модульные тесты, сквозные тесты, вести разработку, управляемую тестами (TDD). При использовании инструментов drag and drop мы разрабатываем с помощью графического интерфейса, а инструменты ETL под капотом генерируют JSON или XML.
В облачных средах мы также можем использовать инструменты ETL/ELT, позволяющие строить процессы с помощью графических интерфейсов с перетаскиванием компонентов для манипулирования данными и их оркестровки. Некоторые из них имеют открытый исходный код, но есть и программы, которые не являются бесплатными. Эти инструменты не зависят от облака, поэтому могут работать с различными облачными провайдерами:
- Apache NiFi
- Informatica Cloud Services
- Cloud Data Fusion
- Talend
Хранение данных
Хранение данных - это, пожалуй, самая простая область для миграции. Файлы можно хранить в самых популярных форматах и легко переносить в другие типы хранилищ (S3, ADSL, Cloud Storage, HDFS и т.д.). Если же мы используем, например, Databricks, то нам придется корректировать местоположение файлов. Эта миграция может быть более простой, если мы монтируем наше хранилище на кластере. Озеро данных - это очень гибкий и мощный способ хранения огромных объемов данных, не зависящий от облака. Во многих случаях мы можем читать файлы Parquet с помощью Databricks, BigQuery, Synapse или Redshift. Это позволяет использовать виртуализацию данных. Средства миграции файлов доступны через облачных провайдеров, например Transfer Service компании GCP.
Оркестрация данных
Оркестрация данных - еще один важный шаг в развитии облачной платформы данных. Реализовать его можно с помощью Airflow, который представляет собой оркестратор, построенный на языке Python. Airflow не зависит от облака и доступен в AWS, Azure и GCP в виде AWS Managed Airflow, Data Factory Airflow runtime и Cloud Composer. Airflow может быть установлен на ВМ или в Docker. Рабочие процессы и группы DAG в Airflow определены в коде Python, поэтому мы можем легко перенести их в другое место.
В качестве альтернативы мы можем внедрить в нашей организации Prefect или Dagster. Например, Prefect предлагает интересный способ реализации, когда все управление предлагается как PaaS, а для реализации ядра нам необходимо установить агентов или свою собственную инфраструктуру.
Управление данными
Управление и руководство данными (data governance) – это процессы и политики, необходимые для обеспечения доступности, интеграции и безопасности данных какой-либо организации. Они обеспечивают основу для управления активами данных и помогают поддерживать качество данных. Основное внимание уделяется управлению данными и метаданными, безопасности данных, управлению основными данными, управлению жизненным циклом информации, архивированию данных и управлению неструктурированными данными. Мы можем использовать AWS Data Catalog, Azure Purview и GCP Data Catalog от ведущих облачных провайдеров. Мы также можем использовать Apache Atlas в качестве платформы с открытым исходным кодом для управления и контроля данных, не зависящей от облака.
В случае DevOps мы можем использовать сервисы, предоставляемые AWS, Azure и GCP, такие как AWS CodeBuild, AWS CodeDeploy, Azure DevOps и GCP Cloud Build. Все эти сервисы интегрируют или предлагают GIT в качестве репозитория. Процессы CI/CD мы можем строить на базе Jenkins или использовать облачные нативные сервисы. Для управления и построения инфраструктуры можно использовать Terraform, который поддерживает все перечисленные платформы, но есть различия в реализации кода для разных провайдеров. Тем не менее, в случае миграции мы имеем возможность работать с одним и тем же инструментом.
Визуализация данных
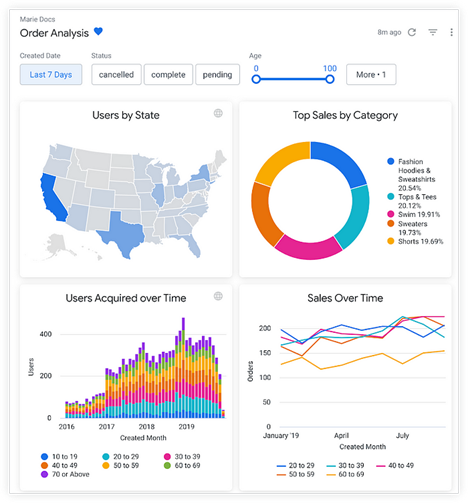
Большинство инструментов, предлагаемых ведущими облачными провайдерами, способны подключаться к наиболее популярным источникам данных. В этом случае мы можем использовать Power BI с Redshift и Data Studio с другими источниками. Существуют также средства визуализации, предлагаемые другими провайдерами: Tableau, Qlik, IBM Cognos или с открытым исходным кодом. В случае с визуализацией мы имеем огромные различия в функциональности, ценах и лицензировании. Облачные провайдеры предлагают эти инструменты в качестве сервиса, но их можно установить и на локальную машину.
Заключение
По мере того, как заказчики начинают рассматривать облако в качестве места для своей будущей платформы данных, ведущие облачные провайдеры предлагают программу адаптации, бесплатные пробные учетные записи и поддержку миграции.
В начале пути Вам должен помочь четко сформулированный проект минимального жизнеспособного продукта (MVP). Я могу помочь Вам создать облачную платформу данных, наш MVP будет представлять ценность для бизнеса, решая пользовательские задачи и обеспечивая необходимые результаты. По мере развития платформы мы сможем приступить к развертыванию передовых аналитических рабочих нагрузок ML и AI для автоматизации процессов и начала прогнозирования и предсказания.
Многие поставщики облачных услуг предлагают совместимые сервисы и инструменты, которые создают основу для облачных платформ данных. Становление организации, управляемой данными, в облаке - это шаг, который требует участия различных заинтересованных сторон и инвестиций. Надеемся, что после того, как Вы прочтете эту статью, Вам будет легче понять, как создать облачную платформу данных.


