

Сравнение 4 баз данных: Greenplum, Teradata, Presto и Clickhouse
|
ОПИСАНИЕ БАЗЫ ДАННЫХ |
|
|---|---|
|
Greenplum |
Open source движок анализа данных. За счет MPP архитектуры сложный анализ SQL для больших наборов данных может быть выполнен гораздо быстрее (по сравнению с другими существующими решениями). Широкий выбор приложений |
|
Teradata |
Большая система хранения данных, включающая в себя высокоэффективные дорогостоящие продукты. Используется в системах безопасности. |
|
Presto |
Распределенный движок SQL запросов, специализирующийся на быстром аналие данных в режиме реального времени. Сам по себе он не хранит данные, но может подключаться к многочисленным источникам данных. Отличный вариант для сложного анализа большого количества данных. |
|
Clickhouse |
Используется для online анализа данных. Функция поддержки очень проста. Работает быстро. Used for statistical analysis of behaviИспользуется для статистического анализа поведения. |
Greenplum
Архитектура Greenplum

Использование архитектуры MMP
- Мастер хост: отвечает за соединение с клиентом, не содержит пользовательских данных, использует ядро базы данных postgres, сохраняет метаданные и взаимодействует с сегментом по локальной сети;
- Сегмент: хранит данные, мониторит подключение мастера, независимая БД PostgreSQL;
- Интерконнект: отвечает за процесс координации, поддерживает TCP или UDP
Разница между Hadoop и MPP
|
Hadoop |
MPP |
|---|---|
|
Неструктурированные или полуструктурированные данные |
Реляционные данные |
|
Массовые запросы к хранилищу данных, пакетный ETL данных, анализ журналов, текстовый анализ |
Самостоятельный анализ многомерных данных, data mart |
Две архитектуры могут быть смешаны (MPPDB + Hadoop): используйте MPP для обработки PB-уровня, высококачественных структурированных данных, при этом обеспечивая богатую поддержку SQL и транзакций для приложений; используйте Hadoop для работы с полуструктурированными и неструктурированными данными. Это позволит удовлетворить потребности в эффективной обработке структурированных, полуструктурированных и неструктурированных данных.
Высокая доступность Greenplum
Резервирование мастера:
- Настройте узел Standby для копирования журналов таблиц системных каталогов (таблиц каталогов) ведущего узла;
- При выходе из строя мастера администратору необходимо активировать резервное устройство, чтобы оно стало новым мастером;
- Для синхронизации основного и резервного мастер-серверов используйте потоковую репликацию на основе журнала с опережающим чтением (WAL).
Резервирование сегментов:
- Главный сегмент получает от мастера запрос на изменение базы данных главного сегмента, а затем копирует эти изменения в соответствующий зеркальный сегмент;
-
Вы можете выбрать зеркалирование хоста (групповое зеркалирование) или раздельное зеркалирование (разнесенное зеркалирование) на сегмент..
- Групповое зеркалирование: при выходе из строя одной машины на другую ложится двойная нагрузка
- Разнесенное зеркалирование: балансировка нагрузки
- При выходе из строя сегментного экземпляра или хоста мастер фиксирует состояние его отказа и активизирует соответствующий ему сегментный экземпляр;
- Зеркальный сегмент использует схему репликации физических файлов, причем для heap таблиц сначала синхронизируется журнал. Когда блок основного сегмента должен быть записан на диск, синхронизируется зеркальный файл. При отказе основного сегмента зеркало автоматически становится основным, а статус -Change Tracking. При отказе зеркала первичное устройство изменит состояние на Change Tracking;
- Таблица AO (Append-optimized) не использует механизм кэширования памяти. Изменения, внесенные в блоки таблицы AO, будут немедленно скопированы в зеркальный сегмент.
Параллельные запросы Greenplum
- Данные таблицы распределяются по различным узлам сегмента в соответствии с хэш-картой. Каждая операция генерирует фрагмент, и эти фрагменты распространяются посредством сбора, трансляции и перераспределения.
|
сбор |
распределение |
перераспределение |
|---|---|---|
|
Данные каждого узла отправляются на главный узел |
Данные таблицы распределяются по каждому узлу, таким образом, каждый узел имеет полные данные таблицы, подходящие для небольших таблиц |
При объединении и группировке по, когда стоимость трансляции высока, можно нажать кнопку для повторного рассредоточения данных каждого узла по каждому узлу и затем оперировать с каждым узлом, что подходит для больших таблиц. |
- Greenplum поддерживает три способа хранения: хранение строк, хранение столбцов и внешняя таблица
|
Строковое хранение |
Колоночное хранение |
Внешние табличные данные |
|---|---|---|
|
Быстрое обновление нескольких колонок |
Одновременный доступ к небольшому количеству полей, высокий коэффициент сжатия |
В базе данных сохраняется только информация о метаданных |
- Данные могут быть разбиты на хэши или диапазоны
Многоверсионный контроль Greenplum (MVCC)
Транзакционные базы данных используют механизм блокировки для контроля одновременного доступа, а greenplum использует многоверсионный контроль для обеспечения согласованности данных. Самым большим преимуществом является отсутствие конфликта между чтением и записью, чтение моментального снимка
Teradata
Архитектура Teradata
Каждый узел физически представляет собой SMP-вычислительный блок (многопроцессорный компьютер), аппаратное обеспечение узла включает процессор, память, диск, сетевую карту, порт BYNET
Сетевая карта: Channel Adapter, подключенный к IBM MainFrame; сетевая карта LAN. На узле будет использоваться только одна сетевая карта, но для различных подключений и резервирования может быть несколько сетевых карт.
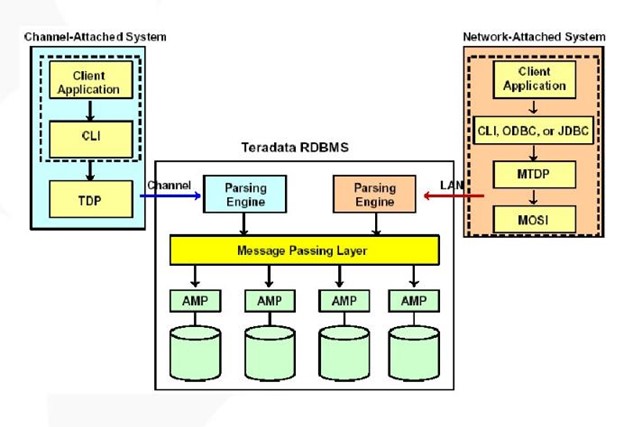
Уровень соединения
CLI(call level interface): Ответ на запрос, создание сессии, распределение буфера, упаковка информации;
TDP(teradata director program: Выполнение на клиентской системе: завершение инициализации сеанса, вход в систему, верификация, перезапуск восстановления и передача существующего персонала в очередь сеансов PE
MTDP( micro TDP : Отличие от TDP заключается в том, что он не отвечает за распределение сеансов между PE.
MOSI( micro operating system interface : Реализация изолирующего слоя, работающего на различных платформах баз данных
PE layer (parsing engine):
- Контроль сессии: Вход в систему управления, выход из системы
- ** парсер: ** разбор SQL, определение правильности грамматики и семантики, запрос словаря для подтверждения существования запрашиваемого объекта и наличия разрешения у пользователя;
- ** оптимизатор: ** Оценить план выполнения и преобразовать его в исполняемые шаги AMP
- ** диспетчер: ** распределить выбранную задачу AMP и вернуть результат пользователю
Уровень MPL (message passing layer):
Уровень MPL отвечает за передачу информации между PE и AMP, синтезируя возвращаемый набор результатов для передачи ПЭ, который состоит из программно-аппаратных средств PDE и Bynet
PDE (parallel database extension):
- Слой, построенный непосредственно на базе ОС, обеспечивает параллельную среду, выполняет работу виртуальных процессоров и планирование параллельных задач, ядра операционной системы и базы данных.
Программное и аппаратное обеспечение bynet:
- Используется для двунаправленной широковещательной, многоадресной и "точка-точка" связи между узлами;
- Реализует функцию объединения в процессе выполнения SQL-запросов (каждый узел или AMP, равномерно распределяет часть данных в таблице, при выполнении запроса каждый узел выполняет запрос параллельно, а результаты агрегируются на определенном узле и передаются обратно запросчику для повышения скорости выполнения запроса;
- Как правило, в типичной Teradata одновременно работают 2 BYNET. BYNET автоматически балансируется, чтобы избежать слишком большой нагрузки на одну из них;
- PE может поддерживать обработку 120 сессий, каждая сессия может управлять 16 запросами и соответствующими результатами, но в каждый момент времени выполняется только один запрос.
AMP уровень
AMP(access module process)
- Ядро архитектуры ShareNothing;
- AMP контролирует до 64 физических дисков (для коммерческого OLTP распределение записей на диске в основном контролируется DBA);
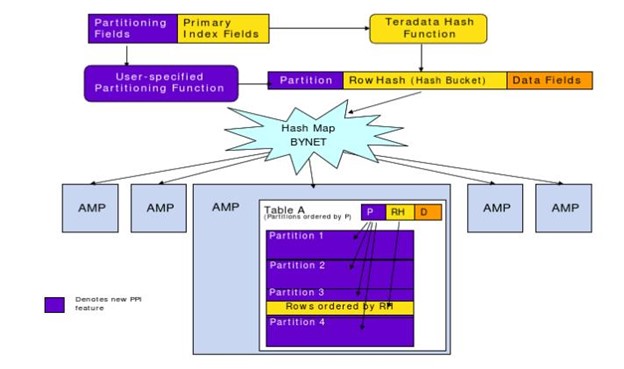
- Алгоритм хэширования аналогичен матричному отображению, только при изменении номера AMP необходимо изменить хэшмап, скорость работы очень высока;
- Каждый AMP может параллельно обрабатывать до 80 задач
Функция AMP:
- Операции сортировки, агрегирования, форматирования, преобразования
- Может передавать данные другим AMP
- Блокировать базу данных или таблицу
- Возврат результатов диспетчеру
- Контроль использования пространства и его распределение
- Преобразование выходных данных в кодировку, противоположную PE
VDisk уровень
Хранящиеся данные равномерно распределяются по разным дискам дискового массива в соответствии с хэш-алгоритмом. Основными из них являются RAID0 и RAID5. Благодаря использованию смешанного и равномерного хранения проблемы реорганизации базы данных не возникает.
Возможности параллельной обработки данных Teradata
Распараллеливание запросов: Каждый AMP, как виртуальный процесс, самостоятельно обрабатывает часть данных (например, запрос к таблице);
Внутришаговый параллелизм: Каждый шаг операции обрабатывается параллельно несколькими процессами;
Многошаговый параллелизм: Принцип, по которому оптимизатор декомпозирует sql-запрос, заключается в том, чтобы сделать каждый шаг максимально независимым (например, запрос к двум таблицам выполняется одновременно);
Традиционный OLTP DBA будет создавать новый индекс для новых задач, что может привести к тому, что база данных будет занимать слишком много дискового пространства. Teradata использует метод временного хранения результатов выполнения одних и тех же шагов в системном буфере для уменьшения размера самой базы данных.
Параллельные OLAP-операции, предоставляемые Teradata: сортировка, накопление, скользящее среднее, скользящая сумма, скользящие нутромеры, выборка, квантиль, предел
Оптимизации, выполняемые Teradata
Разногласия между доступом к большими и маленьким объемам данных
Параллельные OLAP-операции, предоставляемые Teradata: сортировка, накопление, скользящее среднее, скользящая сумма, выборка, квантиль, предел
Управление правами доступа
Определяет роли для назначения прав доступа;
Вводит пользовательские параметры для настройки постоянного пространства (максимальный объем выделенной памяти), пространства спула (хранение промежуточных процессов и конечных результатов), временного пространства (хранение данных, инстанцированных глобальной временной таблицей), настроек базы данных по умолчанию и установки паролей пользователей
Индекс
Группрование AMP: использование только части блока усилителя для обработки операций с целью повышения пропускной способности данных
Использование разреженных индексов для удаления большого количества нулевых индексов
Ускоренная обработка данных
- Парсер и диспетчер объединены
- Расширение возможностей обновления вставки
- Введено обновление слиянием
Индекс
- Для уникальных ключевых кортежей, распределенных на каждом диске;
- Для неуникальных ключей кортежи распределяются по ключам;
- Вторичный индекс, как правило, не нужен, а сама taradata имеют высокую производительность
Механизм блокировки
- Исключительная блокировка (создание таблицы): отказ от произвольной блокировки
- Блокировка записи (обновление): отказ от чтения, записи, эксклюзивная блокировка
- Блокировка чтения (select): отказ от записи, эксклюзивная блокировка
- Блокировка доступа: отказ только от эксклюзивной блокировки (используется для накопления большого количества данных о строках, но результат может быть не самым последним)
Presto
Presto - это инструмент анализа данных, разработанный компанией Facebook с целью усовершенствования предыдущего фреймворка map-reduce hive для слишком долгого запроса к хранилищу данных. Сам по себе Presto не является базой данных, это распределенный механизм запросов. Presto может обращаться к HDFS и другим источникам данных, базам данных. Однако он не может обрабатывать онлайн-транзакции.
Presto разрабатывался как продукт для работы с хранилищами данных и анализа данных: агрегации крупномасштабных данных, формирования отчетов и т.д. Эти задания часто рассматриваются как операции аналитической обработки в режиме онлайн.
Архитектура Presto:
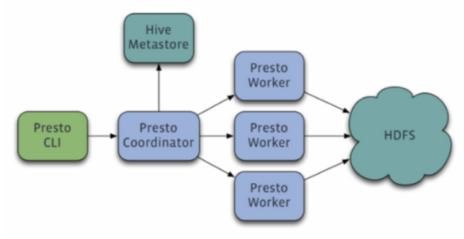
Модель master-slave:
- ** координатор: ** мастер, отвечающий за управление метаданными, управление рабочими, анализ и планирование запросов
- Рабочий (worker): Вычисления и чтение
- сервер обнаружения (discovery server): Обычно он встраивается в узел-координатор, но может быть развернут и отдельно.
Модель данных Presto
- каталог: тип источника данных, например mysql, hive
- схема: БД
- таблица: таблица
Блок хранения данных включает в себя страницу, блок:
страница: многорядный сбор данных, включающий несколько столбцов, но предоставляющий только логические строки, фактически хранящиеся в столбцах;
блок: столбец данных
Запросы Presto

** sql-запрос: ** http POST запрос
** Дерево абстрактного синтаксиса: ** Подзапрос выражается иерархически в единицах запроса
** Логический план: ** Преобразовать абстрактное синтаксическое дерево в простейшую операцию
Оптимизатор:
- Запись агрегатных узлов в форме map-reduce (частичный узел и конечный узел)
- Вставить узел обмена в узел map-reduce
- Заранее ускоряет работу узла
- Возможность слияния
- Что выполняет выполняют каждый тип фрагмента:
- Задача типа source: Определить количество сплитов для чтения в соответствии с метаданныvb, назначить сплит машине и указать в конфигурации network-topology = flat, затем попытаться выбрать машину, на которой находится сплит. Каждый результат будет отправлен на каждую машину верхнего фрагмента;
- фиксированный тип и одиночный тип (настраивается параметром query.initial-hash-partitions, по умолчанию 8): выделяется несколько машин для фрагмента, несколько машин для промежуточных результатов, и только одна машина - для конечного результата
- Если имеется несколько машин (group by), то хэш вычисляется в соответствии с groupby, и выход последующей машины выбирается в соответствии с хэшем. При вычислении не по принципу group by выбор производится случайным образом или по кругу.
Физический план выполнения:
- После передачи фрагмента в машину он записывается в список операторов в виде дерева узлов и динамически компилируется в соответствии с логическим кодом для генерации байткода.
Динамическая генерация байткода, в основном, использует принцип компиляции:
- Открытый контур (open loop)
- В соответствии с типом столбца данных непосредственно вызывать нужную функцию для сокращения операторов перехода по ветвям.
- Оператор исходного типа при каждом вызове будет получать новую порцию данных, а для оператора Aggregate выходной результат может быть получен только после завершения работы всех предыдущих операторов.
-
Есть 2 типа агрегированных вычислений:
- AggregationOperator: Для каждой операции выводить по одному результату;
- HashAggregationOperator: Используйте хэш для вычисления ключа для столбца. Ключ является одним и тем же, чтобы хранить результат вместе для вычисления группировки по классам;
- Агрегатные вычисления предоставляют четыре интерфейса для добавления уровня вычислений между map-reduce и приемом промежуточных результатов на вход и выход.
- Принять исходные данные
- Принять входные данные для получения промежуточных результатов
- Вывести промежуточные результаты
- Вывести окончательный результат.
Существует 2 типа функций:
- Масштабирующая функция: обработка преобразования данных, без сохранения состояния, один вход производит один выход.
- Агрегатная функция: Агрегатная обработка данных, использование существующего состояния + вход для генерации нового состояния.
Управление памятью
Пул памяти:
- системный пул: 40% зарезервировано для системы
- резервный пул: 10% зарезервировано для максимального запроса
- общий пул: для общих запросов
Для того чтобы не выделять большие задачи каждой машине, последняя часть (задача с наибольшей памятью) завершается в резервном пуле, а другая часть (машина с наибольшей памятью) ожидает выполнения в общем пуле, что приводит к тупиковой ситуации.Presto назначает самый большой запрос в резервный пул координатору для его выполнения (хотя это приведет к тому, что часть резервного пула машин, не выполняющих этот запрос, будет потрачена впустую), вместо того чтобы позволить каждой машине выполнить самую большую задачу запроса в резервном пуле.
Координатор вычисляет объем памяти для каждой задачи запроса. Одновременно поток периодически опрашивает состояние памяти каждой машины. После суммирования памяти запросов и памяти машин координатор выбирает запрос с наибольшим объемом памяти и выделяет его в резервный пул.
Принцип реализации запроса с малой задержкой
Традиционная оптимизация SQL
Параллельные вычисления, полностью основанные на памяти
- Параллельное чтение исходных данных: каждый узел Source вызывает HDFS InputSplit API, после чего каждому InputSplit назначается узел Worker для выполнения
- Распределенная хэш-агрегация: результаты частичных задач назначаются разным вычислительным узлам в соответствии с хэш-значением group by
1 Линия сборки
- Каждый рабочий берет объект PrioritizedSplitRunner из очереди приоритетов, периодически проверяет статус завершения и удаляет выполненные задания, а невыполненные помещает обратно в очередь;
- Операция обмена извлекает данные для каждого узла Worker, который перемещается на этап выше. Наименьшей единицей данных является объект Page. После извлечения данных они помещаются в очередь Pages.
- При выполнении задачи каждый оператор получает страницу от предыдущего оператора, данные существуют и выполняются (страница - это несколько строк данных, состоящих из блоков, хранящихся в столбцах).
2 Локализованное вычисление
- Предпочитает выбирать в качестве рабочего тот узел, на котором находятся данные
3 Динамическая компиляция планов выполнения (например, оптимизация расширения циклов): Использование байт-кода, генерируемого кэшем LoadingCache, предоставляемым Google Guava.
4 Аккуратное использование памяти и структуры данных
Используйте Slice для операций с памятью, Slice использует Unsafe # copyMemory для достижения максимально эффективного копирования памяти
5 Близкий к BlinkDB приблизительный запрос
Для повышения скорости выполнения запросов к таким агрегатным функциям, как avg, count distinct и percentile, введены функции запросов approx_avg, approx_distinct и approx_percentile. approx_distinct реализована с использованием алгоритма HyperLogLog Counting.
Алгоритм HyperLogLog: хэш-значение ключа преобразуется в 64 бита, младшие 6 бит используются как количество экспериментальных раундов, берется порядковый номер первой позиции 1 в 60 битах, преобразуется в двоичный бит и сохраняется. Подсчитываем наибольший порядковый номер и получаем количество элементов по следующей формуле
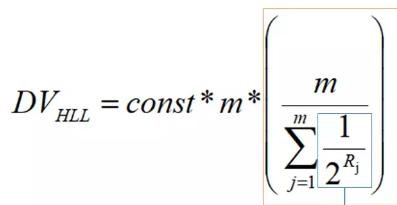
6 GC контроль
Команда Presto обнаружила ошибку JIT при использовании hotspot java7. Когда кэш кода достигает верхнего предела, JIT может перестать работать, в результате чего часто используемый код не может быть динамически скомпилирован в нативный код.
Команда Presto использовала метод Hack для решения этой проблемы, добавив поток для выполнения явного GC, когда кэш кода достигает более 70.
ClickHouse
Архитектура ClickHouse
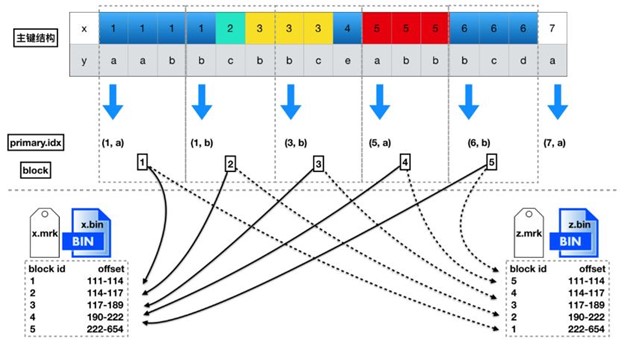
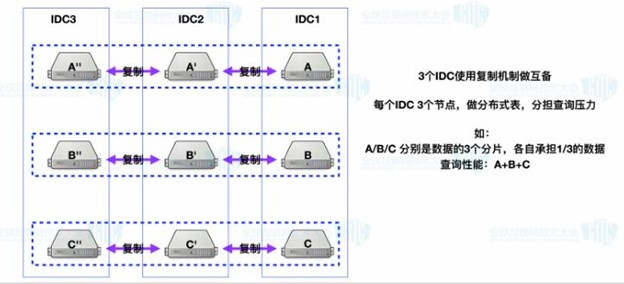
Развертывание ClickHouse
- Возможность расширения
Clickhouse не возможно расширить, для этого необходимо использовать специальный движок
запись:
- Уточнить, на какой узел записаны те или иные данные;
- При записи через один узел данные разделяются по разным узлам, а распределение данных осуществляется путем указания ключа шарда.
- Запись данных осуществляется асинхронно. При вставке данных на другие узлы кластера данные сначала записываются на локальный диск, а затем в фоновом режиме отправляются на другие серверы шардов. Если необходимо проверить, синхронизированы ли данные, можно проверить следующий каталог: / var / lib / clickhouse / data / database / table
чтение:
- Один узел хранит все данные, и возвращает их Клиенту
- надежность
Полагаться на zookeeper, использовать физическую репликацию
Основные характеристики ClickHouse:
- Известна как самая быстрая в области баз данных класса in-memory;
- Данные всегда хранятся в столбцах;
- Существует два способа ускорить процесс обработки данных: векторное выполнение запросов и генерация кода во время выполнения;
- Clickhouse – БД с колоночным типом хранения данных. Используется технология векторных запросов. Операции select, orderby и limit не изменяют исходный вектор столбцов, а создают новый. Подходит для менее модифицированных данных;
- Промежуточные данные каждого шага конвейера запросов сохраняются, причем временные данные должны быть пригодны для кэша процессора;
- Для распределенных данных сложные запросы, такие как join, поддерживаются не в полной мере;
- ClickHouse использует разреженные индексы и не подходит для высоконагруженных точечных запросов;
- ClickHouse не опирается на Hadoop;
- Не поддерживает операции Update / Delete;
- Движок векторизации: данные не только хранятся в столбцах, но и обрабатываются векторно-столбцовой частью. Это позволяет достичь более высокой производительности процессора;
- Позволяет создавать таблицы и базы данных во время выполнения, загружать данные и выполнять запросы без необходимости переконфигурирования и перезапуска сервера.
Причины, по которым ClickHouse работает достаточно быстро:
- Его способность к обрезке данных относительно сильна, обрезка разделов происходит на уровне исполнения, а формат хранения выражается локальными данными, что позволяет обрезать некоторые данные с более мелкой степенью детализации. В движке используется популярный в настоящее время метод LSM;
- Он лучше справляется с вертикальной интеграцией всего ресурса. Метод параллельного выполнения MPP + SMP позволяет полностью использовать интегрированные ресурсы машины. В его реализации сделано много оптимизаций, связанных с производительностью. Существует множество различных вариантов простой операции агрегирования, и для различных комбинаций ключей будут применяться различные реализации. Для расширенных вычислительных инструкций он также используется в небольших количествах при распаковке данных.
- ClickHouse представляет собой набор реализаций, написанных на языке C ++
- Не поддерживает транзакции
- Векторное выполнение запросов:
- При выполнении запроса операция направляется на массив, а не на конкретное значение;
- Практичность векторного выполнения запросов не столь высока. Если временные данные не подходят для L2-кэша, то кэш чтения будет проблематичен. Однако векторное выполнение запросов позволяет легче использовать SIMD-возможности процессора.
- Обеспечивает ограниченную динамическую генерацию кода во время выполнения (первый этап внутреннего цикла group by):
- Генерация кода во время выполнения может более эффективно объединять несколько операций, чтобы в полной мере использовать преимущества блоков выполнения и конвейеров процессора. Векторное выполнение запросов не очень практично, поскольку оно связано с временными векторами, которые должны быть записаны в кэш и считаны обратно. Если кэш L2 не может хранить временные данные, то это становится проблемой. Однако векторное выполнение запросов облегчает использование SIMD-функции процессора.
OLTP и OLAP
** Оперативная обработка транзакций (OLTP) ** Поддерживается бизнес-базами данных, с фиксированными данными и низкой операционной нагрузкой, с акцентом на согласованность и восстанавливаемость базы данных.
** Онлайн - аналитическая обработка (OLAP) ** Поддерживается хранилищем данных, отражающим исторические данные, данные из нескольких источников, обычно многомерное моделирование, типичными операциями OLAP являются:Drill on (полимеризация), Drill down (расширение), Cut (выборка и проекция), Pivot (многомерное представление).
Проблемы запросов в OLAP носят неопределенный характер.
Двумя наиболее критичными факторами базы данных OLAP являются: параллельная обработка и масштабируемость.
ROLAP (реляционный OLAP): поддерживает расширенный SQL и специальный доступ к стандартным или расширенным реляционным СУБД
MOLAP (многомерный OLAP): хранение многомерных данных непосредственно в определенной структуре данных
Ключевые характеристики OLAP
- Большинство запросов на чтение;
- Данные всегда записываются достаточно большими партиями (> 1000 строк);
- Не модифицировать добавленные данные;
- Каждый запрос считывает большое количество строк из базы данных, но при этом требует только небольшое количество столбцов;
- Широкие таблицы, каждая таблица содержит большое количество столбцов;
- Меньшее количество запросов (обычно сотни запросов в секунду или меньше на один сервер);
- Для простых запросов допустима задержка около 50 мс;
- Данные в столбцах относительно небольшие: числа и короткие строки (например, 60 байт на URL);
- При обработке одного запроса требуется высокая пропускная способность (до миллиардов строк в секунду на один сервер);
- Транзакция не требуется;
- Низкие требования к согласованности данных;
- Каждый запрос мал, за исключением одной большой таблицы;
- Результат запроса заведомо меньше исходных данных. Другими словами, данные после фильтрации или агрегирования могут храниться в памяти одного сервера
Общепринятые термины и технологии в сфере БД
Способы обмена информацией
- shared everything(SMP): сеть и диск являются узким местом (SQLServer)
- shared disk(NUMA): когда интерфейс памяти достигает насыщения, добавление узлов не приводит к повышению производительности (Oracle Rac)
- shared nothing(MPP): каждый процесс имеет собственные данные, масштабируемость и низкую стоимость
Массово-параллельная архитектура (англ. massive parallel processing, MPP
- Задачи выполняются параллельно;
- Распределенное хранение данных (локализация);
- Распределенные вычисления;
- Частные ресурсы;
- Горизонтальное расширение;
- Архитектура Shared Nothing.
Характеристики MPPDB
(1) Структура без мастера
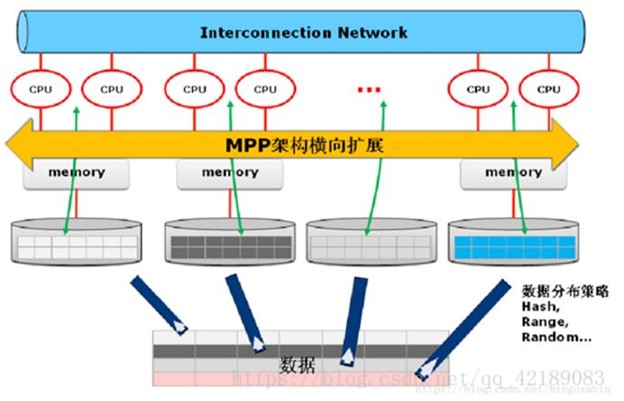
(2) Может обрабатывать данные уровня PB, использовать хэш-распределение и случайную стратегию хранения, а также применять усовершенствованный алгоритм сжатия;
(3) Высокая степень расширения, поддержка расширения и сокращения кластера;
(4) Высокий параллелизм: чтение и запись не являются взаимоисключающими, можно выполнять запросы во время загрузки.
Организация данных:
В отличие от обычного управления сегментами, кластерами и страницами, HTS (huge tablespace) эквивалентна файловой системе.
HTS-> каталог режима SCH-> каталог таблицы TAB-> столбец COL (файл.dta, по умолчанию 64M)-> область (количество строк хранения указывается в начале, а начальная позиция выравнивается по 4k)
Вспомогательная таблица: управление данными в HTS, каждая запись соответствует области, запрос выполняется во вспомогательной таблице
Умный индекс:
В определенной степени он может заменить индекс BTree, а максимальное и минимальное значения могут играть роль фильтра
Адаптивная компрессия:
- Кодировка словаря;
- Выбросы (outliers) (в нескольких различных случаях выбросы сохраняются с помощью <номер строки + значение>);
- RLE-кодирование (большое количество данных одинаково, количество каждого значения более равномерно);
- Порядковое кодирование (при наличии алгебраической зависимости можно хранить только отличие от общего базового значения)
Адаптивные шаги:
- Если столбец является самовозрастающим столбцом или последовательностью, то используется непосредственно код последовательности;
- Получение статистики данных: количество различных значений n_dist, количество каждого различного значения, указатель данных различных значений, количество последовательных вхождений каждого значения, максимальное значение целого числа;
- На основе полученной статистики области определить, какое кодирование использовать: постоянное, RLE-кодирование или словарное; порядок использования этих трех кодировок следующий: предпочтительнее постоянное кодирование, на втором месте - RLE-кодирование, на последнем - словарное кодирование.
- Если суммарная длина после кодирования превышает исходную длину, то она будет возвращена без кодирования.
- Важно: потеря производительности, вызванная декомпрессией, гораздо меньше, чем накладные расходы на ожидание дискового ввода-вывода.
Схема RAID
RAID1 и RAID5 являются самыми распространенными схемами
|
JBOD |
Прямое подключение к диску |
|---|---|
|
JBOD |
Дисковый кабинет, образованный прямым соединением дисков |
|
RAID0 |
Отсутствие избыточного распределенного хранилища |
|
RAID1 |
Зеркальное резервирование |
|
RAID2 |
Проверка кода Хэмминга, 4 дисковое хранилище распределения данных, 3 дисковая проверка, практически редко используется |
|
RAID3 |
Как минимум три диска с данными распределяются и хранятся (распределяются по битам или по байтам), а один диск проверяется, что подходит для распределенного последовательного доступа большой емкости. Производительность RAID3 падает при наличии плохого диска, часто заменяется на RAID5 |
|
RAID4 |
То же самое, что и RAID3, но распределенное по блокам, с хорошей производительностью чтения и плохой производительностью записи, что редко встречается на практике |
|
RAID5 |
То же самое, что и RAID4, данные распределены по каждому диску, узкого места для записи в RAID4 нет, на сегодняшний день это самое лучшее решение |
|
RAID6 |
Вышеописанный вариант защищает от сбоев только один диск, RAID6 имеет двойную проверку (можно использовать два алгоритма для хранения разных проверочных данных на двух дисках), производительность записи низкая |
|
RAID00 |
Двойной RAID0 |
|
RAID01 |
Зеркальное отображение сначала 1, а затем 0 обеспечивает безопасность данных при одновременном повышении производительности |
|
RAID10 |
Сначала создается 0, а затем отображается 1 для обеспечения безопасности данных при одновременном повышении производительности |
|
RAID30/50/60 |
Улучшает производительность |
|
RAID7 |
Событийно-ориентированная ОС, использующая асинхронный доступ для сокращения узких мест при записи, улучшения IO, автоматической оптимизации чтения и записи. |
|
RAID-DP |
NVRAM используется для хранения и записи данных, и они не будут потеряны при отключении питания. Централизованная запись. При использовании RAID6 производительность менее чем на 2% ниже, чем у RAID4, а обновление прошивки происходит без перерыва в режиме реального времени. |
|
RAID5E |
Обеспечение резервирования дисков, автоматическое понижение до RAID5 при повреждении диска занимает много времени |
LSM-Дерево (long structured merge tree)
- Главной особенностью является высокая скорость записи, которая в основном использует последовательную запись на диск
- LSM -дерево предназначено в основном для сценариев с интенсивной записью и небольшим количеством запросов. Используется в различных базах данных с ключевыми значениями
- Запись: При операции записи данные сначала записываются в память (слой f0). Когда объем данных достигнет определенного размера, они будут объединены и отсортированы для слияния и записи на диск (слой f1). Когда слой f1 диска достигнет определенного размера, он продолжит слияние в слой c2;
- Чтение: Запрос слой за слоем
- Реализация lsm-дерева LevelDB: Есть три типа файлов, memtable и immutable в памяти, и SStable (сортированная таблица строк) на диске, запись будет производиться в memtable. При достижении порогового значения immutable сливается на диск, а memtable передается Is immutable.
Параллельная структура Kafka
Архитектура Kafka
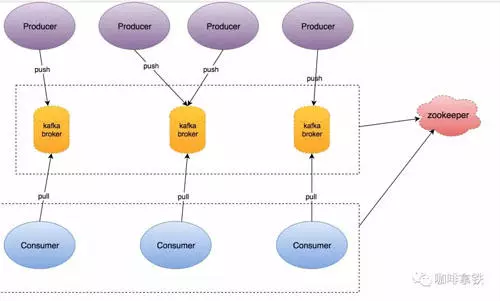
Тема и Разделы
У каждого сообщения Kafka есть своя тема. Для каждой темы Kafka ведет лог-файл распределенного раздела (Partition). Сообщения, отправленные в этот раздел, будут добавлены в конец лог-файла, а в массиве offset будет записано местоположение сообщения . Убедитесь в том, что сообщения в разделе упорядочены.
Модель потребления
Kafka использует модель pull (Poll) для самостоятельного управления скоростью потребления, чтобы предотвратить потерю сообщений, основанных на push, из-за зависания процесса потребления или плохой работы сети.
Сетевая модель
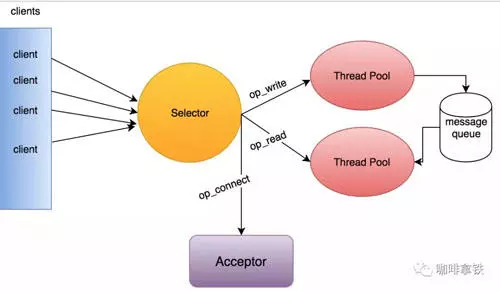
- Многопоточная модель селектора: Акцептор работает в отдельном потоке, а операция чтения регистрирует событие Read в Селекторе. В случае успеха запрос помещается в общую очередь Message Queue. Запишите запрос из пула потоков и логически обработайте его;
- Таким образом, даже если поток запросов будет заблокирован, найдутся последующие потоки, которые получат запрос из очереди сообщений и обработают его;
- После логической обработки в потоке записи, поскольку событие OP_WIRTE зарегистрировано, необходимо отправить на него ответ.
Kafka – высоконадежная модель хранения данных
Благодаря мханизму копирования, даже если машина выйдет из строя, потери данных не будет.
Когда Продюсер (Producer) отправляет данные Лидеру (Leader), можно задать уровень надежности данных с помощью параметра request.required.acks:
- 1: параметр по умолчанию, производитель завершает работу после получения подтверждения.
- 0: без подтверждения
-1: Все последователи в ISR подтверждают получение данных перед отправкой, надежность данных при этом самая высокая.
(ISR = Лидер + новая копия) ISR может использоваться для замены Лидера
AR (Assigned Replicas) = ISR + старая копия
|
Режим подтверждения |
request .required .acks |
Описание |
Характеристики |
|---|---|---|---|
|
al-least-once |
1 |
Продюсер получает подтверждение от Ack о том, что сообщение было записано в Kafka |
Продюсер завершил работу по таймеру или получил ошибку; повторите отправку сообщения; возможно, сообщение будет записано дважды |
|
at-most-once |
0 |
Отсутствие подтверждения после отправки |
|
|
exactly-once |
-1 |
Обеспечить доставку сообщения потребителю не более одного раза |
Каждый продюсер сохраняет порядковый номер для определенного раздела определенной темы. Каждый раз, когда брокер получает сообщение, он требует, чтобы порядковый номер продюсера был на единицу больше, чем его собственный |
Транзакции в Kafka реализуют семантику exactly-once.
Высокопроизводительное хранилище журналов
- Все сообщения по теме распределяются и хранятся на нескольких узлах в виде разделов (Partition);
- Каждому разделу соответствует каталог журнала;
- Файл LogSegment состоит из двух частей - файла ".index" и файла ".log", которые выражаются как файл индекса сегмента и файл данных, соответственно;
- Поскольку объем данных сообщений Kafka слишком велик, построение всех индексов займет много места и увеличит временные затраты, поэтому в Kafka был выбран метод разреженного индекса, благодаря которому индекс может напрямую попадать в память, что значительно ускоряет выполнение частичных запросов.


