

Визуализация логов и событий: Loki и Elasticsearch в Grafana
Логи являются ключевым источником информации для диагностики проблем, аудита и анализа поведения системы. Grafana предоставляет мощные средства для визуализации логов через Loki и Elasticsearch, которые отличаются архитектурой, моделью данных и подходами к поиску. Глава раскрывает, как проектировать и реализовывать эффективные конвейеры логирования, настраивать источники данных, формировать дашборды и внедрять принципы observability на практике.
Логика построения решений в Observability требует глубокой проверки архитектуры, понимания особенностей хранения и индексации, умения работать с запросами и умной настройкой панелей. В рамках этой главы рассматриваются синергия между системами Loki и Elasticsearch, критерии выбора, сценарии миграции и совместного использования в гибридной архитектуре. Особое внимание уделяется алгоритмам фильтрации и структурированию логов, схемам именования меток, а также методам оптимизации запросов и хранения для больших объёмов данных.
- Краткое содержание главы
- Архитектура и модели данных Loki и Elasticsearch, принципы хранения и индексации.
- Подключение Grafana к Loki и Elasticsearch: настройки источников данных, запросы LogQL и Lucene.
- Сценарии визуализации и совместного использования двух источников: когда применять каждый подход и как проектировать дашборды.
- Практики оптимизации производительности, ретенции и мониторинга панели логов.
- Рекомендации по миграции, безопасности и управлению инцидентами в контексте логирования.
Архитектура и концепции логирования в Grafana: Loki и Elasticsearch
Логирование в современном приложении строится на двух базовых моделях: обходной путь с прозрачной агрегацией и полнотекстовый поиск с гибкой фильтрацией. Loki следует парадигме «логов по потокам»: логи группируются по меткам (labels), а сами данные хранятся в слоистых чанках и в объектном хранилище. Поиск осуществляется через индексную составляющую, которая хранится отдельно, что позволяет эффективно масштабировать хранение метаданных при сохранении самой информации о сообщениях в сжатых чанках. В Loki основной акцент на структурированной навигации по потокам логов и эффективной агрегации по ярлыкам, что особенно полезно в микросервисной среде и в контейнеризированных кластерах. Архитектура включает такие ключевые компоненты, как Distributor, Ingester, Querier и Elastic- или BoltDB-шарпер-индексы, а также интеграцию с объектным хранилищем для длительной ретенции. При этом Loki не гарантирует полнотекстовый поиск на уровне всего текста логов, но обеспечивает мощную фильтрацию по лейблам и регулярным выражениям в рамках LogQL.
Elasticsearch реализует полнотекстовый поиск и гибкую схему индексации. Логи индексируются в индексах, которые могут быть организованы по временным рамкам (например, daily или hourly индексы), и поддерживают сложные запросы на уровне Lucene DSL. Это обеспечивает высокую точность поиска по полям, таким как сообщение, уровень, метки, временная метка и контекст. Встроенные пайплайны обработки данных (Beats, Logstash, Ingest Nodes) позволяют нормализовать и обогащать логи перед индексированием. В архитектуре Elasticsearch важна грамотная карта полей (mappings), настройка аналитику и ретенционных стратегий, чтобы не допускать перегрузку кластера и обеспечить предсказуемое время отклика на запросы.
-
Взаимосвязь между архитектурой Grafana и источниками данных: Grafana выступает единой платформой визуализации и запросов к Loki и Elasticsearch, предоставляя унифицированный UX для фильтрации, агрегации и детализации логов. В зависимости от характера логов и требований к полнотекстовому поиску пользователь может выбрать один источник, либо реализовать совместную архитектуру с несколькими источниками в рамках одного дашборда.
-
Модели данных и форматы: Loki опирается на пары (stream, label-set) и хранение сообщений в чанках; Elasticsearch опирается на документы JSON с набором полей, включая @timestamp, message, лейблы и любое произвольное расширяемое поле. Эффективное проектирование схем требует минимизации гиперкардинальности лейблов в Loki и грамотного выбора полей для индексации в Elasticsearch.
-
Протоколы передачи и безопасность: Loki принимает данные через HTTP API и специализированные клиенты-примеры (Promtail, Fluent Bit), поддерживает аутентификацию и шифрование через TLS; Elasticsearch использует REST API и может быть защищён через TLS, OAuth2/RBAC, Kerberos и другие методы защиты доступа. В Grafana эти механизмы интегрируются через настройки источников данных, а также через централизованное управление доступом на уровне дашбордов и панелей.
Архитектура данных и потоки
-
Loki: поток данных строится вокруг потоков логов, каждый поток определяется набором меток. При ingest данные разбиваются на чанки, индекс хранится в объектном хранилище, чтобы облегчить масштабируемость ретенции. Запросы в Grafana проходят через LogQL, который позволяет фильтровать по меткам, использовать регулярные выражения и распаковку JSON-полей внутри сообщений. Такой подход обеспечивает компактное хранение и быстрый доступ к агрегированным данным по меткам.
-
Elasticsearch: логи приходят либо через Beats/Logstash, либо через прямую интеграцию через клиента Grafana. Индексы создаются на основе временной метки, что позволяет выполнять диапазонный поиск и агрегацию по полям. Поля можно структурировать и обогащать с помощью pipelines, что упрощает последующий поиск и визуализацию.
-
Совместное использование: можно сочетать Loki как источник для оперативной диагностики и Elasticsearch как источник для полнотекстового анализа и сложных запросов. Графана поддерживает мультиданные источники в одной панели, что позволяет сравнивать результаты и объединять контекст по одному временному окну.
Безопасность и соответствие требованиям
-
Управление доступом: Grafana предоставляет RBAC на уровне дашбордов и панелей; источники Loki и Elasticsearch также поддерживают свои механизмы аутентификации и авторизации. В инфраструктуре observability следует внедрять минимально необходимые привилегии, разграничение прав на чтение и запись для отдельных проектов и команд.
-
Шифрование и аудит: TLS для трафика между агентами, Grafana и источниками данных; аудит действий пользователей и изменений конфигураций дашбордов для обеспечения соответствия требованиям регуляторов.
Пример сценария потоков
- Источник: Promtail отправляет логи в Loki. Grafana выполняет запрос через LogQL, чтобы отфильтровать по сервису и уровню, затем отображает таблицу с полями timestamp, service, level, message. Параллельно Logstash встраивает в Elasticsearch те же логи, обогащает их полями и размещает в индексах вида logs-YYYY.MM.DD. В Grafana создаются панели, где одна объединяет данные Loki, а другая - Elasticsearch, чтобы обеспечить полнотекстовый поиск и контекст по одному окну времени.
Примеры кода
## Пример запроса LogQL в Grafana для Loki
{job="apiserver"} | json | line_format "{{ .time }} {{ .level }} {{ .message }}"
## Пример запроса Lucene для Grafana Elasticsearch data source
@timestamp:[now-1h TO now] AND message:"error" AND service:"frontend"
## Пример Pipeline DSL для Elasticsearch (для иллюстрации схемы обработки входящих логов)
{
  "description": "Enrich logs with hostname and app name",
  "processors": [
    { "rename": { "field": "log", "target_field": "message" } },
    { "set": { "field": "host", "value": "{{ instrument_host }}" } },
    { "set": { "field": "app", "value": "my-service" } }
  ]
}
Интеграция Grafana с Loki: архитектура, источники данных, схемы
Loki как источник данных для Grafana строится вокруг простого и эффективного подхода к индексации логов по меткам. Подключение осуществляется через стандартный источник данных Loki в Grafana, который поддерживает аутентификацию и TLS. После подключения можно работать как в панели дашборда, так и в режиме Explore для детального поиска.
Архитектура Loki и потоки данных
-
Промежуточные звенья: агентов-логгеры (Promtail, Fluent Bit) собирают логи и отправляют их в Distributor. Distributor маршрутизирует данные в Ingester, где логи сохраняются в чанках и индексируются для быстрого доступа. Индекс и чанки хранятся в отдельном хранилище (object storage) и могут быть синхронизированы с BoltDB-shipper для локального кэша индексов. Querier обеспечивает поиск по чанкам и формирует результаты в Grafana.
-
Преимущества подхода Loki: компактное хранение, эффективная агрегация и поиск по меткам, удобство работы с контейнеризованной инфраструктурой и микросервисами; прощее управление ретенцией и масштабированием по меткам.
Подключение Grafana к Loki
-
Шаги:
- Добавить новый источник данных Loki в Grafana, указать адрес сервера и параметры аутентификации.
- Включить TLS/модули безопасности по необходимости.
- В панели дашборда выбрать Loki как источник данных и строить запросы через LogQL.
-
Практические правила: избегайте избыточной кардинальности лейблов; используйте понятную схематику именования потоков, чтобы уменьшить объём индекса и ускорить поиск.
Примеры запросов LogQL
## Ищем ошибки в контейнерных лейблах за последние 2 часа
{job="kubelet", level="error"} |~ "timeout|failed" | line_format "{{.timestamp}} {{.message}}"
## Расширенная выборка JSON-полей
{container="nginx"} | json | line_format "{{ .time }} {{ .log.level }}: {{ .log.msg }}"
Практические сценарии внедрения
- Начальный этап: централизовать логи всех сервисов через Promtail или аналогичные агенты, настроить базовые дашборды с сущностями, которые чаще всего приводят к инцидентам (ошибки, тайм-ауты, сбои).
- Эволюция: добавить корреляцию по трассировкам, объединить логи с событиями в распределённых трейсах, связать логи с метриками.
Производительность и эксплуатационные особенности Loki
- Ретенция и хранение: благодаря чанкам и объектному хранилищу, Loki эффективно обрабатывает длинные периоды хранения. Важно балансировать размер чанков и частоту архивации индекса.
- Кардинальность лейблов: чрезмерное число уникальных значений лейблов может привести к росту индекса и задержкам. Рекомендуется использовать умеренную кардинальность и планировать лейблы заранее.
- Масштабирование: горизонтальное масштабирование Distributor и Ingester, а также настройка достаточного числа Querier-подпунктов помогает поддерживать низкие задержки запросов.
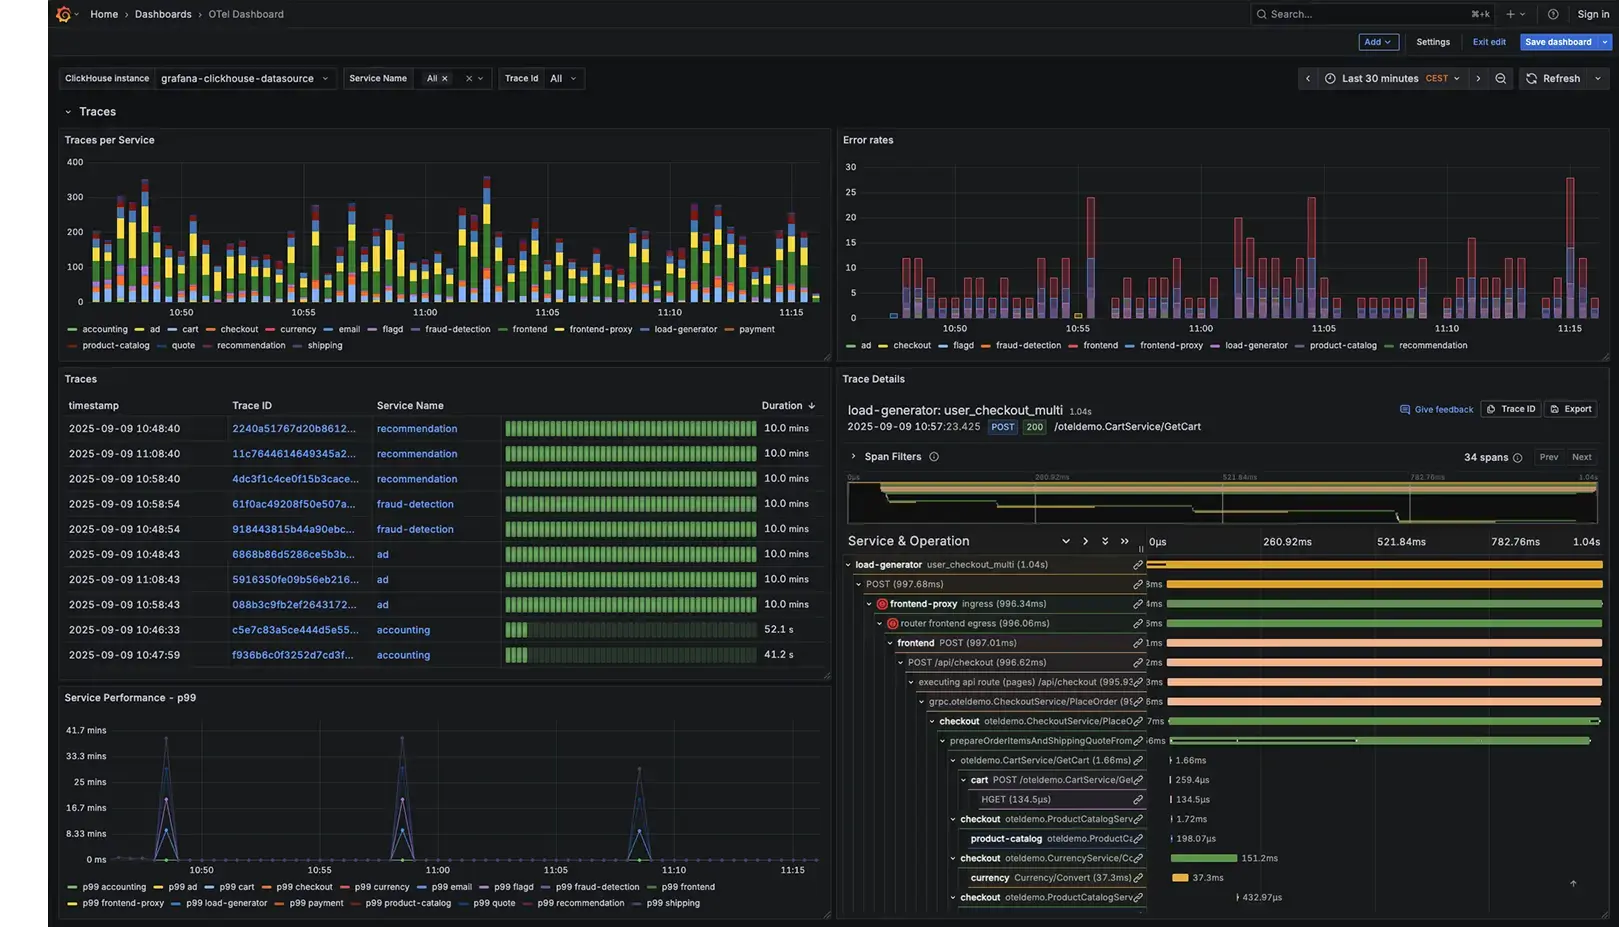
Интеграция Grafana с Elasticsearch: архитектура и запросы
Elasticsearch предоставляет полноценный полнотекстовый поиск и мощные возможности фильтрации по полям. Grafana поддерживает Elasticsearch как источник данных с различными способами конфигурации индексов и полей. В контексте логирования Elasticsearch часто применяют pipeline-процессы (Beats, Logstash, Ingest) для обогащения данных и нормализации структуры логов перед индексированием.
Архитектура Elasticsearch как источника логов
- Индексы: логи индексируются в временных рамках (например, logs-YYYY.MM.DD), что упрощает тайм-диапазонный поиск и агрегации.
- Мappings: строгая карта полей обеспечивает быстрый доступ к полям (message, level, hostname, app, service, trace_id и др.). Преобразование полей на этапе ingestion уменьшает стоимость редактирования и поиск по полям.
- Ингестинг-пайплайны: Logstash или Ingest Nodes позволяют обогащать логи дополнительной информацией (пользователь, среда, зона, контекст). Это упрощает последующий анализ и корреляцию между сервисами.
Подключение Grafana к Elasticsearch
-
Настройка источника данных: выбрать тип Elasticsearch, указать URL к кластеру, версию Elasticsearch, параметры индекса (index pattern) и временную колонку, по которой Grafana будет осуществлять временной поиск.
-
Запросы в Grafana: Grafana поддерживает Lucene-подобный язык запросов, который позволяет задавать фильтры по полям, временные диапазоны и агрегирования. В панели можно использовать фильтры по полям и динамические переменные.
-
Примеры запросов:
## Lucene query в Grafana Elasticsearch data source
@timestamp:[now-1h TO now] AND log_level: "ERROR" AND service: "frontend"
## Пример DSL для иллюстрации: индекс-агрегирование по полю hostname и подсчёт ошибок
POST /logs-*/_search
{
  "size": 0,
  "query": {
    "bool": {
      "must": [
        { "range": { "@timestamp": { "gte": "now-1h" } } },
        { "match": { "log_level": "ERROR" } }
      ]
    }
  },
  "aggs": {
    "by_host": {
      "terms": { "field": "host.keyword" }
    }
  }
}
Интеграционные сценарии и поиск по данным
-
Полнотекстовый и структурный поиск: Elasticsearch позволяет сочетать полнотекстовый поиск по сообщению и структурированные фильтры по полям, что полезно для сложной аналитики и аудита.
-
Метрики и корреляция: можно строить панели, объединяющие логи и контекст трассировок, если в логе присутствуют поля trace_id и span_id.
-
Безопасность: настройка ролей в Elasticsearch и Grafana обеспечивает ограничение доступа к чувствительным данным в логах.
Примеры использования и рекомендации
- При высокой кардинальности полей (например, идентификаторы пользователей или сессий) следует осторожно подходить к индексации и агрегациям, чтобы не перегружать кластер.
- Ротация индексов и настройка жизненного цикла хранения: применяйте политику удаления старых индексов или архивирования в долгосрочное хранилище.
- Оптимизация запросов: используйте фильтры по временным диапазонам для уменьшения объёма данных, применяйте агрегации только к необходимым полям, избегайте глубоких цепочек скалярных агрегаций без нужды.
Примеры кода
## Пример Query DSL для Elasticsearch, иллюстрирующий поиск ошибок за последний час
{
  "query": {
    "bool": {
      "must": [
        { "range": { "@timestamp": { "gte": "now-1h" } } },
        { "match": { "log_level": "ERROR" } }
      ]
    }
  }
}
## Пример Lucene-запроса в Grafana для Elasticsearch data source
@timestamp:[now-1h TO now] AND message:"timeout" AND service:"payments"
Практические сценарии внедрения
- Миграция с локальных хранилищ логов на Elasticsearch: начинается с переноса наиболее критичных источников логов и постепенного разворачивания Pipelines для обогащения полей, затем внедряются дашборды и алерты.
- Гибридное использование: если часть ваших сервисов уже развёрнута на Elasticsearch и требуется полнотекстовый поиск, а другая часть экосистемы хорошо работает с Loki - можно строить единый дашборд Grafana, объединяющий оба источника, чтобы получить целостную картину.
Совместная визуализация логов: выбор подхода и проектирование дашбордов
-
Выбор источника зависит от требований: Loki обеспечивает эффективную агрегацию и фильтрацию по меткам, экономично хранит логи; Elasticsearch - более мощный полнотекстовый поиск и гибкость в работе с полями и сложными запросами.
-
В проектах с микросервисной архитектурой часто применяют гибрид: Loki для оперативной диагностики, Elasticsearch - для детального анализа и аудита. Grafana позволяет строить панели, которые агрегируют данные из разных источников и позволяют пользователю быстро переключаться между режимами детального разбора и сводной картины.
-
Схемы проектирования дашбордов:
- Дашборд глобальной картины: агрегированные метрики по сервисам, а затем детальные панели для конкретных потоков логов (по меткам в Loki) и по записям в Elasticsearch.
- Панели фильтрации: использование переменных (variables) для сервисов, сред, узлов, чтобы динамически менять источник и контекст поиска.
- Динамическое переключение источников: Grafana позволяет пользователям выбирать Loki или Elasticsearch на панели и адаптировать визуализацию под текущие требования.
Архитектура запросов и производительность
- Эффективная работа с логами требует оптимизации запросов: по Loki - ограничение по кардинальности меток и разумные тайм-брейки; по Elasticsearch - фильтры по диапазонам времени и выборочные агрегации.
- Кэширование на стороне Grafana и налаженная ретенция данных помогают снизить задержку при повторных запросах и уменьшить нагрузку на источники данных.
- Планирование ретенции и политики хранения: для критичных инцидентов можно сохранять логи на более длительный срок в Elasticsearch, тогда как Loki может удерживать оперативную коллекцию меток для быстрых поисков.
Практика проектирования дашбордов
- Применение логов к бизнес-сценариям: использование полей, связанных с пользовательскими сессиями, транзакциями и сервис-уровнями соглашений (SLA). Это позволяет углублять анализ и быстро находить причины инцидентов.
- Грамотная визуализация: таблицы с фильтрацией по полям, линейные графики по частоте ошибок, тепловые карты по активности в течение суток, панели со сводками по сервисам.
- Связь логов с метриками: аналогичные панели, добавляющие контекст к метрикам за счет логов, чтобы точно определить источники проблем и подтвердить гипотезы.
Производительность и оптимизация: Loki и Elasticsearch в Grafana
-
Локальные рекомендации для Loki:
- Спланируйте кардинальность лейблов и избегайте избыточной детализации в потоках, чтобы не перегружать индекс и ускорить поиск.
- Поддерживайте баланс между размером чанков и временем доступа: слишком маленькие чанки вызывают увеличение количества запросов к базе данных, слишком большие - задержку при запросах.
- Используйте boltdb-shipper для локального кэша индексов, чтобы ускорить повторные запросы и снизить нагрузку на центральное хранилище.
-
Рекомендации для Elasticsearch:
- Оптимизируйте mappings: фиксированные типы полей, корректные аналоги текстовых и ключевых полей, избегайте непредсказуемых динамических полей.
- Разграничение индексов по времени и настройка ILM (Index Lifecycle Management) для автоматического rollover и удаления старых данных.
- Пайплайны и обогащение: применяйте пайплайны только там, где это действительно необходимо, чтобы не увеличивать задержку индексации.
-
В контексте observability следует помнить:
- Мониторинг запросов: отслеживание времени выполнения запросов, количество возвращённых документов и журналов поиска указывает на узкие места.
- Балансировка нагрузки: при росте объёмов логов нужно масштабировать узлы Elasticsearch и дополнительные ноды Grafana, чтобы сохранить приемлемые задержки.
- Безопасность и соответствие: своевременная проверка прав доступа, аудит действий и контроль доступа к данным лога.
Key takeaways
- Loki и Elasticsearch - разные по архитектуре решения извлечения и анализа логов; выбор зависит от требований к метрикам и полнотекстовому поиску.
- Grafana обеспечивает эффективную интеграцию обоих источников, поддерживая мультиданные источники и единый UX для работы с логами.
- Архитектура Loki дает экономичное хранение и быструю агрегацию по меткам, тогда как Elasticsearch - мощный инструмент полнотекстового поиска и сложной фильтрации по полям.
- При проектировании дашбордов полезно сочетать оперативную диагностику (Loki) и глубинную аналитику (Elasticsearch), чтобы охватить всю цепочку «инцидент - контекст - решение».
- Оптимизация производительности требует баланса между размером чанков, кардинальностью лейблов и настройками индексов/пайплайнов.
- Безопасность и соответствие: внедрять минимальные привилегии, шифрование TLS и аудит действий, особенно при работе с чувствительной информацией в логах.
- Хорошие практики включают структурирование логов, использование единых схем именования полей, грамотное документирование дашбордов и регулярный аудит функциональности алертинга.
FAQ
- В каких случаях целесообразнее использовать Loki, а не Elasticsearch для логов?
- Loki оптимально подходит для сред с микросервисами и контейнерной инфраструктурой, где ключевой акцент делается на агрегацию по меткам и быстрый поиск по потокам. Он обеспечивает экономичное хранение при большом объёме логов и удобное ускорение ретенции через хранение индексов в объектном хранилище. Elasticsearch же полезен, когда необходим полнотекстовый поиск по тексту с сложными фильтрациями по полям и глубокий анализ по большему числу полей.
- Как выбрать стратегию индексации в Grafana для логов?
- В Loki применяйте кардинальность лейблов осознанно: выбирайте ключи лейблов, которые действительно помогают сегментировать потоки и сохранять упреждающее разделение. В Elasticsearch используйте индексы по времени (например, logs-YYYY.MM.DD) и планируйте ILM-политики, чтобы управлять размером и сроками хранения. В сочетании двух источников следует проектировать дашборды так, чтобы они не мешали друг другу и позволяли полноценно искать в Elasticsearch там, где нужен полнотекстовый поиск.
- Какие типичные узкие места встречаются при работе с дашбордами логов?
- Высокая кардинальность лейблов, медленные запросы к большому объёму данных, неэффективные pipelines при входящих логах и неподготовленные схемы индексации. Рекомендуется проводить профилирование запросов, ограничивать временные диапазоны в активных панелях и разделять логи по контексту.
- Как организовать структуру дашбордов для команд без риска пересечений и путаницы?
- Внедрять четкую схему именования источников, использовать переменные для сервисов и окружений, создавать унифицированные шаблоны панелей для Loki и Elasticsearch и обеспечить доступ к ним через роли в Grafana. Разделение дашбордов по доменам (инфраструктура, сервисы, безопасность) упрощает навигацию и ускоряет поиск.
- Какие практики безопасности следует соблюдать при работе с логами?
- Применяйте TLS для всех каналов передачи данных, реализуйте RBAC на уровне Grafana и кластера Elasticsearch, используйте ограничение доступа к данным по проектам, аудит используемых дашбордов и источников. Не храните в логах чувствительных данных без необходимости, используйте нормализацию и обогащение данных с фильтрацией.
- Как организовать ретенцию логов без риска потерять критическую информацию?
- В Loki - настроить соответствующую политику ретенции на основе кардинальности и времени жизни чанков; в Elasticsearch - применить ILM для автоматического rollover и архивирования старых данных. В дашбордах следует отделять долгосрочные журналы от оперативной информации и обеспечить доступ к кратким сводкам в режиме реального времени.
- Какие шаги при внедрении Loki в существующую инфраструктуру?
- Начать с централизованного сбора логов через Promtail или аналог, настроить первоначальные дашборды для быстрого обнаружения инцидентов, постепенно расширять покрытие сервисами и окружениями, минимизируя влияние на текущие сервисы и обеспечивая плавную миграцию. Важно обеспечить мониторинг потоков данных и корректную ретенцию.
- Как объединить логи с метриками и трассировками в Grafana?
- Используйте общий контекст через поля, такие как service, instance, и trace_id для корреляции. В Loki можно привязать логи к трасировкам через поля в сообщении или обогащение на стадии ingest, Elasticsearch - через поля в документах, связанные с трассировками. В дашбордах создавайте панели с синхронизированным временным диапазоном и общий набор фильтров.
- Какие ограничения стоит учитывать при работе с большими объёмами логов?
- Пределы памяти, задержки и требования к сеть; кардинальность меток в Loki; размер и количество индексов в Elasticsearch; необходимость горизонтального масштабирования и настройки кэширования. Важно тщательно планировать архитектуру, тестировать производительность запросов и регулярно пересматривать политики хранения.
- Какие шаги помочь команде внедрить практику observability на основе Loki и Elasticsearch?
- Определить требования к логам и KPI, выбрать набор сервисов и окружений, разработать схему именования полей и лейблов, внедрить базовые дашборды и алерты, наладить пайплайны ingest для Loki и Elasticsearch, провести обучение команд по LogQL и Lucene, организовать регулярные ревизии по производительности и качеству данных.
Глава завершается синергией архитектур Loki и Elasticsearch с Grafana: грамотное соединение полнотекстового поиска и структурированного представления лога, продуманная ретенция и оптимизация, а также ориентирование на процессы observability и устойчивость к росту объёмов данных.


