

Разработка приемника коннектора: вставка, upsert и обработка конфликтов
Приемник коннектора (destination) в рамках Airbyte отвечает за доставку данных в целевую систему хранения и аналитики. В рамках данной главы рассматриваются ключевые аспекты реализации приемника, которые обеспечивают корректную вставку данных, поддержку upsert-операций, а также методы обнаружения и разрешения конфликтов. Для Data Engineer важно не только реализовать базовую загрузку, но и обеспечить идемпотентность, контроль целостности и предсказуемость поведения системы при повторных запусках и задержках данных.
Глава ориентирована на практику архитектурных решений и паттернов реализации приемников, применимых к DWH Lakehouse и аналитическим системам. Рассматриваются принципы согласованности, выбор стратегий upsert, примеры SQL-операций и подходы к мониторингу и тестированию.
- Архитектура приемника: компоненты, API, транзакционность и параллелизм.
- Стратегии upsert: staging+merge, обработка конфликтов и tombstones, выбор подхода под конкретный Lakehouse.
- Реализация и интеграционные паттерны: интерфейсы, обработка ошибок, тестирование и мониторинг.
- Практические примеры и рекомендации по эксплуатации.
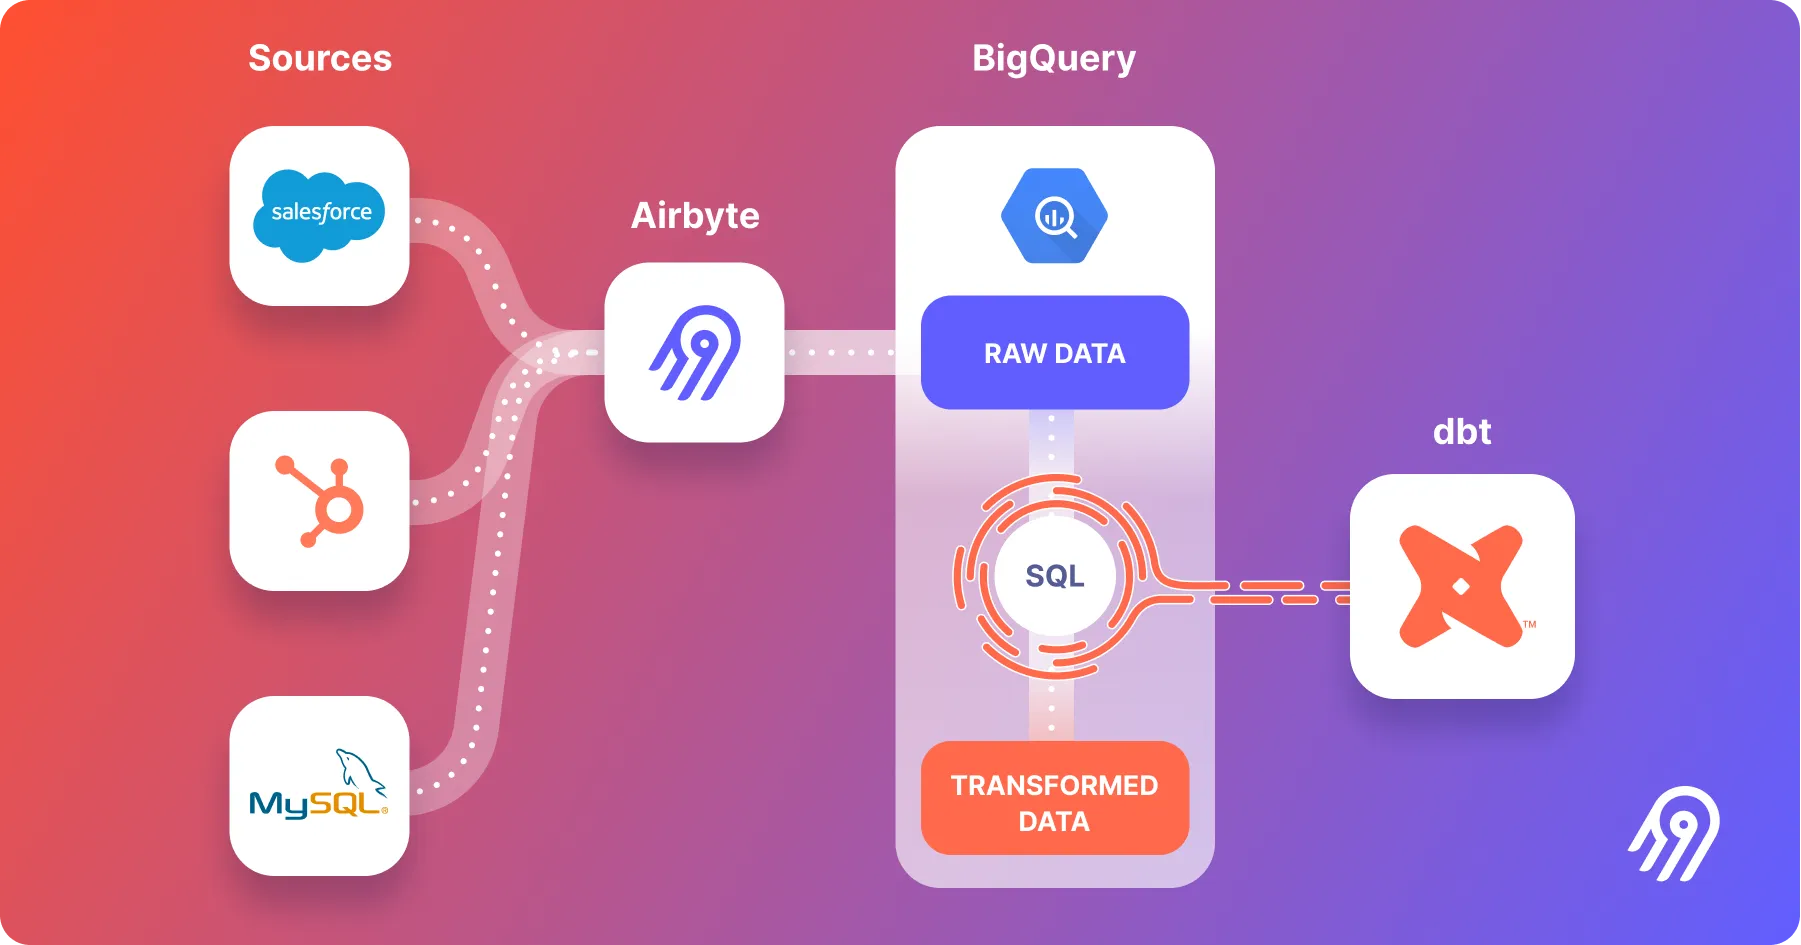
Архитектура приемника: вставка, upsert и конфликт-менеджмент
Цель приемника - обеспечить корректную загрузку данных в целевую систему и поддержать ясную семантику изменений: вставку новых записей, обновления существующих и удаление устаревших через tombstones, если источник передает такие сигналы. Архитектура приемника строится вокруг нескольких взаимосвязанных подсистем:
- интерфейс подключения и трансформации данных. На вход поступают ряды записей, которые приводятся к схеме целевой модели и ключам первичного/словарного типа.
- транзакционный движок записи. В зависимости от целевой платформы он реализует атомарность операций; в большинстве Lakehouse решений это достигается с помощью MERGE-операций или аналогичных механизмов.
- слой стейта и дедупликации. Хранение состояния инкрементальных загрузок, контроль дубликатов и повторных попыток.
- обработчик конфликтов. Определение правил разрешения конфликтов и их применение на уровне записи или группы записей.
- интеграционная логика. Точка входа Airbyte, конвейер по обработке micro-batches или streaming-потока и запись в целевую систему.
Необходимость идемпотентности обусловлена тем, что повторные попытки из-за временных сбоев не должны порождать дубликаты. В реальных сценариях конфликты становятся вероятными при задержках в источнике, переразмещении ключей или изменении данных между микробатчами. Архитектура приемника должна позволять откаты, повторные попытки и корректное разрешение конфликтов без потери целостности данных.
- Идемпотентность достигается за счет идентификаторов операций и воспроизводимости операции записи. В некоторых сценариях применима концепция “upsert по ключу” с детальным контролем обновляемых полей.
- Транзакционность достигается через использование возможностей целевой СУБД или движка Lakehouse для атомарного MERGE/UPSERT. В Snowflake, Delta Lake и аналогичных системах MERGE обеспечивает атомарность обновления ряда строк по условию.
- Порядок применения операций имеет критическое значение: сначала применяются обновления и удаления, затем вставки, чтобы избежать попыток вставки дубликатов по тем же ключам.
Подсистемы и их взаимодействие
- Слой маппинга схемы. Приводит входные поля к целевой схеме, разрешает несовпадения типов, нормализует значения и обогащает данные (например, добавляет временные метки).
- Буферизация и стадирования данных. Часто применяется staging-площадка, чтобы отделить формирование MERGE-операции от самого потока данных и обеспечить простоту повторного выполнения.
- Модуль стойкости состояния. Хранит последние успешные состояния загрузок, ключи по которым происходят апдейты, и параметры конфигурации.
- Модуль конфликтов. Выполняет определения конфликтов на уровне ключа или версии записи, применяет политики разрешения и формирует корректные результаты загрузки.
Архитектура должна быть совместима с подходами Airbyte: ресурсная частота запросов, обработка ошибок, повторные попытки и сохранение состояния. В частности, приемник должен уметь работать как в пакетном, так и в потоковом режимах, обеспечивая консистентность данных в обоих режимах.
Концепции согласованности и конфликтов
Концепция согласованности в приемнике зависит от выбранной стратегии upsert и требований к бизнес-логике. В типичных сценариях:
- Insert-only: простая загрузка новых записей без обновления существующих. Максимальная производительность, минимальная сложность, но ограниченная полезность для источников, которые отражают изменения.
- Upsert: обновление существующих записей по ключу и добавление новых. Такой режим предпочтителен для DWH Lakehouse и аналитических систем.
- Delete/soft delete: поддержка удаления через tombstones или через специальный флаг, когда источник сообщает об удалении записи.
Ключевые концепции:
-
Идентификационные ключи. Основной механизм сопоставления записей. В большинстве случаев это первичный ключ целевой таблицы. В некоторых сценариях применяются surrogate keys и декорированные версии записей.
-
Версионность и временные метки. Включение временных меток обновления позволяет разрешать конфликты и отслеживать историю изменений. Это особенно важно для поздних приходов и повторных запусков.
-
Конфликт-правила. В качестве политики можно выбрать:
- последняя запись по временной метке (last-writer-wins);
- правила обновления, когда обновляется набор полей;
- конфликт-детерминированная комбинация по ключам и версиям;
- запрет конфликтов и возврат ошибок для последующей коррекции источником.
-
Tombstones и удаление. Если источник передает удаление, приемник должен либо пометить запись как удалённую, либо physically удалить запись, либо использовать tombstone-метку и позже очистить.
Выбор политики должен основываться на требованиях к консистентности, задержкам в источнике и специфике целевой платформы. В одном проекте может быть разумна комбинация политик: использовать собственную версию записи для некоторых полей и tombstones для удаления, в то время как другие поля обновляются через MERGE.
Стратегии выполнения upsert в DWH Lakehouse
Существуют несколько конкретных подходов, которые применяются для реализации upsert в DWH Lakehouse. Выбор зависит от поддерживаемых возможностей целевой платформы (Snowflake, Delta Lake, BigQuery и т. д.), объема данных и требований к latency.
-
Стратегия 1: staging + MERGE
- Применяется чаще всего. В начале данные пишутся во временную staging-темповую таблицу, которая повторно загружается без риска порчи целевой таблицы.
- Затем выполняется MERGE целевой таблицы с staging-таблицей по ключу. При совпадении - обновляются заданные поля, при отсутствии - вставляются новые.
- Преимущества: понятность, контроль над процессом, легкость тестирования.
- Ограничения: дополнительная копия данных, необходимость управлять двумя таблицами.
MERGE INTO target_table AS t
USING staging_table AS s
ON t.id = s.id
WHEN MATCHED THEN UPDATE SET
  t.col1 = s.col1,
  t.col2 = s.col2,
  t.updated_at = s.updated_at
WHEN NOT MATCHED THEN INSERT (id, col1, col2, updated_at)
VALUES (s.id, s.col1, s.col2, s.updated_at);
-
Стратегия 2: direct upsert через MERGE в Lakehouse
- В некоторых системах (Delta Lake, современный Snowflake) поддерживаются прямые upsert без промежуточной стадии.
- Прямой MERGE уменьшает задержки и упрощает управление состоянием, но требует аккуратной настройки согласованности и обновления статистики.
- Преимущества: меньшая задержка, меньшее число операций.
- Ограничения: риск конфликтов при параллельной загрузке, необходимость строгих контроля ключей.
MERGE INTO target_table AS t
USING incoming_table AS s
ON t.id = s.id
WHEN MATCHED THEN UPDATE SET
  t.col1 = s.col1,
  t.col2 = s.col2,
  t.updated_at = s.updated_at
WHEN NOT MATCHED THEN INSERT (id, col1, col2, updated_at)
VALUES (s.id, s.col1, s.col2, s.updated_at);
-
Стратегия 3: staging + deletes + inserts для сложной консистентности
- При наличии сложной бизнес-логики обновления и помимо изменений в полях, необходимо явно обрабатывать удаление и восстановление связей.
- Модуль обрабатывает удаление как tombstone и затем удаляет физически или помечает удаление, а затем выполняет вставку новых версий.
- Применяется для систем, где история изменений критична.
-
Стратегия 4: версионирование записей и CDC-архитектуры
- В некоторых сценариях полезна версия записей (versioning) и использование CDC-платформы. Это позволяет не только upsert, но и восстановить историю по версиям.
- Хорошо сочетается с Lakehouse-архитектурами, где поддерживается временная таблица и архив.
Выбор стратегии должен быть согласован с требованиями к латентности, нагрузке и прозрачности процессов. В большинстве проектов предпочтение отдается staging+MERGE, поскольку обеспечивает явную контрольную точку и упрощает тестирование.
Реализация и паттерны: интерфейсы, код и интеграции
Реализация приемника включает определение контрактов интерфейсов, преобразование данных и выполнение операций записи. В контексте Airbyte важно обеспечить совместимость с его моделями потоков и состоянием коннектора.
-
Интерфейс и контракт. Приемник должен принимать записи в виде унифицированной структуры, приводить их к целевой схеме, резолвить конфликты и обеспечивать атомарность операций записи. Важны:
- идентификационные ключи по целевой таблице;
- определение набора полей, которые участвуют в обновлениях;
- поддержка tombstones для удалений;
- сохранение состояния загрузки и возможность повторного выполнения.
-
Преобразование схем. Часто требуется адаптация типов данных к целевой СУБД. Например, преобразование TIMESTAMPNTZ в подходящий формат, конвертация строковых столбцов и нормализация значений.
-
Производственный процесс. Обычно реализация состоит из шагов:
- загрузка данных в staging;
- верификация согласованности записей;
- выполнение MERGE/UPSERT;
- обновление состояния и уведомление Airbyte.
-
Примеры кода и паттерны.
Приведенные примеры ниже иллюстрируют концепции, а не являются готовой реализацией. В реальном проекте код следует адаптировать под конкретную СУБД и стек технологий.## Псевдокод Python-подхода к реализации MERGE-уп upsert def upsert_batch(conn, target_table, staging_table, key_cols, update_cols): merge_sql = f""" MERGE INTO {target_table} AS t ## USING {staging_table} AS s ON {" AND ".join([f\"t.{k}=s.{k}\" for k in key_cols])} ## WHEN MATCHED THEN UPDATE SET {', '.join([f\"t.{c}=s.{c}\" for c in update_cols])}, t.updated_at = CURRENT_TIMESTAMP() WHEN NOT MATCHED THEN INSERT ({', '.join([ 'id'] + update_cols)}) VALUES ({', '.join(['s.' + c for c in ['id'] + update_cols])}) """ conn.execute(merge_sql)Пример демонстрирует базовую схему MERGE: сопоставление по ключу, обновление полей и вставку новых записей. В реальной реализации следует учитывать:
- обработку ошибок и повторные попытки;
- надежность обработки специальных значений (NULL, пустые строки);
- параллелизм и координацию между несколькими параллельными потоками загрузки;
- мониторинг и логирование результатов MERGE-операций.
-
Интеграция с Airbyte. Для поддержки жизни коннектора в рамках Airbyte необходимы:
- правильная обработка состояния; сохранение позиции в источнике;
- корректная обработка дубликатов и конфликтов в рамках каждого пакета;
- возможность повторного выполнения только той части загрузки, которая была неуспешной.
-
Безопасность и доступ. Важно обеспечить минимальные привилегии для приемника в целевой системе, ограничить права на чтение метаданных и выполнение операций MERGE в рамках заданной схемы.
Мониторинг, тестирование и эксплуатация
Мониторинг приемника включает отслеживание следующих метрик:
- латентность загрузки: задержка между поступлением записи и ее записью в целевую таблицу;
- пропускная способность: количество записей в единицу времени;
- частота конфликтов и повторных попыток;
- доля успешных MERGE-операций против общего числа операций;
- дубликаты и несоответствия, возникающие при задержках источника;
- устойчивость к сбоям: время восстановления после ошибок и среднее время до восстановления (MTTR).
Тестирование следует разделить на несколько уровней:
- юнит-тесты на слой маппинга и трансформации, чтобы убедиться, что данные приводятся к нужной схеме.
- интеграционные тесты для MERGE-процессов на тестовой копии целевой базы, с имитацией задержек источника и конфликтов.
- нагрузочные тесты для оценки поведения на больших объемах и в условиях параллельной загрузки.
- регрессионные тесты, которые проверяют, что обновления ключевых полей не ломают существующую логику.
Рекомендованы следующие практики эксплуатации:
- использовать staging-площадки и контроль над транзакциями, чтобы упростить повторный запуск без риска дублирования данных.
- включать версионирование ключевых записей (например, через field version) для облегчения разрешения конфликтов.
- устанавливать политики очистки tombstones и архивирования устаревших данных, чтобы контроль памяти и хранение истории оставались управляемыми.
- организовать централизованный мониторинг и алерты: уведомления о превышении пороговых значений задержки, конфликтов и ошибок.
Key takeaways
- Приемник Airbyte для вставки и upsert должен быть идемпотентным, транзакционным и корректно обрабатывать конфликты и удаления.
- Стратегия staging+MERGE является универсальным и контролируемым подходом для большинства Lakehouse-платформ.
- Правильные политики конфликтов и tombstones критичны для сохранения целостности данных и согласованности анализа.
- Архитектура приемника должна быть модульной: маппинг схем, буферизация, конфликт-менеджмент и слой записи в целевую систему.
- Тестирование и мониторинг процессов загрузки обеспечивают надёжность и предсказуемость операций.
- Важно проектировать приемник в тесном контакте с требованиями целевой платформы (Snowflake, Delta Lake и т. п.) и бизнес-логикой.
- Примеры MERGE-операций иллюстрируют практические подходы к реализации upsert и позволяют проверить сценарии вставки, обновления и удаления.
FAQ
- Что такое идемпотентность в приемнике Airbyte и зачем она нужна?
Идемпотентность означает, что повторный запуск операции записи после сбоя приводит к тем же результатам, что и первый запуск, без создания дубликатов или изменений в данных. Она необходима из-за возможных повторных попыток из-за сетевых сбоев, пауз в источнике или повторной передачи пакетов. Чтобы обеспечить идемпотентность, применяют детерминированные ключи, staging-площадки и атомарные MERGE-операции, а также хранение состояния, позволяющее повторно выполнить только неуспешные части загрузки.
- Какие ключевые различия между вставкой и upsert-операцией в приемнике?
Вставка добавляет новые записи, не затрагивая существующие, что проще реализовать и обеспечивает высокую пропускную способность. Upsert объединяет вставку и обновление: если запись с заданным ключом уже существует, она обновляется; иначе - вставляется новая. Upsert особенно важен для DWH Lakehouse, где бизнес-логика требует отражения изменений источника и консистентности данных. Реализация upsert требует использования MERGE или аналогичных механизмов, а также контроля конфликтов и версий.
- Какие существуют паттерны реализации upsert в Snowflake и Delta Lake?
- Snowflake: MERGE INTO target USING staging ON (ключи) WHEN MATCHED THEN UPDATE ... WHEN NOT MATCHED THEN INSERT ...
- Delta Lake: MERGE INTO target USING source ON (ключи) WHEN MATCHED THEN UPDATE SET ... WHEN NOT MATCHED THEN INSERT ...
Оба паттерна обеспечивают атомарность обновления и вставки. Выбор зависит от latency и параллелизма; staging-подход часто проще для тестирования и мониторинга, прямой MERGE может дать меньшую задержку, но требует более точной синхронизации потоков.
- Как обрабатывать конфликтные записи в приемнике?
Конфликты возникают, когда две или более записи относятся к одному ключу, но содержат противоречивые данные. Политика конфликтов должна быть определена заранее: last-writer-wins по временной метке, обновление конкретных полей по правилам бизнес-логики, или выбраковка конфликта и возврат ошибки. В реальных системах часто применяют комбинированный подход: использовать временные метки для выбора версии записи и ограничивать обновления определенными полями.
- Как обеспечить консистентность при параллельной загрузке?
Параллельная загрузка может привести к гонкам за записью по тем же ключам. Решение - использование транзакционных MERGE-операций на уровне целевой базы, ограничение параллелизма на уровне источника данных, применение очередей и координации между потоками. Также полезно разделять данные по ключам на партиции и записывать в целевую таблицу через единый монолитный конвейер для одного ключа в рамках одной транзакции.
- Какие тесты стоит применять для приемника с upsert?
- тесты на корректность маппинга схем и типов;
- тесты идемпотентности через повторные запуски;
- тесты конфликтов и их разрешения;
- тесты обработки удалений (tombstones) и архивации;
- нагрузочные тесты на крупных объемах и параллельных потоках;
- тесты интеграции с целевой платформой (Snowflake/Delta Lake).
- Какие метрики важны для мониторинга приемника?
- задержка записи (latency) и задержка между источником и целевой системой;
-Throughput (заявленная скорость загрузки); - доля удачных MERGE-операций;
- число конфликтов и повторных попыток;
- доля дубликатов;
- время восстановления после сбоев (MTTR);
- ошибки преобразования схемы и ошибки данных.
- Каковы рекомендации по безопасности и управлению доступом?
При реализации приемника следует минимизировать привилегии в целевой системе: ограничить права на выполнение MERGE в рамках только нужной схемы и таблицы, запретить лишние DDL-операции, обеспечить аудит и журналирование. Механизмы безопасной передачи данных, шифрование в покое и в транзите, а также контроль доступа к staging-таблицам помогают снизить риски.
- Что делать при задержках источника, приводящих к конфликтам?
Задержки источника приводят к несогласованности данных между микробатчами. Решение - хранение версии данных, применение временных меток и версиях, повторные попытки загрузки только для неуспешных записей, а также настройка политики retention и закупоривание старых версий. В некоторых случаях полезно реализовать периодическую реорганизацию и реиндексацию целевых таблиц.
- Есть ли готовые примеры на открытом или российском рынке?
На открытом рынке встречаются реализации по базовым паттернам и образцам из документации Airbyte и официальных коннекторов. Российские решения чаще всего представлены в рамках специализированных консорциумов и клиентов, где применяются локальные практики мониторинга и обеспечения безопасности. В рамках главы рассмотрены общие паттерны и безопасная интеграция с Snowflake и Delta Lake как типовые примеры, которые можно адаптировать под локальные требования.


