

Масштабирование и зрелость инфраструктуры данных: горизонтальное масштабирование, устойчивость
Современная инфраструктура данных требует не только корректной организации загрузки данных, но и способности расти вместе с объемами источников, сложностью обработок и требованиями к надежности. В рамках курса «Airbyte для Data Engineer» эта глава посвящена тому, как проектировать горизонтальное масштабирование коннекторов и пайплайнов, обеспечивать устойчивость систем и эффективно интегрироваться с DWH Lakehouse и аналитическими системами. Рассматриваются архитектурные принципы, паттерны реализации и практические рекомендации, подкрепленные примерами конфигураций и подходами к мониторингу и управлению жизненным циклом инфраструктуры.
Постановка задачи масштаба в контексте Airbyte опирается на сочетание распределенного исполнения коннекторов, общей архитектуры сервиса Airbyte, буферизации, контроля версий конвейеров и согласованности данных. Важно не только увеличить пропускную способность, но и сохранить предсказуемость задержек, повторяемость результатов и возможность оперативной реакции на инциденты. В этом плане ключевыми становятся: разделение вычислений и хранения состояния, выбор подходящих стратегий параллелизации и ретраев, а также грамотная настройка взаимодействия с Lakehouse-слоем.
- Архитектура и принципы горизонтального масштабирования коннекторов и пайплайнов Airbyte
- Устойчивость пайплайнов: ретраи, идемпотентность и управление сбоями
- Интеграция с DWH Lakehouse и аналитическими системами: схемы данных, версии моделей и управление качеством данных
- Конфигурация, автоматизация развертываний и управление жизненным циклом инфраструктуры
- Путь к зрелости: планирование трансформаций, контроль затрат и эволюционные этапы
Архитектура и принципы горизонтального масштабирования коннекторов Airbyte
Успех масштабирования начинается с архитектурной модели, где расчленение по горизонтали обеспечивает независимость и возможность параллельного выполнения. В Airbyte горизонтальное масштабирование достигается за счет распределения коннекторов и потоков обработки по нескольким воркерам и узлам кластера. В типичной реализации серверная часть Airbyte отвечает за оркестрацию синхронизаций, а воркеры выполняют конкретные коннекторы источников и приемников. Такое разделение позволяет добавлять новые узлы в кластер, не нарушая текущие потоки данных.
Ключевые принципы включают:
- Stateless-выполнение воркеров: каждый воркер должен быть самодостаточным и не хранить внутреннее состояние между запусками. Состояние хранится в централизованной БД Airbyte или in-memory кэшах при наличии устойчивого решения к сбоям. Это облегчает горизонтальное масштабирование и упрощает эвристику восстановления.
- Разделение по потокам и источникам: параллелизация достигается за счет обработки нескольких потоков внутри коннектора и параллельного прогона нескольких коннекторов. Встроенные параметры конфигурации позволяют задать максимальное число параллельных потоков и коннекторов, что критично для удержания задержек в пределах SLA.
- Эластичность через оркестрацию: Kubernetes или аналогичная система оркестрации обеспечивает автоматическое масштабирование по нагрузке. Helm-чарты и манифесты Deployments/HPA позволяют адаптивно прибавлять реплики воркеров и серверной части.
- Изоляция ресурсов и QoS: для каждого коннектора выделяются лимиты CPU и памяти, чтобы перегрузка одного коннектора не влияла на другие. Это особенно важно в environments с bursting-подходом или непредсказуемой корреляцией источников.
- Централизованное хранение метаданных и состояния: индекс состояния и логика инкрементальных обновлений хранятся в базе данных Airbyte или в специализированном хранилище, что обеспечивает консистентность между копиями воркеров и повторяемость прогонов.
Эти принципы переходят к практике через конфигурацию кластеров и специфику развёртываний. В реальных условиях рекомендуется начинать с разумного числа воркеров при сохранении контроля над ресурсами, затем постепенно увеличивать масштаб, применяя автоскейлинг и мониторинг. Важную роль здесь играет выбор среды исполнения: Kubernetes позволяет легко реализовать горизонтальное масштабирование, управление трафиком и автоматическое восстановление.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: airbyte-worker
spec:
  replicas: 3
  selector:
    matchLabels:
      app: airbyte-worker
  template:
    metadata:
      labels:
        app: airbyte-worker
    spec:
      containers:
      - **name**: airbyte-worker
        image: airbyte/airbyte:0.x.y
        resources:
          requests:
            memory: "4Gi"
            cpu: "1000m"
          limits:
            memory: "8Gi"
            cpu: "2000m"
        env:
        - **name**: AIRBYTE_CONFIG
          value: "/config"
        - **name**: AIRBYTE_MAX_WORKERS
          value: "8"
        volumeMounts:
        - **name**: config
          mountPath: /config
      volumes:
      - **name**: config
        configMap:
          name: airbyte-config

apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: airbyte-worker-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: airbyte-worker
  minReplicas: 3
  maxReplicas: 12
  metrics:
  - **type**: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
В приведённых конфигурациях иллюстрируются принципы: реплики воркеров масштабируются по нагрузке, ресурсы ограничены и управляются автоматически. Важно помнить: масштабирование должно сопровождаться контролем задержек и мониторингом. Порой разумнее ограничить параллелизм для отдельных коннекторов, чтобы не перегружать DWH или внешние источники, особенно в периоды пиковых загрузок.
Для многих сценариев имеет смысл использовать специализированные коннекторы и контейнеры, поддерживающие кастомизацию потоков и уровня параллелизма. В частности, можно разграничить по группам: источники с высокой задержкой и узкими каналами пропускной способности - меньшая параллельность; источники с широкими потоками - большая. Такой подход позволяет добиться сбалансированного распределения нагрузки без перегрузки зеркальных систем.
Архитектурно важно учитывать этапы загрузки: чистая конвейерная цепочка включает источники, конвертацию/нормализацию, загрузку в промежуточный буфер и последующую загрузку в Lakehouse. При масштабировании следует стабильно поддерживать пропускную способность на каждой стадии, избегая узких мест. Прямой путь к пропускной способности, как правило, лежит через параллелизм на уровне источников и потоков, а также через правильную настройку очередей и буферов между стадиями.
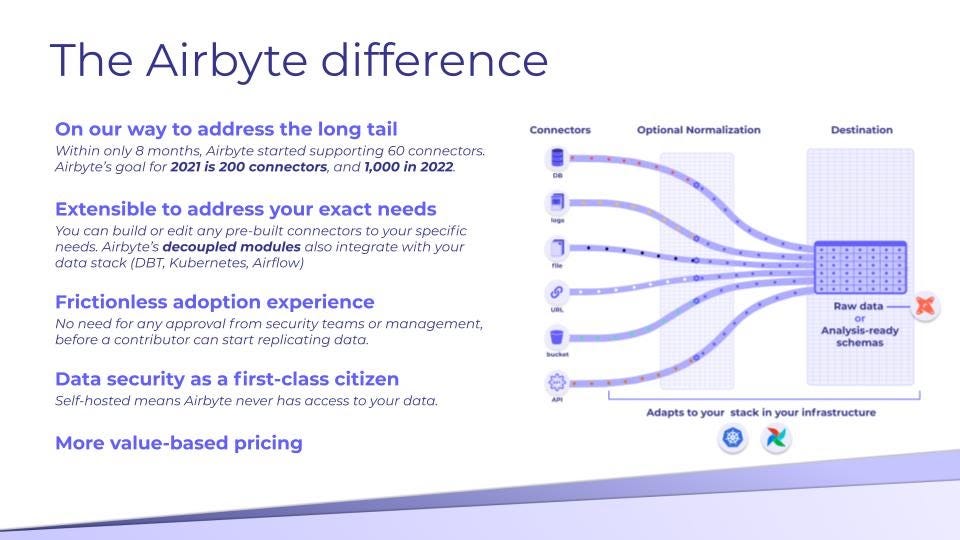
Управление устойчивостью пайплайнов: ретраи, идемпотентность и управление сбоями
Надежность данных требует построения устойчивых пайплайнов, которые корректно обрабатывают временные сбои, сетевые задержки и сбои источников. Основные принципы включают:
- Ретрай и экспоненциальная задержка: при неудаче коннектор должен повторно попытаться выполнить операцию с возрастающим временем ожидания. Важно ограничить максимальное количество попыток и обнародовать отдельный полезный сигнал об отказе, чтобы не «залипать» в бесконечных повторениях.
- Идемпотентность писем к целевой системе: повторные записи должны приводить к одинаковому результату без дублирования. Для Lakehouse это означает применение механизмов upsert/merge и корректную обработку ключей на уровне модели данных.
- Управление сбоем через Dead Letter Queue (DLQ): источники, которые не удалось обработать, направляются в DLQ для последующего анализа. Это предотвращает зависание конвейера и позволяет отделить проблемы источника от последующих шагов.
- Контроль версий и повторяемость: хранение версий схем и миграций конвейера, чтобы при откате можно было воспроизвести последовательность изменений. Это критично для аудита и расследования инцидентов.
- Мониторинг задержек и SLA: мониторинг времени прохождения данных по каждому конвейеру, а также отслеживание метрик успешных/неуспешных прогонов. SLA-зу, которые помогают определить пороговые значения для алертинга.
- Поддержка согласованности и качество данных: в Lakehouse и аналитических системах часто требуется проверка согласованности в различных зонах, а также автоматическая валидация качества. Встраивание проверок на входе/выходе помогает удерживать качество на приемлемом уровне.
Праксически устойчивость достигается через сочетание ретраев и ограничений, а также через проектное мышление о границах повторяемости. В контексте Airbyte это означает точную настройку параметров параллелизма и ретраев для каждого коннектора, а также корректную обработку состояний синхронизации. Важной частью является архитектура повторной загрузки в Lakehouse: когда повторная загрузка выполняется повторно, результаты должны оставаться корректными. Это достигается за счет детального учёта состояния и правильной реализации механизмов обновления данных в целевой системе.
Мониторинг устойчивости предполагает использование инструментов наблюдаемости: сбор метрик и логов, трассировку процессов, построение дашбордов. Рекомендовано применять OpenTelemetry или аналогичные решения для трассировки критических путей. Окружение должно иметь согласованную схему логирования, единый формат и централизованный поиск инцидентов. В рамках дашбордов полезно отображать такие параметры, как задержка между источником и Lakehouse, процент успешных прогонов, частота ретраев и среднее время до восстановления после сбоя.
Кроме того, для устойчивости полезно внедрять концепцию «поставщика качества» на границе слоя данных. Это означает, что внешние источники и внутренние конвейеры имеют четко определённые контракты по формату, задержке и гарантии доставки данных. В Airbyte это достигается через прописывание контрактов на уровне каталогов коннекторов, использование схем совместимости и фиксирование ограничений по версии коннектора и схеме данных.
## Пример конфигурации ретраев и ограничений в конфигурации коннектора (псевдокод)
{
  "retry": {
    "enabled": true,
    "maxAttempts": 5,
    "backoffMs": 2000,
    "backoffStrategy": "exponential"
  },
  "idempotency": {
    "enabled": true,
    "strategy": "upsert",
    "uniqueKey": ["id"]
  },
  "dlq": {
    "enabled": true,
    "destination": "kafka-dlq-topic"
  }
}
Управление устойчивостью требует тесной интеграции между конфигурацией коннекторами, мониторингом и процессами эксплуатации. В практической плоскости это означает:
- Чёткую инициализацию коннекторов с параметрами ретраев и ограничений по времени;
- Наличие DLQ и процессора для автоматического анализа без влияния на основной конвейер;
- Инструменты для анализа причин сбоев, включая трассировку, логи и метрики;
- Встроенные проверки качества данных на входе и выходе, чтобы вовремя выявлять аномалии.
Эти принципы являются фундаментом для устойчивых систем, особенно в условиях растущего объема данных и усложнения источников.
Интеграция с DWH Lakehouse и аналитическими системами: схемы данных, версии, качество
Интеграция с Lakehouse требует согласованной стратегии моделирования данных, контроля версий схем и поддержки эволюции схем без прерывания бизнес-процессов. В контексте Airbyte ключевые практики включают:
- Архитектура «raw → curated»: данные сначала попадают в «сырой» слой Lakehouse, затем проходят шаги унифицирования, нормализации и обогащения. Это позволяет сохранить источник и одновременно готовить данные к аналитике и моделированию.
- Согласование моделей данных: коннекторы должны поддерживать версионность схем. При изменении структуры источника система должна автоматически воссоздать миграцию в Lakehouse, сохранив совместимость с существующими пайплайнами.
- Управление временем и версиями данных: хранение временных штампов/инкрементных маркеров и обеспечение возможности детектирования изменений схем и данных. В Lakehouse важны версии таблиц, патчи и механизмы проверки целостности.
- Обеспечение качества и валидности данных: интеграция с инструментами валидации данных (например, Great Expectations) для автоматической проверки соответствия данных нормативам, контрактам и бизнес-правилам.
- Эффективная загрузка в Lakehouse: использование таблиц типа апдейтов/upserts и соблюдение транзакционных гарантий на уровне дата-слоя. Важно поддерживать корректную обработку ключевых полей и денормализационных связей, чтобы избежать дублирования и конфликтов.
- Версионность конвейеров и каталога коннекторов: хранение версии схем, конфигураций и каталогов коннекторов в системе контроля версий и CI/CD.
При проектировании интеграции с DWH Lakehouse следует помнить о следующих паттернах:
- Разграничение зон хранения: «raw» зона для неагрегируемых данных, «bronze/silver/gold» для поэтапной обработки и агрегаций. Такой подход упрощает управление качеством и эволюцию схем.
- Архитектура событий и CDC: если источники поддерживают CDC, стоит аккуратно регулярно захватывать изменения и минимизировать задержки между источником и Lakehouse. Это критично для аналитических сценариев в реальном времени.
- Прогнозирование затрат на хранение и обработку: Lakehouse often involves cost considerations for data retention, compaction, and query efficiency. Планирование partitioning strategy, compaction windows и файла-нарезки помогает управлять затратами и задержками.
С точки зрения инструментов и экосистем, в рамках курса можно ориентироваться на две концептуальные группы: открытые решения для обработки схем и версий (например, Apache Iceberg/Delta Lake) и интеграционные подходы в рамках Airbyte. В качестве примера можно рассмотреть подходы к хранению «raw» и «calculated» слоев и согласование схем через каталог коннекторов, где каждый коннектор имеет версию и контракт поля. В реальности многие организации комбинируют Lakehouse-платформы (Delta Lake, Apache Iceberg) с Airbyte для обеспечения надежной загрузки и адаптации к изменениям источников.
Для управления эволюцией схем и версий полезны практики:
- Регистрация изменений в каталоге изменений и автоматическая миграция схем при развертывания;
- Контроль версий ETL-процессов и коннекторов через CI/CD;
- Тестирование миграций на staging/разделенных окружениях перед выпуском в продакшн.
В контексте практических сценариев архитектура данных часто предполагает наличие «непосредственной» загрузки сырых данных в Lakehouse, затем последовательную обработку и агрегацию. В этом процессе Airbyte обеспечивает надежную доставку и источник изменений, а Lakehouse - эффективную и управляемую аналитическую площадку. Важно поддерживать согласованность между слоями, чтобы данные в curated-зонах точно отражали реальные бизнес-события и могли использоваться для продвинутой аналитики, предупреждения и моделирования.
Конфигурация, автоматизация развёртывания и управление жизненным циклом инфраструктуры
Эффективное масштабирование требует дисциплины в развёртывании, конфигурации и обновлениях. Рекомендованные подходы:
- Инфраструктура как код (IaC): управление кластерами Airbyte и связанной инфраструктурой через Terraform, Helm-чарты и YAML-манифесты. Это обеспечивает воспроизводимость и удобство аудита изменений.
- GitOps и CI/CD: хранение конфигураций и каталогов коннекторов в репозиториях, автоматическое тестирование и развёртывание через пайплайны. В случаях аварийных ситуаций решение об откате должно быть формализовано.
- Тестовая среда и тесты миграций: создание staging-окружения для проверки изменений коннекторов, схем и политик ретраев. В тестовой среде должны выполняться проверки функциональности, производительности и устойчивости под нагрузкой.
- Управление секретами и безопасностью: использование Kubernetes Secrets, Vault или аналогичных инструментов для безопасного хранения конфигураций и ключей доступа. Регулярный ревью правил RBAC и сетевой сегментации.
- Построение мониторинга и алертинг: сбор метрик о задержках, успехах и ретраях, а также логгирование событий. В качестве инструментов мониторинга полезно использовать Grafana/Prometheus, OpenTelemetry и интеграции с системами оповещения.
- Контроль качества изменений: публикация изменений в каталоге коннекторов и конфигураций с пометками «minor/major», чтобы потребители могли планировать обновления и оценивать риск миграций.
Реализация этих практик требует сформированной методологии DevOps для данных, которая охватывает управление изменениями, тестирование и прозрачность. В конкретных реалиях Airbyte это может включать следующие шаги:
- Поддержка версий Catalog и коннекторов: каждый коннектор имеет версию и конкретные параметры конфигурации. Изменения в каталоге должны быть согласованы с бизнес-объектами, ответственными за данные.
- Тестирование совместимости: автоматизированные тесты для проверки совместимости новых версий коннекторов с целевой Lakehouse и существующими пайплайнами.
- Резервное копирование и откат: политики резервного копирования состояния коннекторов и конфигураций, а также готовность к откату до стабильной версии в случае инцидентов.
Примеры конфигураций и практик CI/CD можно дополнить документацией по конкретной инфраструктуре организации. В реальном проекте полезно разворачивать простые Canary-плавающие обновления для коннекторов, чтобы минимизировать риск прерывания бизнес-процессов и оперативно выявлять регрессии. Важно также поддерживать актуальные инструкции по обновлениям, чтобы инженеры данных могли быстро выполнять миграции в безопасном режиме.
Модель зрелости и план действий на этапе трансформации
На этапе масштабирования и зрелости инфраструктуры следует определить дорожную карту изменений, которая учитывает не только техническую сторону, но и организационные факторы. Примерная дорожная карта может включать этапы:
- Этап 1 - основы масштабируемости: настройка горизонтального масштабирования, базовые политики ретраев и мониторинга; запуск на ограниченном наборе коннекторов с прогнозируемыми источниками.
- Этап 2 - устойчивость и управление качеством: внедрение DLQ, идемпотентности, тестирования миграций и расширенного мониторинга; построение первого слоя автоматических уведомлений об инцидентах.
- Этап 3 - интеграция Lakehouse: выстроение «raw/curated» архи-тектуры, согласование версий схем и внедрение валидаций данных; улучшение управления версиями коннекторов.
- Этап 4 - управляемость затратами и CI/CD: усиление IaC, GitOps, Canary-обновления; формализация процессов изменения и аудита.
- Этап 5 - зрелость операционных практик: единые стандарты для мониторинга, логирования, тестирования и обучения команд; постоянное улучшение по метрикам качества.
- Этап 6 - масштабирование по бизнес-юнитам: внедрение автономных команд по данным, внедрение политики доступности и соответствия, развитие архитектурных паттернов для различных доменов.
- Этап 7 - управляемость данными и безопасностью: внедрение продвинутых механизмов защиты, контроля доступа, соответствия нормам и регламентам.
Эта дорожная карта должна дополняться конкретными KPI: пропускная способность конвейеров, средняя задержка, процент промахов по SLA, доля успешных прогонов, время до обнаружения и устранения инцидентов, стоимость обработки единицы данных и прочие показатели. Важной частью является непрерывное обучение команд данными и дисциплина DevOps для данных. По мере роста организации возрастает роль внутренней методологии: стандартизации процессов, документирования контрактов между источниками и целевыми системами, а также выработки политики совместной эксплуатации (SRE для данных).
Стратегия зрелости ориентирована на минимизацию риска, обеспечение согласованности и предсказуемости результата. Это достигается через структурированное планирование, обеспечение требований к качеству данных и механизмов возврата к устойчивости. В рамках курса особенно важно уметь переводить технические решения в управляемые процессы: внедрять автоматизацию, поддерживать документацию и обучать команды работать в единой экосистеме. В итоге такая зрелость позволяет не только выдерживать пиковые нагрузки, но и ускорять доставку аналитической ценности бизнесу.
Key takeaways
- Горизонтальное масштабирование коннекторов Airbyte достигается за счет распределения воркеров, разделения по потокам и использования оркестрации (Kubernetes) с учётом ресурсов и изоляции.
- Устойчивость конвейеров строится через ретраи с экспоненциальной стратегией, идемпотентность записей, DLQ и контроль версий схем для обеспечения повторяемости и качества данных.
- Интеграция с Lakehouse требует архитектуры raw/curated, управления версиями схем и внедрения процедур качества данных и миграций.
- IaC и GitOps упрощают управление масштабируемой инфраструктурой: предсказуемость, воспроизводимость и возможность безопасного обновления.
- Дорожная карта зрелости должна сочетать технические практики с организационными изменениями: стандарты, обучение команд, контроль затрат и управление изменениями.
- Эффективная система мониторинга и алертинга обеспечивает раннее выявление инцидентов и эффективное реагирование без снижения производительности пайплайнов.
- Взаимодействие между коннекторами и DWH Lakehouse должно быть спроектировано так, чтобы изменения схем и данных не нарушали существующие аналитические сценарии и бизнес-процессы.
FAQ
- Какие ключевые параметры следует настраивать для эффективного горизонтального масштабирования Airbyte?
- Необходимо учитывать количество параллельных потоков, ограничение ресурсов (CPU, память) для каждого воркера, а также лимит на число одновременных коннекторов. В Kubernetes это реализуется через параметры Deployment (replicas, ресурсы) и Horizontal Pod Autoscaler. Важно мониторить задержки и пропускную способность, чтобы не приводить к перегрузке целевых систем и источников.
- Какую роль играет DLQ в устойчивости конвейера и как её настраивать?
- DLQ служит буфером для неподдающихся обработке сообщений, что предотвращает блокировку основного конвейера. В Airbyte это позволяет независимо анализировать источники ошибок и не мешать текущим прогоном. Настройка DLQ должна быть связана с процедурами анализа ошибок, уведомлениями и автоматическим повтором на стадии переработки.
- Какие практики полезны для обеспечения идемпотентности при загрузке в Lakehouse?
- В ключевых полях данных предусмотреть уникальные ключи и конфликты разрешать через upsert-операции. Убедиться, что повторные прогоны не приводят к дублированию. В архитектуре рекомендуется применение компонент, которые поддерживают уникальные идентификаторы и детерминированное поведение при повторной загрузке.
- Как выбрать баланс между параллелизмом коннектора и стабильностью целевой системы?
- Важно проводить нагрузочные тестирования и устанавливать пороги на пропускную способность целевого слоя, а также ограничивать параллелизм для «чувствительных» источников. Оптимальная конфигурация достигается через постепенное увеличение параллелизма с мониторингом задержек и ошибок, чтобы избежать перегрузки Lakehouse или источников.
- Какие практики помогают управлять версиями схем и миграциями при эволюции Lakehouse?
- Использование каталога версий схем, формальное тестирование миграций в staging-среде, автоматическое тестирование совместимости коннекторов с новыми версиями схем и CI/CD-процессы для проверок и откатов. Важна прозрачная документация контрактов между источниками и целевой системой.
- Какие типы мониторинга полезны для устойчивости и производительности?
- Метрики задержек пайплайна, время до восстановления после сбоя, частота ретраев, доля успешных прогонов, нагрузочные тесты под пиковые режимы, трассировка критических путей, агрегация логов по коннекторам и слоям Lakehouse. Использование Grafana, Prometheus, OpenTelemetry обеспечивает единый взгляд на работу системы.
- Как обеспечить безопасность и соответствие требованиям в устойчивой инфраструктуре?
- Необходимо внедрить RBAC на уровне источников и коннекторов, шифрование секретов и коммуникаций, управление доступами к данным в Lakehouse и мониторинг подозрительных действий. Регулярные аудиты и обновление политик безопасности снижают риски и соответствуют требованиям регуляторов.
- Какие внедрения лучше всего начинать с точки зрения зрелости инфраструктуры?
- Рекомендуется начать с архитектуры горизонтального масштабирования и базового мониторинга, затем перейти к устойчивости (DLQ, ретраи, идемпотентность), далее - интеграция с Lakehouse и управление версиями схем, и, наконец, автоматизация развёртываний и управление изменениями в рамках CI/CD и GitOps.
- Какую роль играет выбор Lakehouse-решения в проекте масштабирования?
- Lakehouse-решение определяет доступные паттерны обработки, качество транзакций и уровень поддержки эволюции схем. Важно выбрать подход, который обеспечивает эффективную загрузку, поддержку апдейтов и датасета, а также гибкую оптимизацию на основе параллелизма и системной архитектуры.
- Что считать индикатором готовности к дальнейшему масштабированию инфраструктуры?
- Важны метрики пропускной способности и задержек, стабильность при росте числа источников, устойчивость к сбоям и качество данных после миграций. Если текущие показатели соответствуют SLA и планам роста, можно планировать следующий этап масштабирования и интеграции новых доменов данных, не ухудшая работу существующих пайплайнов.


