

Моделирование данных в Doris: таблицы, типы, схемы
Doris - это аналитическая колоночная база данных, ориентированная на быстрый отклик на запросы в больших объемах данных. Её архитектура FE/BE,.vectorized execution и продвинутые механизмы хранения данных влияют на принципы моделирования: выбор типа таблицы, распределение данных, partitioning и проектирование схем витрин. Эта глава фокусируется на практических аспектах моделирования данных в Doris: как определить типы таблиц, как строить схемы под задачи аналитики и как при этом учитывать особенности ingestion и real-time обновления.
Doris требует четкой стратегии на стыке схемы и загрузки: чем внимательнее спроектированы таблицы и их ключи, тем эффективнее будут запросы к витринам и тем выше стабильность ingestion-пайплайнов. В разделе приведены понятные принципы и конкретные примеры DDL, пояснения к выбору типов ключей, а также рекомендации по построению схем в рамках обычной OLAP-аналитики и реального времени.
- В этой главе рассмотрены сущности и принципы: типы таблиц Doris, выбор ключей, схемы STAR/SNOWFLAKE и wide-table подходы, механизмы загрузки и агрегаций, а также практики миграций схем.
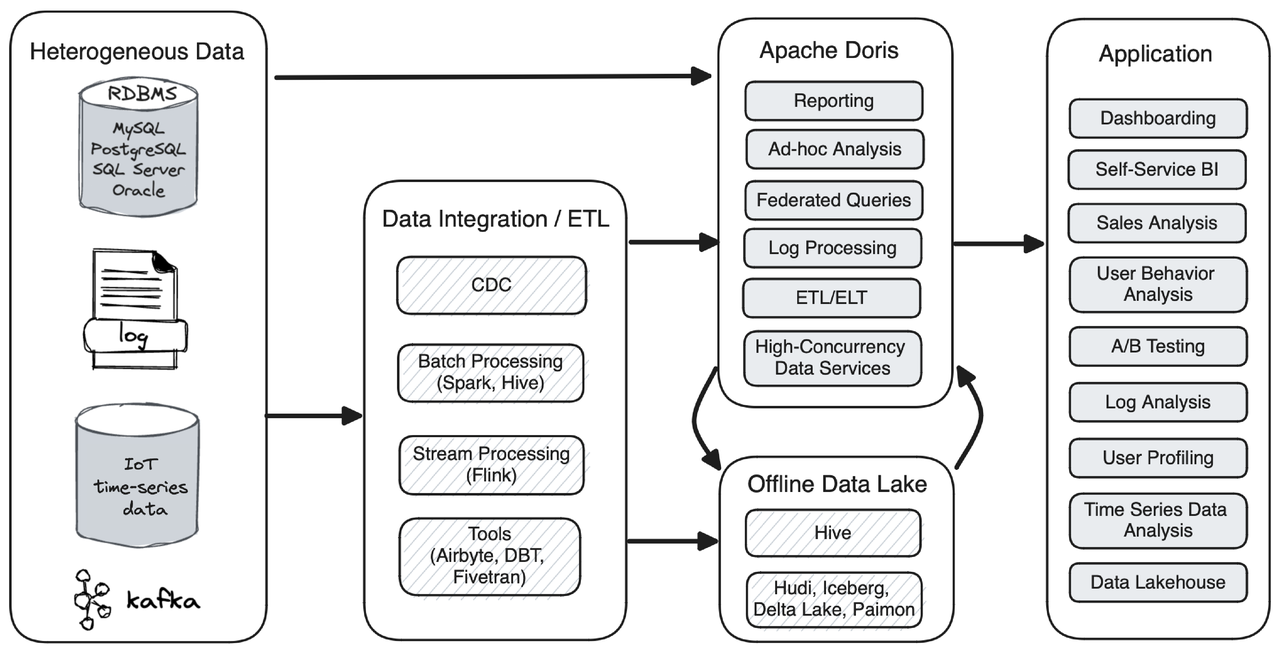
Архитектура Doris и влияние на моделирование
Doris состоит из двух основных компонентов: Frontend (FE) и Backend (BE). FE отвечает за метаданные, планирование запросов, глобальную координацию и управление пользовательскими правами, тогда как BE хранит данные и осуществляет вычисления на уровне сегментов. Данные в Doris хранятся в колонко-ориентированном формате и обрабатываются векторизованным исполнением, что значительно влияет на выбор структуры таблиц и схем. Основные последствия этой архитектуры для моделирования:
- Оптимизация сквозных запросов в условиях больших фактов: колоночное хранение и векторизация позволяют быстро аггрегировать и фильтровать данные, особенно по диапазонам дат и по ключам измерений. Модель должна максимально поддерживать "микро-агрегацию" на уровне витрин и минимизацию дорогостоящих джоин-перекрестков.
- Распределение данных по кластеру (BUCKETS) и выбор ключа распределения: ключи распределения должны минимизировать пересечение данных между сегментами при джоин-операциях и группировках, что улучшает локальность чтения и скорость прелогирования.
- Разделение по времени и партиционирование: диапазонные партиции по дате позволяют быстро prune-partition и ускоряют аналитические запросы за счет ограничения сканируемого объема данных.
- Поддержка real-time и потоковых загрузок: Doris предлагает механизмы пакетной загрузки и потоковой загрузки (stream load) для минимизации задержек между источником и витриной. Архитектура лучше всего поддерживает "мягкие" обновления в реальном времени через агрегированные витрины и матричные представления.
Практически это означает: на стадии моделирования следует продумать, как тип таблицы, стратегия распределения и партиционирования будут влиять на скорость чтения, размер сканов и покрытие запросов в реальном времени. В частности, следует внимательно подходить к выбору типа ключа, схемы и кросс-ресурсной интеграции, чтобы обеспечить эффективную поддержку как исторических витрин, так и реальных обновлений.
-- Пример концептуального DDL: как архитектура влияет на выбор ключей и партиционирования
CREATE TABLE events_fact (
  event_id BIGINT,
  date_id DATE,
  user_id BIGINT,
  product_id INT,
  amount DECIMAL(18,2),
  country_code STRING
)
DUPLICATE KEY(event_id)
## PARTITION BY RANGE(date_id) (
  PARTITION p202001 VALUES LESS THAN ('2020-02-01'),
  PARTITION p202002 VALUES LESS THAN ('2020-03-01')
)
DISTRIBUTED BY HASH(event_id) BUCKETS 16
PROPERTIES ("replication_num" = "3");

CREATE TABLE dim_date (
  date_id DATE,
  day INT,
  month INT,
  quarter INT,
  year INT
)
UNIQUE KEY(date_id)
DISTRIBUTED BY HASH(date_id) BUCKETS 4;
В приведённых примерах видно, как архитектура влияет на выбор: первичный ключ и партиционирование по дате позволяют эффективно прелогировать данные и ускорить фильтрацию по временным диапазонам, что важно для витрин и реальных потоков данных.
Таблицы Doris: типы ключей и их назначение
Одна из ключевых особенностей Doris - поддержка различных типов ключей, которые определяют семантику вставки и агрегаций. Основные варианты:
- DUPLICATE KEY (дублированные ключи): это базовый и наиболее распространённый тип. В таких таблицах дубликаты допустимы, вставка не приводит к аггрегации значений автоматически. Такой тип оптимален для высокоскоростной загрузки фактов и для сценариев, где дубликаты допустимы и их удаление осуществляется на уровне ETL.
- UNIQUE KEY (уникальные ключи): таблицы с уникальными ключами обеспечивают уникальность по указанным колонкам. Вставки с дубликатами могут перезаписывать существующие строки или вызывать конфликты в зависимости от реализации; в Doris часто используются для измерений, где дубликаты недопустимы и требуется консолидация уникальных записей.
- AGGREGATE KEY (агрегированные ключи): эти таблицы рассчитаны на хранение агрегированных значений по ключам. При загрузке дубликаты по ключам агрегируются согласно заданным агрегатам (например, SUM, MAX, MIN). Такой подход удобен для больших фактов, где целесообразна предагрегация и экономия места за счёт хранения агрегатов.
Назначение каждого типа связано с характером данных и частотой обновлений:
- Для событийных фактов, которые приходят в большом объёме и могут содержать повторные записи для одного и того же ключа в рамках суток, чаще выбирают DUPLICATE KEY. Это упрощает процесс загрузки и последующую агрегацию при аналитике.
- Для витрин, где нужно обеспечить уникальность измерений (например, измерения клиентов, продукты, география), уместно использовать UNIQUE KEY или комбинацию уникальных ключей с конкретной логикой загрузки.
- Для предвычисляемых агрегатов, часто используемых в частых запросах на «тонкие» сводки по дате и товару, применяют AGGREGATE KEY и определённые аггрегатные столбцы. Это снижает объем вычислений во время выполнения запросов и ускоряет отклик.
Рассмотрим практические примеры.
-- Пример 1: DUPLICATE KEY для фактов
CREATE TABLE sales_fact (
  sale_id BIGINT,
  date_id DATE,
  product_id INT,
  store_id INT,
  amount DECIMAL(18,2)
)
DUPLICATE KEY (sale_id)
DISTRIBUTED BY HASH(sale_id) BUCKETS 16
## PARTITION BY RANGE(date_id) (
  PARTITION p202501 VALUES LESS THAN ('2025-02-01'),
  PARTITION p202502 VALUES LESS THAN ('2025-03-01')
);

-- Пример 2: UNIQUE KEY для измерений
CREATE TABLE dim_customer (
  customer_id BIGINT,
  region STRING,
  signup_date DATE
)
## UNIQUE KEY (customer_id)
DISTRIBUTED BY HASH(customer_id) BUCKETS 4;

-- Пример 3: AGGREGATE KEY для предагрегатов
CREATE TABLE agg_sales_daily (
  date_id DATE,
  product_id INT,
  total_amount DECIMAL(18,2) SUM,
  total_quantity INT SUM
)
AGGREGATE KEY (date_id, product_id)
DISTRIBUTED BY HASH(date_id) BUCKETS 8;
Важно понимать, что аггрегации в AGGREGATE KEY таблицах выполняются на уровне загрузки: если приходят дубликаты по ключам из набора (date_id, product_id), значений аггрегируемых колонок применяются агрегатные функции (SUM, MIN, MAX и т. д.). Это позволяет значительно ускорить запросы, которые пользуются сводными мерами.
Рекомендации по выбору типа таблиц:
- Начинайте с DUPLICATE KEY для фактов, если загрузка велика и нужно сохранить максимальную производительность записи.
- Используйте UNIQUE KEY для размерных таблиц, где гарантируется уникальность по ключам, и где важна точная идентичность записей.
- Применяйте AGGREGATE KEY для часто запрашиваемых сводок на уровне дат/позиций, чтобы сократить вычисления на стадии выполнения запросов.
Рассматривая схемы, следует помнить о связях между таблицами: размерные таблицы должны быть хорошо нормализованы или денормализованы в зависимости от сценария, а фактовые таблицы - с удобной аггрегацией и эффективной маршрутизацией данных по частям (partitions) и сегментам (segments).
Схемы данных в Doris: проектирование витрин и агрегатов
Эффективная аналитика в Doris строится на грамотной схеме витрины. В Doris возможности позволяют реализовать как классическую STAR/SNOWFLAKE схему, так и варианты wide-table подходов. Выбор зависит от частоты обновлений, требуемого времени отклика и сложности дью-дийсей анализа.
- STAR-схема: классический подход, где фактовая таблица соединяется с несколькими размерными таблицами. Преимущества - простота запросов, ясность семантики и хорошая предсказуемость планирования. В Doris STAR хорошо подходит для агрегирования по нескольким измерениям и эффективной фильтрации по времени.
- SNOWFLAKE: нормализация размерных таблиц может снизить избыточность и обновления в случае большого числа изменений в измерениях. Однако запросы в Snowflake-образной схеме чаще требуют джоинов между размерными таблицами, что может снизить производительность по сравнению с STAR в условиях больших нагрузок.
- Wide-table (широкие таблицы): денормализация на грани реализации. В случаях, когда требуется очень быстрый отклик по конкретной витрине и объем джоин-переносов не нужен, wide-table может быть оправдан. Однако сложность поддержки и обновления такой схемы возрастает при росте числа измерений.
Практически это означает, что на этапе моделирования следует выбрать такую схему, которая обеспечивает баланс между простотой запросов и стоимостью поддержки. В Doris это достигается за счет разумного сочетания:
- размерные таблицы с устойчивыми surrogate-ключами;
- факт-таблица с понятной зерном по времени;
- распределение по HASH по ключам, которые часто участвуют в джоин-условиях;
- партиционирование по диапазонам времени (например, по месяцам или неделям) для ускорения прелогирования и ограничений сканирования;
- использование агрегатов и материализованных представлений там, где это приносит существенную экономию времени ответа.
Ниже приведён пример реализации STAR-схемы с витриной продаж:
-- Размерная таблица DimProduct
CREATE TABLE dim_product (
  product_id INT,
  category_id INT,
  product_name STRING,
  brand STRING
)
## UNIQUE KEY (product_id)
DISTRIBUTED BY HASH(product_id) BUCKETS 4;

-- Размерная таблица DimStore
CREATE TABLE dim_store (
  store_id INT,
  region STRING,
  city STRING
)
UNIQUE KEY (store_id)
DISTRIBUTED BY HASH(store_id) BUCKETS 4;

-- Факт sales
CREATE TABLE fact_sales (
  sale_id BIGINT,
  date_id DATE,
  product_id INT,
  store_id INT,
  amount DECIMAL(18,2)
)
DUPLICATE KEY (sale_id)
DISTRIBUTED BY HASH(sale_id) BUCKETS 16
## PARTITION BY RANGE(date_id) (
  PARTITION p202501 VALUES LESS THAN ('2025-02-01'),
  PARTITION p202502 VALUES LESS THAN ('2025-03-01')
);

-- Витрина (агрегированная) для быстрых запросов по дате и товару
CREATE TABLE mv_daily_sales (
  date_id DATE,
  product_id INT,
  total_amount DECIMAL(18,2) SUM
)
AGGREGATE KEY (date_id, product_id)
DISTRIBUTED BY HASH(date_id) BUCKETS 8;
-
Поддержка агрегированных витрин: материализованные представления (materialized views) или аналогичные таблицы-агрегаты, которые рассчитываются во время загрузки или по расписанию, чтобы ускорить наиболее частые запросы.
-
Partitions и prune: партиционирование по дате обеспечивает быстрое усечение выборки. В случае реального времени важно наличие параллельной загрузки фактов в основную витрину и параллельной обновляемой агрегированной витрины.
-
Денормализация против нормализации: STAR-схема упрощает запросы и улучшает производительность чтения, а Snowflake - снижает дублирование, но может потребовать более сложного планирования джоин-цепочек. В Doris разумно сочетать оба подхода: держать основную STAR-структуру для быстрых запросов, а нормализованные dimension-таблицы - для управляемой эволюции.
-
Стратегии обновления витрин: поддержка incremental loads, обновление агрегатов и использование индикаторов изменений (change data capture) для обновления витрин без переработки всей базы.
Интеграции загрузки и поддержания схемы
Управление загрузкой в Doris должно быть тесно связано с выбранной схемой. В большинстве проектов применяется сочетание пакетной загрузки и потоковых источников (реального времени). Основные принципы:
- Каким образом источники данных попадают в витрину: пакетная загрузка (bulk load) для истории и ежесуточной загрузки; потоковый загрузчик (stream load) для реального времени и близких к нему обновлений.
- Как управлять изменениями измерений: эволюция размерных таблиц требует аккуратной миграции и совместимости с существующими фактами.
- Как обрабатывать дубликаты и консолидацию: DUPLICATE KEY позволяет быстро снова загрузить данные, но для аналитики по агрегатам часто полезны AGGREGATE KEY и материализованные агрегаты.
- Принципы тестирования и миграции: выкатывайте изменения в тестовой среде, сначала на исторических данных и с сравнениями результатов между старой и новой схемами, затем постепенно переносите нагрузку в продуктив.
Ниже приведён упрощённый пример загрузки через потоковый канал ( STREAM LOAD ) и пакетной загрузки. Примечание: конкретные параметры и конечные точки зависят от версии Doris и инфраструктуры.
-- Пример потоковой загрузки в Doris через REST-API
POST http://fe-host:8040/api/_stream_load
{
  "db": "analytics",
  "tbl": "fact_sales",
  "_label": "stream_load_202503",
  "data": "col1,col2,col3\n1,2025-03-01,100.00\n2,2025-03-01,150.50",
  "format": "csv",
  "column_separator": ",",
  "strip_outer_array": true
}
-- Пример пакетной загрузки из локального файла или хранилища
LOAD LABEL 'bulk_202503' INTO TABLE analytics.fact_sales
FROM LOCAL FILE '/data/bulk/fact_sales_202503.csv'
CREDENTIALS ( "user" "password" )
FORMAT AS CSV
;

// Альтернатива: загрузка через broker
LOAD LABEL 'bulk_202503' INTO TABLE analytics.fact_sales
FROM BROKER("hdfs://path/to/folder/", "user", "password")
FORMAT AS PARQUET;
Рекомендации по интеграциям:
- Используйте потоки данных (streaming) только для тех витрин, где задержки критичны и нужна минимальная задержка от источника до витрины.
- Для исторических данных применяйте пакетную загрузку, которая позволяет надежно грузить большой объем с гарантиями консистентности.
- Поддерживайте версионирование схем через имена таблиц и лейблы загрузок, чтобы можно было откатиться к предыдущим версиям витрины без простоя.
- Внедрите контроль целостности и аудит проверки как часть пайплайна загрузки: сверка сумм, количества записей и контрольные суммы.
Эволюция схемы и миграции
Изменение требований к витрине требует умений управлять миграциями без потери доступности. В Doris миграции схем часто реализуются через:
- Создание новой таблицы с нужной схемой и типом ключа;
- Перенос данных из старой таблицы в новую с использованием INSERT INTO ... SELECT ...;
- Применение новой витрины и постепенная миграция запросов;
- Деприсечение старой таблицы после подтверждения совместимости.
Подходы к миграциям:
- Версионирование схем и итеративная миграция: начинайте с параллельного существующей витрины и новой, затем переключайте запросы на новую.
- Непрерывность и откат: храните обе версии витрины на короткое время и реализуйте план отката на случай проблем.
- Тестирование совместимости: сравните результаты запросов между двумя версиями витрины на реальных выборках данных.
-- Создание новой витрины и миграция агрегаций
CREATE TABLE fact_sales_v2 (
  sale_id BIGINT,
  date_id DATE,
  product_id INT,
  store_id INT,
  amount DECIMAL(18,2)
)
DUPLICATE KEY (sale_id)
DISTRIBUTED BY HASH(sale_id) BUCKETS 16
PARTITION BY RANGE(date_id) (...);

## INSERT INTO fact_sales_v2
SELECT sale_id, date_id, product_id, store_id, amount
FROM fact_sales;

-- Переключение приложений на новую витрину
## RENAME TABLE fact_sales TO fact_sales_old;
RENAME TABLE fact_sales_v2 TO fact_sales;

-- В случае проблем — откат
RENAME TABLE fact_sales_old TO fact_sales;
Такой подход позволяет минимизировать риск при изменении структуры витрины и обеспечивает плавный переход.
Key takeaways
- Типы таблиц в Doris (DUPLICATE KEY, UNIQUE KEY, AGGREGATE KEY) определяют семантику вставки и агрегаций, а следовательно и стратегию загрузки и хранение данных.
- Архитектура Doris влияет на проектирование схем: партиционирование по дате, распределение по HASH и выбор ключей должны соответствовать частоте запросов и характеру обновлений.
- STAR/SNOWFLAKE схемы и wide-table подходы могут сочетаться в рамках одной витрины: STAR для быстрого чтения, AGGREGATE и материальные витрины - для ускорения частых запросов.
- Планирование загрузки должно учитывать реальное время: потоковые загрузки для ЛВ и пакетные загрузки для исторических данных, с возможностью миграций схем без простоя.
- Миграции схем требуют параллельной витрины и планов отката: тестирование на отдельной среде, версионирование и поэтапный переход.
- Эффективное проектирование витрин требует баланса между денормализацией (для скорости чтения) и управляемостью изменений (для поддержки и развития схемы).
- Инструменты в Doris позволяют строить агрегаты, материализованные представления и витрины, ориентированные на реальный тайм и глубокую аналитику.
FAQ
- Что такое ключи DUPLICATE KEY, UNIQUE KEY и AGGREGATE KEY в Doris и как выбрать между ними?
- DUPLICATE KEY предназначен для транспортировки большого потока фактов без обеспечения уникальности, что упрощает загрузку и поддерживает высокую скорость.
- UNIQUE KEY применяют к измерениям, где требуется уникальная запись по ключу, чтобы исключить дубликаты и обеспечить целостность измерений.
- AGGREGATE KEY используется для таблиц с предагрегированными значениями; дубликаты по ключам аггрегируются согласно заданным функциям (SUM, MAX и т. д.). Этот режим полезен для витрин, где часто запрашиваются агрегаты и требуется экономия вычислительных ресурсов.
- Какие принципы распределения данных в Doris способствуют производительности запросов?
- Распределение по HASH на ключах, которые активно присутствуют в джоинах или группировках, обеспечивает хорошую локальность и минимизирует пересечения между сегментами.
- Партиционирование по дате позволяет prune-partition и ускоряет выборку по времени.
- Сочетание распределения и партиционирования обеспечивает эффективное параллельное выполнение запросов и уменьшение сканов.
- Как выбрать между STAR и Snowflake схемами в Doris?
- STAR предпочтителен, когда важна скорость чтения и простота запросов: один факт и несколько измерений, меньше джоин-проектирования.
- Snowflake подходит для больших изменений в измерениях и снижения дублирования, но может потребовать более сложного планирования и чаще приносит увеличение времени выполнения джойнов.
- В реальности часто выбирают гибрид: основная витрина в STAR, а часть размерных таблиц - нормализована для поддержания изменений.
- Какие практики минимизируют риск при миграции схем витрин?
- Микро-миграции: создайте новую витрину и перенесите данные, затем плавно переключите приложение.
- Откат: имейте план отката и храните старую витрину на некоторое время после перехода.
- Тестирование: используйте тестовые выборки данных и сравнивайте результаты между старыми и новыми витринами.
- Как Doris поддерживает real-time витрины?
- Doris поддерживает потоковую (stream) загрузку и механизм обновления витрин в реальном времени, что позволяет быстро отражать изменения из источников данных.
- Эффективность достигается за счет предопределённых агрегатов и секций, которые ускоряют аналитические запросы на свежие данные.
- Какие практические принципы проектирования витрин следует помнить?
- Определяйте surrogate-ключи для размерных таблиц и держите факт-таблицу в формате, поддерживающем агрегации.
- Партиционируйте по времени и распределяйте значение по столбцам, которые часто присутствуют в фильтрах и группировках.
- Используйте агрегаты и материализованные представления для часто запрашиваемых сводок.
- Соблюдайте баланс между денормализацией и поддержкой изменений: STAR для скорости, normalization - для управляемости.
- Какую роль играют загрузки данных в моделировании Doris?
- Загрузка данных - ключевой фактор производительности витрины. Для фактов (частые обновления) применяют DUPLICATE KEY и потоковую загрузку, для измерений - UNIQUE KEY и структурированные загрузки.
- Эффективная стратегия загрузки в сочетании с партиционированием и агрегациями позволяет поддерживать актуальные витрины без снижения доступности.
- Какие ограничения стоит учитывать при проектировании схем?
- Количество столбцов и их типы влияют на сжатие и скорость сканов; выбирайте типы, соответствующие точной потребности аналитики.
- Чрезмерная денормализация может усложнить поддержку и миграции; оптимально разделять витрины на управляемые части.
- Прежде чем внедрять AGGREGATE KEY, убедитесь, что запросы действительно выигрывают по времени выполнения, иначе возможна избыточная сложность.
- Какие инструменты и практики применяются для мониторинга схем?
- Мониторинг загрузок и задержек в ingestion, контроль целостности данных, сравнение агрегатов и полноты витрин.
- Непрерывная проверка производительности запросов по ключевым сценариям и поддержка обновлённых витрин.
- Какую роль играет документация в поддержке схемы?
- Документация по схемам, ключам, партиционированию и агрегациям - основа эволюции витрины. Это снижает риск при миграциях и облегчает вовлечение новых участников проекта.


