

Риски, ограничения и частые ошибки в эксплуатации Doris
Apache Doris представляет собой мощный OLAP-движок для аналитики в масштабе данных. Однако эффективная эксплуатация требует не только владения базовыми операциями загрузки и моделирования, но и внимательного управления рисками, связанными с распределенной архитектурой, динамикой нагрузок и эволюцией схем. В этом разделе рассмотрим ключевые ограничения Doris, типичные источники ошибок и практические подходы к их минимизации на протяжении жизненного цикла проекта.
В отличие от монолитных решений, Doris реализует параллелизм, распределение данных и асинхронные механизмы обновления. Это создает ряд операционных и архитектурных рисков, которые часто оказываются причиной задержек внедрения, некорректной аналитики или просто простоя. Цель главы - вооружить инженера данными о типичных сценариях эксплуатации, способах диагностики и методах снижения влияния рисков на производительность и качество данных.
- Архитектура Doris: FE/BE, координация запросов, распределение данных и точки отказа.
- Моделирование и эволюция схем: выбор распределения, партиционирования и колокации; влияние на консистентность и производительность.
- Ингестия и консистентность потоков данных: режимы загрузки, идемпотентность, дубликаты и обработка ошибок.
- Оптимизация запросов: статистика, планировщик, материализованные представления и управление ресурсами.
- Операционная устойчивость: мониторинг, безопасность, бэкапы и миграции между версиями.
Архитектура Doris и операционные риски
Архитектура Doris опирается на разделение ролей между Frontend (FE) и Backend (BE). FE отвечает за метаданные, анализ запросов и планирование исполнения, тогда как BE хранит и обрабатывает данные. Эта схема обеспечивает масштабируемость и высокую пропускную способность аналитических запросов, но поднимает вопросы устойчивости и согласованности в распределенной среде.
Роли FE и BE: точки отказа и принципы HA
FE-кластер обычно работает как один или несколько узлов с режимами высокого доступности. Потенциальные точки отказа - одиночные FE-узлы, сетевые сбои между FE и BE, а также проблемы консистентности между каталогами метаданных и физическим расположением сегментов. Практическая рекомендация: развернуть FE в кластерном режиме с согласованными хэш-таблицами и обеспечить автоматическое переключение (failover) между FE-узлами. В качестве дополнительного действенного приема - репликация метаданных и регулярное тестирование плана восстановления после сбоев.
BE-узлы несут нагрузку по хранению и вычислениям. Масштабирование BE вдоль горизонтальной оси требует продуманной схемы балансировки нагрузки и учета локальных ресурсов: CPU, память, I/O. Необходимо избегать «hot spots» - сильной перераспределительности по частям данных (таблеткам) и по ключам распределения. Рекомендовано заранее определить стратегию перераспределения и поддерживать баланс активности между узлами.
Планирование ресурсов и эксплуатация
Doris применяет параллельное выполнение запросов и распределение по сегментам. Эффективное управление ресурсами требует:
- явной настройки лимитов памяти на FE и BE,
- мониторинга очередей выполнения и задержек планирования,
- контроля за активной параллельностью (concurrency) и лимитами параллелизма на уровне узла.
Без чёткой политики ресурсов запросы с большими фильтрами и сложными соединениями могут монополизировать вычислительную мощность, что ведёт к задержкам для остальных пользователей и дедупликации внутри кэшей планирования.
Мониторинг и диагностика
Непременная часть эксплуатации - активный мониторинг: метрики задержек, загрузки CPU и памяти, использования диска и сетевого трафика, частоты ошибок при загрузке и оперативных операциях. Неправильная интерпретация метрик может привести к задержке реагирования и ухудшению качества данных. Рекомендовано внедрить дашборды по:
- LATENCY и THROUGHPUT для FE и BE,
- проценту задержанных запросов (tail latency),
- количеству активных и заблокированных запросов,
- статусам фоновых процессов (compact, flush).
Взаимодействие с экосистемой и интеграциями
Doris интегрируется с внешними системами через источники данных и коннекторы (S3/HDFS для брок-лоад, Kafka для стриминга и т.п.). Непосредственные проблемы часто связаны с несовместимостью форматов, кодировок, временных зон или несоблюдением единообразия схематических типов. При проектировании интеграций следует учитывать требования к идемпотентности загрузок, синхронности обновлений и политике ошибок на случай потери данных.
-- Пример минимального создания таблицы Doris для иллюстрации
CREATE TABLE analytics.sales (
  dt DATE,
  region STRING,
  product_id BIGINT,
  amount DECIMAL(20,2)
) UNIQUE KEY (dt, region, product_id)
DISTRIBUTED BY HASH(region) BUCKETS 16;
Моделирование таблиц и схем: ограничения и риски
Правильное моделирование - основа производительности аналитических запросов в Doris. Непраильная схема приводит к значительным задержкам, дисбалансу нагрузки и дополнительным расходам на переработку данных.
Распределение и колокация
Уточнение схемы распределения по HASH-ключу и выбор BUCKETS напрямую влияют на параллелизм операций над данными. Неправильный выбор ключа или отсутствие колокации между связанными таблицами может привести к:
- сильной переработке сетевых передач между узлами,
- неравномерному распределению данных и «горячим» зонах,
- сложностям в агрегациях и соединениях.
Рекомендовано использовать колокацию для связанных таблиц, чтобы минимизировать shuffling и увеличить локальность чтения.
Партиционирование и диапазоны
Партиционирование по времени (date/range) или по бизнес-горизонтам помогает управлять архивами, ускоряет прогоны запросов и облегчает обслуживание. Однако слишком мелкие партиции увеличивают нагрузку на планировщик и метаданные, а слишком крупные - ограничивают параллелизм. Оптимальная конфигурация достигается через анализ частотности запросов и характерных паттернов доступа.
Эволюция схем и совместимость
Изменение схемы требует аккуратности: добавление колонок с дефолтами, изменение типов, переопределение ключей. Операции ALTER и перепроектирование таблиц могут потребовать времени простоя и переразделения данных. Рекомендовано внедрять эволюцию схем через управляемые миграции: сначала тесты в стейдж-среде, затем пошаговая миграция, сохранение обратной совместимости и детальная верификация данных после каждого этапа.
Материализованные представления и индексы
Материализованные представления (MV) могут существенно ускорить часто выполняемые агрегации, но требуют поддержки на уровне планирования, обновления и хранения. Неправильная настройка MV приведёт к избыточному расходу памяти и устареванию данных. Важно синхронизировать MV с базовыми таблицами и обеспечить корректную стратегию их обновления.
Безопасность изменений и доступ к схемам
Изменения схем должны сопровождаться процедурами контрольной проверки: кто и когда изменил схему, какие данные затронуты, есть ли откаты. Это обеспечивает прозрачность изменений, снижает риск неконсистентности и потери данных при миграциях.
Ингестия данных и режимы загрузки
Загрузка данных в Doris может происходить через несколько режимов: брокер-лоад из файлов в HDFS/S3, стрим-лоад из стриминговых систем (например, Kafka) и обычные вставки. Каждый режим имеет свои особенности, ограничения и риски дублирования данных, временных задержек и идемпотентности.
Стрим-лоад против брокер-лоад
- Стрим-лоад ориентирован на минимальные задержки и регулярную подачу данных в витрины. Он склонен к повторной отправке данных после сбоев и требует аккуратной обработки ошибок и idempotency ключей.
- Брокер-лоад обеспечивает загрузку больших пакетов данных из файловых систем и чаще применяется для пакетной загрузки. Однако он может вносить задержки из-за необходимости ожидать завершения конвейера и согласования схемы.
Важно определить требование к консистентности и задержке в витрине. Для Echt-time витрин чаще выбирают стрим-лоад с белым списком полей, валидацией схем и повторной попыткой на уровне загрузчика.
-- Пример стрим-лоада: отправка строк в формате CSV через REST API Doris
STREAM LOAD
  LABEL load_sales_stream_001
  ( DATA in SCRIPT "stream_sales.csv" )
  INTO TABLE analytics.sales
  ( dt, region, product_id, amount )
  WITH BROKER "kafka_stream_source"
  TREAT_NULL_AS "\\N";
Идемпотентность и уникальные ключи
В условиях повторной отправки данных, особенно в реальном времени, критично обеспечить идемпотентность загрузки. В Doris это достигается за счет использования уникальных ключей таблиц и аккуратной обработки повторяющихся событий. Рекомендовано:
- применение естественных уникальных ключей бизнес-событий,
- дедупликацию на этапе подготовки данных,
- использование RETRY-политик с ограничением повторных попыток и идентификаторов загрузки.
Интеграции и совместимость форматов
Работа с внешними источниками требует аккуратной настройки форматов, кодировок, трактовки дат и временных зон. Простейшие принципы: единая кодировка (например, UTF-8), единая модель времени (UTC внутри среды), согласование схем между источниками и целевой таблицей. При интеграции с Kafka важно обеспечивать совместимость сериализации и политик повторной доставки.
Оптимизация аналитических запросов: режимы и риски
Оптимизация запросов в Doris требует не только знания механизмов планирования, но и дисциплины в управлении статистикой, ресурсами и матрицами нагрузок. Неправильно сконфигурированные параметры могут привести к деградации времени выполнения и непредсказуемым результатам.
Статистика и планировщик
Обновление статистики колонок и ключевых столбцов существенно влияет на качество планирования. Недостаточно актуальная статистика ведет к неэффективной перестройке плана, перерасходу памяти и увеличению задержек. Рекомендовано регулярно запускать ANALYZE на таблицах с изменениями в загрузке или схеме, а также учитывать сезонные паттерны доступа.
Материализованные представления и индексы
MV и агрегационные кеши ускоряют конкретные сценарии, но требуют синхронизации и контроля обновлений. Автоматическое обновление MV может быть полезно, но увеличивает сложность мониторинга и потребление ресурсов. Эффективная политика - использовать MV для стабильных повторяющихся рабочих нагрузок и ограничить частоту обновления, чтобы не перегружать диспетчер ресурсов.
Параллелизм и управление ресурсами
Doris исполняет запросы в распределенном режиме, используя параллельную обработку. Неправильная настройка параллелизма может привести к конкуренции за CPU, памяти и IO, что ухудшает латентность и трактовку итогов. Важно определить верхние пределы параллелизма для конкретной рабочей нагрузки и соблюдать баланс между скоростью выполнения и потреблением ресурсов. Особенно полезна практика «cold-start» - ограничение параллелизма на старте нагрузок и постепенное наращивание.
Производительность и деградации под нагрузкой
Поддержание производительности требует мониторинга «tail latency» и устойчивости под пиковыми нагрузками. В типичных сценариях возникают задержки из-за:
- перегруженных узлов BE,
- нехватки памяти для агрегаций и сортировки,
- блокировок операций путём длительных сериализаций.
Рекомендовано внедрять практики стэков тестирования нагрузки, стресс-тестирования обновлений схем и планов исполнения, чтобы заблаговременно выявлять узкие места.
Операционная устойчивость: безопасность, резервирование и миграции
Эксплуатация Doris в реальных условиях требует продуманной политики безопасности, сохранности данных и планов восстановления.
Безопасность и доступ
Управление доступом в Doris должно учитывать принцип наименьших привилегий, роли пользователей и аудит действий. В крупных средах целесообразно централизовать аутентификацию (LDAP/SSO) и внедрить разделение обязанностей между командами данных, эксплуатации и администрирования.
Бэкапы и восстановление
Наличие стратегий резервного копирования и восстановления критически важно для долговременного хранения аналитических витрин. В зависимости от политики, бэкапы могут выполняться на уровне файловой системы или же на уровне метаданных Doris. Восстановление должно поддерживать точное воспроизведение таблиц и их схем, а также согласование версий метаданных.
Миграции и обновления
Обновления Doris могут затрагивать ядро обработки запросов, форматы данных и внутренние структуры таблиц. Практически важны:
- тестирование обновлений в стейдж-среде,
- поэтапная миграция между версиями,
- минимизация перерывов в работе витрин за счёт планирования окон обслуживания.
Инструменты мониторинга и инцидент-менеджмент
Необходимо строить устойчивую практику оповещения об аномалиях: задержках выполнения, росте ошибок загрузки, снижении доступности. Плюс - регламент реагирования на инциденты и четкая процедура эскалации.
Реальные сценарии: частые ошибки и пути их устранения
-
Неправильный выбор ключа распределения приводит к перегреву узлов и сильной дисперсии задержек на ответах. Решение: провести анализ паттернов запросов и перераспределить данные по ключам, возможно добавить колокацию между таблицами фактов и размерность.
-
Игнорирование статуса обновления статистики после загрузок. Решение: автоматизировать периодическую сборку статистики и запуск планов ANALYZE на ключевых таблицах после крупных загрузок.
-
Игнорирование характера нагрузки при выборе партиционирования. Решение: адаптировать партиции под динамику времени и объема запросов, избегать мелких партиций для оперативной аналитики.
-
Недостаточно строгая идемпотентность загрузок в стрим-каналах. Решение: включать уникальные идентификаторы загрузок, избегать повторных записей и реализовать дедупликацию на этапе ingest.
-
Неправильное использование MV без учёта обновлений исходной таблицы. Решение: планировать MV с учётом частоты обновлений данных и режимов актуализации.
-
Отсутствие единой политики мониторинга и алертинга. Решение: внедрить набор ключевых метрик и автоматические алерты для задержек, ошибок загрузки и нагрузок на узлы.
-
Пренебрежение проверкой схемы и совместимости форматов между источниками и целевыми таблицами. Решение: внедрить строгие правила в CI/CD для схем, тесты на совместимость форматов и верификацию данных после загрузок.
-
Игнорирование временных зон и форматов дат в процессе загрузки. Решение: стандарт UTC во всей цепочке обработки и единая конфигурация локали.
-
Политика обслуживания без резервного плана. Решение: регламентировать окна обслуживания, предусмотреть резервные копии и тестовые сценарии восстановления.
-
Неправильная настройка лимитов памяти и параллелизма. Решение: мониторинг потребления и настройка порогов, постепенное наращивание параллелизма по мере роста нагрузки.
-- Пример загрузки из S3 через брокер-лоад с настройками идемпотентности
LOAD LABEL label_sales_001
(
  DATA INFILE("s3://bucket/path/sales_2024*.csv")
)
INTO TABLE analytics.sales
FIELDS TERMINATED BY ","
OPTIONALLY ENCLOSED BY "\""
SET some_config = 'value';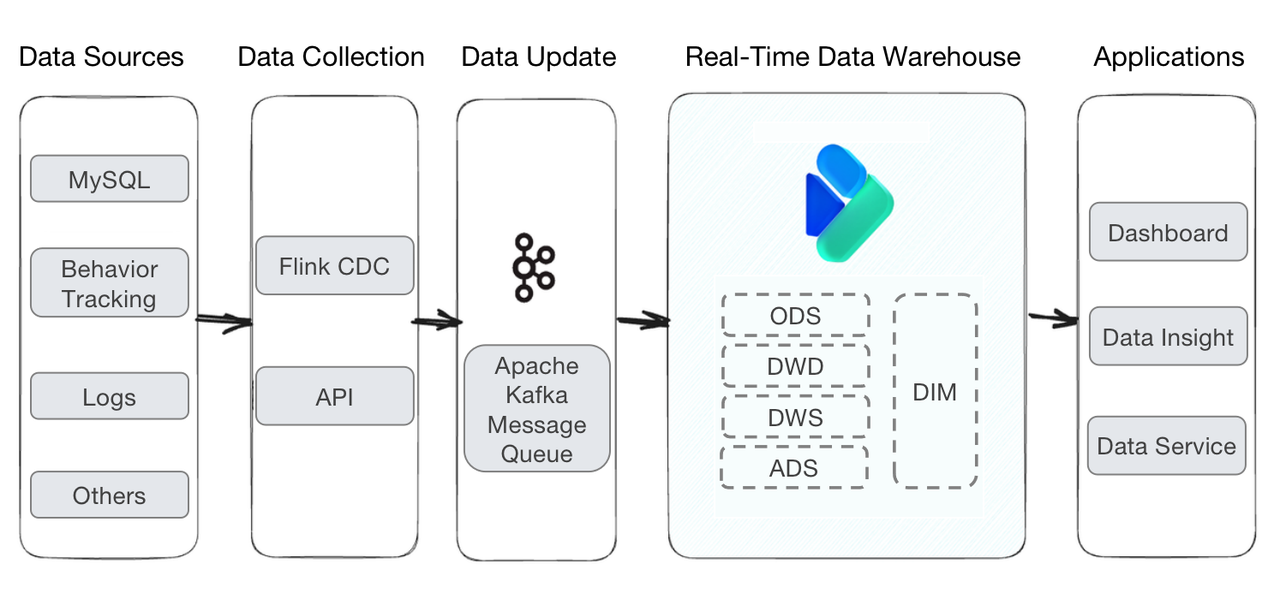
Key takeaways
- Doris предоставляет мощную распределённую архитектуру FE/BE, но требует внимательного управления точками отказа и ресурсами.
- Правильное моделирование таблиц и согласованное распределение данных критично для производительности агрегаций и скорости ответов.
- Загрузка данных должна учитывать режим стрим-лоад/брокер-лоад, идемпотентность и обработку дубликатов для сохранности витрин в реальном времени.
- Оптимизация запросов опирается на актуальные статистики, грамотное использование MV и управление параллелизмом и памятью.
- Операционная устойчивость требует полноценного мониторинга, безопасного доступа, резервного копирования и продуманной миграционной политики.
FAQ
- Какие главные риски характерны для эксплуатации Doris и как их свести к минимуму?
- Основные риски - точки отказа FE/BE, неравномерное распределение данных, устаревшая статистика и проблемы с консистентностью при загрузке. Их снижают через HA FE-монтаж, балансировку нагрузки, регулярную актуализацию статистики, идемпотентность загрузок и чётко прописанные политики резервного копирования и восстановления.
- Как выбрать оптимальное распределение и партиционирование для фактов и измерений?
- Выбор ключа распределения зависит от наиболее частых агрегатных запросов. Для часто фильтруемых по региону и дате - распределение по region и партиционирование по дате. Важно избегать сильной дисбалансировки узлов и учитывать колокацию таблиц, чтобы минимизировать shuffle.
- Как обеспечить идемпотентность загрузок в реальном времени?
- Определяйте уникальные идентификаторы загрузок, используйте дедупликацию на этапе ETL/ингестии и применяйте idempotent retry-политики на стороне клиента и сервера. Стрим-лоад следует оборачивать в механизм повторных попыток с корректной обработкой дубликатов.
- Какие практики помогут избежать ошибок при изменении схем?
- Внедрить план миграции с тестированием изменений в изолированной среде, сохранять обратную совместимость на время миграций и проводить точное тестирование данных после каждого этапа.
- Что считать при настройке MV и индексов в Doris?
- MV ускоряет повторяющиеся запросы, но требует синхронизации и контроля обновлений. Вводите MV для стабильных рабочих нагрузок и ограничьте частоту обновления, чтобы не перегружать кэш и планировщик.
- Какие метрики критически важны для деградации производительности?
- Tail latency, throughput, CPU- и I/O-использование BE/FE, очередь запросов, доля ошибок загрузки и время выполнения критических сцен - эти метрики позволяют быстро распознавать узкие места.
- Как минимизировать риск потери данных при загрузках?
- Применяйте политики резервного копирования и восстановления, тестируйте сценарии FTA (failover, failback), используйте транзакционные подходы в рамках supported features Doris и держите данные в репликах.
- Как скоординировать интеграции Doris с внешними системами?
- Структурируйте конвейеры данных так, чтобы форматы и кодировки были едиными на входе, согласуйте временные зоны и версионирование схем. Для Kafka используйте проверенные коннекторы и тестируйте сценарии повторных отправок.
- Какие практики управления изменениями схем полезны в больших командах?
- Внедрить централизованную политику изменений, автоматизированные проверки схем в CI/CD, регистр изменений и аудит доступа к схеме.
- Как доказать устойчивость витрин к пиковой нагрузке?
- Примените стресс-тестирование на масштабе, мониторинг времени отклика и потребления ресурсов под пиковыми сценариями, и разработайте план действий для быстрого масштабирования или перераспределения ресурсов.
Этот материал предоставляет комплексное представление о рисках и ограничениях Doris, а также практические руководства по их устранению в рамках живых систем. В следующих главах будет углубление по конкретным сценариям загрузки, моделирования и оптимизации, включая углубленную работу с транзакциями и реализацией real-time витрин данных.


