

Объяснение мема Postgres - Уровень 2: Зона солнечного света
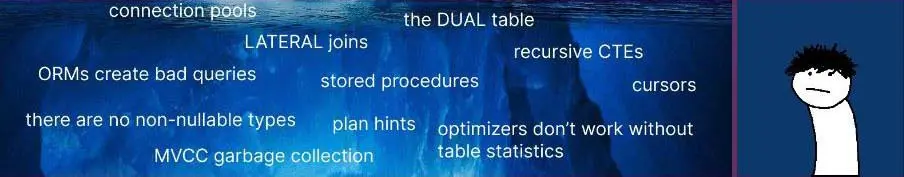
Добро пожаловать в зону солнечного света! По мере продвижения мы будем изучать более продвинутые возможности и методы работы в PostgreSQL. Приготовьтесь окунуться в омут знаний и расширить свои навыки работы с базами данных…
Connection Pool
Подключение к серверу базы данных состоит из нескольких этапов. Connection pool - это способ дальнейшего повышения производительности за счет объединения соединений пользователей с базой данных. Идея заключается в том, чтобы уменьшить общее количество открываемых соединений. Всякий раз, когда клиент хочет подключиться к базе данных, вместо создания нового соединения повторно используется открытое соединение из пула.

Существует множество инструментов и библиотек для различных языков программирования, позволяющих создавать подобные пулы, а также программное обеспечение для создания пулов на стороне сервера, которое работает для всех типов соединений, а не только в рамках одного программного стека. Создать или отладить пулы можно с помощью таких инструментов, как Amazon RDS Proxy, pgpool, pgbouncer, pg_crash и др.
Таблица DUAL
Таблица DUAL - это фиктивная таблица с одной строкой и одним столбцом, которая была первоначально добавлена в качестве базового объекта в системы баз данных Oracle Чарльзом Вайсом. Эта таблица используется в ситуациях, когда необходимо выбрать что-либо, но при этом нет необходимости в предложении from. В Oracle предложение FROM является обязательным, поэтому Вам потребуется двойная таблица. Однако в PostgreSQL создание такой таблицы не требуется, поскольку выборку можно осуществлять и без предложения from.
--- postgresql
select 1 + 1;


-- oracle
select 1 + 1 from dual;
При этом для облегчения проблем переноса с Oracle на PostgreSQL эту таблицу можно создать в Postgres в виде представления. Это позволяет сохранить некоторую совместимость кода с Oracle SQL:
create table dual();
Латеральные соединения (lateral joins)
Начиная с версии PostgreSQL 9.3 в PostgreSQL добавлены латеральные соединения. Используя их, Вы можете посмотреть на левую таблицу:
select * from weather as w
join lateral (
         select city.location
         from city
         where city.name = w.city -- only possible to reference "w" because of lateral
) c on true;
В запросе, приведенном выше, внутренний подзапрос стал коррелированным подзапросом к внешнему запросу select. Без использования латерали каждый подзапрос оценивается независимо и, как следствие, не может содержать перекрестных ссылок на любой другой элемент FROM. Если Вы не использовали LATERAL, то получите эту ошибку:
ERROR: invalid reference to FROM-clause entry for table "w"
HINT: There is an entry for table "w", but it cannot be referenced from this part of the query.
Рекурсивные CTE
Предложения WITH могут использоваться с дополнительной опцией RECURSIVE. Этот модификатор превращает WITH из простого синтаксического удобства в функцию, позволяющую реализовать то, что невозможно в стандартном SQL. Используя RECURSIVE, запрос WITH может ссылаться на свой собственный вывод. Приведенный ниже запрос создает последовательность Фибоначчи:
with recursive fib(a, b) AS (
  values (0, 1)
  union all
    select b, a + b from fib where b < 1000
)
select a from fib;

-- 0
-- 1
-- 1
-- 2
-- 3
-- 5
-- ...
ORM создают неоптимальные запросы
Как уже говорилось ранее, ORM - это абстракции, построенные поверх SQL и упрощающие взаимодействие с базой данных. Некоторые люди используют ORM для написания кода с использованием языковых структур, а не для создания SQL-запросов. ORM выступают в качестве прослойки между реляционной базой данных и приложением, генерируя необходимые запросы.
С другой стороны, ORM абстрагируют особенности базы данных, могут быть более сложными для отладки, чем "сырые" запросы, и иногда генерируют неоптимальные запросы, которые значительно медленнее, чем хорошо написанный SQL для той же задачи. Одной из известных проблем является проблема N+1.
Предположим, что нам нужно получить запись в блоге вместе с комментариями к ней. Чаще всего мы сталкиваемся с проблемой N+1: один запрос select для получения записи и n дополнительных запросов для выбора комментариев к каждой записи (всего n + 1 запросов). Это легко исправить на обычном SQL с помощью простого объединения. Однако при использовании ORM у Вас будет меньше возможностей контролировать генерируемые запросы, кроме того, иногда бывает сложно определить, столкнулись Вы с этой проблемой или нет:
N+ roundtrip:
-- one query to fetch the posts
select id, title from blog_post;
-- N query in a loop to fetch the comments of each post:
select body from comments where post_id = :post_id;

Join:
select c.body, p.title
from comments as c
join blog_post as p on (c.post_id = p.id)
Хранимые процедуры
Хранимые процедуры - это процедуры на стороне сервера с именами, которые обычно пишутся на различных языках, наиболее распространенным из которых является SQL. Ниже показано определение процедуры на языке SQL:
create procedure insert_person(id integer, first_name text, last_name text, cash integer)
language sql
as $$
insert into person values (id, first_name, last_name);
insert into cash values (id, cash);
$$;
Хранимые процедуры вызываются с помощью оператора CALL:
call insert_person(1, 'Maryam', 'Mirzakhani', 1000000);
Отличительной особенностью PostgreSQL от других систем баз данных является то, что она позволяет писать процедуры на любом языке программирования (в отличие от большинства систем баз данных, которые ограничивают использование только предопределенного набора языков).
Дополнительные языки могут быть легко интегрированы в сервер PostgreSQL с помощью команды CREATE LANGUAGE:
create language myLovelyLanguage
  handler my_language_handler -- the function that glue postgresql with any external language
  validator my_language_validator -- check syntax errors before executing function
Функции - это понятие, схожее с хранимыми процедурами, но все же это разные сущности. Традиционно для обозначения обеих функций используется термин "хранимая процедура", однако между ними существуют различия. Одно из ключевых отличий заключается в том, что функции могут возвращать значения, а хранимые процедуры - нет. Однако это не единственное их различие.
Одно из наиболее существенных различий между хранимыми процедурами и функциями заключается в том, что функции можно использовать в операторе SELECT, но они не могут запускать или фиксировать транзакции:
select my_func(last_name) from person;
С другой стороны, хранимые процедуры могут запускать и фиксировать транзакции, но их нельзя использовать внутри операторов select.
call sp_can_commit_a_transaction();
Коротко говоря:
- Функции имеют возвращаемые значения, а хранимые процедуры - нет.
- Функции могут использоваться в операторах select, а хранимые процедуры - нет.
- Функции не могут начинать или фиксировать транзакции, а хранимые процедуры могут.
Существует также концепция, называемая Trigger Functions, но о ней мы поговорим, когда окажемся «поглубже»!
Курсоры
Идея Курсора заключается в том, что данные генерируются только тогда, когда это необходимо (через FETCH). Этот механизм позволяет нам «потреблять» набор результатов, пока база данных генерирует их. То есть он позволяет не ждать, пока механизм базы данных завершит свою работу и отправит все результаты сразу:
declare my_cursor scroll cursor for select * from films; -- you can read more about SCROLL in the collapsible box

fetch forward 5 from my_cursor; -- FORWARD is the direction, PostgreSQL supports many directions.
-- Outputs five rows 1, 2, 3, 4, and 5
-- Cursor is now at position 5

fetch prior from my_cursor; -- outputs row number 4, PRIOR is also a direction.

close my_cursor;
Что такое SCROLL курсор?
Указание SCROLL определяет, что курсор может прокручивать набор данных и получать строки непоследовательно (например, в обратном порядке). В зависимости от сложности плана запроса указание SCROLL может отрицательно отразиться на скорости выполнения запроса.
Отсутствие нулевых типов
Как уже говорилось ранее, в SQL null - это маркер, а не значение. В SQL null означает неизвестность, а отсутствие нулевых типов означает, что мы можем контролировать «нулевость» столбцов исключительно с помощью проверочных ограничений not null.
Такой подход приводит к созданию гибких типов данных, когда любой пользователь базы данных может вводить данные в систему, даже если данные для столбца с таким типом данных отсутствуют или неизвестны.
PostgreSQL позволяет создавать пользовательские типы с помощью CREATE TYPE, при этом можно указать тип данных по умолчанию, если пользователь хочет, чтобы столбцы этого типа данных имели значение по умолчанию, отличное от null. Однако при этом значение столбца остается равным null, если не определены проверочные ограничения not null.
Оптимизаторы не работают без статистики таблиц
Как уже говорилось ранее, PostgreSQL стремится генерировать оптимальный план выполнения SQL-запросов. Различные планы могут давать одни и те же результаты, но хорошо продуманный планировщик/оптимизатор может создать более эффективный план выполнения.
Оптимизация запросов - это искусство, и для того, чтобы составить хороший план, PostgreSQL нужны данные. В PostgreSQL используется оптимизатор на основе затрат, который использует статистику данных, а не статические правила. Планировщик/оптимизатор оценивает стоимость каждого шага в плане и выбирает план, имеющий наименьшую стоимость для системы. Кроме того, PostgreSQL переключается на генетический оптимизатор запросов, когда количество объединений превышает определенный порог (задается переменной geqo_threshold). Это связано с тем, что среди всех реляционных операторов соединения часто являются наиболее сложными и трудными для обработки и оптимизации.
В связи с этим в PostgreSQL реализована система кумулятивной статистики, которая собирает и выдает информацию, связанную с работой сервера баз данных. Эта статистика может пригодиться оптимизатору. Подробнее о статистике, которую собирает PostgreSQL, можно прочитать здесь.
Подсказки по составлению плана
Как мы уже знаем, PostgreSQL делает все возможное для того, чтобы составить хороший план выполнения запросов, используя статистику. Хотя такой подход в целом эффективен для оптимизации пользовательских запросов, бывают ситуации, когда пользователь может захотеть дать подсказку движку базы данных, чтобы вручную повлиять на определенные решения в планах выполнения.
Эти подсказки могут попасть в планировщик/оптимизатор с помощью таких подходов, как проект pg_hint_plan и добавление SQL-комментариев перед запросами:
/*+ SeqScan(users) */ explain select * from users where id < 10;

--                      QUERY PLAN
-- ------------------------------------------------------
-- Seq Scan on a  (cost=0.00..1483.00 rows=10 width=47)
Комментарий /*+ SeqScan(users) */ указывает планировщику на необходимость использования последовательного сканирования при поиске элементов в таблице "users". Аналогично, в комментарии можно указать подсказки для объединений, используя синтаксис HashJoin.
MVCC и сбор «мусора»
Аббревиатура MVCC означает Multiversion Concurrency Control или управление параллельным доступом посредством многоверсионности. Любой движок базы данных должен каким-то образом управлять одновременным доступом к данным, и PostgreSQL как продвинутый движок базы данных не является исключением.
Как следует из названия, MVCC - это механизм управления параллелизмом в Postgres. Мультиверсионность означает, что каждый оператор видит свою версию базы данных (так называемый снимок), как это было некоторое время назад. Это предотвращает просмотр операторами несовместимых данных.
MVCC позволяет блокировкам чтения и записи не конфликтовать друг с другом, поэтому чтение никогда не блокирует запись, а запись не блокирует чтение (и PostgreSQL была первой базой данных, в которой была реализована эта возможность).
Хранение нескольких копий/версий данных приводит к образованию мусорных данных, занимающих много места на диске, что в долгосрочной перспективе снижает производительность базы данных. Для очистки данных от «мусора» в Postgres используется VACUUM, который возвращает место, занимаемое «мертвыми» данными, то есть данными, которые удаляются или устаревают в результате обновления, но физически не удаляются из таблицы. Периодически необходимо выполнять VACUUM, особенно для часто обновляемых таблиц, поэтому в PostgreSQL имеется функция "autovacuum", позволяющая автоматизировать данный процесс.
Далее: Уровень 3: Зона сумерек: Уровни изоляции, ZigZag Join, триггеры, ...


