

Объяснение мема Postgres - Уровень 1: Зона поверхности
Добро пожаловать в зону поверхности! Теперь, когда мы преодолели уровень неба, мы можем познакомиться с некоторыми более продвинутыми возможностями и концепциями, а также глубже погрузиться в функциональные возможности PostgreSQL. Эти темы дадут Вам хорошее понимание системы баз данных.
Транзакции
Транзакция превращает совокупность шагов/действий в одну операцию по принципу "все или ничего". Промежуточные шаги не видны другим параллельно выполняющимся транзакциям. Транзакция - это любое изменение в базе данных.
В PostgreSQL транзакция обрамлена командами BEGIN и COMMIT. Приведенный ниже пример демонстрирует передачу монет от Игрока1 Игроку2 (пример является упрощенным):
BEGIN;
update accounts set coins = coins - 1 where name = "Player1";
update accounts set coins = coins + 1 where name = "Player2";
COMMIT;
В данном случае мы хотим быть уверены, что либо все обновления будут применены к базе данных, либо ни одно из них не произойдет. Мы не хотим, чтобы в результате системного сбоя количество монет у Игрока1 уменьшилось, а у Игрока2 не добавилось ни одной монеты.
ACID
ACID - это аббревиатура от Atomicity, Consistency, Isolation, Durability (Атомарность, Согласованность, Изолированность, Долговечность). Это набор свойств транзакций баз данных, призванных гарантировать достоверность данных, несмотря на ошибки, сбои в электропитании и другие возможные неприятности.
Транзакция в базе данных должна быть ACID, то есть:
- Атомарной - транзакция должна быть либо завершена полностью, либо не иметь никакого эффекта вообще. Атомарность гарантирует, что каждая транзакция рассматривается как единое целое.
- Согласованной – должна быть гарантия, что транзакция может переводить базу данных из одного согласованного состояния в другое. Например, транзакция не должна позволять столбцу NOT NULL иметь значение NULL после COMMIT.
- Изолированной - транзакции часто выполняются параллельно (несколько чтений и записей одновременно). Как мы уже говорили ранее, промежуточные шаги не видны другим параллельно выполняющимся транзакциям, а значит, параллельно выполняющаяся транзакция не должна иметь результат, отличный от того, который был бы получен при последовательном выполнении транзакций.
- Долговечной - система управления базой данных не должна пропустить ни одной зафиксированной транзакции после перезапуска или какого-либо сбоя. Все зафиксированные транзакции должны быть записаны на энергонезависимую память.
Планы запросов и EXPLAIN
Каждая система баз данных нуждается в планировщике для создания плана выполнения запросов на основе Ваших SQL-запросов. Хороший планировщик запросов очень важен для обеспечения высокой производительности БД. В PostgreSQL команда EXPLAIN используется для того, чтобы узнать, какой план создается для выполнения Ваших запросов.
explain select "name", "author" from "book";

-- output:
-- Seq Scan on book  (cost=0.00..18.80 rows=880 width=64)
Для более сложного запроса:
select
         w.temp_lo,
         w.temp_hi,
         w.city,
         c.location as city_location
from weather as w
join city as c
on c.name = w.city;
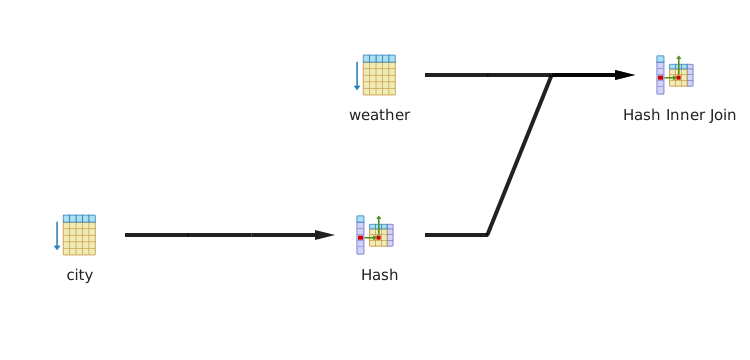
Мы получаем дополнительную информацию о том, как PostgreSQL пытается найти запись (с помощью последовательного сканирования или хэша и т.д.) о затратах, времени и производительности. Приведенная ниже информация получена с помощью команды EXPLAIN ANALYZE. Использование опции ANALYSE наряду с EXPLAIN показывает точное количество строк и истинное время выполнения наряду с оценками, предоставленными EXPLAIN:
  {
    "Plan": {
      "Node Type": "Hash Join",
      "Parallel Aware": false,
      "Async Capable": false,
      "Join Type": "Inner",
      "Startup Cost": 18.10,
      "Total Cost": 55.28,
      "Plan Rows": 648,
      "Plan Width": 202,
      "Actual Startup Time": 0.024,
      "Actual Total Time": 0.027,
      "Actual Rows": 3,
      "Actual Loops": 1,
      "Inner Unique": false,
      "Hash Cond": "((w.city)::text = (c.name)::text)",
      "Plans": [
        {
          "Node Type": "Seq Scan",
          "Parent Relationship": "Outer",
          "Parallel Aware": false,
          "Async Capable": false,
          "Relation Name": "weather",
          "Alias": "w",
          "Startup Cost": 0.00,
          "Total Cost": 13.60,
          "Plan Rows": 360,
          "Plan Width": 186,
          "Actual Startup Time": 0.010,
          "Actual Total Time": 0.010,
          "Actual Rows": 3,
          "Actual Loops": 1
        },
        {
          "Node Type": "Hash",
          "Parent Relationship": "Inner",
          "Parallel Aware": false,
          "Async Capable": false,
          "Startup Cost": 13.60,
          "Total Cost": 13.60,
          "Plan Rows": 360,
          "Plan Width": 194,
          "Actual Startup Time": 0.008,
          "Actual Total Time": 0.008,
          "Actual Rows": 3,
          "Actual Loops": 1,
          "Hash Buckets": 1024,
          "Original Hash Buckets": 1024,
          "Hash Batches": 1,
          "Original Hash Batches": 1,
          "Peak Memory Usage": 9,
          "Plans": [
            {
              "Node Type": "Seq Scan",
              "Parent Relationship": "Outer",
              "Parallel Aware": false,
              "Async Capable": false,
              "Relation Name": "city",
              "Alias": "c",
              "Startup Cost": 0.00,
              "Total Cost": 13.60,
              "Plan Rows": 360,
              "Plan Width": 194,
              "Actual Startup Time": 0.004,
              "Actual Total Time": 0.005,
              "Actual Rows": 3,
              "Actual Loops": 1
            }
          ]
        }
      ]
    },
    "Triggers": [
    ]
| # | Node | Timings | Rows | Loops | ||||
|---|---|---|---|---|---|---|---|---|
| Exclusive | Inclusive | Rows X | Actual | Plan | ||||
| 1. | Hash Inner Join (cost=18.1..55.28 rows=648 width=202) (actual=0.019..0.022 rows=3 loops=1) Hash Cond: ((w.city)::text = (c.name)::text) | 0.007 ms | 0.022 ms | ↑ 216 | 3 | 648 | 1 | |
| 2. | Seq Scan on weather as w (cost=0..13.6 rows=360 width=186) (actual=0.008..0.008 rows=3 loops=1) | 0.008 ms | 0.008 ms | ↑ 120 | 3 | 360 | 1 | |
| 3. | Hash (cost=13.6..13.6 rows=360 width=194) (actual=0.007..0.007 rows=3 loops=1) Buckets: 1024 Batches: 1 Memory Usage: 9 kB | 0.003 ms | 0.007 ms | ↑ 120 | 3 | 360 | 1 | |
| 4. | Seq Scan on city as c (cost=0..13.6 rows=360 width=194) (actual=0.003..0.004 rows=3 loops=1) | 0.004 ms | 0.004 ms | ↑ 120 | 3 | 360 | 1 |
Если у Вас установлен pgAdmin, то он также может показать графический вывод:
Инвертированные индексы
Инвертированный индекс (inverted index) — структура данных, в которой для каждого слова коллекции документов в соответствующем списке перечислены все документы в коллекции, в которых оно встретилось. Инвертированный индекс используется для поиска по текстам.
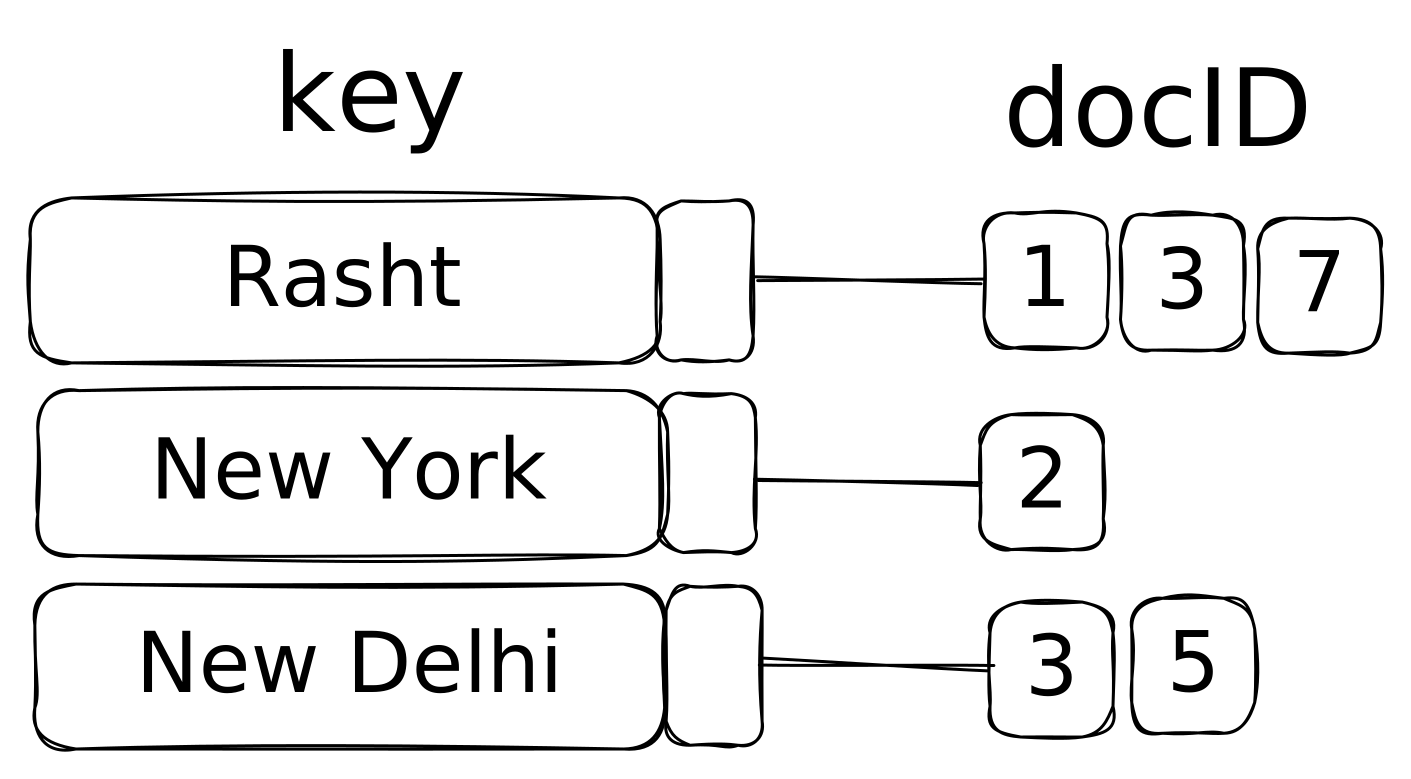
PostgreSQL поддерживает GIN, что расшифровывается как Generalized Inverted Index. GIN является обобщенным в том смысле, что GIN коду метода доступа не обязательно знать конкретные операции, которые он ускоряет.
Keyset Pagination
Существует множество способов реализации пагинации для чтения только части строк из БД. Как мы уже говорили ранее, во многих случаях использование offset замедляет выполнение запроса, поскольку база данных должна считать все строки с самого начала и до достижения запрашиваемой строки. Одним из способов преодоления этой проблемы является использование подхода Keyset Pagination:
select *
from "audit_log"
where created_at < ?
order by created_at desc
limit 10; -- equivalent standard SQL: fetch first 10 rows only
Здесь вместо пропуска записей мы просто используем keyset_column > x, где x - последняя запись с предыдущей страницы, которую мы извлекли.
Дополнительная информация: Пагинация, автор Маркус Вайнанд
Вычисляемые столбцы
Вычисляемый столбец в таблице - это столбец, значение которого является функцией других столбцов в той же строке. Другими словами, вычисляемый столбец для столбцов - это то же самое, что представление для таблиц. Значение вычисляемого столбца может быть прочитано, но не может быть записано. Вычисляемый/генерируемый столбец определяется с помощью GENERATED ALWAYS AS в PostgreSQL:
create table people (
         ...,
    height_cm numeric,
    height_in numeric GENERATED ALWAYS AS (height_cm / 2.54) -- this won't work, will explain why in the next section
)
Сохраняемые столбцы
Вычисляемый столбец может быть как сохраняемым, так и виртуальным:
- Сохраняемый: вычисляется при записи (вставке или обновлении) и занимает место в памяти, как обычный столбец
- Виртуальный: не занимает места в памяти и вычисляется при чтении
Таким образом, виртуальный вычисляемый столбец похож на представление, а сохраняемый вычисляемый столбец - на материализованное представление (за исключением того, что он всегда обновляется автоматически).
Если Вы попробовали выполнить предыдущий запрос, то могли столкнуться с ошибкой. Это связано с тем, что на момент написания данной заметки в PostgreSQL реализованы только сохраняемые вычисляемые столбцы, поэтому необходимо отметить столбец с помощью STORED:
create table people (
    ...,
    height_cm numeric,
    height_in numeric GENERATED ALWAYS AS (height_cm / 2.54) STORED -- works fine
);
ORDER BY
Агрегатная функция вычисляет один результат из набора значений. Одними из наиболее известных агрегатных функций являются min, max, sum и avg, которые используются для вычисления минимального, максимального, суммарного и среднего значения результатов. Приведенный ниже запрос вычисляет среднее значение высоких и низких температур из записей в таблице о погоде:
select
         avg(temp_lo) as temp_lo_average,
         avg(temp_hi) as temp_hi_average
from weather;
Некоторые агрегатные функции вводятся ORDER BY. Эти функции иногда называют функциями "обратного распределения". В качестве примера запрос, приведенный ниже, показывает ранг всех игроков для каждого игрового сервера:
SELECT
    "server",
    percentile_cont(0.5) WITHIN GROUP (ORDER BY rank DESC) AS median_rank
FROM "player"
GROUP BY "server"

-- server    median_rank
-- asia      2.5
-- europe    5
Определение таблицы:
create table player (
  id serial primary key,
  "server" text not null,
  "rank" integer not null default 0
)

insert into player("server", "rank") values
  ('europe', 1), ('europe', 5), ('europe', 7),
  ('asia', 3), ('asia', 2), ('asia', 9), ('asia', 1)
Оконные функции
Оконные функции - мощнейший инструмент, позволяющий одновременно обрабатывать сразу несколько значений результирующего набора. Это похоже на то, чего можно добиться с помощью агрегатных функций, но оконные функции не приводят к группировке строк в одну выходную строку, как это происходит при вызове агрегатных функций.
Вызов оконной функции всегда содержит предложение OVER, следующее непосредственно за именем оконной функции и ее аргументом(ами):
select
         city,
         temp_lo,
         temp_hi,
         avg(temp_lo) over (partition by city) as temp_lo_average,
         rank() over (partition by city order by temp_hi) as temp_hi_rank
from weather

-- city     temp_lo  temp_hi  temp_lo_average  temp_hi_rank
-- Lahijan  10       20       10.33333333      1
-- Lahijan  11       25       10.33333333      1
-- Lahijan  10       20       10.33333333      3
-- Rasht    15       45       15               1
-- Rasht    20       35       15               2
-- Rasht    10       30       15               3
При использовании оконных функций необходимо понимать понятие оконной рамки. Для каждой строки в пределах раздела существует набор строк, называемый оконной рамкой. Некоторые оконные функции действуют только на строки оконной рамки, а не на весь раздел.
В общем случае можно выделить следующие правила работы с оконной рамкой:
select salary, sum(salary) over () from empsalary;
--  salary |  sum
-- --------+-------
--    5200 | 47100
--    5000 | 47100
--    3500 | 47100
--    4800 | 47100
--    3900 | 47100
--    4200 | 47100
--    4500 | 47100
--    4800 | 47100
--    6000 | 47100
--    5200 | 47100
-- (10 rows)
select salary, sum(salary) over (order by salary) from empsalary;
--  salary |  sum
-- --------+-------
--    3500 |  3500
--    3900 |  7400
--    4200 | 11600
--    4500 | 16100
--    4800 | 25700
--    4800 | 25700
--    5000 | 30700
--    5200 | 41100
--    5200 | 41100
--    6000 | 47100
-- (10 rows)
Дополнительные характеристики
В SQL-кодах, приведенных выше, over (order by salary) фактически эквивалентен over (order by salary):
over (order by salary rows between unbounded preceding and current row)
Возможно использовать другие виды спецификаций:
over (order by salary rows between current row and unbounded following)
Или поставить NULL:
over(partition by first_name order by salary nulls last)
Внешние объединения (outer joins)
Как мы уже говорили ранее, при внешнем объединении из таблицы извлекаются все записи, даже те, которые не имеют совпадающих значений ни в левой, ни в правой, ни в обеих сторонах отношения.
select *
from weather left outer join cities ON weather.city = cities.name;

--      city      | temp_lo | temp_hi | prcp |    date    |     name      | location
-- ---------------+---------+---------+------+------------+---------------+-----------
--  Hayward       |      37 |      54 |      | 1994-11-29 |               |
--  San Francisco |      46 |      50 | 0.25 | 1994-11-27 | San Francisco | (-194,53)
--  San Francisco |      43 |      57 |    0 | 1994-11-29 | San Francisco | (-194,53)
-- (3 rows)
Вышеприведенный запрос показывает левое внешнее объединение, поскольку таблица, упомянутая слева от оператора объединения (weather), будет иметь каждую из своих строк хотя бы один раз в выходных данных, в то время как таблица справа (cities) будет иметь только те строки, которые совпадают со строкой в левой таблице.
В PostgreSQL для выполнения внешних соединений используются операторы left outer join, right outer join и full outer join.
CTE
Запросы WITH, они же Common Table Expressions (CTE), можно рассматривать как определение временных таблиц, существующих только для одного запроса. Используя предложение WITH, мы можем определить вспомогательный оператор, который может быть присоединен к основному оператору.
В приведенном ниже запросе мы сначала определяем две вспомогательные таблицы, называемые hottest_weather_of_city и not_so_hot_cities, а затем используем их в первичном запросе select:
with hottest_weather_of_city as (
         select city, max(temp_hi) as max_temp_hi
         from weather
         group by city
), not_so_hot_cities as (
         select city
         from hottest_weather_of_city
         where max_temp_hi < 35
)
select * from weather
where city in (select city from not_so_hot_cities)
В общем-то Common Table Expressions - это не что иное, как другое название предложений WITH.
Нормальные формы
Нормализация базы данных - это процесс структурирования реляционной базы данных в соответствии с рядом так называемых нормальных форм для уменьшения избыточности данных и повышения их целостности.
Существует несколько уровней нормализации, и более высокий уровень нормализации может быть достигнут только после выполнения предыдущих уровней.
Вот некоторые из нормальных форм:
- 1NF: столбцы не могут содержать отношения или составные значения (каждая ячейка является однозначной), и в таблице нет дублирующихся строк
- 2NF: «неключевые» столбцы зависят от всего ключа (он не должен зависеть от части составного ключа). Другими словами, нет частичных зависимостей.
- 3NF: Таблица не имеет транзитивных зависимостей.
Другие нормальные формы, такие как EKNF, BCNF, 4NF, 5NF, DKNF и 6NF, в данной статье не рассматриваются.
Далее: Уровень 2: Зона солнечного света: Пулы соединений, хранимые процедуры, ...


