

Объяснение мема Postgres - Уровень 3: Зона сумерек
Добро пожаловать в зону сумерек! Все начинает становиться все более и более интригующим, поскольку мы переходим к более сложным концепциям баз данных. Приготовьтесь к более глубокому пониманию внутреннего устройства PostgreSQL.
COUNT(*) vs COUNT(1)
Функция COUNT - это агрегатная функция, которая может принимать вид либо count(*) - подсчитывает общее количество строк ввода, либо count(expression) - подсчитывает количество строк ввода, в которых значение выражения не равно null.
-- Number of all rows, including nulls and duplicates.
-- Performance Warning: PostgreSQL uses a sequential scan of the entire table,
-- or the entirety of an index that includes all rows.
select count(*) from person;

-- Number of all rows where `middle_name` is not null
select count(middle_name) from person;

-- Number of all unique and not-null `middle_name`s
select count(distinct middle_name) from person;
Функционально count(1) не отличается от count(*), так как каждый ряд считается как константа 1:
select count(1) from person;
-- equivalent result:
select count(*) from person;
Существует миф, утверждающий, что:
использование count(1) лучше, чем count(*), потому что count(*) выбирает все столбцы без какой-либо необходимости.
Приведенное выше утверждение ошибочно. В PostgreSQL функция count(*) быстрее, так как это специальный жестко закодированный синтаксис без аргументов для агрегатной функции count. count(1) специально медленнее, так как она следует синтаксису count(expression) и ей необходимо проверять, не равна ли константа 1 null для каждого ряда.
Уровни изоляции и фантомные чтения
Как мы уже упоминали ранее, буква I в слове ACID означает изолированность. Транзакция должна быть изолирована от других параллельных транзакций, выполняющихся в базе данных. Например, когда Вы хотите создать резервную копию базы данных с помощью таких инструментов, как pg_dump, Вы совсем не хотите, чтобы на Вашу резервную копию влияли другие операции записи в системе.
Стандарт SQL определяет 4 уровня изоляции транзакций. Эти уровни изоляции определяются в рамках явлений, и каждый из этих уровней либо запрещает эти явления, либо не гарантирует, что они не произойдут. Ниже приведен список явлений:
- “грязное” чтение: транзакция читает данные, записанные параллельной незафиксированной транзакцией.
- неповторяющееся чтение: транзакция перечитывает ранее прочитанные данные и обнаруживает, что они были изменены другой транзакцией (зафиксированной после первоначального чтения).
- фантомное чтение: транзакция повторно выполняет запрос, возвращающий набор строк, удовлетворяющих условию поиска, и обнаруживает, что набор строк, удовлетворяющих условию, изменился в результате другой недавно зафиксированной транзакции.
- аномалия сериализации: результат успешной фиксации группы транзакций не соответствует всем возможным порядкам выполнения этих транзакций по одной. Перекос записи является простейшей формой аномалии сериализации.
В базах данных существует четыре уровня изоляции:
- Read uncommitted (чтение незафиксированных данных)
- Read committed (чтение фиксированных данных)
- Repeatable read (повторяющееся чтение)
- Serializable (упорядочиваемость)
Важно отметить, что в PostgreSQL не реализован уровень изоляции read uncommitted. Вместо этого режим Read Uncommitted в PostgreSQL ведет себя так же, как Read Committed. Это объясняется тем, что это единственный разумный способ сопоставить стандартные уровни изоляции с многоверсионной архитектурой управления параллелизмом PostgreSQL. Такой подход согласуется со стандартом SQL, поскольку стандарт определяет минимальные, а не максимальные гарантии. Поэтому PostgreSQL может запретить фантомное чтение даже на уровне изоляции повторяющегося чтения:
|
Уровень изоляции |
Грязное чтение |
Неповторяющееся чтение |
Фантомное чтение |
Аномалия сериализации |
|
Read uncommitted |
Возможно (не в PG) |
Возможно |
Возможно |
Возможно |
|
Read committed |
Не возможно |
Возможно |
Возможно |
Возможно |
|
Repeatable read |
Не возможно |
Не возможно |
Возможно (не в PG) |
Возможно |
|
Serializable |
Не возможно |
Не возможно |
Не возможно |
Не возможно |
Термин "Serializable" означает, что транзакция может выполняться так, как будто она имеет "последовательное исполнение", когда никакие параллельные операции не влияют на нее.
Уровень изоляции Serializable как отдельный вид искусства!
Исследовательскому сообществу потребовалось около 20 лет, чтобы разработать более или менее удовлетворительную математическую модель для эффективной реализации изоляции моментальных снимков, а затем всего лишь год, чтобы включить эти открытия в рабочий процесс! Подробнее об этом Вы можете узнать здесь:
Serializable snapshot isolation (SSI)
Перекос записи
Перекос записи является простейшей формой аномалии сериализации, и как раз уровень изоляции Serializable и защищает от нее. Однако уровень изоляции Repeatable Read не обеспечивает такой же защиты от перекоса записи.
Предположим, что в таблице имеется столбец, значение которого может быть либо черным, либо белым. Два пользователя одновременно пытаются сделать так, чтобы все строки содержали одинаковые значения цвета, но их попытки идут в противоположных направлениях. Один пытается обновить все белые строки на черные, а другой - все черные строки на белые.
В этом случае две параллельные транзакции определяют, что они пишут, на основе чтения набора данных (строк с черным/белым столбцом), и этот набор данных перекрывает то, что пишет другая транзакция. В этом случае мы можем получить состояние, которое не могло бы возникнуть, если бы одна из транзакций выполнялась раньше другой.
Если эти обновления выполняются последовательно, то все цвета будут совпадать: одна из транзакций переводит все строки в белый цвет, а другая - в черный. Если же они выполняются одновременно в режиме REPEATABLE READ, то значения будут меняться местами, что не согласуется ни с каким последовательным порядком выполнения. Если они выполняются одновременно в режиме SERIALIZABLE, то система изоляции последовательных снимков (Serializable Snapshot Isolation, SSI) PostgreSQL заметит перекос в записи и откатит одну из транзакций.
Дополнительная информация:
- PostgreSQL's Serializable Snapshot Isolation (SSI) vs plain Snapshot Isolation (SI)
- PostgreSQL's Serializable Wiki
Сериализуемые перезапуски требуют циклов повторных попыток для всех операторов
Перезапуск «сериализуемой» транзакции требует повторного выполнения всех утверждений транзакции, а не только того, которое завершилось неудачей. Если сгенерированная транзакция опирается на вычисляемые значения вне sql-кода, то эти коды также должны быть выполнены заново:
// This code snippet is for demonstration-purposes only
let retryCount = 0;

while(retryCount <= 3) {
  try {
    const computedSpecies = computeSpecies("cat")
    const catto = await db.transaction().execute(async (trx) => {
      const armin = await trx.insertInto('person')
        .values({
          first_name: 'Armin'
        })
        .returning('id')
        .executeTakeFirstOrThrow()

      return await trx.insertInto('pet')
        .values({
          owner_id: armin.id,
          name: 'Catto',
          species: computedSpecies,
          is_favorite: false,
        })
        .returningAll()
        .executeTakeFirstOrThrow()
    })

    continue;

  } catch {
    retryCount++;
    await delay(1000);
  }
Частичные индексы
Частичный индекс - это индекс, построенный по подмножеству таблицы, заданному с помощью предложения where; является полезным в тех случаях, когда известно, что значения столбцов уникальны только при определенных обстоятельствах. Один из основных случаев использования частичных индексов - это случаи, когда Вы не хотите помещать в индекс общие элементы, поскольку их частые изменения могут увеличить размер индекса и замедлить его работу из-за повторяющихся обновлений.
В качестве примера предположим, что большинство Ваших клиентов имеют одинаковую национальность (не менее 25% или около того), а в таблице имеется лишь несколько различных значений, тогда хорошей идеей будет создание частичного индекса на столбце:
create index nationality_idx on person(nationality)
where nationality not in ('american', 'iranian', 'indian');
Функции генерации
Функции генерации, также Set returning Functions (SRF), - это функции, которые могут возвращать более одной строки. В отличие от многих других баз данных, в которых в выражениях select могут встречаться только скалярные значения, PostgreSQL позволяет использовать в select функции, возвращающие множества. Одной из наиболее известных таких функций является функция generate_series, которая принимает параметры start, stop и step (необязательные) и генерирует ряд значений от start до stop. Эта функция может генерировать различные типы рядов, включая целочисленные, большие, числовые и даже временные метки:
select * from generate_series(2,4); -- or `select generate_series(2,4);`

--  generate_series
-- -----------------
--                2
--                3
--                4
-- (3 rows)

select * from generate_series('2008-03-01 00:00'::timestamp,
                              '2008-03-04 12:00', '10 hours');
--    generate_series
-- ---------------------
--  2008-03-01 00:00:00
--  2008-03-01 10:00:00
--  2008-03-01 20:00:00
--  2008-03-02 06:00:00
--  2008-03-02 16:00:00
--  2008-03-03 02:00:00
--  2008-03-03 12:00:00
--  2008-03-03 22:00:00
--  2008-03-04 08:00:00
-- (9 rows)
В SQL можно выполнить перекрестное соединение двух таблиц, используя один из двух синтаксисов:
select * from table_a cross join table_b; -- with `cross join`
-- or --
select * from table_a, table_b;           -- with comma
А для функций можно использовать любой из этих двух синтаксисов:
select * from generate_series(1, 3); -- with `select * from`
-- or --
select generate_series(1, 3);        -- with `select` only
При сочетании этих синтаксисов, когда мы выполняем один и тот же синтаксис кросс-соединения для функций-генераторов с помощью синтаксисов select * from f() и select f(), один из них превращается не в кросс-соединение, а в операцию zip:
select * from generate_series(1, 3) as a, generate_series(5, 7) as b; -- cross joins

-- a     b
-- 1     5
-- 1     6
-- 1     7
-- 2     5
-- 2     6
-- 2     7
-- 3     5
-- 3     6
-- 3     7

select generate_series(1, 3) as a, generate_series(5, 7) as b; -- zips

-- a     b
-- 1     5
-- 2     6
-- 3     7
Во втором случае мы получаем результат от двух функций генерации, расположенных рядом (это называется zip двух результатов). Это связано с тем, что план join не может быть создан без from/merge, и PostgreSQL создает в плане так называемый узел ProjectSet для проецирования (отображения) элементов, полученных от функций генерации.
Шардинг
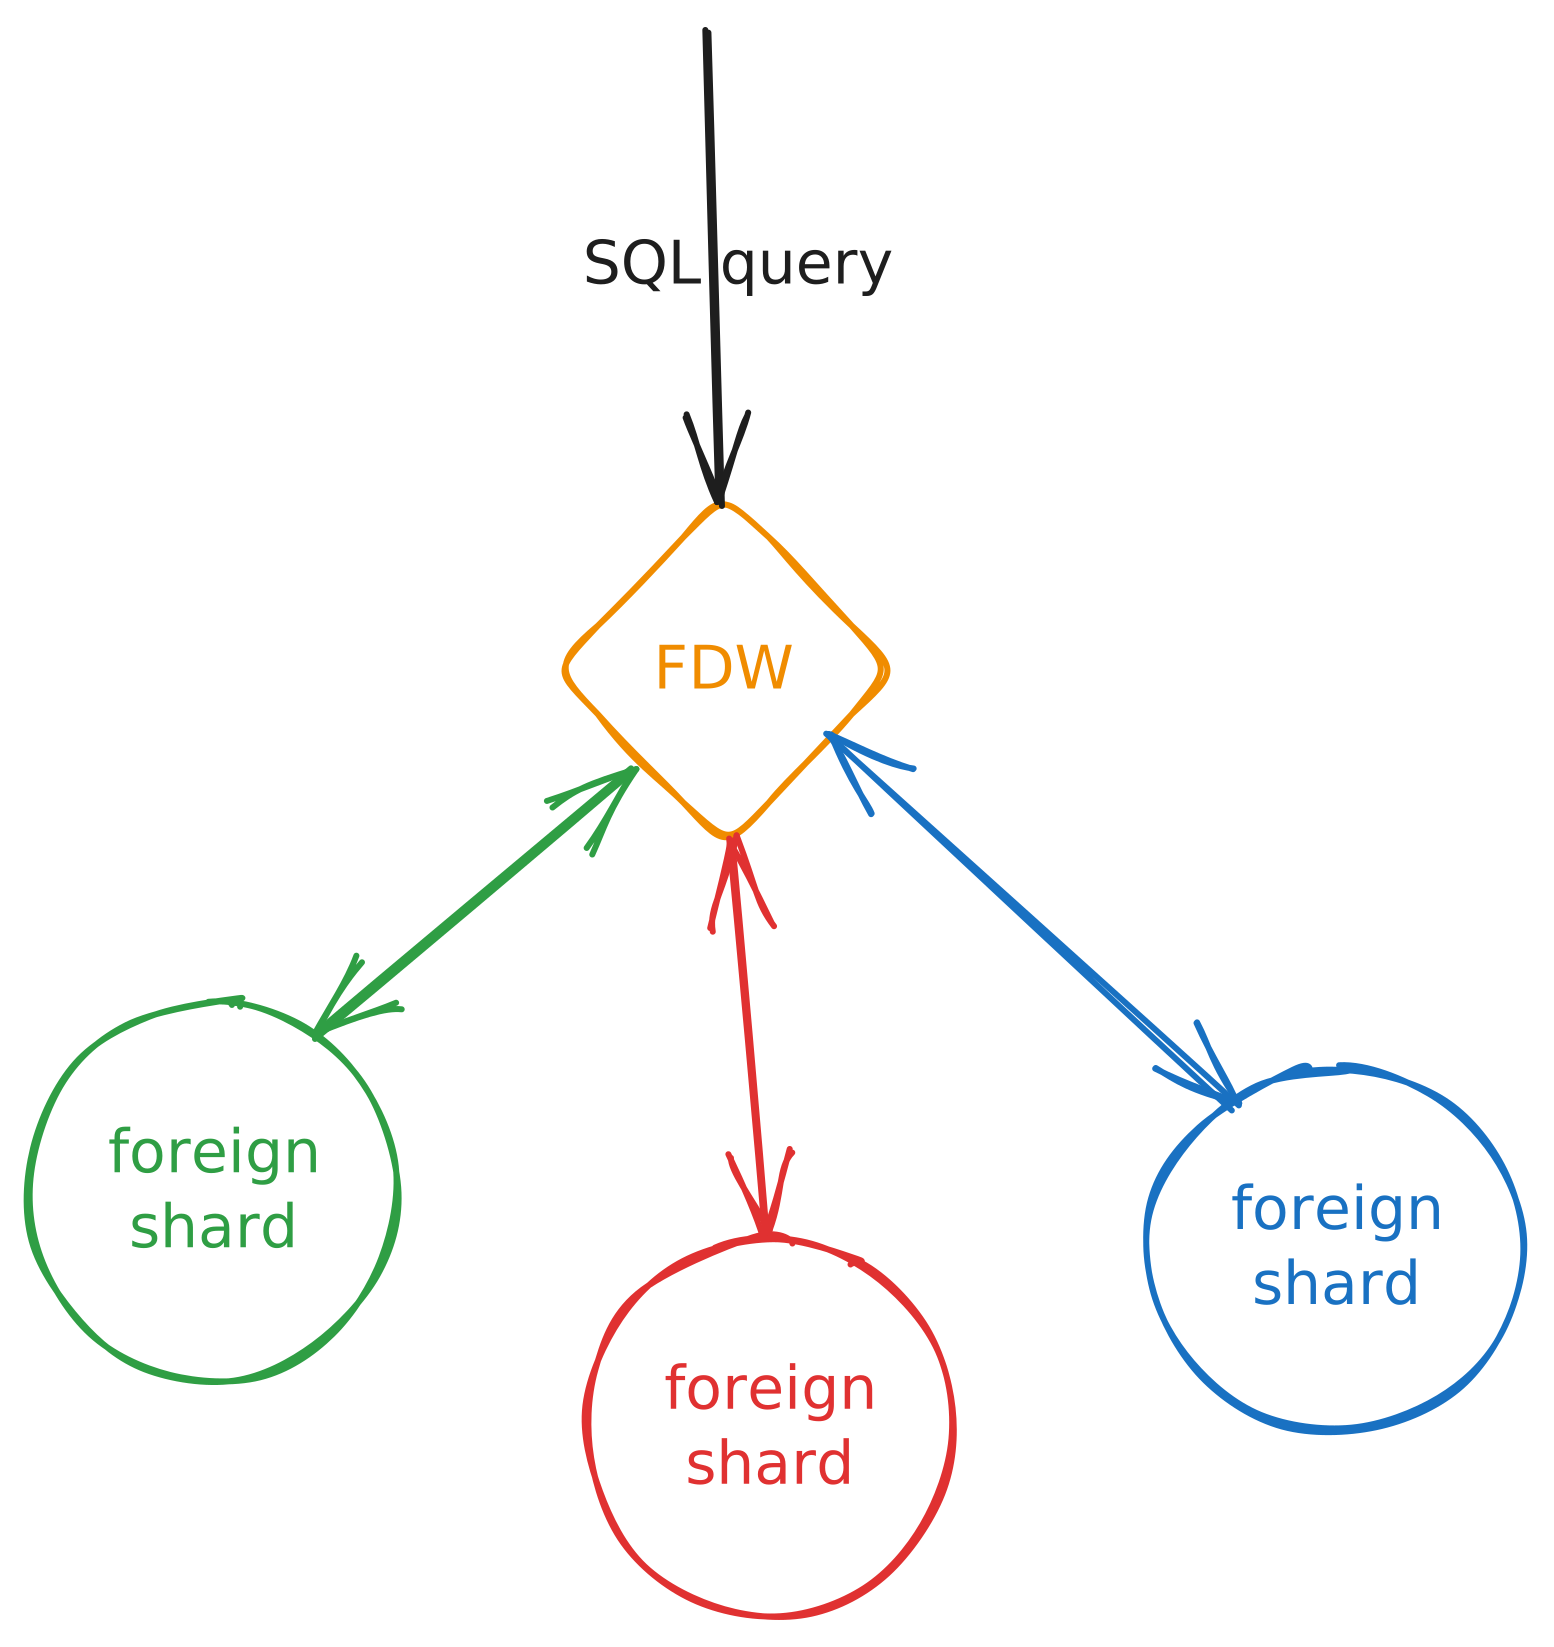
Шардинг в базе данных - это возможность горизонтального разделения данных на несколько шардов базы данных. В то время как функция разделения позволяет разбить таблицу на несколько таблиц, шардинг позволяет разделить таблицу таким образом, чтобы ее части находились на внешних серверах.
Для реализации шардинга в PostgreSQL используется подход Foreign Data Wrappers (FDW), но он все еще находится в стадии разработки.
Citus - это расширение PostgreSQL с открытым исходным кодом, позволяющее достичь горизонтальной масштабируемости за счет шардинга и репликации. Одним из ключевых преимуществ Citus является то, что это не форк, а именно расширение, что позволяет ему быть синхронизированным с релизом сообщества. В отличие от этого, многие другие форки PostgreSQL часто отстают от релиза сообщества в плане обновлений и возможностей.
ZigZag Join
Ранее мы уже обсуждали логические объединения (left join, right join, inner join, cross join, full join). Они являются логическими в том смысле, что это простые соединения, которые мы пишем в наших SQL-кодах. Существует еще одна категория объединений, называемая физическими объединениями. Физические соединения представляют собой реальные операции соединения, которые выполняет база данных для объединения данных. К ним относятся Nested Loop Join, Hash Join и Merge Join. Вы можете воспользоваться функцией explain, чтобы увидеть, какой тип физического соединения использует база данных в плане выполнения логического соединения, определенного в SQL.
ZigZag join - это стратегия физического соединения, которую можно рассматривать как более производительное вложенное циклическое соединение. Предположим, что у нас есть таблица следующего вида:
create table vehicle(id integer primary key, tires integer, wings integer);
create index on vehicle(tires);
create index on vehicle(wings);
И у нас есть такой запрос select:
select * from vehicle where tires = 0 and wings = 1;
Без Zig-Zag join это было бы сложной задачей, поскольку, используя в плане соединения один из вторичных индексов и первичный индекс, мы все равно должны получить много записей, если у нас возникла такая ситуация:
- есть много автомобилей с шинами = 0, или крыльями = 1
- но не много автомобилей, у которых и шины = 0, и крылья = 1.
ZigZag join может использовать оба индекса для уменьшения количества обрабатываемых записей:
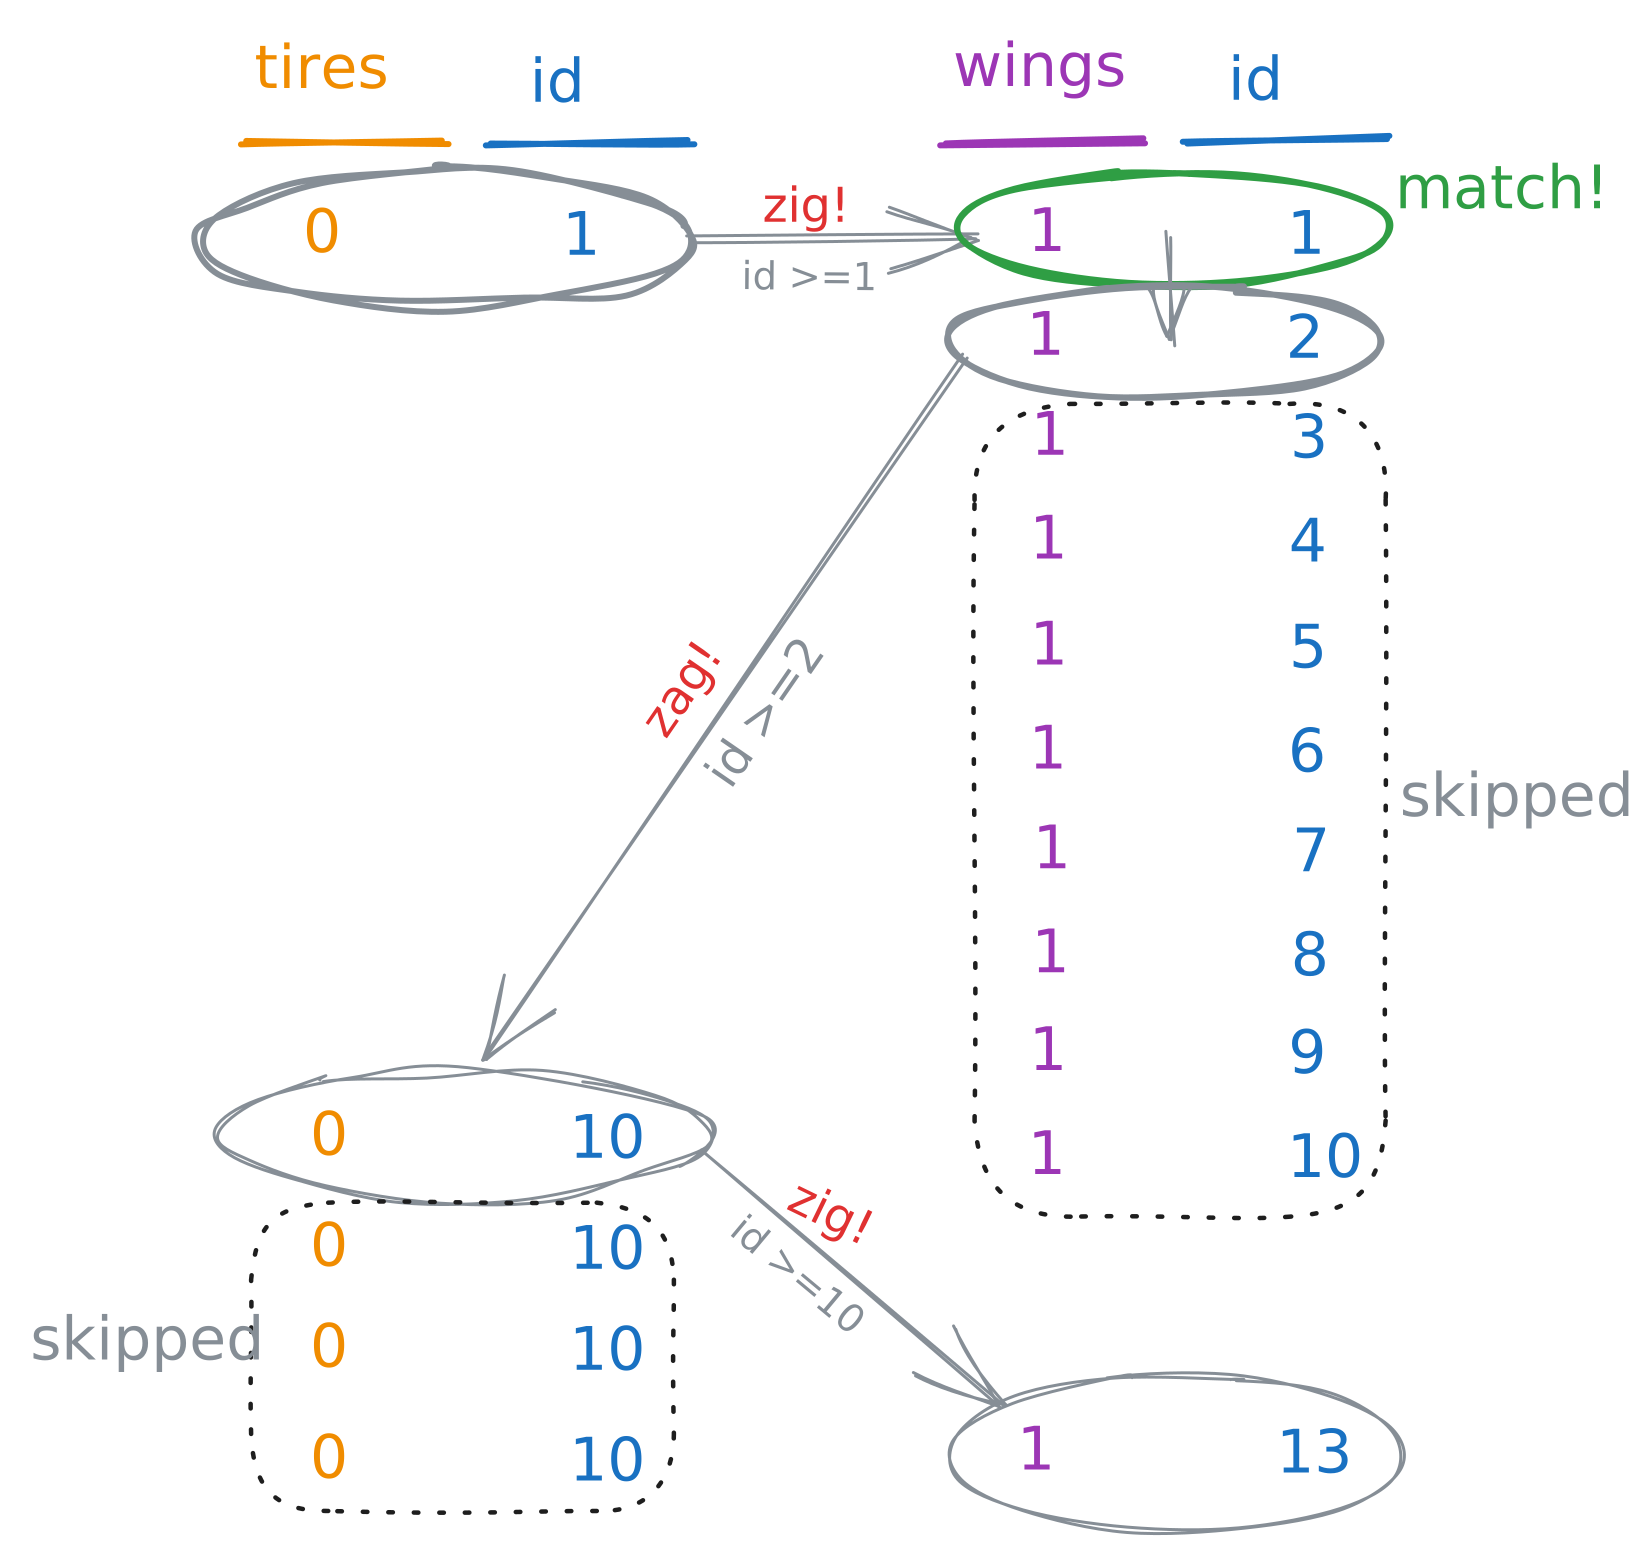
В zig-zag join, показанном на рисунке выше, мы постоянно переключаемся между вторичными индексами, сравнивая их с первичным индексом:
- Сначала мы смотрим индекс tires на предмет значений tires = 0. Первый id равен 1. Поэтому нам нужно перескочить (zig) на другой индекс и искать строки, где id = 1 (match) или id > 1 (skip). В общем случае мы переходим к строке, в которой id >= 1.
- Переходим по zig к индексу крыльев, и поскольку id = 1, значит, мы нашли совпадение. Можно смело искать следующую запись того же индекса.
- Следующая запись имеет id = 2. Переходим по zig к индексу tires, где id >= 2.
- Текущая запись имеет id = 10. Это не совпадение, но мы уже пропустили много записей.
- Снова переходим к индексу wings, ищем записи, в которых id >= 10.
- И так далее...
MERGE
Merge условно вставляет, обновляет или удаляет строки таблицы, используя источник данных:
merge into customer_account  as ca
using recent_transactions as tx
on tx.customer_id = ca.customer_id
when matched then
  update set balance = balance + transaction_value
when not matched then
  insert (customer_id, balance)
  values (t.customer_id, t.transaction_value);
С помощью merge мы упрощаем несколько операторов процедурного языка до одного оператора merge.
Триггеры
Триггеры - это механизм в PostgreSQL, который позволяет выполнять функцию до, после или вместо операции при наступлении определенного события в таблице. Этими событиями могут быть insert, update, delete или truncate. Триггерные функции имеют доступ к специальным переменным, которые хранят данные как до, так и после редактирования, поэтому они более мощные, чем проверочные ограничения:
create trigger log_update
    after update on system_actions
    for each row
    when (NEW.action_type = 'sensitive' or OLD.action_type = 'sensitive')
    execute function log_sensitive_system_action_change();
Как видите, в предложении when можно ссылаться на столбцы значений старой и/или новой строки, записывая OLD.column_name или NEW.column_name соответственно.
Grouping sets, Cube, Rollup
Представьте, что Вы хотите увидеть сумму зарплат сотрудников различных отделов в зависимости от их пола. Один из способов сделать это - использовать несколько предложений group by и затем объединить строки с результатами:
  select dept_id, gender, SUM(salary) from employee group by dept_id, gender
union all
  select dept_id, NULL, SUM(salary)   from employee group by dept_id
union all
  select NULL, gender, SUM(salary)    from employee group by gender
union all
  select NULL, NULL, SUM(salary)      from employee;

-- dept_id  gender  sum
--
-- 1        M       1000
-- 1        F       1500
-- 2        M       1700
-- 2        F       1650
-- 2        NULL    3350
-- 1        NULL    2500
-- NULL     M       2700
-- NULL     F       3150
-- NULL     NULL    5850
Однако это будет неудобно, если мы хотим получить отчет о сумме зарплат для разных групп данных. Grouping sets позволяют написать более простой запрос. Эквивалент приведенного выше запроса с использованием grouping sets будет выглядеть следующим образом:
select dept_id, gender, SUM(salary) from employee
group by
  grouping sets (
        (dept_id, gender),
        (dept_id),
        (gender),
        ()
      );
Существует два типа grouping sets, каждый из которых имеет свой собственный синтаксиc, обусловленный их общим использованием: rollup и cube.
rollup (e1, e2, e3, ...)
является эквивалентом:
grouping sets (
    ( e1, e2, e3, ... ),
    ...
    ( e1, e2 ),
    ( e1 ),
    ( )
И
cube ( a, b, ... )
является эквивалентом:
GROUPING SETS (
    ( a, b, c ),
    ( a, b    ),
    ( a,    c ),
    ( a       ),
    (    b, c ),
    (    b    ),
    (       c ),
    (         )
)
Grouping sets могут также быть скомбинированы вместе:
group by a, cube (b, c), grouping sets ((d), (e))

-- equivalent:

group by grouping sets (
    (a, b, c, d), (a, b, c, e),
    (a, b, d),    (a, b, e),
    (a, c, d),    (a, c, e),
    (a, d),       (a, e)
)
Далее: Уровень 4 Зона полуночи: Денормализация, SELECT FOR UPDATE, звездные схемы, ...


