

Эксплуатация и операционная модель: SRE, SLA, аварийные планы
В этой главе рассматриваются вопросы эксплуатации Apache Kafka как критической части инфраструктуры потоковой передачи данных. Обеспечение доступности, предсказуемости задержек и сохранности данных требует объединения инженерной дисциплины SRE, формализации SLA/SLO, четких планов аварийного восстановления и автоматизации операционных процессов. Мы сфокусируемся на архитектурных принципах, конфигурациях, метриках наблюдаемости и процедурах реагирования на инциденты, которые позволяют строить надежные потоковые системы интеграции данных.
Цель главы - выработать практический набор подходов, применимых в реальных организациях: как формулировать SLA и SLO для Kafka-экосистемы, какие метрики считать критическими, как проектировать DR-архитектуру и как выстраивать операционную модель вокруг процессов релизов, изменений и реагирования на происшествия.
- Определение SLA/SLO для потоковых сервисов: параметры доступности, задержек и сохранения данных.
- Мониторинг и телеметрия Kafka: ключевые метрики, алерты, уровни SLI/SLO.
- Планы аварийного восстановления: DR-архитектура, тестирование и процедуры восстановления.
- Процессы эксплуатации: инцидент-менеджмент, управление изменениями, автоматизация.
Архитектура эксплуатации Kafka
Архитектура эксплуатации должна учитывать особенности работающих кластеров: как обеспечивается устойчивость к сбоям, как происходит выбор ведущего брокера и синхронизация копий, какие конфигурации минимизируют риск потери данных и задержек.
Узлы, репликация и устойчивость
Кластер Kafka строится вокруг набора брокеров, которые хранят данные в логах и обрабатывают запросы продюсеров и консумеров. Основной механизм устойчивости - репликация разделов (партиций) между брокерами и поддержка множества реплик в ISR (in-sync replicas). В случае сбоя лидера одной партиции выбирается новый лидер из числа реплик в ISR, что позволяет минимизировать время простоя. В современных версиях можно строить как традиционные кластеры с Zookeeper, так и автономные кластеры на базе KRaft, где управление метаданными встроено в брокеры.
Из операционной точки зрения критически важно правильно выбрать фактор репликации (replication.factor) и минимальное число синхронных копий (min.insync.replicas). Неправильно подобранные параметры приводят к ситуации “unclean leader election” - когда устойчивая копия оказывается недоступной для лидерской роли, что может повлечь потерю данных или нарушение доступности. Также следует учитывать политику выбора лидера и стратегию отключения клиента от сбоев (unclean.leader.election.enable) в случае необходимости.
Конфигурация и режимы обновления
Эффективная эксплуатация требует понятной политики изменений и обновлений. Rolling-обновления брокеров позволяют минимизировать простои, но требуют точной координации: планирование окна обслуживания, последовательность обновлений, управление удаленным резервным копированием и согласование версий компонентов экосистемы (Kafka, Zookeeper/KRaft, связанное ПО). Необходимо настроить обработку корректного завершения работы брокеров (controlled shutdown), а также обеспечить сохранность конфигураций и параметров логирования.
Ключевые конфигурации, влияющие на эксплуатацию, включают log.dirs, log.retention. и log.segment. параметры, настройки репликации и консистентности, параметры сетевых подключений и масштабирования. В рамках SRE-практик следует фиксировать допустимые пределы задержек (latency budgets) и устанавливать автоматические проверки целостности конфигураций после изменений.
Инструменты наблюдения и автоматизации
Успешная эксплуатация опирается на полноценную телеметрию: метрики XIV и журналы, трассировку и алертинг. Типовой стек включает Prometheus и Grafana для мониторинга, JMX-битые метрики брокера, а также отдельные панели для ISR-рисков, подмножества устаревших партиций, задержек консьюмеров и пропускной способности топиков. Для автоматизации часто применяют инфраструктурный код (IaC) и конфигурационный менеджмент: Terraform/Ansible или Terraform/Helm в сочетании с Kubernetes, если кластер размещен в контейнеризированной среде. Вопросы безопасности и секретов требуют интеграции с системами управления ключами и секретами, а также регулярной проверки прав доступа.
## Пример минимального кода на Java для получения информации о кластере через AdminClient
import org.apache.kafka.clients.admin.AdminClient;
import org.apache.kafka.clients.admin.DescribeClusterResult;

import java.util.Properties;
import java.util.concurrent.ExecutionException;

public class KafkaAdminExample {
  public static void main(String[] args) throws Exception {
## Properties props = new Properties();
    props.put("bootstrap.servers", "broker1:9092,broker2:9092");
    try (AdminClient admin = AdminClient.create(props)) {
## DescribeClusterResult result = admin.describeCluster();
      System.out.println("Cluster id: " + result.clusterId().get());
      System.out.println("Controller: " + result.controller().get());
    }
  }
}
Такой пример иллюстрирует базовые действия по получению данных о кластере. В реальной эксплуатации AdminClient применяется для автоматизации аудита конфигураций, проверки статуса узлов, мониторинга изменений и интеграции с процессами CI/CD для конфигураций брокеров и топиков.
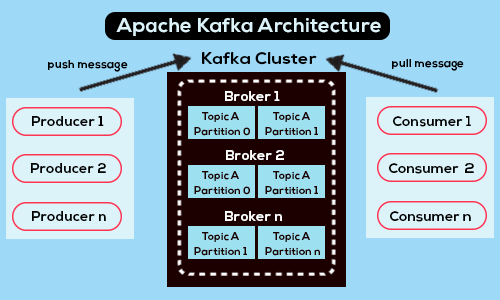
SLA, SLO и требования к данным
Определение SLA и SLO для Kafka-процессов следует привязывать к бизнес-целям и к ожиданиям пользователей от потоковой передачи. SLA может охватывать доступность кластера, время простоя и устойчивость к сетевым сбоям, в то время как SLO конкретизирует допустимую задержку (latency), пропускную способность (throughput), устойчивость к потере данных (durability) и уровень устойчевых копий (ISR). В рамках операций важно также определить RTO (время восстановления) и RPO (потерю данных) для сценариев аварий.
- Доступность кластера: процент времени, в течение которого кластер отвечает на запросы продюсеров и консумеров без критических задержек.
- Время задержек: целевые пределы end-to-end latency для продюсеров/консьюмеров в условиях нормальной работы.
- Сохранность данных: вероятность потери данных в течение заданного периода, учитывая уровень replication и конфигурации min.insync.replicas.
- Время простоя в DR-случае: время, необходимое для восстановления функциональности в другом регионе или кластере.
Эти параметры следует переводить в измеряемые SLI и затем в SLO, для которых устанавливаются пороги в рамках мониторинга. В качестве примера можно использовать следующие ориентиры: доступность кластера > 99.9%, end-to-end latency в пределах нескольких сотен миллисекунд для критичных топиков, минимизация случаев, когда топики оказываются в состоянии offline или с малым ISR. Важно помнить, что SLO для потока данных не может быть одинаковым для всех топиков и потребителей: разные сервисы имеют разные торговые параметры между задержкой и надежностью.
SLA по данным и задержкам
SLA по данным устанавливают требования к сохранности и времени доставки сообщений. Реалистичная архитектура допускает асинхронную природу потоков: потребители должны получать данные своевременно, а продюсеры - иметь понятные гарантии доставки. Принципы, которые применяются на практике:
- Разделение периодов консолидации риска: критические топики должны иметь более высокий replication-factor и min.insync.replicas.
- Контроль непостоянства задержек: SLA для потребителей принимается в виде ориентиров на lag и соответствие Pick/Consuming latency budgets.
- Учет обновлений и конфигураций: планирование изменений должно сопровождаться тестированием на продакшн-образцах и моделированием задержек.
Контроль пропускной способности и capacity planning
Построение операционной модели требует планирования ресурсов: storage, сеть, CPU/RAM, I/O. Раскладывать план следует по следующим аспектам:
- Пропускная способность топиков и средняя задержка на p99/p95.
- Запас по месту в лог-архиве и удаленным директориям log.dirs.
- Влияние конфигураций, таких как retention, segment.ms, и compression.
- Возможности горизонтального масштабирования и автоматического масштабирования.
Мониторинг и инцидент-менеджмент
Этап мониторинга включает в себя сбор метрик, построение SLI/SLO и настройку алертов. В контексте Kafka разумно отслеживать:
- ISR и количество недостающих реплик per топик/partition.
- Поздние и повторяющиеся сбои лидера.
- Трафик продюсеров и консумеров, задержки и задержки репликации.
- Время отклика управляющих запросов к брокерам (describe, alter).
- Кросс-узловое состояние кластера, включая состояние контроллера и доступность брокеров.
Эти данные должны визуализироваться в дашбордах Grafana и подготавливаться к автоматическим алертам на основе SLO. При инцидентах важна процедура эскалации и наличие Runbook’ов с четкими ролями, первым контактам и временными рамками. Пост-инцидент анализ (blameless postmortem) должен служить основой для улучшения архитектуры, конфигураций и процессов.
Метрики и SLI/SLO
- Доступность брокеров и топиков.
- Время восстановления после сбоев (RTO).
- Уровень устойких копий (ISR) и процент недостающих реплик.
- Latency ожидания и задержка для консьюмеров (consumer lag).
- Пропускная способность топиков и throughput.
- Число ошибок в продюсерах и консьюменах, retries.
Эскалация и Runbooks
Эскалация должна быть чётко определена на уровне операции: P1 - остановка бизнес-процессов, P2 - частично ограниченная функциональность, P3 - предупреждение о возможном снижении качества сервиса. Runbooks должны включать:
- Контактные лица и роли на первый и второй уровни поддержки.
- Шаги предварительной диагностики: сбор метрик, проверка состояния узлов и топиков.
- Процедуры исправления и восстановления, включая переключение лидеров, перераспределение топиков и масштабирования.
- Процедуры пост-инцидентного анализа и документов по улучшению.
Аварийные планы и DR
DR-архитектура Kafka должна быть спроектирована для минимизации потери данных и времени простоя в случае событий в регионе или кластере. Рассматриваются несколько подходов: кросс-кластерная репликация двумя способами - синхронной ( MirrorMaker2/похожие механизмы) и асинхронной репликации между регионами. В зависимости от требований бизнеса выбираются активный или активо-пассивный режим, а также архитектура топиков и конфигурации совпадений (topic-level replication policies).
Архитектура DR
- Cross-cluster replication: MirrorMaker2 или сопоставимые решения позволяют синхронно/асинхронно реплицировать топики в DR-кластер. Важно правильно настроить контрольные механизмы, чтобы избежать коллизий при повторной доставке сообщений и дубликатов.
- Географическое разделение топиков: в DR-архитектуре целесообразно размещать критичные топики в обоих кластерах, применяя консистентность и согласованность, учитывая задержки сети между регионами.
- Уровни доступности: определение того, какие сервисы должны быть восстановлены в DR-кластере и какие процессы могут продолжать работу в режиме локального обслуживания.
Планирование и тестирование DR
DR-тестирование должно проводиться регулярно и в условиях, близких к реальным. Включаются тесты на:
- Включение DR-механизмов и переключение потребителей.
- Проверку целостности данных и согласованности между кластерами.
- Тесты производительности после переноса рабочих нагрузок.
Восстановление и миграции
Пошаговые процедуры восстановления включают:
- Оценку состояния DR-кластера и доступности.
- Временное перенаправление продюсеров и консумеров в DR-поддержащий кластер.
- Репликацию новых данных и согласование окончательных ролей лидеров.
- Постепенный возврат к основной инфраструктуре, если это возможно безопасно.
Автоматизация, управление изменениями и безопасность
Эксплуатацию Kafka следует сопровождать формализацией процессов изменений и автоматизацией повторяемых действий. Управление изменениями должно включать оценку рисков, тестирование на стенде, а также планирование и утверждение изменений перед их внедрением в продакшн.
Автоматизация инфраструктуры
Использование IaC позволяет воспроизводить окружения и конфигурации кластеров. Инструменты типа Terraform или Ansible позволяют управлятьProvisioning, масштабированием и стандартными настройками. В Kubernetes-окружениях практикуется использование Helm-чартов для Kafka-брокеров и вспомогательных сервисов.
Управление конфигурациями
Динамические настройки Kafka (dynamic configs) требуют контроля версий и тестирования на стенде. Команды типа kafka-configs.sh и аналогичные инструменты в рамках CI/CD-пайплайна позволяют безопасно изменять параметры, такие как min.insync.replicas, log.retention.hours, и другие важные параметры, не приводя к непредвиденным простоям.
Безопасность и соответствие
Безопасность в операционной модели Kafka охватывает аутентификацию и авторизацию (ACLs, SASL, TLS, Kerberos), шифрование данных и безопасное управление секретами. Регулярная ротация ключей, мониторинг доступа и аудита - часть операционной дисциплины. Важна также настройка безопасных сетевых правил и ограничение прав на изменение конфигураций.
## Пример конфигурации RBAC и TLS-клиента в Kafka (упрощенно)
## Это иллюстративный фрагмент; конкретные параметры зависят от окружения.
listener.security.protocol.map=PLAINTEXT:TOKEN,SSL:SSL
listeners=SSL://broker1:9093
advertised.listeners=SSL://broker1:9093
ssl.keystore.location=/var/security/keystore.jks
ssl.keystore.password=changeit
ssl.key.password=changeit
authorizer.class.name=kafka.security.auth.SimpleAclAuthorizer
allow.everyone.if.no.acl.found=false
Фрагмент демонстрирует принципы безопасной коммуникации и авторизации. В реальных условиях конфигурации должны быть вынесены в секреты и управляться через секрет-менеджеры и IaC-проекты, с соблюдением принципов минимальных привилегий.
Key takeaways
- Эксплуатационная модель Kafka строится на сочетании архитектурных решений, SLA/SLO-управления, мониторинга и автоматизации процессов.
- Важно четко определить параметры replica и ISR, а также политику выбора лидера и обновления конфигураций, чтобы снизить риск потери данных и простоев.
- Наблюдаемость и инцидент-менеджмент должны строиться вокруг SLI/SLO, с понятными Runbooks и blameless postmortems.
- DR-архитектура должна включать кросс-кластерную репликацию и регулярное тестирование восстановления, чтобы гарантировать бизнес-непрерывность.
- Безопасность и управление доступом — неотъемлемая часть операционной модели, требующая автоматизации секретов и аудита доступа.
- Автоматизация инфраструктуры и конфигураций снижает риск ошибок при изменениях и ускоряет реакции на инциденты.
- Планирование capacity и прокачка по-настоящему устойчивых систем требуют тесной связи между инженерами разработки, SRE и бизнес-целями.
FAQ
- Что такое SRE в контексте Kafka и зачем он нужен?
SRE (Site Reliability Engineering) в контексте Kafka отвечает за внедрение надежной операционной модели: мониторинг, управление изменениями, инцидент-управление и непрерывное улучшение архитектуры. Цель — обеспечить предсказуемость сервиса, страхование от сбоев и минимизацию времени простоя, сохраняя контроль над производительностью и качеством обслуживания. В рамках SRE создаются SLI/SLO, руководства по инцидентам и runbooks, а также автоматизация, позволяющая повторно использовать процессы.
- Какие SLA и SLO применимы к Kafka?
Типовые SLA включают доступность кластера, время реагирования на инциденты и сохранность данных. SLOs специфичны для latency и lag консумеров, а также для числа UPS-минусов и срока восстанавливаемости после сбоев. Важно адаптировать параметры под бизнес-требования и характер рабочих нагрузок: критичные сервисы требуют более строгих бюджетов задержек и большего числа реплик.
- Как определить min.insync.replicas и unclean.leader.election?
min.insync.replicas указывает минимальное число реплик, которые должны быть синхронными для того, чтобы запись считалась успешной. Это напрямую влияет на durability. unclean.leader.election.enable управляет тем, разрешено ли кластеру выбирать лидера из не-синхронных копий. В большинстве случаев рекомендуется отключать нечистые лидерские выборы в продакшне, чтобы снизить риск потери данных, либо включать их только в аварийных сценариях, когда нужна доступность.
- Какие DR-стратегии применимы к Kafka?
DR-стратегии включают кросс-кластерную репликацию (MirrorMaker2 или аналог) и архитектуру с географическим резервом. В активном-активном режиме возможно реплицирование между регионами, однако это требует синхронизаций и корректного разрешения дубликатов. В активном-пассивном режиме DR-кластер становится сайтом-резервом и активируется только при аварии.
- Какие метрики критичны для мониторинга Kafka?
Ключевые метрики включают доступность брокеров, состояние ISR, количество незавершенных реплик, задержки (latency) продюсеров и консьюмеров, throughput по топикам, и долю топиков, находящихся в offline. Также важно мониторить состояние контроллера и общую нагрузку на сеть и диск.
- Как проводить тестирование DR-процедур?
DR-тестирование следует проводить регулярно, симулируя сценарии сбоев в регионе, переключение на DR-кластер, проверку целостности данных и производительности после переноса. Результаты тестов документируются и используются для обновления планов и runbooks.
- Как управлять изменениями в конфигурациях Kafka без риска простоя?
Использовать IaC и предварительную версию тестовой среды. Прежде чем применить изменения в продакшн, выполнить тестирование на стенде, задокументировать rollback-планы и применить стратегию canary/rolling update. В продакшне критические параметры (min.insync.replicas, replication.factor, security settings) должны обновляться через согласованный процесс утверждений и автоматизированные проверки.
- Какие практики безопасности важны для эксплуатации Kafka?
Важно обеспечить аутентификацию и авторизацию (SASL/TLS, Kerberos, ACLs), секреты и ключи — через секрет-менеджеры, регулярную ротацию. Также следует ограничивать сетевые доступы и осуществлять аудит операций конфигураций и изменений.
- Когда целесообразно переходить на KRaft вместо Zookeeper?
KRaft упрощает архитектуру, устраняет зависимость от внешнего Zookeeper и упрощает управление метаданными. Рекомендовано рассматривать переход на KRaft по мере зрелости версии и совместимости ваших сервисов. В существующих кластерах Zookeeper остаются валидной опцией, если миграция сложна или не соответствует текущему циклу выпуска.


