

Архитектура Apache Spark: компоненты, роли, жизнь задач
Apache Spark представляет собой распределенную вычислительную платформу, построенную вокруг концепций DAG-плана, гибкой памяти и мощного исполнителя. Архитектура Spark сочетает в себе моменты параллелизма на уровне задачи, эффективную обработку данных через DataFrame и Spark SQL, а также механизмов обмена данными между узлами, которые позволяют работать с терабайтами данных в реальном времени и в пакетном режиме. В нашей практике Data Engineer это значит не только понимать, как работает Spark внутри каждой нити исполнения, но и как правильно конфигурировать кластер, как строить устойчивые ETL/ELT пайплайны и как интегрировать Spark с современными Lakehouse-платформами.
В этой главе мы сосредоточимся на технических деталях архитектуры Spark: какие компоненты образуют ядро платформы, какую роль выполняют драйверы и исполнители, как устроен жизненный цикл задач, какие протоколы используются для обмена данными, какие схемы планирования применяются и какие механизмы обеспечивают устойчивость и мониторинг в продакшене. Особое внимание уделим тем аспектам, которые directly влияют на проектирование ETL/ELT пайплайнов: схемы выполнения, управление памятью, shuffle и данные в Parquet, а также интеграциям с Lakehouse и аналитическими платформами.
- Ключевые концепты архитектуры Spark и их взаимосвязь в контексте ETL/ELT
- Роли драйвера, исполнителей и менеджеров кластера
- Жизненный цикл задач: от DAG до выполнения и обратной связи
- Протоколы обмена данными, сериализация и управление памятью
- Интеграции с источниками данных, форматами и Lakehouse
- Диагностика, мониторинг и оптимизация производительности
Архитектура Spark: базовые компоненты и их роли
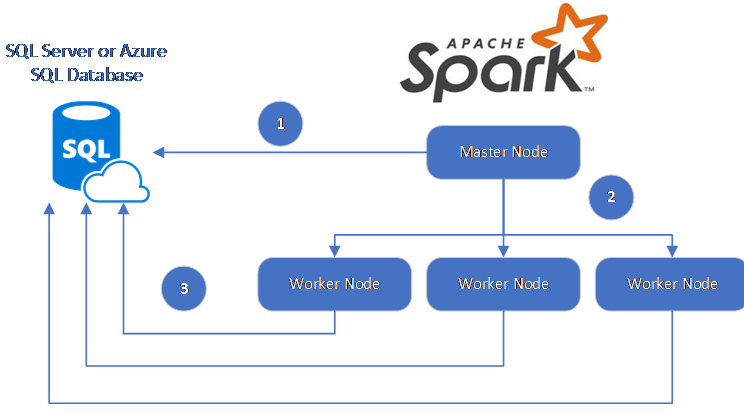
Основной концептуальный узел Spark - это Driver, который отвечает за планирование и координацию выполнения. Драйвер держит SparkContext (или SparkSession в рамках высшего уровня API) и строит логическую и физическую цепочку задач. В реальном кластере драйвер может размещаться на выделенной машине или в рамках одного из узлов, в зависимости от режима развертывания.
Исполнители - это JVM-процессы на узлах кластера, которые выполняют задачи, получаемые от планировщика. Каждый исполнитель имеет локальное пространство памяти, которое разделяется между хранением данных (persist, cache) и вычислениями. Управление памятью исполнителей - ключ к эффективной обработке больших наборов данных: неэффективная конфигурация приводит к OutOfMemoryError или частой перераспределению памяти и сбоям.
Ключевые механизмы коммуникаций и обмена данными осуществляются через сетевые протоколы RPC, организованные с помощью Netty. Взаимодействие между драйвером, планировщиком и исполнителями требует минимальной задержки и высокой пропускной способности, особенно для shuffle-процессов и передачи больших блоков данных между узлами.
Существует несколько режимов развертывания кластера: Standalone, YARN, Kubernetes и Mesos. Каждый режим имеет свои особенности по управлению ресурсами и интеграции с существующей инфраструктурой. В продуктивной среде выбор режима влияет на стратегию эластичности, планирования ресурсов и межкластерной совместимости. В рамках Spark SQL и DataFrame-API в архитектуру добавляются модули Catalyst и Tungsten: Catalyst - оптимизатор запросов, который преобразует исходный план в эффективный физический план; Tungsten - движок выполнения, ориентированный на эффективную работу с памятью и нативной реализацией операций над данными.
BlockManager отвечает за хранение распределённых блоков данных на узлах кластера и координацию чтения/записи между исполнительными процессами. Именно блоки данных и их перемещение по сети лежат в основе shuffle-операций - механизмов перераспределения данных между стадиями вычислений. Важной частью также является ShuffleManager: он решает, как именно будет осуществляться запись и считывание промежуточных данных. В современных конфигурациях часто применяется External Shuffle Service (ESS) для обеспечения устойчивости к перераспределению памяти и задержкам при обновлении исполнителей.
Сердцем обработки данных в Spark SQL является Catalyst - мощный аналитический оптимизатор, который применяет правила преобразования и перестраивает план запроса для минимизации затрат. Вместе с ним работает Tungsten - реализация физического исполнения и памяти: в рамках Tungsten реализованы улучшенные структуры памяти, безопасные операции и векторизация вычислений. Эти технологии позволяют Spark достигать высокой производительности при работе с большими таблицами в Parquet, ORC и других колоночных форматах.
DataSource API и DataSourceV2 расширяют возможности интеграции с различными источниками данных, включая Parquet, ORC, JDBC, NoSQL-решения и файловые хранилища в рамках Lakehouse-архитектуры. Это позволяет единообразно работать с данными, независимо от формата и физического размещения, и обеспечивает гибкую схему эволюции данных.
Понимание архитектуры Spark требует осознания баланса между вычислениями и хранением. Режимы исполнения, динамическая настройка памяти и кэширование данных влияют на общую производительность пайплайнов. В частности, концепции unified memory management, storage memory и.Execution Memory есть важные различия: часть памяти выделяется под хранение кэшированных экземпляров и промежуточных результатов, другая часть - под выполнение операторов. Эффективное управление этой областью критично для стабильности и предсказуемости поведения пайплайнов в условиях пиковых нагрузок.
Оптимизация взаимодействий с данными часто начинается с выбора форматов и источников. Parquet обеспечивает компрессию и колоночное хранение, поддерживает predicate pushdown и статистику, что существенно снижает объем считанных данных и ускоряет сканирование. Delta Lake, Iceberg и Apache Hudi - примеры решений для организации обновляемых таблиц в Lakehouse-архитектуре, которые добавляют ACID-операции, управление версиями и эффективный контроль схем.
<примечание> Для более глубокой цветовой схемы в продакшене полезно помнить: выбор форматов и источников следует сочетать с требованиями к консистентности, скорости загрузки и потребностям в аналитических запросах. В сочетании с адаптивным выполнением (Adaptive Query Execution) Spark может подстраивать план во время выполнения в зависимости от характеристик данных, что существенно снижает нагрузку на кластер и ускоряет обработку.
<при>Пример конфигурации памяти и shuffle-поведения может оказаться полезным в контексте архитектуры, однако здесь мы ограничимся концептуальными объяснениями и общими рекомендациями по настройке.</при>
Жизненный цикл задачи: от DAG к выполнению и обратной связи
Каждый запущенный пайплайн Spark формирует граф задач (DAG) из зависимостей между операциями. Драйвер получает логический план, который затем конвертируется в физические стадии и задачи. В процессе выполнения Spark разбивает работу на стадии, каждая из которых состоит из множества задач, которые распараллеливаются по executors. Такой подход позволяет максимально использовать параллелизм и минимизировать задержки при выполнении больших данных.
DAGScheduler занимается созданием и перераспределением DAG-циклов в случае сбоев или изменения доступности ресурсов. Он координирует стадии, отвечает за объединение задач в локальные группы, которые затем отправляются TaskScheduler’у. TaskScheduler - это механизм, который распределяет задачи по доступным executors с учётом локальности данных, нагрузки на узлы и предельных сроков. В рамках этой архитектуры важна поддержка локальности: если данные уже находятся на конкретном узле, планировщик постарается вынести обработку на этот узел, чтобы минимизировать сетевые перемещения.
В процессе выполнения Spark применяет оптимизации на уровне плана выполнения, включая WholeStageCodegen - стратегию компиляции целиком нескольких операторов в единый код на лету. Это позволяет значительно снизить накладные расходы на сериализацию и интерпретацию между операторами. Включение или отключение WholeStageCodegen зависит от характера задач: для сложных пайплайнов с множеством цепочек трансформаций это обычно даёт заметный прирост производительности.
С точки зрения устойчивости жизненный цикл задач подразумевает обработку ошибок и повторные попытки. При временных сбоях или перегреве узлов Spark способен автоматически переназначать задачи на другие executors. В случае устойчивых сбоев сценарий может включать перераспределение стадий между узлами кластера и повторную попытку выполнения. Для продакшн-систем важна поддержка checkpoint и возможность восстановления состояния в случае длительных пайплайнов.
Контроль за исполнением включает сбор метрик и логов. Spark UI предоставляет прозрачный обзор по стадиям, задачам, времени выполнения и распределению ресурсов. В продакшене критично настраивать сборку логов, хранение Event Logs и интеграцию с системами мониторинга (Prometheus, Grafana) для быстрого реагирования на аномалии.
Планировщик и исполнение: как Spark превращает план в задачи
Двухуровневый подход к планированию - DAGScheduler и TaskScheduler - позволяет гибко управлять ресурсами и адаптироваться к изменяющимся условиям выполнения. DAGScheduler отвечает за подготовку графа задач, определяет зависимости и группы заданий в стадии. TaskScheduler занимается фактическим распределением задач по executors и обработкой очередей задач.
Важно различать Logical Plan (логический план) и Physical Plan (физический план). Spark сначала превращает запросы в логическую операцию над данными (на уровне DataFrame/RDD), затем применяет оптимизации Catalyst и формирует физический план, который затем исполняется. В рамках этого процесса возможна адаптивная оптимизация - Adaptive Query Execution (AQE) - которая позволяет Spark перераспределять ресурсы и перестраивать план в ходе выполнения в зависимости от реальных характеристик данных (размера и количества записей, распределения skew, особенностей файлового формата).
Memory management в рамках планирования играет критическую роль. Unified Memory Management разделяет память на две области: execution memory (для операций вычисления) и storage memory (для кэширования и хранения промежуточных результатов). Этому соответствуют параметры spark.memory.fraction и spark.memory.storageFraction, которые требуют аккуратной настройки под рабочие нагрузки ETL/ELT пайплайнов. Неоптимальная настройка может привести к частым перераспределениям памяти, частичным сбоям и ухудшению задержек.
Особый акцент ставится на настройках, связанных с shuffled процессами. В зависимости от характера нагрузки, можно выбрать стратегию shuffle, указывая параметры spark.shuffle.manager, spark.shuffle.compress, spark.shuffle.file.buffer и другие. Неправильная настройка может привести к перегрузке сети и задержкам, особенно при перераспределении больших объемов данных между стадиями.
Планировщик Spark учитывает локальность данных и возможность перераспределения нагрузки. В сложных пайплайнах с большим количеством источников данных и разнообразными узлами кластера критично тщательно продумать масштабируемость, а также динамическую подкачку узлов (Dynamic Allocation), чтобы избежать переполнения и неэффективного использования ресурсов. Правильная конфигурация динамического масштабирования помогает поддерживать устойчивые latency-профили в периоды пиковых нагрузок.
Обмен данными, сериализация и shuffle: протоколы и механизмы
Обмен данными между узлами - один из самых критичных факторов производительности в Spark. Промежуточные данные между стадиями обычно записываются как файлы shuffle на локальных дисках узлов и затем читаются с соседних узлов. Эффективность этого процесса зависит от того, как организована сериализация и как управляются буферы и сетевые каналы. По умолчанию используются Java- сериализация и Kryo как альтернативы, с возможностью отключения или включения Unsafe-оптимизаций для ускорения обработки. Применение Unsafe и нативной памяти может давать значительный выигрыш, но требует внимательного тестирования и корректной совместимости версий JVM.
BlockManager - ключевой компонент, ответственный за хранение блоков данных в памяти и на диске. Он координирует передачу блоков между executors с помощью shuffle-сервисов и сетевых вызовов. Shuffle-процессы - это не просто перемещение данных, это этап, на котором данные перераспределяются между задачами, часто требуя сортировки и объединения локальных сегментов. Эффективная организация shuffle-процесса часто достигается за счет выбора между sort-based shuffle и hash-based shuffle, контроля размера блоков, конфигурации уровня параллелизма и параметров сети.
External Shuffle Service (ESS) - механизм поддержки устойчивости к переразделению памяти, позволяющий executors продолжать хранение промежуточных данных, даже если сам executor перезапускается. Это важно в длинных пайплайнах, где перезапуск нескольких задач может быть неизбежен, и требует минимизации повторной переработки данных.
Контроль над сериализацией и форматами хранения оказывает влияние на производительность. При обработке конвейерных операций через DataFrame и Spark SQL особенно полезно использовать колоночные форматы на входе (Parquet, ORC), которые поддерживают predicate pushdown и быстрые сканирования. В рамках проекта Lakehouse хорошей практикой является применение единых источников данных и версий таблиц, чтобы обеспечить консистентность и возможность восстановления.
Кроме того, важной практикой является использование broadcast переменных для небольших таблиц, чтобы избежать лишних shuffle-операций. В больших пайплайнах следует учитывать баланс между broadcast и обычным join-операциями, чтобы не перегружать сеть и не вызывать переполнения памяти.
Интеграции с данными и источниками: DataFrame, Parquet, Lakehouse
DataFrame и Spark SQL представляют собой высокоуровневые абстракции, которые скрывают сложность низкоуровневых RDD-операций и позволяют писать эффективные конвейеры обработки. Важным элементом является DataSource API и новая парадигма DataSourceV2, которая обеспечивает расширяемость и удобство подключения к различным источникам: файловым системам (HDFS, S3, ADLS), форматом Parquet, ORC, JDBC и NoSQL. В рамках ETL/ELT пайплайнов это позволяет строить устойчивые конвейеры над стабильными интерфейсами доступа к данным.
Parquet - один из наиболее часто используемых форматов хранения из-за своей колоночной структуры и эффективности с точки зрения сжатия и пропуска строк. Predicate pushdown и статистика файлов позволяют Spark значительно уменьшать объём данных, проходящих через план выполнения. В рамках Lakehouse часто применяются дополнительные слои: Delta Lake, Apache Hudi, Apache Iceberg, которые добавляют ACID-операции, версионирование и схематическую эволюцию. Эти решения позволяют вести эволюцию схем в условиях высоконагруженной аналитики и обновления данных, что является неотъемлемой частью современных пайплайнов.
Интеграции со сторонними аналитическими платформами и инструментами бизнес-аналитики часто строятся на уровне SQL-ступеней и DataFrame API. В частности, Spark может работать как источник/потребитель данных для аналитических витрин, BI-платформ и сервисов Data Lake. В этом контексте архитектура Spark становится основой для построения единой архитектуры данных: ingestion - хранение - аналитика - аналитическая витрина. Важно обеспечить прозрачность и совместимость версий, особенно в сценариях, где данные синхронно поступают в Lakehouse и потребляются из BI-инструментов.
Из практических аспектов следует выделить важность тестирования пайплайнов на различных источниках данных и форматах. Рекомендовано использовать единые наборы тестовых данных и версионирование схем, чтобы гарантировать предсказуемость поведения конвейеров при миграциях форматов, изменений в источниках данных или обновлениях Spark.
Мониторинг, диагностика и оптимизация архитектуры
В продакшене ключевыми являются наблюдаемость и предсказуемость поведения пайплайнов. Spark UI предоставляет детальный разбор по стадиям и задачам, включая временные метрики, количество чтений, записи, shuffle-операций и план выполнения. Аналитики и инженеры должны использовать это для быстрого выявления узких мест: например, стадий с высоким временем ожидания, большого количества задач с зависимостями или нестабильного поведения в связи с skew-данными.
Мониторинг включает сбор метрик через Prometheus/Grafana, интеграцию журналирования и анализа gc-логов JVM. Принципы устойчивости к изменениям нагрузки требуют правильной настройки параметров памяти, сбоев и планирования. Ряд рекомендаций для оптимизации:
- Настроить adaptive execution (spark.sql.adaptive.enabled = true) для динамического перераспределения ресурсов и адаптивного выбора стратегий исполнения.
- Настроить уровень параллелизма: spark.default.parallelism и spark.sql.shuffle.partitions, учитывая объём данных и ресурсы кластера.
- Уточнить параметры памяти executors: spark.executor.memory, spark.memory.fraction и spark.memory.storageFraction для баланса между кешированием и вычислениями.
- Включить WholeStageCodegen, чтобы снизить накладные расходы на интерпретацию и повысить производительность.
- Поддержать устойчивость к сбоям: настройка dynamic allocation, если доступна автоматическая подкачка узлов, и ESS для сохранения промежуточных данных.
- Настроить сетевые параметры: spark.network.timeout и spark.rpc.message.maxSize для стабильной коммуникации в условиях больших конвейеров.
- Продумывать стратегию кэширования: что именно кэшировать, на какой стадии и для каких пайплайнов. Избыточное кэширование может привести к OOM, а неэффективная кэш-полоса - к повторной вычислительной работе.
Практика диагностики включает сборник кейсов, где в каждой задаче есть ясные показатели по времени выполнения, распределению памяти и затратам на shuffle. В рамках ETL/ELT пайплайнов полезно моделировать характер загрузки данных: частые обновления небольшими порциями против больших пакетных загрузок. Это позволяет адаптировать конфигурацию и архитектуру под реальные сценарии.
Взаимодействие Spark с Lakehouse и аналитическими платформами становится эффективным благодаря единообразию интерфейсов и надежному управлению версиями. В таких сценариях критично поддерживать согласованность схем, минимизировать задержки при обновлениях и обеспечивать быструю загрузку данных в витрины. Важным элементом является использование подходов к тестированию в продакшене: A/B-тестирование изменений в конфигурации, мониторинг по KPI и плавный переход между версиями конвейера.
Интеграции и устойчивость к нагрузке: кластеры, управление и отказоустойчивость
Рациональная архитектура Spark требует продуманного развёртывания кластера и управляемости. Kubernetes и контейнеризация позволяют легко масштабировать исполнителей, проводить rollouts обновлений и повышать устойчивость к сбоям. В случаях, когда используемая инфраструктура допускает динамическое масштабирование, динамическое добавление и удаление исполнителей существенно помогают управлять пиками нагрузки и различиями в объёме данных по времени суток.
Управление отказами строится на нескольких уровнях. Записи в журнале событий (Event Logs) и аудит исполнителей позволяют воспроизводить сценарии ошибок и автоматически восстанавливать пайплайны. В практике безопасности и целостности данных это становится критическим для соблюдения соглашений по SLA и гарантирования точности и полноты данных в витринах и Lakehouse.
Кроме того, интеграция с Delta Lake, Apache Iceberg или Apache Hudi обеспечивает ACID-операции и версионирование таблиц, что особенно важно при обновлении больших наборов данных и необходимости отката к предыдущим версиям. В контексте архитектуры Spark это означает, что Spark становится не только средством трансформации и агрегации, но и слоем интеграции между источниками данных и аналитическими витринами.
Наконец, важно помнить о роли мониторинга и управления в реальном времени. В современных архитектурах Spark применяется связка с системами наблюдения и алертинга (Prometheus, Grafana, ELK/EFK-стек), а также с централизованной политикой управления доступом к данным и безопасностью. Это обеспечивает единое представление об операционной эффективности и позволяет быстро реагировать на изменения в нагрузке и внешних условиях.
Key takeaways
- Архитектура Spark объединяет драйвер, исполнителей, кластер-менеджера и набор средств для выполнения вычислительных задач, в том числе Catalyst и Tungsten.
- Жизненный цикл задачи строится вокруг DAG, стадий и задач, с поддержкой оптимизаций WholeStageCodegen и AQE.
- Эффективное управление памятью и shuffle-процессами критично для производительности ETL/ELT пайплайнов.
- DataSourceV2 и Parquet/Apollo-ориентированные форматы обеспечивают гибкость и эффективность интеграций с Lakehouse и аналитическими платформами.
- Мониторинг, диагностика и настройка параметров памяти, параллелизма и сетевых ресурсов необходимы для устойчивости продакшн-конвейеров.
- Интеграции с Delta Lake, Iceberg и Hudi дают возможности ACID и контроля версий в рамках Lakehouse-архитектуры.
- Архитектура Spark требует балансирования между предсказуемостью производительности и гибкостью инфраструктуры: выбор режимов кластера, динамическое масштабирование и отказоустойчивость должны быть встроены в процесс проектирования пайплайнов.
FAQ
- Что такое DAGScheduler и зачем он нужен в Spark?
DAGScheduler отвечает за построение и перераспределение DAG задач на уровне стадий. Он строит граф зависимостей между операциями, распознаёт стыки между задачами и управляет повторными попытками при сбоях. Его задача - превратить логический план в набор условий, которые затем сможет выполнить TaskScheduler, распределяя задачи по executors. Без DAGScheduler Spark не мог бы корректно управлять зависимостями и перераспределением выполнения в условиях изменяющейся конфигурации кластера.
- Как работает планирование задач и локализация данных?
TaskScheduler принимает стадии и задачи, распределяя их по доступным executors с учётом локальности данных. Локальность важна: чтение локальных блоков гораздо быстрее сетевого обмена и уменьшает нагрузку на сеть. Spark предпочитает планировать выполнение там, где данные уже лежат, но при необходимости перераспределяет задачи, чтобы сбалансировать нагрузку и предотвратить узкие места из-за skew в данных.
- Какие механизмы памяти в Spark чаще всего влияют на производительность?
Ключевые элементы - Unified Memory Management: execution memory для операций и storage memory для кэширования. Неправильная настройка может привести к нехватке памяти и частым garbage collection. Важны параметры spark.memory.fraction, spark.memory.storageFraction, а также режим WholeStageCodegen, который влияет на размер и сложность кода, генерируемого во время выполнения, и соответственно на производительность.
- Что такое shuffle-процессы и как их оптимизировать?
Shuffle - перераспределение данных между стадиями; он часто становится узким местом из-за большого объема передачи и операций агрегации/соединения. Оптимизация включает настройку размера блоков, выбор используемого Shuffle Manager (sort-based vs hash-based), включение ESS, настройку уровня параллелизма и баланса между количеством задач и размером данных на задачу. Эффективный shuffle значительно сокращает задержки и улучшает пропускную способность пайплайна.
- Как выбрать форматы хранения и источники данных для Spark?
Parquet - стандарт де-факто для колоночного хранения благодаря сжатию и predicate pushdown. DataSourceV2 расширяет интеграцию с различными источниками. В Lakehouse-архитектуре часто применяются Delta Lake, Apache Iceberg и Apache Hudi для ACID-операций и версионирования. Выбор зависит от требований к консистентности, обновлениям данных и аналитическим паттернам.
- Какие практики позволяют повысить устойчивость пайплайнов в продакшене?
Включение dynamic allocation и ESS для устойчивости к переразделению и сбоям узлов, мониторинг через Spark UI и внешние панели, включение AQE для адаптивности плана выполнения, а также применение подходов к тестированию и версионированию схем. Важно минимизировать риск сбоев за счет резервирования ресурсов и устойчивого хранения промежуточных данных.
- Как Spark интегрируется с Lakehouse и аналитическими платформами?
Spark служит мощной «мозговой» частью Lakehouse: он обеспечивает ingestion- и трансформационные пайплайны, а затем экспортирует данные в витрины и BI-инструменты. Delta Lake/ Iceberg/ Hudi предоставляют транзакционную целостность и версионность таблиц, что упрощает обновления и откаты. В интеграциях с аналитикой ключевым является единый интерфейс доступа к данным и предсказуемое поведение при обновлениях.
- Какие индикаторы указывают на необходимость оптимизации плана выполнения?
Высокий уровень shuffle, долгие стадии, неравномерное распределение задач, частые задержки из-за IO, частые GC и частые перераспределения памяти - это сигналы к оптимизации. В таких случаях полезно включить AQE, скорректировать spark.sql.shuffle.partitions, изменить конфигурацию памяти, пересмотреть использование кэширования и проверить схему данных.
- Какие практики по архитектуре полезно применять в рамках ETL/ELT пайплайнов?
Прежде всего - проектирование конвейеров с предсказуемой латентностью и устойчивостью к изменениям объема данных. Это включает в себя разумное кэширование данных на этапах трансформации, выбор подходящих форматов хранения, управление версиями таблиц, а также планирование тестирования на реальном объёме данных и мониторинг по SLA. В рамках Lakehouse - единый подход к источникам, форматам и версионированию данных, чтобы минимизировать задержки и риски консистентности.


