

Spark на Kubernetes и в облаке: подходы к развёртыванию
В условиях современных облачных реалий и потребности в многоклиентной обработке данных Kubernetes выступает как платформа для горизонтального масштабирования Spark. Эта глава раскрывает архитектурные принципы развёртывания Spark в Kubernetes и в облаке, сравнивает подходы к управлению ресурсами, безопасности и мониторингу, а также детализирует типовые сценарии применения в ETL и аналитике больших данных. Рассматриваются как концепции, так и практические схемы развёртывания, вместе с примерами конфигураций и связанных интеграций.
Spark в Kubernetes кардинально меняет парадигму доставки ресурсов и жизненного цикла рабочих нагрузок. Вместо жесткой привязки к VM-подобной инфраструктуре теперь используются контейнеры и динамическое масштабирование. Главная идея состоит в том, чтобы вынести логику планирования и исполнения задач на уровень оркестратора, сохранив при этом богатый функционал Spark: поддержка драйвера и исполнителей, управление памятью, shuffle-процессы, вычислительные задачи и сбалансированная работа с данными. В Kubernetes появляется возможность эффективно управлять многорежимными нагрузками, обеспечивать изоляцию и повторное использование ресурсов между различными командами и проектами на одной кластере, а также упрощать интеграцию с облачными сервисами хранения и сетевыми политикам для безопасности и соответствия требованиям.
Краткое содержание главы
- Архитектура развёртывания Spark на Kubernetes: роли драйвера и исполнителей, взаимодействие с API Kubernetes, принципы динамического выделения ресурсов и альтернативы через Spark Operator.
- Конфигурации, протоколы и инфраструктурные требования: какие параметры Spark и Kubernetes критичны для устойчивого исполнения, сетевые принципы и безопасность.
- Интеграции и сценарии облачного развёртывания: выбор платформы (EKS/AKS/GKE), хранение данных, IAM и секреты, управление версиями образов и политики обновления.
- CI/CD, мониторинг и безопасность: pipeline-видение развёртывания, инструменты наблюдаемости, подходы к безопасности и соответствию.
- Практические паттерны развёртывания для ETL и аналитики: типовые решения, характерные конфигурации и сценарии эксплуатации.
Архитектура развёртывания Spark на Kubernetes
Современная архитектура развёртывания Spark на Kubernetes опирается на две ключевые концепции: управляемые ресурсы Kubernetes и управляющий слой Spark, который координирует выполнение задач через драйвер и набор исполнителей. В режиме cluster драйвер запускается в отдельном поде и управляет executors как подами в кластере. В некоторых сценариях применяется Spark Operator, который реализует абстракцию SparkApplication, упрощает повторное использование конфигураций и упрощает управление жизненным циклом рабочих нагрузок.
- Драйвер: отвечает за планирование задач, сбор результатов и управление функциональностью Spark. В Kubernetes он обычно выполняется как отдельный под и может работать с сервисной учетной записью для доступа к ресурсам кластера.
- Исполнители: поды Kubernetes, на которых исполняются задачи задач Spark. Их количество масштабируется динамически в зависимости от вакансий и требуемого объёма памяти.
- Промежуточная инфраструктура: хранилище образов (OCI), общий локальный объем для временных данных, объектное хранилище cloud-объекта для данных и витрины (S3, GCS, ADLS).
- Spark Operator vs ручной Spark-on-Kubernetes: оператор автоматизирует развертывание и управление жизненным циклом приложений Spark, предоставляет CRD SparkApplication и упрощает управление обновлениями, зависимостями и повторными запусками.
## Пример спаренного в Kubernetes проекта через SparkOperator (yaml)
apiVersion: sparkoperator.k8s.io/v1beta2
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: data-engineering
spec:
  type: Scala
  mode: cluster
  image: gcr.io/spark-operator/spark:v3.4.0
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: local:///opt/spark/examples/jars/spark-examples.jar
  sparkVersion: "3.4.0"
  restartPolicy:
    type: OnFailure
  driver:
    cores: 1
    memory: 512m
    serviceAccount: spark
  executor:
    cores: 2
    instances: 3
    memory: 1g
Факторы выбора между подходами:
- Контроль над жизненным циклом и предсказуемость обновлений: Spark Operator упрощает повторное использование конфигураций и управление версиями.
- Накладные расходы на инфраструктуру: оператор добавляет слой абстракций, но облегчает мониторинг, управление зависимостями и обновлениями.
- Сложности интеграций с существующими пайплайнами и сервисами кластера: native Spark-on-Kubernetes может быть предпочтительнее в средах с минимальным набором операций по конфигурации CRD.
Ключевые механизмы взаимодействия в Kubernetes-формате включают:
- Управление контекстом и namespaces: изоляция задач, ограничение RBAC и доступов.
- Сетевые политики и сервисы: изоляция трафика, безопасность и доступ к данным.
- Персистентность и временные данные: использование PV/PVC и динамических томов.
- Секреты и конфигурации: Kubernetes Secrets и ConfigMaps для конфигурационных параметров и чувствительных данных.
- Мониторинг и телеметрия: экспорт метрик в Prometheus, сборлогов в EFK/ELK.
Конфигурации и протоколы взаимодействия
Для надёжности и предсказуемости развёртывания в Kubernetes необходима чёткая конфигурационная парадигма. В контексте Spark ключевыми являются параметры, управляющие ресурсами, сетевым взаимодействием и окружением исполнения.
- Ресурсы и память: memory и cores для драйвера и Executors, параметры динамического масштабирования (если поддерживаются). В Kubernetes это должно быть синхронизировано с выделяемыми лимитами и квотами по контейнерам.
- Сетевые параметры и коммуникации: связь драйвера и исполнительных подов, а также межузловой обмен данными. В Spark используется собственная сетевые протоколы и shuffle-сервис; для Kubernetes критично обеспечить доступность между подами через внутрение сервисы и сетевые политики.
- Безопасность и доступ: сервис-аккаунты, RBAC, Secrets для учетных данных к источникам данных, ключам шифрования и хранилищам.
- Интеграции со стойкими хранилищами: облачные хранилища (S3, GCS, ADLS) и локальные перспективы (NFS, Ceph). Важно обеспечить корректную аутентификацию и корректные политики доступа.
- Протоколы обновления и отката: стратегия обновления образов (Canary/Blue-Green), проверка совместимости версий Spark и образов, роллбек-процедуры.
Важно помнить, что Kubernetes разделяет вычисление и память на поды. Spark требует внимательного баланса между выделяемыми ресурсами и возможностью перераспределения задач в случае сбоя или изменения нагрузки. В частности, динамическое распределение исполнения (dynamic allocation) может существенно повысить эффективность за счёт уменьшения накладных расходов времени ожидания очередей и перегрузки кластера. Однако для Kubernetes оно требует корректной настройки внешних файловых систем, shuffle-сервисов и корректной реализации механизма сериализации и передачи данных между драйвером и исполнителями.
## Пример конфигурационных параметров Spark при развёртывании в Kubernetes через SparkApplication
spec:
  sparkVersion: "3.4.0"
  mode: cluster
  image: myrepo/spark:3.4.0
  imagePullPolicy: IfNotPresent
  mainApplicationFile: local:///opt/spark/jars/spark-sql-kafka-broker.jar
  mainClass: org.apache.spark.examples.SparkSQLKafkaExample
  driver:
    cores: 1
    memory: 1g
    serviceAccount: spark
  executor:
    cores: 2
    instances: 4
    memory: 2g
  dynamicAllocation:
    enabled: true
    minExecutors: 2
    maxExecutors: 10
 submitTimeOut: 600s
  deps:
    - **name**: kafka
      version: 2.8.0
Принципы сетевого взаимодействия в рамках Kubernetes требуют тщательной настройки:
- используйте сервис-аккаунты и RBAC для ограничения доступа подов к ресурсам кластера;
- обеспечьте безопасную аутентификацию к хранилищам данных через секреты и CMEK (customer-managed encryption keys) там, где это возможно;
- применяйте сетевые политики, чтобы ограничить доступ между NS и кроме того разрешать доступ к внешним ресурсам, нужным для чтения данных.
Интеграции и сценарии облачного развёртывания
Облачные платформы предлагают множество возможностей для развертывания Spark на Kubernetes и управления данными. Выбор конкретной платформы зависит от требований к безопасности, стоимости и оперативной гибкости. В рамках главы рассмотрим три распространённых сценария: развёртывание в управляющей среде общедоступного облака (GKE/AKS/EKS), частные кластеры на базе Kubernetes и управляемые решения с использованием специализированных операторов.
- Выбор платформы: GKE, EKS, AKS предоставляют готовые интеграции с IAM/IRSA, управления секретами и интеграции с системами мониторинга и хранения. В крупных организациях целесообразно рассмотреть гибридные подходы: локальный кластер для чувствительных данных и облачный для масштабирования.
- Хранение и доступ к данным: S3-compatible хранилища, GCS/ABFS/ADLS, объектные хранилища в облаке. Spark может работать с данными напрямую через spark.read.* форматы (JSON, Parquet и т.д.) без необходимости копирования в HDFS.
- Безопасность и управление доступом: интеграция с IAM/IRSA (AWS), Workload Identity (GCP), Managed Identities (Azure) обеспечивает безопасный доступ к ресурсам без размещения секретов в коде. Используйте Vault или Kubernetes Secrets в связке с политиками доступа.
- Обновления и версия управления: Helm-чарты и сидения Helm-карт позволяют централизованно управлять конфигурациями, а также внедрять CI/CD пайплайны. Spark Operator упрощает управление жизненным циклом задач и обеспечивает единый способ развертывания Spark-приложений.
Таблица ниже иллюстрирует характерные паттерны развёртывания и их применимость в зависимости от задач:
| Паттерн развёртывания | Тип задачи | Преимущества | Рекомендуемые ограничения |
|---|---|---|---|
| Spark Operator + SparkApplication | Batch ETL, периодические задачи | Простота повторного использования конфигураций, Управляемый жизненный цикл | Потребность в дополнительном слое абстракций и обучения |
| Spark без оператора (чистый Kubernetes) | Спектр нагрузок, экспериментальные сценарии | Большая гибкость, минимальные зависимости | Сложность конфигураций и обслуживания |
| Облачная платформа с управляемым Kubernetes (GKE/EKS/AKS) | Микросервисы, многопользовательские среды | Интеграции с IAM, мониторингом, авто-масштабирование | Зависимость от конкретного облака и цены |
CI/CD, мониторинг, безопасность
Инфраструктура развёртывания Spark на Kubernetes требует продуманного подхода к жизненному циклу приложений, мониторингу и безопасности. В рамках CI/CD важно обеспечить автоматизированную сборку образов Spark-узлов, тестирование совместимости и надёжные процедуры развёртывания в различных средах (dev/stage/prod). В контексте мониторинга следует объединять метрики Spark (Stage, Task, Shuffle, GC) и системные метрики Kubernetes (CPU/Memory по подам, QoS-классы, задержки сетевых запросов). Для безопасности - внедрить принципы минимальных привилегий, управление секретами, шифрование и аудит.
- CI/CD: сборка и публикация образов, автоматическое тестирование на локальных кластерах, интеграция с GitOps-подходами (ArgoCD, Flux) для синхронизации конфигураций и CRD SparkApplication.
- Мониторинг и трассировка: Prometheus + Grafana, Spark UI доступ через Ingress или port-forward, сбор логов в Elasticsearch/EFK. Включайте trace-данные и метрики по задержкам, чтобы быстро выявлять узкие места в пайплайнах.
- Безопасность и соответствие: управление секретами через Secrets Store, KMS/cev, аудит действий на уровне кластера и приложений. Рекомендуются политики шифрования данных в покое и в транзите, а также контроль доступа к источникам данных.
- Управление конфигурациями: используйте Helm-чарты и политики конфигурации, чтобы обеспечить единообразие во всех средах; применяйте GitOps для отслеживания изменений и автоматизации откатов.
## Пример Helm Values для Spark Operator
operator:
  enabled: true
  image: "gcr.io/spark-operator/spark-operator:3.4.0"
iam:
  enabled: true
  serviceAccount:
    name: spark
monitoring:
  enabled: true
  prometheus:
    secretName: prometheus-scrape
Безопасность в контейнерных средах требует учёта изоляции и прав доступа к данным. Пример безопасной практики:
- разделение пространств имен (namespace) по отделам или по окружениям;
- применение RBAC и ограничение доступа к API Kubernetes;
- использование секретов для хранения ключей доступа к данным и параметров конфигурации;
- аудит и ретеншмонт учетных действий через журналы и SIEM.
Практические схемы развёртывания и паттерны ETL и аналитики
Глубокий технический подход к развёртыванию Spark на Kubernetes и в облаке побуждает к выбору паттернов, которые соответствуют характеру выполняемых задач: пакетные ETL-пайплайны, интерактивная аналитика, обработка потоков данных и ML-нагрузки. В этом разделе рассмотрим две распространённые конфигурации и выделим их преимущества и ограничения.
- Паттерн A: пакетная ETL через SparkApplication в Kubernetes, с использованием динамического масштабирования и внешнего shuffle-сервиса. Подобный подход обеспечивает предсказуемые временные окна загрузок и эффективное использование ресурсов.
- Паттерн B: потоковая аналитика с Structured Streaming на Spark в Kubernetes, через устойчивые источники данных (Kafka, Kinesis) и sink-ы (Parquet/HDFS/облако). Важно обеспечить устойчивое хранение состояния и способность к горизонтальному масштабированию.
- Паттерн C: гибридные пайплайны, где Spark запускается как часть облачных конвейеров (CI/CD pipelines) и интегрируется с системами хранения данных и BI-инструментами.
Рассмотрим сценарий: пакетная загрузка и агрегация данных из нескольких источников с последующим сохранением в Parquet и загрузкой в аналитическую витрину. Процесс начинается с подгрузки метаданных из каталога данных, затем формируются дата-сеты и выполняются стадии очистки и нормализации. В конце данные записываются в облачное хранилище и обновляется витрина BI. В Kubernetes для такого сценария характерна комбинация SparkApplication и соответствующих секретов/конфигураций, чтобы обеспечить безопасную маршрутизацию данных и управление зависимостями.
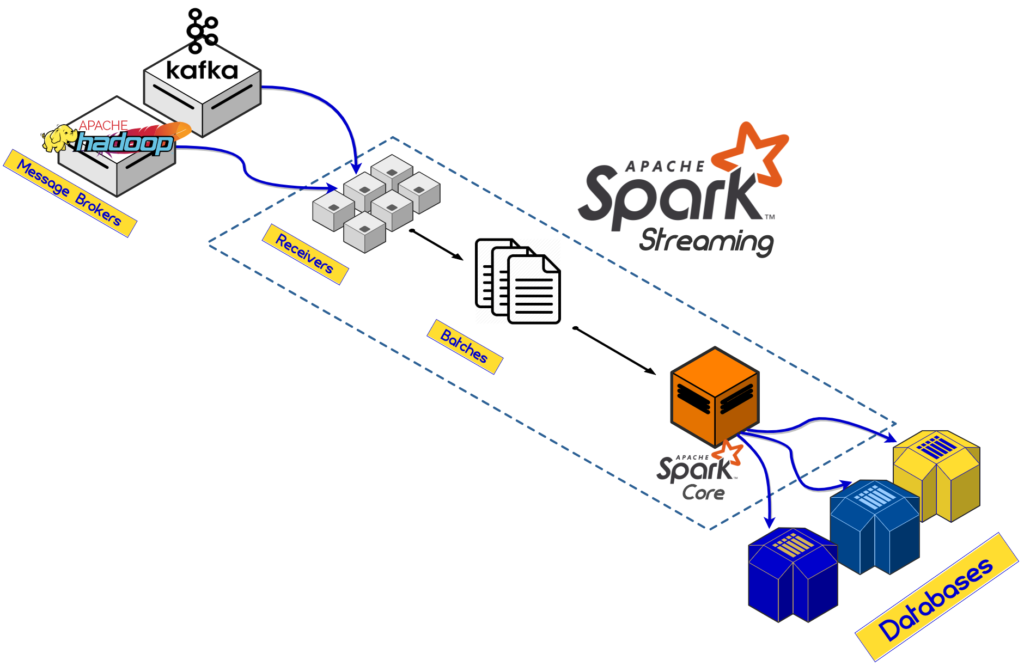
Типовые шаги реализации:
- подготовка образа Spark и зависимостей, выбор версии Spark и совместимости с используемым API Kubernetes;
- настройка ресурсов драйвера и исполнителей (cores/memory), включение динамического распределения;
- конфигурация доступа к данным и секретам; указание путей к данным и целевых витринам;
- настройка мониторинга и логирования; определение политики отката и тестирования;
- в контексте облака - интеграция с IAM/IRSA, Workload Identity и т.д.
Для инженерной практики полезно иметь на руках примеры конфигураций, которые можно адаптировать под конкретные требования проекта. В следующем разделе приводятся основные выводы и резюме главы.
Key takeaways
- Spark на Kubernetes позволяет разделить вычисление и данные, обеспечивая масштабируемость и изоляцию нагрузок.
- Выбор между Spark Operator и нативным Kubernetes-оркестрацией зависит от потребностей в управляемости жизненным циклом задач и сложности конфигураций.
- Конфигурации должны учитывать ресурсы (memory/cores), сетевые политики, безопасность и интеграцию с внешними хранилищами.
- Облачные интеграции требуют правильной настройки IAM/секретов, секрет-сервисов и политик доступа; это критично для безопасной эксплуатации.
- Мониторинг и наблюдаемость - ключ к устойчивости: комбинируйте Prometheus, Grafana, Spark UI и логи в централизованном хранилище.
- Паттерны ETL и аналитики на Kubernetes должны сочетать надёжность, управляемость и экономическую эффективность через динамическое масштабирование и повторное использование конфигураций.
- Использование GitOps и Helm-чартов упрощает управление версиями конфигураций и ускоряет процессы выпуска изменений.
FAQ
- Что даёт внедрение Spark на Kubernetes по сравнению с традиционной установкой на VM?
- Основное преимущество состоит в возможности горизонтального масштабирования и динамического управления ресурсами через оркестрацию. Kubernetes обеспечивает изоляцию подов, унифицированный подход к сетям и хранению, упрощает интеграцию с CI/CD и мониторингом. Кроме того, контейнеризация упрощает переносимость между облачными окружениями и локальными кластерами.
- Когда стоит выбрать Spark Operator?
- Если задача требует единообразного и повторяемого жизненного цикла приложений, удобной конфигурации через CRD и централизованного управления обновлениями, Operator становится предпочтительным. Он абстрагирует многие детали запуска и позволяет отделить конфигурацию приложения от инфраструктуры.
- Какие риски связаны с использованием внешних shuffle-сервисов в Kubernetes?
- Внешний shuffle-сервис обеспечивает снижения накладных расходов на запись и чтение shuffle-перемещений между драйвером и исполнителями, но добавляет дополнительный узел риска и зависимости. Необходимо обеспечить его доступность и согласование версий между Spark и сервисом, а также предусмотреть резервирование.
- Какие требования к сетевым политикам и безопасности при развёртывании Spark на Kubernetes?
- Требуется ограничение доступа подов к API кластера, безопасное использование секретов и учетных записей, шифрование данных в транзите и в покое, аудит действий и соответствие требованиям регуляторики. Рекомендуется применение принципа минимальных привилегий и разделение нагрузок по namespaces.
- Какой подход к хранению данных оптимален для Spark в облаке?
- Использование облачных объектных хранилищ (S3, GCS, ADLS) для данных и временного хранения; Parquet/ORC форматы для эффективной компрессии и столбцовой ориентации. Для промежуточных данных возможно применение локальных томов с динамическими пулами, чтобы снизить задержки.
- Какие конфигурационные параметры наиболее критичны для стабильности?
- memory и cores для драйвера и Executors, параметры динамического распределения, настройки shuffle-сервиса, путевые настройки для источников и приемников данных, политика откатов и рестартов. В Kubernetes важны лимиты и запросы ресурсов, чтобы обеспечить предсказуемое планирование.
- Как обеспечить мониторинг Spark в Kubernetes?
- Включайте Prometheus-экспортеры на уровне Spark и Kubernetes, используйте Grafana для визуализации метрик и Spark UI для детального анализа задач. Логи можно перенаправлять в Elasticsearch/EFK, чтобы поддерживать аудит и оперативное реагирование.
- Какие паттерны CI/CD особенно эффективны для Spark на Kubernetes?
- GitOps-подходы с ArgoCD/Flux, автоматизированные сборки образов, тестовые окружения, интеграционные тесты под реальные данные и конфигурации, безопасное управление секретами и политиками доступа. Включайте процессы отката и упрощение отката через CRD и Helm-чарты.
- Какие требования к совместимости версий между Spark, Kubernetes и образом контейнера?
- Важно поддерживать совместимость между версией Spark, версией Spark Operator (если используется), версией Kubernetes API и базовым образом. Рекомендуется регулярно обновлять стек и тестировать на совместимость в стадии CI, прежде чем переходить в production.
- Каковы лучшие практики для многопользовательской среды на одном кластере?
- Разделение по namespaces и RBAC, строгие политики доступа к данным, ограничение ресурсов на уровне подов, отделение витрин данных и пайплайнов, применение GitOps для единообразия конфигураций и предсказуемости развёртывания. Это снижает риск «перекрёстного» влияния между проектами и повышает устойчивость к сбоям.


