

Как разработать и поддерживать функционирование высокопроизводительного конвейера данных
Конвейеры данных необходимы для управления потоками данных, поступающих из различных источников к целевому адресату. Команда BI-Infra-Ops компании Agoda представила исчерпывающее руководство по лучшим практикам проектирования, мониторинга и обеспечения жизнедеятельности конвейеров данных.
Что такое конвейер данных?
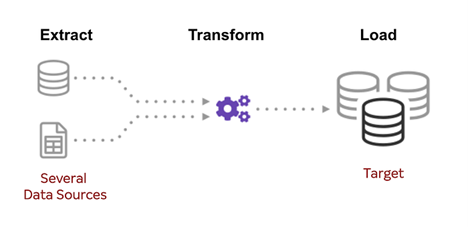
Конвейеры данных - это процессы, в ходе которых данные извлекаются из источника (одного или нескольких), преобразуются в подходящий формат и загружаются в целевой объект, чаще всего в таблицу.
Проектирование правильного конвейера данных
«Здоровый» конвейер данных имеет решающее значение для обеспечения эффективного использования данных для принятия стратегически важных решений и повышения операционной эффективности. Если наши конвейеры данных «нездоровы», то данные не смогут быть предоставлены вовремя или даже вызовут определенные проблемы у конечных пользователей.
Правильное проектирование конвейера данных может сделать его надежным и свести к минимуму нежелательные потери данных или простои системы. В нем должны быть предусмотрены механизмы обработки ошибок, восстановления данных и мониторинга для своевременного обнаружения и устранения проблем. Когда наши конвейеры данных хорошо спроектированы и оптимизированы, обработка данных будет происходить гораздо быстрее и с меньшими затратами, что значительно сократит время подготовки данных.
Более того, поскольку требования к данным быстро меняются, наши конвейеры обработки данных также должны быть максимально гибкими. Новые источники данных, новые форматы данных и новые схемы данных должны быть адаптируемыми без особых усилий. Хорошо спроектированный конвейер обработки данных можно масштабировать для работы с растущими объемами и источниками данных без существенного снижения производительности. Такая масштабируемость крайне важна по мере роста организаций и увеличения объема генерируемых ею данных.
Таким образом, для создания здорового канала передачи данных необходимо учитывать несколько факторов:
- Данные: где хранятся данные? Каково их «поведение»?
- Используемые ресурсы: сколько ресурсов должно быть выделено для нашего конвейера данных?
- Разбиение: как мы должны разбить нашу таблицу (в Hadoop)?
- Планирование заданий: как часто должен запускаться наш конвейер обработки данных?
- Зависимость данных: зависит ли работа конвейера от данных других таблиц?
Мы рассмотрим каждый фактор по отдельности и приведем несколько общих примеров того, как эти факторы влияют на проектирование конвейера данных в Agoda.
Для обеспечения эффективной работы конвейера данных необходимо эффективно распределять ресурсы. Разбиение процесса на части позволит в разы повысить производительность и значительно сократить время выполнения. При планировании заданий необходимо учитывать тип используемых данных, SLA, продолжительность выполнения заданий и «свежесть» источника данных. Необходимо также учитывать и зависимость данных - когда одно задание может начать выполняться только по завершении предыдущего задания.
1. Данные
Источник данных и поведение данных определяют то, как именно будут обрабатываться данные. Источник данных означает то, где именно хранятся данные (MSSQL/Hadoop). Поведение данных заключается в том, изменяются ли данные с течением времени или какова их гранулярность (уровень детализации).
В одном из конвейеров обработки данных в Agoda мы разделили процесс на три подпроцесса в зависимости от данных, с которыми мы работаем. Этот конвейер данных загружает данные в таблицу фактов в нашем хранилище данных. Эта таблица называется Fact Booking. В ней хранятся данные о бронированиях. Наша схема основана на методе Star Schema. Три подпроцесса включают в себя:
-
Оригинальный колоночный процесс
- Обрабатываются столбцы без изменений (статические)
- Реализация: Привязать значение с момента создания бронирования(игнорировать изменение)
- Источник: MSSQL + Hadoop
-
Текущий колоночный процесс
- Обрабатваются столбцы, которые могут быть изменены с течением времени (динамические)
- Реализация: Все значения могут быть изменены в случае обновления в источнике
- Источник: MSSQL + Hadoop
-
Плоский процесс
- Обновление размерных столбцов
- Реализация: Получение значений путем объединения с таблицами размерностей
- Источник: Hadoop
Каждый подпроцесс подходит для разных типов данных и, соответственно, должен быть по-разному реализован. Это как раз и объясняет то, почему понимание данных имеет решающее значение при проектировании конвейера данных.
2. Используемый источник
Под ресурсом понимается количество ресурсов, используемых для обработки данных в конвейере данных. Объем ресурсов, выделяемых для конвейера данных, является еще одним фактором, который должен быть уточнен.
-
Если выделено слишком мало источников, то:
- Потребуется слишком много времени для завершения работы над конвейером данных
- Возрастет риск ошибок вследствие недостатка ресурсов
-
Если выделено слишком много источников, то:
- Это негативно отразится на работе других конвейеров данных
- Ресурсы будут использоваться нерационально
В компании Agoda большинство конвейеров обработки данных работают на Apache Spark. Распределение ресурсов между приложениями Apache Spark необходимо для обеспечения эффективной и оптимальной работы конвейеров данных. Spark позволяет задавать конфигурации ресурсов для отдельных заданий Spark или этапов внутри заданий для более точной настройки распределения ресурсов. Для управления и распределения ресурсов между приложениями Spark можно использовать Apache YARN или Kubernetes.
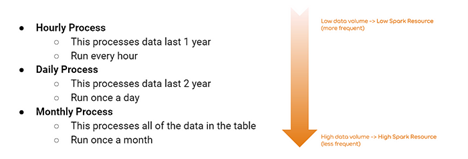
Вернемся к таблице Fact Booking. Мы разделяем процессы в конвейере данных не только в соответствии с типом используемых данных, но и в зависимости от того, какой объем данных потребляется в каждом раунде. Процессы, потребляющие больший объем данных, запускаются реже, что позволяет избежать нерационального потребления ресурсов.
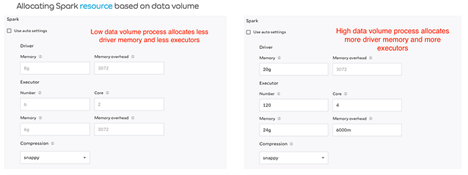
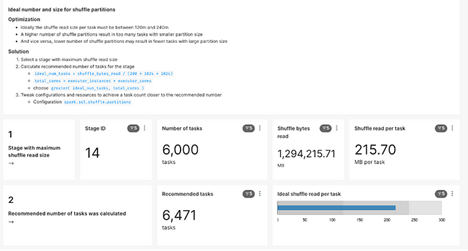
В Spark можно регулировать некоторые параметры, такие как память драйвера и количество исполнителей. Например, процесс, потребляющий большой объем данных, как правило, требует больше памяти драйвера и большее количество исполнителей.
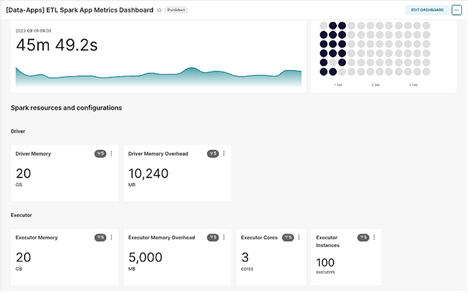
В компании Agoda также имеются дашборды, созданные для отслеживания нескольких показателей Spark, используемых в наших конвейерах. Эти дашборды могут быть использованы для мониторинга Spark-приложений.
3. Разбиение на части
В Hadoop под разбиением на части понимается процесс разделения и организации данных на более мелкие и управляемые подмножества, называемые разделами. В основном мы разбиваем наши таблицы на разделы по определенным столбцам.
Правильное разбиение таблицы может значительно повысить производительность записи и сократить время работы конвейера обработки данных. Вот некоторые факторы, которые можно использовать для разбиения:
-
Размер и количество разделов
- Размер и количество разделов не должны быть слишком большими или слишком маленькими;
-
Распределение данных
- Мы хотим, чтобы данные были распределены по всем разделам равномерно.
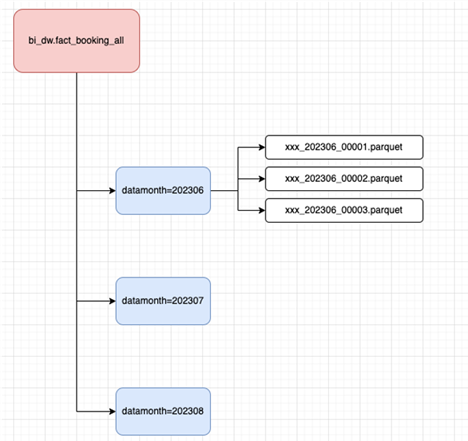
Вернемся к нашей таблице Fact Booking. Здесь в качестве разделительного столбца мы используем datamonth, который является месяцем даты бронирования.
-
Почему именно месяц даты бронирования?
- Количество бронирований распределяется равномерно по месяцам даты бронирования
-
Почему месяц, а не день?
- Если использовать день даты бронирования, то размер разделов будет слишком мал, а количество разделов - слишком велико.
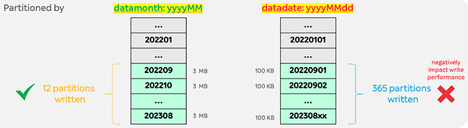
На самом деле, зачастую более практичным является выбор размера раздела на основе первоначального анализа, а затем его более точная настройка путем тестирования производительности. Измерьте влияние различных размеров разделов на производительность запросов и использование ресурсов, чтобы найти оптимальный баланс для каждого конкретного случая.
4. Планирование заданий
В обычных условиях мы не будем вручную запускать наши конвейеры данных. Планирование заданий - это способ автоматизации их работы. С помощью планирования заданий мы можем заранее определить, когда и как часто должен запускаться наш конвейер. Основным моментом при его настройке является частота выполнения заданий.
Периодичность планирования заданий зависит от:
-
Использования данных
- Если данные используются интенсивно, можно запланировать выполнение задания на большее количество раз.
- Если данные используются один раз в день (например, для составления ежедневного отчета), тогда можно запланировать выполнение задания на один раз в день;
-
SLA данных
- Меньшее время SLA означает, что конвейер должен запускаться чаще
-
Продолжительности работы конвейера данных
- Сколько времени необходимо для выполнения одного цикла заданий
-
Свежести источника данных
- Если исходные данные обновляются раз в день, то нам не нужно планировать выполнение заданий чаще.
5. Зависимость данных
Иногда конвейер данных может полагаться на источник данных, загружаемый другим конвейером. Это означает, что в конвейере существует зависимость от данных, которую также необходимо учитывать при проектировании конвейера данных.
Вот пример, наглядно демонстрирующий то, почему зависимость от данных имеет решающее значение при проектировании конвейера данных:
- Конвейер B загружает данные в Таблицу B (работает ежедневно в 10:30)
- Конвейер B загружает данные, используя Таблицу A в качестве исходной.
- Конвейер A - задание, загружающее данные в таблицу A (выполняется ежедневно в 10:00)
- Конвейер B зависит от данных, содержащихся в таблице A
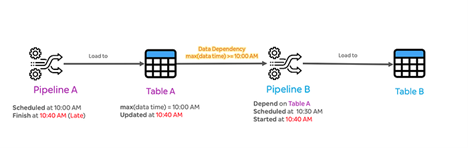
Если для конвейера B не задано правило зависимости данных, то он начнет работу в 10:30 утра, и данные, загруженные в таблицу B, будут неполными.
Мониторинг Вашего конвейера данных
После создания конвейера данных необходимо найти способ его мониторинга. Мониторинг очень важен для обеспечения бесперебойной работы и быстрого выявления и устранения любых проблем.
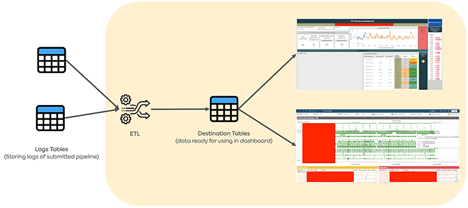
Когда наши конвейеры передаются в Spark, создаются таблицы журналов, в которых хранится информация о переданном конвейере. Эта информация включает в себя время начала и окончания работы конвейера и многое другое. Команда Hadoop Data отвечает за платформу, используемую для запуска наших конвейеров и управления этими журналами. Как команда BI, мы создали конвейер, который консолидировал данные из журналов и загружал их в целевую таблицу, где данные были готовы к дальнейшему использованию в дашбордах. Затем мы создали несколько дашбордов для мониторинга представленных конвейеров.
Примеры дашбордов для обеспечения мониторинга:
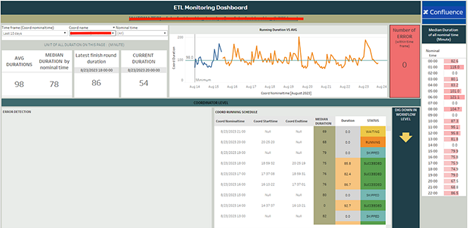
- Дашборд для контроля продолжительности работы конвейера данных
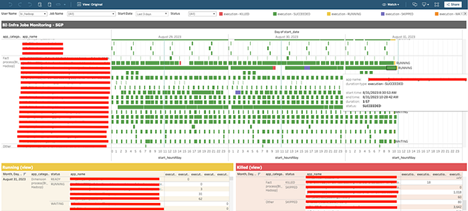
- Дашборд для мониторинга статуса работы конвейера (успешно или неуспешно)
Обеспечение качества данных
Продуктом конвейера данных являются данные. Поэтому обеспечение их качества является первостепенной задачей. Качество данных можно определить с точки зрения их свежести, целостности, согласованности, полноты и точности. Мы рассмотрим каждый аспект по отдельности.
Свежесть
Свежесть данных означает их своевременность.
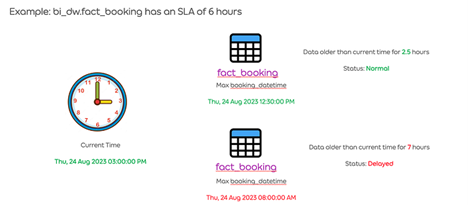
В компании Agoda мы создали собственный инструмент для отслеживания свежести данных в наших таблицах. Например, в таблице Fact Booking мы настроили возможность отслеживания столбца booking_datetime. Поскольку SLA нашей таблицы Fact Booking составляет 6 часов, инструмент уведомит нас в случае, если время последнего бронирования превысит 6 часов. Задержки могут возникать по самым разным причинам.
Целостность и полнота
В большинстве случаев под целостностью данных понимается их уникальность. Полнота данных – это отсутствие NULL или пустых клеток.
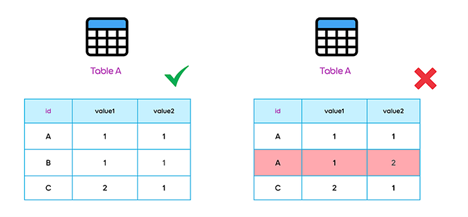
Например, таблица A содержит столбец "id", который идентифицирует каждую запись в таблице. Таким образом, не должно быть двух записей с одинаковым id.
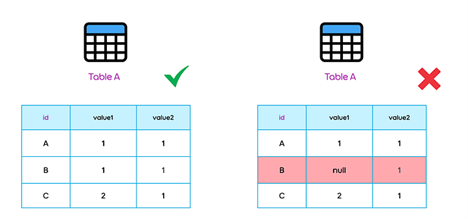
Другим примером полноты данных является ситуация, когда мы не хотим, чтобы какое-либо значение в таблице было NULL или пустым (смотрите рисунок выше).
В Agoda мы проверяем данные перед их записью в целевую таблицу. Если данные не прошли проверку на целостность или полноту, конвейер не будет записывать их в целевую таблицу.
Точность
Точность данных обеспечивается путем сверки текущих данных с предыдущим трендом.
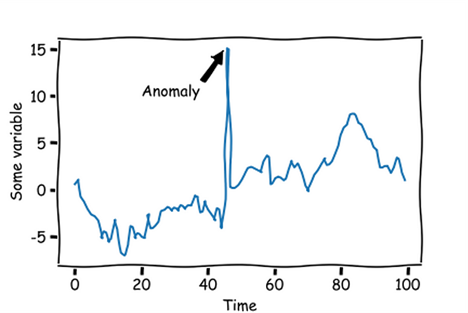
В компании Agoda для выявления аномалий в данных мы используем инструмент ThirdEye, который позволяет исследовать любые отклонения в метриках с помощью интерактивного анализа первопричин.
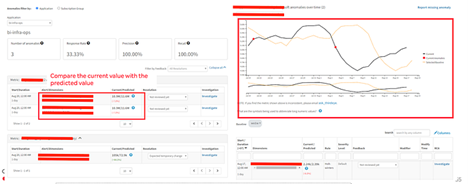
На рисунке выше показан пример того, как ThirdEye помогает нам обнаружить аномалии в данных. Он сравнивает текущее значение с прогнозируемым значением, основанным на предыдущей тенденции. Если разница превышает пороговое значение, ThirdEye уведомляет нас о выявленной аномалии.
ThirdEye также очень прост в использовании, поскольку предоставляет четыре основных алгоритма для расчета прогнозируемого значения.
Подробнее о ThirdEye: https://github.com/project-thirdeye/thirdeye
Согласованность
Согласованность данных обеспечивает согласованность данных между двумя точками (источником и местом назначения).
Для проверки согласованности данных наша команда BI использует инструмент под названием Quilliup.
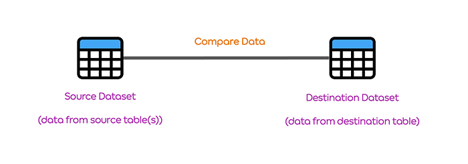
Основная концепция Quilliup заключается в том, что у нас есть исходный набор данных, содержащий данные из исходных таблиц, и конечный набор данных, содержащий данные из конечной таблицы. Данные в исходном и целевом наборах данных должны совпадать.
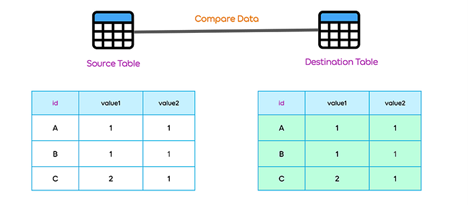
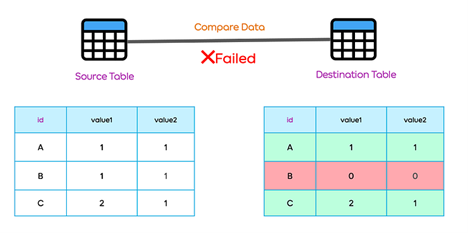
Обычно мы запускаем Quilliup, когда конвейер уже завершил проверку согласованности загруженных данных.
Подробнее о Quilliup: https://quilliup.zendesk.com/hc/en-us
Мониторинг данных
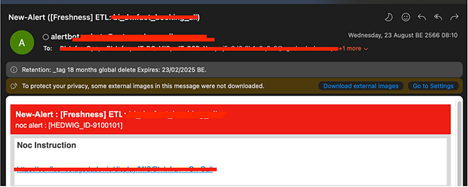
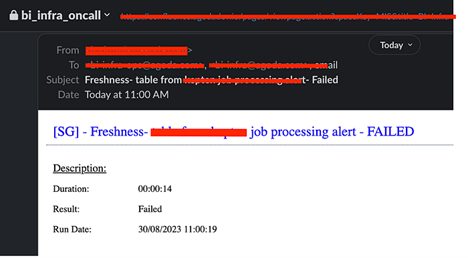
Мониторинг данных - это процесс сбора, анализа и реагирования на результаты тестирования качества данных. В компании Agoda имеется собственная централизованная система оповещений под названием Hedwig. Hedwig может получать результаты тестирования от различных инструментов тестирования качества данных, упомянутых в предыдущих разделах, и отправлять оповещения по электронной почте и в Slack. Это позволяет нам быстро и эффективно реагировать на любые неожиданные изменения в данных.
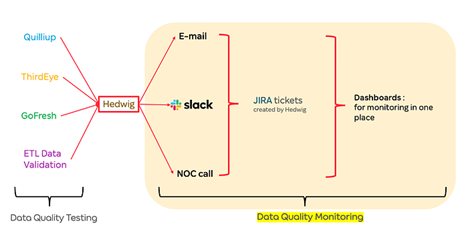
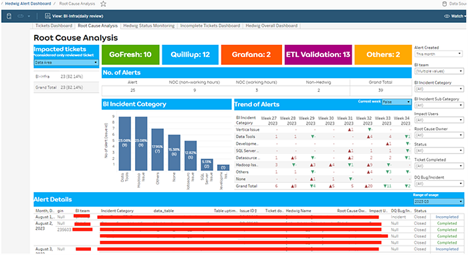
Мы также автоматизируем создание тикетов JIRA, когда Hedwig отправляет оповещения. Это позволяет нам отслеживать время возникновения и решения проблемы с данными, основную первопричину и способ ее решения.
Пример email и оповещения Slack из Hedwig:
- У нас также есть дашборд, на котором отображаются все тикеты JIRA, созданные Hedwig при отправке оповещений.
Заключение
В заключение хотелось бы отметить, что проектирование, мониторинг и обеспечение качественной работы конвейеров данных имеют первостепенное значение. Следуя лучшим практикам, представленным командой BI-Infra-Ops, можно разрабатывать и поддерживать оптимальную работу конвейеров данных, обеспечивая их эффективность и точность.
Примечание: подходы, перечисленные в данной статье, соответствуют специфическим требованиям компании Agoda, а все вышеупомянутые инструменты используются только внутри компании.


