

Проблемы современного стека данных
Хаотичная экосистема данных и как мы к ней пришли
В сегодняшней статье я расскажу о самых больших проблемах современного стека данных и том, как мы к ним пришли.
Что представляли из себя данные раньше
Десять лет назад компании были охвачены ажиотажем в области бизнес-аналитики (BI). Их в первую очередь интересовала возможность быстро генерировать отчеты и дашборды, чтобы управлять операционными рисками, реагировать на требования законодательства и, в конечном счете, принимать эффективные бизнес-решения на основе фактов.
Помимо BI, классические статистические приемы широко использовались в страховании, здравоохранении, производстве и финансовой сфере.
В целом, то, как данные выглядели на заре своего существования, можно описать следующим образом:
- Данные использовались для анализа конкретных случаев, а не для принятия стратегических решений
- Данные использовались в основном для автоматизации отчетности
- Начало статистического моделирования для бизнеса
Традиционный стек данных
Традиционный стек данных (TDS) - это еще одно название локальных систем данных.
Организации сами управляли своей инфраструктурой и оборудованием, что было обременительно с точки зрения уязвимости (высокая устойчивость к любым изменениям), высокой стоимости обслуживания (трудоемкое обслуживание вручную), отсутствия возможности масштабируемости (трудно предоставить новую инфраструктуру, когда стек нуждается в ней и сложного анализа первопричин.
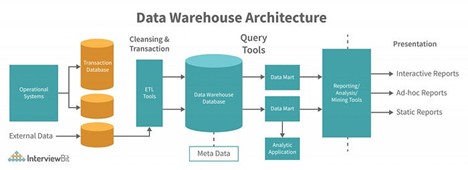
Примерно в 2010 году появление передовых технологий привело к появлению новых задач для стека данных. Теперь организациям приходилось решать следующие задачи:
- Увеличение объема данных потребовало перехода от жесткого управления и интенсивного моделирования в хранилище данных к менее контролируемой среде озера данных, где можно было бы хранить данные. Стоимость хранения возросшего объема данных также стала серьезной проблемой для оптимизации управления;
- Новые типы данных - появились новые типы данных, такие как текст, изображения и аудио. Большинство организаций в то время не знали, как можно использовать эти неструктурированные данные;
- Больше возможностей использования данных в бизнес-сфере - теперь организации могли использовать возросший объем и новые типы данных для построения более точных моделей, чтобы улучшить системы принятия решений. НЛП, компьютерное зрение и рекомендательные системы стали более доступными для всех организаций.
Современный стек данных
Принимая во внимание новый задачи стек данных вынужден был эволюционировать. Именно тогда и появился современный стек данных (MDS).
Самым значительным достижением MDS стал переход к облачным технологиям, которые сделали данные более доступными, восстанавливаемыми и простыми в управлении с технической точки зрения. MDS обеспечил сбор и обработку данных, поддержку высокоскоростных потоков данных и высокую масштабируемость при низких затратах.
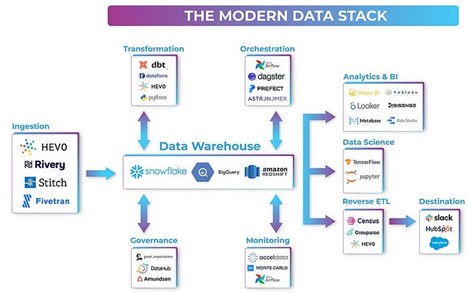
MDS - это совокупность нескольких инструментов, которые связаны друг с другом для того, чтобы обеспечить переход от физических данных к инсайтам в сфере бизнеса.
Их отличает простота развертывания в облаке, масштабируемость и компонентный характер. Каждый инструмент решает отдельные задачи в области данных, такие как разделение вычислений и хранения (Snowflake, DataBricks), Data Lineage (Stemma, Alation), трансформация (dbt), оркестровка заданий (Airflow, Prefect), управление схемами (Protobuf), стриминг (Kafka), мониторинг (Monte Carlos, Bigeye) и многие другие.
Какие новые проблемы появились при этом?
MDS возникла как разрозненная группа инструментов, которые создавали тяжелые конвейеры и сбрасывали данные в центральное озеро, создавая неуправляемые болота данных в разных отраслях. Эти инструменты не создавались для совместной работы по всей цепочке создания ценности данных.
Более того, за несколько лет данные переросли первоначальный вариант использования - создание дашборда для руководителя - и превратились в сотни моделей и дашборды. Это привело к возникновению целого ряда проблем:
- Поскольку данные поступали из разных источников, понять их контекст стало намного сложнее - хранилища данных перестали быть копией реального мира;
- Многие инициативы по созданию данных повторно используют одни и те же данные под разными именами или ссылаются на необслуживаемые таблицы;
- Команды пытаются понять источник истины для важных данных и создают свои собственные таблицы, что приводит к "долгу данных" (подробнее о долге данных я напишу в следующих постах).
- Команды по работе с данными тратят месяцы на создание наборов функций для ML-моделей, создание метрик и проведение экспериментов с данными;
- Критически важные наборы данных постоянно ломаются, а ответственность и подотчетность при этом отсутствует.
В результате мы наблюдаем стремительный рост долга данных, увеличение количества ошибок, с которыми приходится разбираться ежедневно, а также отсутствие должного контроля над хранилищем данных, которое за последнее десятилетие утратило свое первоначальное значение, несмотря на то что до сих пор является самым важным активом данных в организации.
Большинство организаций либо уже столкнулись с этими проблемами, либо столкнутся с ними в ближайшее время, поскольку они продолжают инвестировать в свое развитие в области данных.
Что мы можем с эти сделать?
Современный стек данных позволил решить в основном задачи, связанные с затратами и производительностью, и породил еще больше проблем, когда речь зашла о том, как использовать данные для решения бизнес-задач.
Основная цель использования данных была и будет заключаться в обогащении бизнес-опыта и увеличении прибыли, поэтому именно на этом следует сосредоточиться в первую очередь.
Ниже приведены некоторые мысли о том, что можно сделать для того, чтобы сократить разрыв между производством и потреблением данных:
Хранилище данных как основа для всей аналитики
Создание семантически значимого отображения между всеми данными, поступающими из различных источников, позволит создать действительно эффективное хранилище данных и улучшить качество работы потребителей данных. Необходимо уделять гораздо больше времени пониманию того, как различные источники данных связаны между собой и отображают реальный мир.
Подключение инженеров-программистов (SWE) к работе с данными
Инженеры-программисты производят большую часть данных, используемых в бизнес-отчетах, экспериментах и моделях. При этом они не имеют ни малейшего представления о том, как потребляются их данные.
В итоге дата-инженеры превращаются в посредников, которые тратят больше времени на исправление конвейеров из-за того, что что-то изменилось на верхнем уровне (в back-end или front-end сервисах), чем на создание новых конвейеров для реализации бизнес-возможностей. Поэтому необходимо сделать следующее:
- Сначала контракты с данными - контракты с данными - это ожидания, связанные с данными. Эти ожидания могут быть связаны со значением для бизнеса, качеством данных, безопасностью данных и управлением ими. Это позволит дата-инженерам лучше понять, какие данные поступают к ним, и избежать разрывов конвейера из-за изменений, происходящих в потоке данных;
- Более глубокое проникновение в жизненный цикл создания данных - команды специалистов должны понимать, как создаваемые ими данные будут использоваться в последующих процессах;
- Качество данных зависит от команды инженеров, поскольку именно они производят данные, по крайней мере, до тех пор, пока они не будут загружены в озеро.
Инженерия данных ближе к бизнесу
Дата-инженеры отвечают за настройку и управление платформой данных и ее рабочими процессами. Они выступают в роли посредника между инженерами-программистами, учеными, изучающими данные, и аналитиками. Однако чаще всего они строят конвейеры, не имея ни бизнес-контекста, ни представления о конечной цели таблиц, которые они предоставляют.
Без бизнес-контекста дата-инженеры не смогут понять, как должны быть связаны между различные точки данных, и не смогут построить хранилище данных, соответствующее реальному миру.
Продуктовое мышление в области данных
Команда разработчиков данных должна быть уверена, что создаваемые ею продукты данных решают реальные проблемы пользователей. Рассматривать продукт данных только с технической точки зрения недостаточно. Обеспечение рыночного соответствия между продуктом данных и проблемой пользователя должно стать частью рабочего процесса над данными.
Новая структура моделирования данных
Традиционное моделирование данных сталкивается с такими проблемами, как высокий уровень управления, жесткие процессы, сложность итераций и длительное время получения результатов. Моделирование данных хорошо работало в те времена, когда данные находились под контролем, и команды могли гарантировать, что поступающие данные будут соответствовать определенной схеме.
Но с увеличением объема данных и источников данных применять моделирование данных стало намного сложнее, и именно поэтому хранилища данных начали терять свое предназначение.
Экосистема данных должна задуматься о моделировании данных 2.0 для современного стека данных. Решением этой проблемы может стать децентрализованная архитектура данных, в которой данные распределены по доменам.
Определение политик data governance
За последние десятилетия большинство инвестиций в инициативы по созданию данных были направлены на развитие и совершенствование технологий. Мало времени и внимания уделялось процессам и управлению данными. Вот несколько практик, позволяющих обеспечить эффективное, безопасное и этичное управление данными:
- Владение данными - кто является владельцем и ответственным за данные. Это обеспечивает право собственности на данные и подотчетность;
- Стандарты качества данных - набор критериев для обеспечения точности, полноты, последовательности и своевременности данных. Этот критерий обеспечивает надежность и достоверность данных;
- Каталоги данных - хранилище всех продуктов данных в организации, обеспечивающее местонахождение метаданных, документации и истории данных, облегчающее их обнаружение, понимание и использование;
- Политики и процедуры в отношении данных - набор процедур, определяющих, как данные должны собираться, храниться, обрабатываться, проверяться и использоваться в организации;
- Линейка данных - обеспечивает четкое понимание происхождения и перемещения данных.
Является ли Data Mesh наилучшим решением?
На мой взгляд, важнее всего не сама структура, а наша способность обеспечить успешное обогащение бизнеса за счет данных.
Data mesh решает некоторые из проблем, о которых я говорил в этой статье, но абсолютно точно, что это не панацея. Кроме того, data mesh находится на ранней стадии развития, и по мере того, как компании начнут внедрять данный фреймворк, будут появляться новые варианты того, что представляет собой data mesh.
В заключение хочу сказать, что, несмотря на мой, казалось бы, негативный взгляд на MDS, я с большим оптимизмом смотрю на будущее индустрии данных и на нашу способность адаптироваться и совершенствоваться.


