

Метаданные, каталог данных и lineage: поиск, прозрачность и управление данными
В рамках Data Mesh метаданные, каталог данных и lineage выступают не просто вспомогательными инструментами, а фундаментом для децентрализованной архитектуры данных. Они обеспечивают доменным владениям понятие о том, что именно есть в распоряжении организации, как данные связаны между собой и как ими управлять на протяжении всего жизненного цикла. Правильная организация метаданных и прозрачность lineage позволяют ускорить поиск, повысить доверие к данным и снизить риски несоответствий между контрактами данных и операционными практиками.
Эта глава фокусируется на концептуальных основах, архитектурных паттернах и практических подходах к проектированию, внедрению и эксплуатации метаданных, каталога данных и lineage в условиях decentralizованной архитектуры. Особое внимание уделено тому, как данные становятся продуктами, как выстраиваются доменные ответственности и как self-service платформа поддерживает эффективное использование данных без потери управляемости.
-
Глава призвана предоставить понятную дорожную карту: какие компоненты необходимы, как они взаимодействуют, какие политики и процессы требуют внедрения, и какие техничес решения помогут реализовать эффективный поиск, прозрачность и управление данными внутри Data Mesh.
-
В конце главы приведены практические примеры внедрения, потенциальные риски и набор вопросов для самоконтроля и планирования.
Краткое содержание главы
- Определение метаданных, lineage и каталога данных в контексте Data Mesh, роли владения данными и data products.
- Архитектура и интеграции: как организовать федеративный каталог, сбор метаданных из пайплайнов и BI-инструментов, и как обеспечить единый поиск.
- Модели данных и семантика: типы метаданных, контракты данных и их влияние на доверие и качество.
- Управление качеством, прозрачностью и ответственностью: lineage, аудит, соответствие требованиям и политики доступа.
- Практики внедрения: минимально жизнеспособный каталог, эволюционные паттерны, обмен знаниями между доменами и автоматизация процессов.
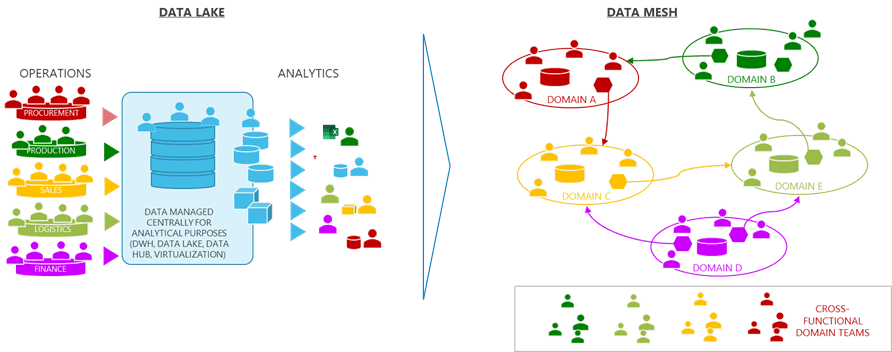
Контекст: роль метаданных, каталога и lineage в Data Mesh
Метаданные - это информация о данных, которая описывает их содержимое, происхождение, качество, контекст использования и условия доступа. В Data Mesh метаданные становятся связующим звеном между доменными командами, отвечающими за данные внутри своих границ, и потребителями данных по всей организации. Без четко структурированных метаданных поиск и повторное использование данных становятся невозможными или субъективными.
Lineage, или линейность данных, охватывает цепочку превращений и потоков данных: от источников до конечных потребителей, включая ETL/ELT-пайплайны, потоки событий, репликации и трансформации. Линейность обеспечивает прозрачность происхождения данных, позволяет аудитировать качество, выявлять источники ошибок и упрощает соблюдение регуляторных требований. Каталог данных компактизирует все эти элементы в единое средство обнаружения, классификации и понимания контекста.
Два ключевых аспекта, на которых строится эффективная система метаданных в Data Mesh:
- децентрализация владения данными и согласование контрактов: домены несут ответственность за качество и доступность своих наборов данных, но требуют общей видимости и стандартов описания;
- self-service и продуктовая направленность: пользователи получают понятный доступ к данным и метаданным через каталог, API и данные как продукт (data products), что повышает скорость внедрения и уменьшает когнитивную нагрузку на исследователей данных и разработчиков.
Понимание того, какие именно метаданные собирать и как их хранить, напрямую влияет на поиск, доверие к данным и способность быстро реагировать на изменения в пайплайнах и бизнес-требованиях. В этом контексте каталог становится не просто витриной, а рабочим инструментом, поддерживающим соглашения о кодификаций, семантике и безопасности.
Архитектура метаданных и каталога данных
Эффективная архитектура каталога данных в Data Mesh строится вокруг нескольких взаимодополняющих слоев и интерфейсов. В основе - федеративная модель, где каждый домен хранит и управляет своими метаданными, но каталоги доменов синхронизируются на уровне глобального каталога по единым стандартам описания. Это обеспечивает локальную автономию и глобальную видимость одновременно.
- Компоненты каталога данных
- Хранилище метаданных: база данных или графовый индекс, где сохраняются сущности данных, их атрибуты, версии и контексты использования.
- Поиск и индексация: полнотекстовый поиск, фильтры по домену, тегам и контрактам, поддержка релевантности и персонализации выдачи.
- Метаданные пайплайнов: интеграция с ETL/ELT, потоками событий и репликациями, автоматический сбор и обновление lineage и контекстов данных.
- API и UI: REST/GraphQL API для программного доступа и пользовательский интерфейс для исследователей и доменных экспертов.
- Контракты данных и категоризация: хранение контрактов, уровней качества данных, правил доступа и политики лицензирования.
- Метаданные бизнес-логики: терминология, глоссары, бизнес-правила и связь с бизнес-процессами.
- Интеграции с пайплайнами и системами потребления
- Интеграция со стеком CI/CD данных: автоматическое обновление метаданных после изменений в пайплайнах, мониторинг изменений и соответствие контрактам.
- Интеграция BI и аналитики: связь с отчетами, дашбордами и моделями данных, чтобы обеспечить согласованность между аналитическими выводами и исходными данными.
- Инструменты групповой работы: уведомления, задачи по управлению качеством данных и совместная работа через комментарии и аннотации.
- Архитектурные паттерны
- Федеративный каталог: каждый домен хранит локальные метаданные, глобальный индекс обеспечивает поиск по всей организации.
- Источники единого сигнала изменений: события об изменениях в пайплайнах, добавлениях набора данных, обновлениях контрактов.
- Контрактно-ориентированная архитектура: данные как продукт с четкими контрактами, уровнями качества, SLA и политиками доступа.
- Примеры практических реализаций
- Amundsen: открытое решение для каталогизации метаданных и поиска, поддерживающее интеграцию с различными пайплайнами и источниками данных.
- DataHub: платформа с фокусом на lineage, поиске и семантике, подходит для гибридной (федеративной) архитектуры метаданных и богатой экспликации контекста.
- В реальных условиях возможно сочетать подходы: доменные города-агентовские каталоги с публикацией в глобальном индексе и синхронизацией через событийное шину.
Архитектура требует четко определённых политик управления и процессов обновления. В частности:
- какие метаданные являются обязательными для каждого набора данных;
- как обрабатываются устаревшие данные и версии;
- как обеспечивается соответствие требованиям по безопасности и приватности;
- как реализуется доступ к данным и какие уровни доступа применяются как внутри доменов, так и на уровне организации.
Для эффективной реализации важны следующие принципы проектирования:
- совместимость семантики: единый словарь терминов и глоссарий, чтобы одинаковые понятия трактовались одинаково во всех доменах;
- устойчивость к изменениям: метаданные должны адаптироваться к новым типам данных, новым пайплайнам и новым требованиям;
- наблюдаемость и аудит: прозрачная история изменений метаданных и lineage, возможность аудита использования данных;
- безопасность и соответствие: детальные политики доступа, шифрование, контроль доступа и хранение версии контрактов.
Модели метаданных и семантика
Метаданные делятся на несколько категорий, каждая из которых несёт свою ценность для разных групп пользователей и задач.
- Типы метаданных
- Технические: структура данных, формат, схема (schema), типы полей, дефиниции ключей и зависимостей.
- Бизнес-метаданные: предназначение набора, бизнес-целевые показатели, контекст использования, термины и глоссарий, соответствие бизнес-правилам.
- Операционные: данные об обновлениях, задержках потоков, уровни качества, SLA, аудит изменений.
- Контроль доступа и безопасность: политики доступа, классификация чувствительности, требования к шифрованию и анонимизации.
- Семантика и теги
- Единый словарь терминов: устранение неоднозначностей, унификация понятий.
- Теги и категории: доменные теги, тематика, критичность, ответственность за данные.
- Контракты данных
- Определение наборов контрактов: набор полей, форматы, допустимые значения, требования к качеству и частоте обновления.
- Механизмы эскалации и уведомлений в случае отклонений: автоматические уведомления, регламентированные действия владельцев.
- Ключевые принципы хранения
- Версионирование метаданных: отслеживание изменений во времени, возможность отката.
- Хронология источников и изменений lineage: полная история происхождения и траектории данных.
Модели метаданных должны подкреплять практики Data Product и доменной ответственности. В частности, при описании набора данных следует явно указывать: кто владелец данных в домене, какие бизнес-цели обслуживает набор, какие требования к качеству применяются и какие ограничения доступа действуют. Хорошо спроектированные модели позволяют быстро сопоставлять данные с бизнес-терминами, адаптироваться к изменениям и поддерживать показатель доверия к данным.
Lineage и прозрачность: практика и архитектура
Lineage является критическим элементом прозрачности данных: он показывает путь данных от источников к потребителям и преобразованиям, которым данные подвергаются в процессе. В контексте Data Mesh lineage служит доказательством согласованности между контракта и реальной реализации, а также инструментом для аудитирования и устранения узких мест в пайплайнах.
- Стратегии сбора lineage
- Инструментальная инъекция: внедрение телеметрии в пайплайны (как в источниках, так и в процессах трансформации) для автоматического формирования графа lineage.
- Инструментальная агрегация: сбор lineage из нескольких систем через коннекторы, фабрики событий и интерфейсы API.
- Ручной ввод: в отдельных случаях возможно добавление вручную за счет экспертной оценки, особенно для нестандартных трансформаций.
- Видимость lineage
- Визуализация в каталоге: отображение маршрутов данных, зависимостей между наборами и их трансформациями.
- Кросс-доменная прозрачность: возможность пользователям из разных доменов видеть lineage, чтобы понимать влияние изменений в одном домене на другие.
- Связь с контрактами и SLA: lineage связан с контрактами данных, чтобы потребители могли отслеживать соблюдение ожиданий по качеству и доступности.
- Качество и аудит через lineage
- Автоматическое обнаружение несоответствий: выявление несоответствий между фактическими преобразованиями и контрактами.
- Метрики доверия: доля наборов данных с полным lineage, полнота metadata, частота обновления, корректность тегирования.
- Соответствие требованиям: хранение аудита и журналов изменений для регуляторных целей.
- Примеры практик
- Инструменты каталогов: Amundsen и DataHub предоставляют функциональные возможности для визуализации lineage и контекста данных, облегчая аудит и поиск.
- Интеграция событий: использование брокера сообщений (например, Apache Kafka) для передачи изменений в метаданные и lineage между системами.
Баланс между автоматизацией и контролируемыми ручными вставками критически важен. Полная автоматизация lineage снижает операционные издержки, но требует зрелых процессов отклика на изменения и качественные коннекторы. В то же время, поддержка экспертов-доменов в добавлении качественных бизнес-метаданных и аннотаций обеспечивает более точную семантику и полезность каталога для конечных пользователей.
Управление качеством данных, безопасность и доступ
Управление качеством данных и обеспечение соответствия требованиям - это не только техническая задача, но и управленческая и организационная. В Data Mesh качество является коллективной ответственностью доменных команд, однако общие политики, стандартные контракты и требования к безопасности должны быть унифицированы и доведены до каждого домена.
- Качество данных
- Определение уровней качества (quCDs): точность, полнота, своевременность, достоверность, согласованность.
- Механизмы мониторинга: автоматические проверки ценностей, диапазонов значений, согласования схем и контрактов.
- Ассоциации с бизнес-целями: определение того, какие показатели качества критичны для конкретного использования данных.
- Безопасность и приватность
- Классификация чувствительности: высокий, средний, низкий уровень, применяемые меры защиты.
- Контроль доступа: принципы минимальных привилегий, аудит доступа, контракты безопасности для каждого набора данных.
- Анонимизация и псевдонимизация: методы защиты данных при необходимости использования в аналитических задачах и исследованиях.
- Контракты и соблюдение
- Контракты данных определяют параметры использования данных, обязательства доменов и правила доступа.
- Мониторинг отклонений: процедуры уведомления, эскалации и автоматизированной реакции на нарушения контрактов и SLA.
Важно обеспечить прозрачность между доменами: владелец данных в домене должен иметь возможность быстро увидеть, какие потребители данных существуют и какие политики применяются к конкретному набору данных. Это позволяет снизить риск нарушений и повышает доверие к данным внутри организации.
Внедрение в рамках Data Mesh: паттерны, процессы и шаги
Внедрение метаданных, каталога и lineage в Data Mesh следует рассматривать как эволюционный процесс. Развертывание должно идти по шагам, на каждом из которых достигаются конкретные цели и создаются соответствующие артефакты, которые можно использовать для дальнейшей экспансии.
- Стартовый набор артефактов
- Базовая модель метаданных для ключевых доменов: технические, бизнес-метаданные и контракты.
- Начальный федеративный каталог с минимально необходимыми наборами данных и базовыми тегами.
- Простая визуализация lineage для критически важных наборов данных и каналов передачи.
- Переход к зрелости
- Расширение каталога за счет новых доменов и улучшение согласованности семантики.
- Интеграция с более сложными пайплайнами и источниками, поддержка более сложных контрактов.
- Внедрение политик доступа и мониторинга на уровне каталога и домена.
- Практические сценарии внедрения
- Быстрый старт с минимальным жизнеспособным каталогом: выбрать набор данных, верифицировать контракты и обеспечить базовый поиск.
- Эволюция через data products: описание и управление data products, поддержка связанных контрактов, SLA и ответственности.
- Интеграция с существующими системами: BI-инструменты, системы качества данных, службы мониторинга и аудита.
- Роли и ответственность
- Владельцы доменов за данные и их метаданные.
- Глобальные роли по управлению метаданными и аудитом.
- Команды обеспечения качества и безопасности, ответственные за политику и её исполнение.
Риски внедрения включают сложности согласования стандартов, сопротивление изменениям и нехватку квалифицированных специалистов. Эффективная коммуникация между доменными командами, согласование контрактов и внедрение автоматизированной инфраструктуры метаданных являются ключами к устойчивому прогрессу. Назначение ответственных за конкретные данные и четкие процедуры обновления метаданных помогают снизить эти риски.
Key takeaways
- Метаданные, каталог и lineage образуют фундамент децентрализованной архитектуры данных в Data Mesh и обеспечивают поиск, прозрачность и управление данными.
- Федеративная архитектура каталога поддерживает автономию доменов при общей видимости и единых стандартах описания.
- Контракты данных, бизнес-метаданные и операционные аспекты должны быть тесно связаны через единый словарь и семантику.
- Lineage обеспечивает трассируемость происхождения данных и соответствие контрактам, что критично для аудита и доверия.
- Внедрение следует рассматривать как эволюционный процесс с минимальной стартовой базой и структурированной дорожной картой по мере роста зрелости.
- Практические решения, такие как Amundsen и DataHub, могут служить опорными платформами для реализации каталогов и lineage, при этом важно адаптировать их к доменным требованиям.
- Обеспечение безопасности и соответствия требует сочетания политик, контроля доступа, мониторинга и аудита на уровне каталога и доменов.
- Self-service доступ к данным и data products требует четких контрактов, понятного описания данных и удобного интерфейса для исследователей и бизнес-пользователей.
FAQ
- Что такое метаданные в контексте Data Mesh и зачем они нужны?
Метаданные - это структурированная информация о данных: происхождение, контекст использования, качество, форматы, владельцы и ограничения доступа. В Data Mesh они позволяют доменным командам быстро находить данные, понимать их смысл, оценивать риски и соответствовать требованиям нормативов. Без метаданных поиск превращается в догадку, а управление данными - в сложный ручной процесс.
- Какие виды метаданных особенно важны для каталога?
Ключевые категории: технические (схемы, форматы, зависимости), бизнес-метаданные (назначение, контекст, глоссарий), операционные (тайминги обновления, SLA, история изменений) и политики доступа/безопасности. Кроме того важны контракты данных и линейность (lineage), которые связывают техническую реализацию с бизнес-обязанностями.
- Как выбрать архитектуру каталога: федеративный или централизованный подход?**
Федеративный каталог обеспечивает автономию доменов и локальные сценарии использования, сохраняя при этом возможность глобального поиска и координации. Централизованный компонент может быть полезен для унифицированной визуализации и упрощенного администрирования, но рискует стать узким местом и ограничить agility доменов. В реальности эффективна гибридная модель: федеративные источники метаданных с глобальным индексом и стандартами описания.
- Как обеспечить качество данных через lineage?
Lineage позволяет видеть, как данные проходят через пайплайны, какие трансформации выполняются и какие источники задействованы. Это облегчает поиск источников ошибок, управление контрактами и аудит. Для эффективной практики необходима автоматизация сбора lineage, поддержка ручной аннотации там, где автоматизация невозможна, и тесная привязка lineage к контрактам данных.
- Как связать каталоги с доменными владениями и ответственностью?
Каждый домен отвечает за свои метаданные, контракты и данные как продукт. При этом существует общий набор стандартов описания, политики доступа и SLA, который обеспечивает видимость и согласование между доменами. Важно назначать ответственных за метаданные внутри домена (Data Steward) и устанавливать процедуры эскалации и аудита.
- Какие практики способствуют успешному внедрению self-service каталога?
Необходимо предоставить интуитивно понятный поиск, понятные бизнес-термины и глоссарий, а также хорошо документированные контракты данных. API и SDK для интеграции с аналитикой и BI ускорят внедрение. Важны обучение пользователей, поддержка community-driven подхода и регулярные обновления справочников и контрактов.
- Как обеспечить безопасность и соответствие требованиям?
Разработайте политики доступа на уровне набора данных и контрактов, используйте модули аудита и журналирования, реализуйте анонимизацию там, где это требуется, и следите за соответствием нормативам. Регулярно проводите аудиты и обновляйте политики в ответ на новые бизнес-требования и регуляторные изменения.
- Какие риски связаны с каталогами и lineage и как их минимизировать?
Риски: несогласованность стандартов, устаревшие метаданные, слабая интеграция с пайплайнами, риск перегрузки пользователей информацией. Минимизировать риск можно через четкое управление изменениями, автоматическое обновление метаданных, разумную стратегию тегирования и участие доменов в процессе определения стандартов и контрактов.
- Какие KPI полезны для оценки эффективности каталога и lineage?
Частота обновления метаданных, доля объектов с полным lineage, скорость поиска по новым запросам, уровень удовлетворенности пользователей, количество контрактов, соблюдающих SLA, доля активных данных, риск инцидентов по данному набору.
- С чего начать минимально жизнеспособную реализацию каталога в Data Mesh?
Начните с определения 2-3 критически важных доменных наборов данных и создайте базовую модель метаданных, включая контракты и основные бизнес-метаданные. ПостройтеFederative каталог и реализуйте простой поиск по ключевым полям. Включите lineage для самых критичных пайплайнов и установите процедуры аудита и обновления. Обеспечьте связь между данными и data products, чтобы пользователи могли легко найти и начать использовать данные как продукт.


