

Риски, ограничения и типичные ошибки в проектах CDC
CDC-проекты на базе Debezium обещают минимизацию задержек между источником и потребителем, но реализация такой архитектуры несет специфические риски и ограничения. Понимание их на стадии проектирования позволяет выверить архитектуру, выбрать корректные параметры интеграции и сформировать устойчивые операционные практики. В этой главе рассматриваются наиболее значимые типы рисков, способы их диагностики и практические подходы к снижению влияния на бизнес-цели.
CDC-проекты характеризуются сочетанием технологических ограничений источников данных, поведения стриминговой платформы и особенностей конвейеров обработки. Необходимо помнить о различиях между системами источников (MySQL, PostgreSQL, MongoDB и пр.), особенностях Debezium как инструмента репликации изменений и ограничениях инфраструктуры Kafka и потоковых систем. Реализация требует постоянной оценки компромиссов между задержкой, единоразовой обработкой изменений, масштабируемостью и качеством данных.
Краткое содержание главы
- Архитектурные ограничения и проектные решения для CDC с Debezium и Kafka.
- Консистентность данных, порядок событий, обработка удалений и повторного воспроизведения.
- Производительность, латентность и масштабирование CDC пайплайнов.
- Эксплуатационные риски: мониторинг, тестирование, релизы и управление изменениями.
- Практические паттерны минимизации рисков и типичные ошибки, которые следует избегать.
Архитектурные риски и ограничения
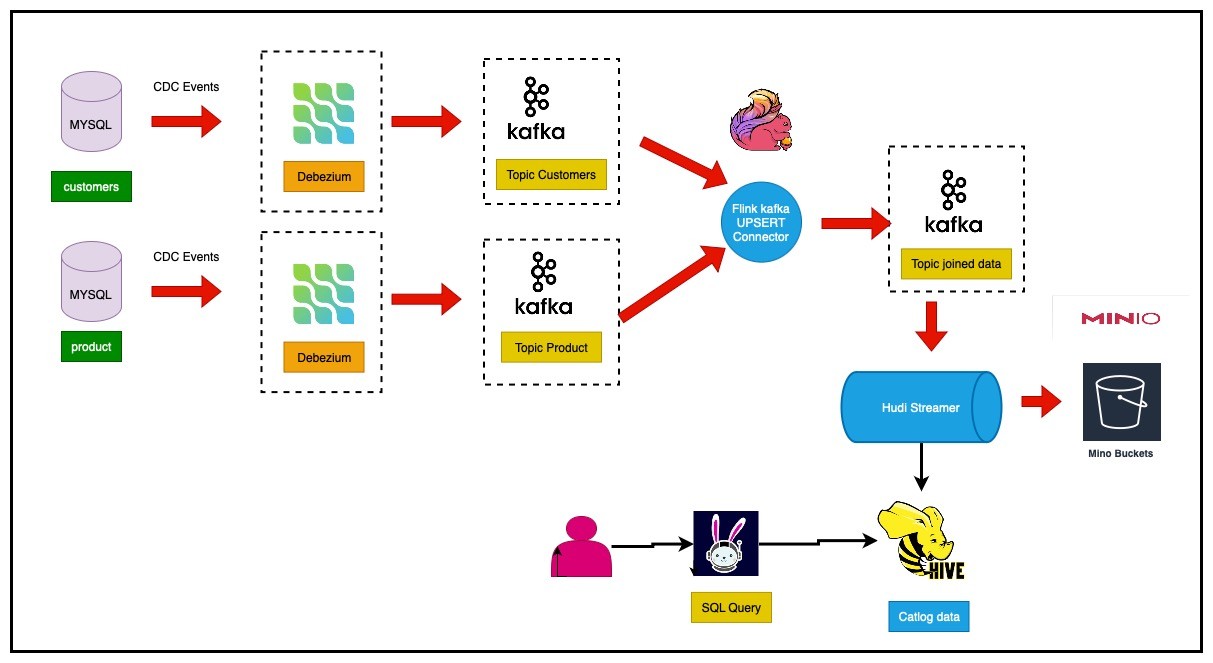
Архитектура CDC-пайплайна включает в себя источники данных, Debezium в роли коннектора, Kafka как транспорт и хранилище состояния, а также потребителей, которые формируют целевые системы. В этой связке риск возникает на стыках: несовместимость форматов изменений, ограниченная поддержка специфических операций в конкретной СУБД, ограничения протоколов и спецификаций, а также проблемы синхронизации между различными узлами инфраструктуры.
Главные аспекты архитектурных ограничений:
- Эволюция схем: изменения в таблицах и колонках должны раскрываться без потери потока изменений. В реальности дифференциация изменений не всегда совпадает с ожидаемым в целевых системах (например, когда новые колонки без дефолтов становятся обязательными). Важно заранее договориться о политике обработки схем: какие изменения логируются, как обрабатывать добавление колонок, удаление колонок и изменение типов. Встроенные механизмы Debezium позволяют транслировать схему изменений, но потребители должны быть готовы к эволюции.
- Поддержка операций баз данных: Debezium реализует CDC через чтение журналов изменений источника, например binlog/redo log. Разные СУБД по-разному поддерживают операции INSERT/UPDATE/DELETE, а также tombstones. Не все операции конвертируются в единообразные события в Kafka, что может потребовать дополнительной обработки на стороне потребителей.
- Архитектура источника: стабильная репликация зависит от характеристик источника. В среде с высокой нагрузкой может появляться задержка или временные задержки в передаче изменений, что приводит к рассинхронности между источником и подписчиками. В частности, для MySQL/PgSQL характерны различные режимы логирования, блокировки и задержек, что влияет на латентность.
- Масштабируемость коннекторов: Debezium запускается как часть Kafka Connect или в кластерной среде. Производительность зависит от числа задач, аппаратной мощности и конфигурации памяти. Неправильная балансировка задач или недооценка ресурсов может привести к перегрузке коннекторов и задержкам в потоке изменений.
- Природа истории изменений: Debezium хранит историю изменений и состояние оффсетов в Kafka и внутреннем хранилище. Если исторические данные ломаются, это может повлечь за собой проблемы воспроизведения изменений. Правильная настройка "database.history" и надёжного хранения истории критична для устойчивости пайплайна.
- Соответствие времени и порядок: системные часы и задержки сетей вызывают рассинхрон между источниками и потребителями. В случаях, когда точный хронологический порядок критичен, требуется дополнительная логика сортировки и обработки времени событий на стороне потребителей.
Практическая рекомендация:
- заранее планируйте политику эволюции схем: какие изменения поддерживаются автоматически, какие требуют миграций в потребителях, и какие уведомления будут отправляться в команду данных.
- обеспечьте мониторы для задержек по каждому сегменту пайплайна (источник → Debezium → Kafka → потребители) и задайте пороги уведомлений.
- ограничьте риск отказа от историй изменений: используйте надёжное хранилище истории и резервное копирование конфигураций коннекторов.
Взаимодействие с планами изменений и схемами
Изменения схем требуют синхронной координации между командами. Часто возникают ситуации, когда источник изменяется раньше потребителя. В таких случаях полезна стратегия версионирования схем и явного указания версии событий в полезной нагрузке. Это упрощает локализацию проблем и облегчает миграции. Важно также предусмотреть план отката изменений схемы: как потребители будут обрабатывать обратную совместимость, если новая версия схемы несовместима с текущей реализацией.
Примеры конфигурации и ограничений
Конфигурация Debezium может включать параметры, влияющие на архитектуру:
- включение истории схем и режимы эволюции;
- выбор частоты фиксации точек состояния;
- ограничение размера журналов и ретеншен;
- настройка параметров потока через Kafka, таких как количество разделов и число потребителей.
{
  "name": "inventory-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "tasks.max": "4",
    "database.hostname": "db-host",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "dbz",
    "database.server.id": "184054",
    "database.server.name": "dbserver1",
    "database.include.list": "inventory",
    "table.include.list": "inventory.orders,inventory.customers",
    "include.schema.changes": "true",
    "offset.flush.interval.ms": "60000",
    "database.history.kafka.bootstrap.servers": "kafka:9092",
    "database.history.kafka.topic": "dbserver1.history"
  }
}
Риски консистентности и синхронизации данных
Основной целью CDC является передача изменений в режиме близком к реальному времени. Однако консистентность данных на отражении в целевых системах зависит от ряда факторов: задержек в источнике, особенностей обработки и дизайна потребителей. В этой секции рассматриваются механизмы достижения и поддержания корректной консистентности, а также типичные проблемы, возникающие при повторной обработке изменений или изменении порядка событий.
Ключевые аспекты:
- единообразие времени и порядок: события не обязательно приходят в исходном порядке из-за различной задержки и параллельной обработки. Необходимо обеспечить устойчивую логику обработки, которая корректно обрабатывает_OUT_OFORDER события, а также применяет изменения с учётом их временной метки.
- обработка удалений: tombstone-события и отсутствие изменений требуют ясной политики на стороне потребителей. Некорректная обработка удалений может привести к рассинхронности и неверному синхронному состоянию целевых систем.
- идемпотентность потребителей: повторная обработка тех же изменений может приводить к дубликатам или некорректному состоянию. Подходы включают идемпотентные операции, уникальные ключи и контроль версий записи.
- репликационные курсы: инфраструктура может нормализовать задержку, что приводит к асинхронной репликации между конвейером и целевыми системами. Важно проектировать потребителей так, чтобы они могли адаптироваться к различным скоростям обработки и задержкам.
- режимы консистентности: не все сценарии допускают единоразовую обработку. Вопрос о том, нужна ли "exactly-once" семантика, - зависит от целевых систем и бизнес-требований. В большинстве случаев допускается "at-least-once" с доп. защитой на уровне потребителей.
Практическая рекомендация:
- реализуйте четкую стратегию обработки времени и порядка событий, включая логику детерминированной обработки и тестируемые сценарии на повторное воспроизведение.
- применяйте идемпотентные обновления в целевых системах, где это возможно; если нет - используйте медиаторы, которые нивелируют дубликаты.
- тестируйте сценарии удаления и восстановления данных, включая "soft delete" и "hard delete" в зависимости от бизнес-логики.
Управление версионированием событий
Чтобы обеспечить устойчивость к изменениям схем, полезно внедрять явное управление версиями событий в полезной нагрузке. Это позволяет потребителям определить, как обрабатывать конкретную версию записи, и облегчает миграцию между версиями. В отсутствие контроля версий проблемные сценарии, такие как внезапные изменения структуры данных, приводят к ошибкам десериализации и нарушению консистентности.
Примеры паттернов
- паттерн "schema registry + аутентификация": согласование форматов и версий через реестр схем, который обеспечивает совместимость между Producers и Consumers.
- паттерн "event replay": хранение недавней истории изменений и способность повторно проигрывать события для целевых систем без ошибок состояния.
Производительность, латентность и масштабирование
Производительность CDC пайплайна определяется как скоростью, с которой изменения проходят от источника к целевой системе, так и устойчивостью к пиковым нагрузкам. В этом разделе рассматриваются драйверы латентности, масштабирования и надёжности, которые критичны для предприятия при работе с Debezium и Kafka.
Основные моменты:
- латентность: задержка между изменением в исходной базе и доступностью соответствующего события в целевой системе. Она определяется временем чтения журнала изменений, временем обработки коннектором, задержкой передачи через Kafka и временем обработки потребителями. Для некоторых сценариев допустимо увеличение латентности в пользу устойчивости.
- пропускная способность: пропускная способность пайплайна зависит от числа задач Debezium, числа разделов Kafka, числа потребительских групп и TOPIC-параметров. При росте объема изменений следует рассматривать горизонтальное масштабирование Debezium (несколько задач) и увеличение числа разделов Kafka.
- хранение состояния: Debezium и Kafka хранят состояние оффсетов, истории изменений и т.д. Важно обеспечить достаточное место под журнал и защиту от потери состояния, чтобы исключить повторную реплику и потерю данных.
- формат и размер сообщений: крупные изменения и сложные записи могут увеличить размер сообщений и влиять на сетевые и потребительские задержки. Оптимизация поля полезной нагрузки и чистка ненужной информации может снизить нагрузку на сеть и дисковый ввод-вывод.
- безопасность и шифрование: обеспечение безопасной передачи через TLS и контроль доступа к топикам Kafka, а также к хранилищам истории. Безопасность может добавлять задержку и сложность конфигурации, но критична для коммерческих систем.
Практическая рекомендация:
- планируйте кластер Kafka с учетом ожидаемых пиков, проводите нагрузочные тесты и используйте canary-демонстрацию изменений.
- используйте мониторинг задержек по каждому сегменту пайплайна: от источника до целевого потребителя, чтобы быстро локализовать узкие места.
- применяйте мемориальные и дисковые оптимизации Debezium: настройки памяти JVM, лимиты очередей и конфигурацию буферов, чтобы обеспечить предсказуемость производительности.
Тестирование производительности и устойчивости
Проверка CDC-пайплайна в тестовой среде должна включать сценарии с пиковыми нагрузками и резкими изменениями схем. Включение тестовых данных, имитирующих реальное изменение, позволяет выявлять узкие места и ошибки в обработке. Важно проверить сценарии задержек, повторного воспроизведения и ошибок источников, чтобы удостовериться в корректности реакции потребителей.
{
  "name": "inventory-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "tasks.max": "8",
    "database.hostname": "test-db",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "password",
    "database.server.name": "dbserver1",
    "database.include.list": "inventory",
    "include.schema.changes": "true",
    "offset.flush.interval.ms": "30000",
    "database.history.kafka.bootstrap.servers": "kafka:9092",
    "database.history.kafka.topic": "dbserver1.history"
  }
}
Инфраструктура, интеграции и эксплуатационные риски
Рациональная эксплуатация CDC-пайплайна требует продуманной инфраструктуры. Здесь учитываются вопросы интеграции Debezium с Kafka, стабильности Connect-кластера, безопасности и управления зависимостями между компонентами. Эффективная архитектура обеспечивает устойчивость к сбоям, возможность масштабирования и упрощение операционных процессов.
Ключевые направления:
- архитектура Connect: риски, связанные с распределённой обработкой задач, нужны четкие правила балансировки и мониторинг ресурсов. В случае больших проектов целесообразно использовать кластерную конфигурацию с резервированием и отказоустойчивыми схемами.
- топики Kafka и фактор репликации: выбор количества разделов, репликаций и контроль доступности. Неправильная конфигурация может привести к потере данных или задержкам. Важно обеспечить достаточные ресурсы и устойчивость к сбоям.
- совместная работа с реестрами и схемами: реестры схем (если применимо) помогают поддерживать совместимость и отслеживать версии. Однако они требуют дополнительных зависимостей и контролей доступа.
- безопасность и соответствие: ограничение доступа к данным через контроль доступа, а также шифрование и контроль аудита. Обеспечение конфиденциальности данных критично при работе с поточными системами.
- мониторы и алертинг: мониторинг задержек, загрузок памяти, CPU и дискового ввода-вывода. Неправильная настройка мониторинга может привести к задержкам в обнаружении проблем и неэффективному реагированию.
Практическая рекомендация:
- внедрите полноценную модель мониторинга и алертинга: задержка конвейера, задержка в источнике, величина дискового использования и прочее.
- настройте защиту от перегрузок: лимит задач Debezium и пула коннекторов, ограничение скорости и ретрансляции ошибок.
- проведите регулярные аудиты конфигураций: контроль доступа, журналирование и изменение политик.
Безопасность данных и соответствие требованиям
CDC-проекты часто оперируют чувствительной информацией. В контексте Debezium важно не только обеспечить передачу изменений, но и соблюдение требований по хранению, обработке и доступу к данным. Это включает настройку шифрования, аудита, контроля доступа к топикам Kafka, а также управление темами и историей изменений. Особое внимание уделяют данным, подход которым попадает под регулятивные нормы (PII, PCI-DSS и т. п.).
Управление рисками, тестирование и процессы
Управление рисками в CDC-проектах требует организация процессов разработки, тестирования и эксплуатации. В этой секции рассмотрены стратегии снижения рисков через планирование релизов, автоматизацию тестирования и контрольный набор процессов для устойчивity пайплайна.
Ключевые элементы:
- CI/CD для коннекторов: автоматизированная сборка, тестирование и развёртывание конфигураций Debezium и Kafka Connect. Включает проверки совместимости версий, регрессионное тестирование и безопасный выпуск.
- canary и phased rollout: постепенное внедрение изменений в продакшн, минимизация риска и возможность быстрого отката.
- тестирование на реальной нагрузке: создание тестовых сценариев, близких к реальному объему и структуре данных, проверка поведения коннекторов и потребителей в условиях пиковых нагрузок.
- управление изменениями: документирование политик изменения схем, правил дорожной карты и ответственных за детали реализации.
- мониторинг целевых систем: проверка целевых систем на корректность применения изменений и устойчивость к ошибкам на стороне источника и конвейера.
Примеры лучших практик
- разделение задач Debezium по сервисам или доменам данных, чтобы локализовать проблемы и упростить масштабирование.
- установление ограничений для операций DDL на уровне источников вне CDS-пайплайна, чтобы предотвратить неожиданные изменения, влияющие на пайплайн.
- формирование политики отката: как вернуть систему к состоянию до изменения при обнаружении критических проблем.
Примеры ошибок и как их избегать
- недооценка эволюции схем: без ясной политики добавления колонок и изменения типов можно получить конфликт данных или ошибки десериализации.
- игнорирование порядка событий: если потребителям не обеспечен упорядоченный вывод, данные могут применяться в неверном порядке.
- злоупотребление режимами "exactly-once": в некоторых случаях слишком строгая семантика может снизить производительность и увеличить сложность. В большинстве сценариев подходит "at-least-once" с надежной идемпотентностью потребителей.
- недостаточный мониторинг: без систематического мониторинга задержек и ошибок трудно понять, где именно возникают проблемы.
Типичные ошибки внедрения и их коррекция
В практике CDC-проектов встречаются несколько распространённых ошибок, которые приводят к задержкам, потере данных или некорректной синхронности. В этом разделе приводятся конкретные примеры и способы их устранения.
- слабая поддержка версий схем: если версии схем не синхронизированы между источником и потребителем, десериализация может упасть. Решение - внедрить реестр схем, контрактное тестирование и явную политику обновления версий.
- неправильная обработка deletes: отсутствие tombstones или неправильная передача удалений в целевые системы. Решение - четко определить стратегию удаления и корректно обрабатывать tombstones на стороне потребителей.
- несоблюдение ограничений по ресурсам: выбор слишком агрессивного конфигурации задач Debezium и слишком малого числа разделов Kafka. Решение - провести нагрузочное тестирование и корректировку масштаба.
- неэффективное тестирование изменений схем: без имитации реальных изменений в схемах можно пропустить критичные проблемы. Решение - включение эволюций схем в тестовую среду.
Key takeaways
- CDC-проекты требуют дисциплины в управлении схемами, версиями изменений и обработкой удалений.
- Архитектурные решения должны учитывать эволюцию источников, особенности Debezium и ограничения Kafka.
- Консистентность данных достигается через продуманную обработку порядка событий, идемпотентность потребителей и грамотную политику tombstones.
- Производительность зависит от горизонтального масштабирования и правильной настройки ресурсов для Debezium и Kafka.
- Эксплуатационные процессы (monitoring, тестирование, rollout) критичны для устойчивости пайплайна и контроля рисков.
- Безопасность и соответствие требованиям должны быть встроены в архитектуру и процессы на ранних стадиях проектов.
- Типичные ошибки часто связаны с нехваткой планирования изменений в схемах, отсутствии мониторинга задержек и неучетом удалений.
FAQ
- Что такое CDC и почему она важна в Debezium?
- Change Data Capture (CDC) - это технология отслеживания изменений в источнике данных и их передачи в целевые системы в режиме реального времени. Debezium реализует CDC через чтение журналов изменений СУБД и распространение событий в Kafka. Это позволяет снизить задержку между изменениями в источнике и их отражением в аналитических и оперативных системах. В реальных сценариях CDC обеспечивает актуальность данных без прямого опроса источника и повторной обработки больших объемов данных, что существенно экономит ресурсы и ускоряет принятие решений.
- Какие риски связаны с эволюцией схем и как их минимизировать?
- Эволюция схем может привести к несовместимостям между источниками и потребителями, если не предусмотрена версия изменений и обработка новых полей. Минимизация рисков достигается через внедрение реестра схем или контрактов на уровне событий, четкую политику поддержки изменений (добавление, удаление полей, изменение типов) и тестирование совместимости в тестовой среде. Важна также детальная документация изменений и их влияние на потребителей.
- Как управлять порядком событий в потоке изменений?
- Порядок событий может меняться из-за различной задержки между коннектором и потребителем. Рекомендуется реализовать на стороне потребителей детерминированную обработку и сортировку по меткам времени или версии события, а также использовать уникальные ключи записи для обеспечения идемпотентности. Можно применить диапазонную обработку и буферизацию до получения необходимой последовательности.
- Что делать с tombstones и удалениями в CDC?
- tombstone-события обозначают удаление записей, и потребители должны уметь корректно применять такие события (удаление строк в целевых системах, пометка приватности иности и т. д.). Необходимо определить, как именно обрабатываются удаленные записи и как об этом сигнализируется на целевых системах. Игнорирование tombstones может привести к «мертвым» записям или несоответствию между источником и потребителем.
- Как обеспечить масштабируемость CDC пайплайна?
- Масштабируемость достигается за счет горизонтального масштабирования Debezium (несколько задач на разных источниках) и увеличения числа разделов Kafka на топиках, а также распределенных потребителей. Важно также обеспечить балансировку нагрузки и мониторинг узких мест, чтобы вовремя реагировать на перегрузки.
- Какие практики тестирования CDC-пайплайна наиболее эффективны?
- Эффективны тесты на эволюцию схем, тесты на удаление и повторное воспроизведение, имитация пиковых нагрузок и сценариев с задержками. Важно включать в тестовую среду реальные данные и сценарии, соответствующие производственным нагрузкам, чтобы выявлять проблемы на ранних стадиях.
- Какие паттерны безопасности применимы к CDC?
- Необходимо обеспечить защиту данных через TLS и контроль доступа к Kafka Topology, ограничение доступа к источникам и аудит изменений. Включение политики маскирования чувствительных данных на уровне потребителей и согласование требований соответствия регуляторным требованиям помогут минимизировать риск утечки.
- Какую роль играет мониторинг и алертинг в CDC?
- Мониторинг позволяет быстро обнаруживать задержки, сбои коннекторов и перегрузки в Kafka. Алерты должны уведомлять оперативную команду об аномалиях, таких как рост задержек, падение throughput или сбои в доставке изменений. Важно иметь единый центр мониторинга, где видна вся цепочка: источник, Debezium, Kafka и потребители.
- Как оценивать стоимость и ресурсы для CDC-пайплайна?
- Оценка затрат включает вычислительную мощность Debezium и Kafka, сеть, хранение в журналах изменений и резервное копирование. Необходимо моделировать пиковые нагрузки, определить пороги задержек и целевые SLA, а затем подбирать конфигурацию кластера, чтобы держать показатели в рамках.
- Что считать плохой практикой в проектах CDC?
- Игнорирование изменений в схемах, недооценка ресурсов для Kafka и коннекторов, отсутствие тестирования на эволюцию схем и отсутствия мониторинга задержек. Также недопустимо отсутствие плана отката и неучет удалений в целевых системах.
Глава рассчитана на практическое применение в проектах Debezium для Data Engineer: построение CDC пайплайнов, интеграция с Kafka и streaming-системами, а также организации потоковой синхронизации данных. В материалах приведены ключевые концепции, вопросы реализации и типовые сценарии, которые помогут снизить риски и повысить надёжность CDC-инфраструктуры.


