

Стратегия внедрения DuckDB в корпоративную архитектуру
DuckDB становится всё более востребованным компонентом современных аналитических платформ: он дополняет централизованные хранилища данными, обеспечивает гибкость внедрения и ускоряет SQL‑аналитику за счёт оптимизированной колоночной обработки. В условиях цифровой трансформации он выступает как связующий узел между прикладной аналитикой, data science и практиками управляемых данных. Эта глава формулирует стратегию внедрения, охватывая архитектурные решения, подходы к интеграции в data stack и организационные практики, которые позволяют обеспечить устойчивую ценность от DuckDB на корпоративном уровне.
DuckDB как архитектурный элемент следует рассматривать не изолированно, а в контексте экосистемы данных: Lakehouse или data lake + data warehouse, ETL/ELT‑пайплайны, BI и ноутбуки аналитиков, а также механизмы управления данными и безопасности. Основной баланс достигается за счёт сочетания встроенной аналитики в приложениях и центрального сервиса аналитики, поддерживающего единое понимание данных и единый контроль над доступом. В таком контексте DuckDB служит как двигатель локальной и слабо связанной аналитики: он позволяет снизить задержки в критичных сценариях, ускорить прототипирование и повысить гибкость архитектуры без риска миграции всего объёма данных.
Ключевые идеи, которые будут рассмотрены далее:
- архитектурные варианты развёртывания и их влияние на управляемость и стоимость владения;
- способы интеграции DuckDB в современные data stacks и совместимые паттерны;
- принципы оптимизации SQL‑аналитики за счёт columnar processing и векторной обработки;
- аспекты безопасности, соответствия и управляемости данными в условиях корпоративной среды;
- процессы внедрения и организационные изменения, необходимые для устойчивого эффекта.
Краткое содержание главы
- Определение ролей DuckDB в корпоративной архитектуре и базовых паттернов интеграции.
- Архитектурные варианты развёртывания: встроенный движок, серверный режим, интеграции с orchestration и облачными хранилищами.
- Производительность и оптимизация: принципы columnar processing, план запроса, профилирование и контроль качества аналитики.
- Управление данными и безопасность: безопасность, соответствие, каталогизация и совместимость с существующими инструментами.
- Стратегия внедрения и операционная практика: пилоты, дорожная карта, обучение команд, управление изменениями.
Контекст и роль DuckDB в корпоративной data stack
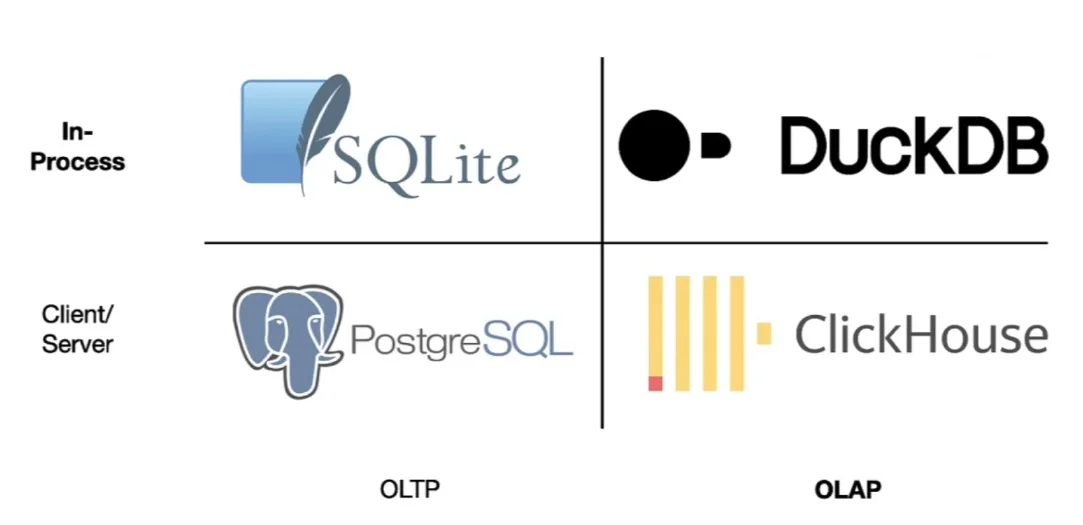
DuckDB реализует аналитическую обработку на уровне колонок и рассчитан на эффективную работу с наборами данных в среде, близкой к приложениям и исследовательским средам. В корпоративной архитектуре он выполняет несколько функций, которые дополняют существующие источники данных и инструменты анализа:
- ускорение локальных и повторяющихся аналитических задач. Встраиваемый движок позволяет выполнять сложные SQL‑операции непосредственно внутри приложений, ноутбуков и BI‑слоёв без постоянного обращения к удалённым хранилищам, что сокращает задержки и упрощает разработку прототипов.
- роль связующего звена между данными в data lake и аналитическими потребностями бизнес-подразделений. DuckDB может читать данные в формате Parquet/Arrow напрямую из дата‑лэйков и динамически преобразовывать их к нужной схеме для анализа, не копируя массивы данных в новый слой.
- поддержка гибкой архитектуры: как встроенный движок в приложениях, так и как серверный сервис, который может обслуживать единый аналитический контур компании. Это позволяет сочетать локальную аналитику с централизованной координацией и управлением ресурсами.
- возможность ускоренного прототипирования и обучения команд. Благодаря простоте развёртывания и совместимости с популярными языками (SQL, Python, R), DuckDB становится удобным инструментом для data science и аналитического моделирования, что снижает порог входа и ускоряет передачу знаний в организацию.
Понимание ограничений DuckDB и последовательная работа над архитектурными паттернами позволяют получить устойчивую ценность: снижение задержек на критичных этапах пайплайна, уменьшение объема перемещаемых данных и повышение скорости отклика аналитических сервисов. В этом контексте следует устанавливать принципы архитектурной совместимости: какой слой будет отвечать за обновления данных, какие данные будут кэшироваться, как синхронизируются схемы и как поддерживается единый контракт доступа к данным.
Архитектурные принципы и режимы развёртывания
DuckDB может работать в разных режимах развёртывания. В корпоративной среде эти режимы часто комбинируются для достижения баланса между автономией отдельных команд и централизованной управляемостью:
- встроенный движок в прикладных сервисах и BI‑клиентах. Такой режим минимизирует задержку данных и упрощает прототипирование. Он подходит для сценариев, где аналитика должна жить рядом с приложением или ноутбуком исследователя.
- серверный режим (DuckDB Server) для центрального доступа. Позволяет объединить множество клиентских источников под одним API, обеспечивая единый контракт доступа к данным и консистентные политики безопасности. Этот режим удобен в рамках аналитических контуруов, где требуется централизованный контроль над ресурсами и согласованность версий движка.
- интеграция с orchestration и пайплайнами. DuckDB может работать в рамках ETL/ELT‑потоков в контейнеризованных средах (Kubernetes, Docker) или через серверно‑ориентированную архитектуру, где он выполняет преобразования и агрегации данных на этапе подготовки к анализу.
- использование в data lake‑ориентированных сценариях. DuckDB читает Parquet/Arrow‑форматы напрямую, что снижает копирование данных и ускоряет аналитические задачи без изменения исходного хранилища.
- безопасная и управляемая эксплуатация. В корпоративной среде ключевыми являются парадигмы RBAC, аудит, шифрование и совместимость со стандартами корпоративного управления данными. DuckDB интегрируется с существующими каталогами данных и политиками доступа, что снижает риски несогласованности данных.
Интеграционные паттерны
Унификация доступа к данным и минимизация накладных расходов на копирование являются критическими факторами успешной интеграции DuckDB. В рамках data stack DuckDB может быть использован как:
- слой предиктивной аналитики в приложениях и сервисах. Использование локального анализа позволяет ускорить ответ пользователю и снизить нагрузку на центральный склад данных.
- трансформационный узел в ELT‑потоках. DuckDB может выполнять трансформации на лету, создавая готовые к анализу наборы данных и облегчая последующую загрузку в хранилища и BI‑слоя.
- слой подготовки данных для Data Science и ноутбуков. Быстрое извлечение и агрегации данных из разнообразных источников поддерживает сценарии исследования и обучения моделей.
- связующий компонент между data lake и warehouse. DuckDB может служить мостом: извлечение данных из lake, преобразование и агрегации перед загрузкой в warehouse или предоставление аналитикам «быстрого доступа» к необходимым поднаборам данных.
Для эффективной интеграции целесообразно определить следующие принципы:
- единый контракт доступа к данным. Определение общих форматов, схем и правил доступа, чтобы избежать дублирования логики и несогласованности в разных частях стеков.
- минимизация копирования и оптимизация I/O. Приоритет отдаётся операциям чтения Parquet/Arrow, что позволяет сэкономить сетевой трафик и ускорить анализ.
- понятные показатели производительности и мониторинга. Включение в архитектуру механизмов наблюдаемости и профилирования запросов DuckDB, чтобы своевременно выявлять узкие места.
- совместимость с существующими инструментами. DuckDB должен без проблем сосуществовать с существующими каталогами данных, инструментами контроля версий схем и процессами CI/CD.
Пример организационного взаимодействия
В рамках крупных компаний целесообразна распределенная роль DuckDB следующим образом:
- команда аналитики - использует встроенные возможности DuckDB для прототипирования и быстрого анализа данных на месте, в ноутбуках и приложениях.
- команда данных - обеспечивает совместимость схем, безопасность доступа и поддержку данных в lakehouse/warehouse, управляет каталогами и политиками.
- команда DevOps/DataOps - отвечает за развёртывание DuckDB в контейнерах, мониторинг, управление ресурсами и интеграцию с оркестраторами.
Такой подход позволяет сохранить гибкость на уровне неопределённых временных рамок и обеспечить устойчивость архитектуры.
Архитектурные варианты развёртывания и интеграции DuckDB
Развертывание DuckDB в корпоративной среде должно опираться на принципы повторной используемости и управляемости. Приведем основные варианты и их влияние на эксплуатацию.
- Встроенный движок в приложениях. Преимущества - минимальные задержки и простота внедрения. Этот режим особенно эффективен для аналитических функций в бизнес‑приложениях, персональных аналитических панелях и прототипировании. Ограничения - фрагментация логики аналитики и необходимость дублирования политик безопасности в разных местах.
- Серверный режим и централизованный доступ. Цель - централизовать ресурсы, обеспечить единый контроль над доступами, версионированием движка и мониторингом. Такой режим хорошо подходит для корпоративной аналитики и Data Science‑платформ, где необходимо единое окно доступа к данным и общие политики.
- Интеграция в облачные хранилища и data lake. DuckDB работает с Parquet и Arrow и может «загружать» данные напрямую из cloud‑хранилищ. Это позволяет избегать лишнего копирования и ускоряет аналитические задачи, особенно на гранулярном уровне агрегаций и отбора.
- Инструменты мониторинга и управления. В корпоративной среде важны совместимость и интеграция с существующими инструментами наблюдаемости и мониторинга: логирование, трассировка запросов, агрегированные показатели производительности и использования ресурсов.
- Конейнеризация и оркестрация. Развёртывание DuckDB в контейнерах или через Kubernetes обеспечивает изоляцию, масштабируемость и согласование версий. Это снижает риски завязки на отдельные окружения и упрощает управление изменениями.
Технические принципы поддержки эффективной интеграции
- совместимость форматов. Предпочтение Parquet/Arrow в качестве форматов ввода‑вывода; DuckDB поддерживает прямой доступ к этим форматам без промежуточного копирования.
- управление схемами и миграциями. Наличие единого источника правды о схемах позволяет избежать рассинхронизации между DuckDB‑инстансами и основными хранилищами данных.
- совместимость с безопасностью. Включение политик RBAC, аудитов и шифрования, встраиваемых в корпоративные процессы, обеспечивает соответствие регуляторным требованиям.
- контроль за ресурсами. Настройка ограничений CPU/memory и планов выполнения позволяет избегать перегрузок в общем кластере и обеспечивает предсказуемость.
Производительность, оптимизация и качество аналитики
Производительность аналитики в DuckDB достигается за счёт нескольких ключевых механизмов, связанных с архитектурой и алгоритмами обработки данных. В корпоративной среде важно не только понимать принципы, но и уметь их применять на практике.
- колоннарная обработка и векторизация. DuckDB проектируется вокруг эффективной обработки столбцов, что обеспечивает высокую пропускную способность для сквозной аналитики и оконных функций. Векторизация снижает стоимость операций над данными и ускоряет фильтрацию и агрегацию.
- раннее/позднее материализование и план запроса. Эффективная оптимизация запросов достигается за счёт анализа плана выполнения, упрощения операторов и выбора наилучших стратегий для конкретного набора данных. Применение explains и explain analyze помогает выявлять узкие места.
- фильтрация на уровне источников и predicate pushdown. Чем раньше выполняется фильтрация данных, тем меньше обрабатывается в последующих операциях. DuckDB поддерживает эффективное распознавание условий отбора и их применение на входе к источникам.
- управление и профилирование запросов. Встроенные средства объяснения и анализа запросов позволяют операционным командам и аналитикам оптимизировать пайплайны на ранних стадиях. В корпоративной практике это означает регулярные ревью профилей и внедрение стандартных паттернов для повторяемых задач.
- качественный контроль аналитики. Включение тестирования SQL‑пайплайнов, регрессионного тестирования и мониторинга изменений в схемах обеспечивает надёжность и предсказуемость аналитических результатов.
Практические подходы к оптимизации
- проектирование под сценарии. При проектировании QA‑пайплайнов важно учитывать частые запросы, которые формируют нагрузку, и оптимизировать их через структурирование данных, предикаты и агрегации.
- прототипирование и перенос в продакшн. DuckDB отлично подходит для быстрого прототипирования, после чего можно перенести логику в более устойчивые архитектурные узлы, обеспечив контроль изменений и совместимость.
- мониторинг производительности. Регулярный анализ времени выполнения, ресурсов и частоты выполнения запросов помогает оперативно выявлять узкие места и корректировать конфигурацию.
Интеграция и управление данными: безопасность, Governance и совместимость
Успешная интеграция DuckDB в корпоративную архитектуру требует соответствия корпоративным требованиям к безопасности, управлению данными и совместимости. В этом контексте DuckDB следует рассматривать как часть экосистемы, а не как автономный компонент.
- безопасность и доступ. Реализация RBAC и интеграции с существующими системами идентификации обеспечивает надёжность доступа к данным. В серверном режиме возможно централизованное управление политиками и аудитами.
- соответствие. Учитываются требования по сохранности данных, шифрованию на уровне хранения и виде аудита действий пользователей, что особенно важно в финансовых и регламентируемых секторах.
- каталогизация и совместимость. Интеграция с существующими каталогами данных и политиками версионирования схем обеспечивает единый источник правды и упрощает миграции.
- совместимость инструментов. DuckDB совместим с популярными инструментами аналитики и бизнес‑пользования: BI‑инструменты, ноутбуки, пайплайны данных, что снижает тормозящие факторы внедрения.
Управление изменениями и политика эксплуатации
- дорожная карта внедрения. Реализация проекта делится на пилоты, переход к локальным сервисам и затем к полномасштабному внедрению в рамках корпоративной архитектуры.
- обучение и трансформация команд. Внедрение DuckDB требует подготовки аналитиков, инженеров данных и DevOps к новым режимам работы, включая понимание особенностей оптимизации запросов и архитектурных паттернов.
- устойчивость и резервирование. Определение стратегий резервного копирования и восстановления, а также миграций между режимами (встроенный vs серверный) позволяет избежать простоев в работе аналитических сервисов.
Стратегии внедрения, управление изменениями и операционная практика
Эти практики формируют основу успешной реализации проекта по внедрению DuckDB в корпоративную архитектуру.
- пилотные проекты с конкретными KPI. В рамках пилота необходимо определить, какие сценарии принесут наибольшую ценность: сокращение задержек, ускорение анализа, снижение нагрузки на центральный склад.
- дорожная карта внедрения. Построение поэтапной стратегии помогает управлять рисками и ресурсами: от прототипирования до масштабирования. Включайте этапы тестирования совместимости, миграции и обучения.
- роль и ответственность. Назначение ответственных за архитектуру, безопасность и эксплуатацию DuckDB в рамках различных команд - аналитики, инженеры данных, DevOps.
- методики обучения. Включайте регулярные обучающие сессии, обмен практиками и документирование лучших практик, чтобы обеспечить единое понимание и единый подход к аналитике.
- управление изменениями. Используйте практики CI/CD для пайплайнов DuckDB, тестирование схем, автоматическое развёртывание и мониторинг изменений.
Key takeaways
- DuckDB предлагает гибкую архитектуру для ускорения SQL‑аналитики в рамках современных data stacks, сочетая встроенный и серверный режимы развёртывания.
- Архитектурный паттерн должен учитывать интеграцию с Parquet/Arrow‑форматами, Data Lake и централизованным управлением доступом, чтобы минимизировать копирование данных и повысить управляемость.
- Основные драйверы производительности - колоннарная обработка, векторизация и раннее применение фильтрации; регулярное профилирование запросов помогает управлять качеством аналитики.
- Безопасность и соответствие требуют единого контракта доступа, аудита и интеграции с каталогами данных и политиками управления данными.
- Эффективная стратегия внедрения включает пилоты, дорожную карту и развитие компетенций команд; важно сочетать техническую реализацию с организационными изменениями.
- DuckDB оптимален для прототипирования и локального анализа, а серверный режим обеспечивает централизованный контроль и устойчивость в корпоративной среде.
- Внедрение DuckDB должно быть тесно связано с существующими процессами DataOps и CI/CD, чтобы обеспечить повторяемость и предсказуемость результатов аналитики.
FAQ
- Что такое DuckDB и в каких сценариях он уместен в корпоративной архитектуре?
DuckDB - это аналитический движок, ориентированный на колоночную обработку и встроенное выполнение SQL‑запросов. Он уместен там, где требуется быстрый локальный анализ данных, прототипирование и обработка данных ближе к приложению или notebook‑оперированию, а также как легковесный серверный компонент для централизованной аналитики. В корпоративной архитектуре он действует как мост между данными в lakehouse/warehouse и аналитическими инструментами, снижая задержки и упрощая пайплайны без полной миграции всего объёма данных.
- Какие архитектурные режимы развёртывания DuckDB чаще всего применяются в организациях?
На практике применяют встроенный движок в приложениях и серверный режим для централизованного доступа. Встроенный режим подходит для прототипирования и локального анализа, серверный - для единичного окна к данным и координации политики доступа, мониторинга и управления ресурсами. Оба режима можно сочетать: прикладные сценарии используют встроенный движок, в то время как централизованный анализ обслуживают через DuckDB Server.
- Как DuckDB интегрируется в data lake и data warehouse, не создавая избыточных затрат на копирование данных?
DuckDB умеет напрямую считывать данные в формате Parquet/Arrow из data lake, что минимизирует копирование. При этом он может преобразовывать данные в нужные структуры и форматы для анализа, а затем отдавать результаты в BI‑слой или в warehouse. Это позволяет сохранить текущую инфраструктуру и снизить общую стоимость владения.
- Какие требования к безопасность и управляемость DuckDB в корпоративной среде?
В корпоративной среде DuckDB должен поддерживать политики RBAC, аудит действий пользователей, шифрование данных на уровне хранения и интеграцию с существующими каталогами данных. За счёт серверного режима можно централизовать контроль, журналирование и мониторинг, обеспечивая единый контракт доступа к данным и согласованность между различными командами.
- Какие подходы к оптимизации аналитических пайплайнов с помощью DuckDB наиболее эффективны?
Эффективные подходы включают раннюю фильтрацию данных, эффективное использование колоночной обработки и векторизации, анализ плана выполнения запросов с помощью EXPLAIN/EXPLAIN ANALYZE и повторяемое тестирование пайплайнов. Важно проектировать запросы под характер операций: фильтрацию, агрегацию и оконные функции, чтобы DuckDB мог максимально эффективно распараллеливать работу над колонками.
- Какой порядок действий рекомендуется для внедрения DuckDB в корпорацию?
Рекомендуется начать с пилотов на конкретных сценариях (прототипы, ускорение повторяющихся запросов, локальная аналитика в приложениях), затем перейти к единому серверному режиму для централизованного контроля и управления, и наконец масштабировать на другие подразделения. Важно сопровождать этапы обучением команд, настройкой политики безопасности и внедрением стандартов тестирования схем и пайплайнов.
- Какие примеры архитектурных паттернов применимы для интеграции DuckDB в существующий data stack?
Примеры паттернов включают: встроенная аналитика в приложении с использованием DuckDB как локального движка; центральный аналитический шлюз на DuckDB Server, обслуживающий разные источники и клиенты; слой подготовки данных в ELT‑пайплайне, где DuckDB выполняет трансформации перед загрузкой в warehouse; и прототипирование аналитических моделей в ноутбуках с возможностью экспортировать результаты в единый репозиторий.
- Какие ограничения DuckDB нужно учитывать на корпоративном масштабе?
В рамках крупных систем DuckDB может иметь ограничения по масштабируемости в сравнении с полноценно масштабируемыми хранилищами. При этом его преимущество - скорость разработки, гибкость и низкий порог входа. В крупных конфигурациях целесообразно комбинировать DuckDB с серверным режимом и централизованной координацией, чтобы сохранить предсказуемость и управляемость.
- Как оценивать ROI внедрения DuckDB?
ROI можно оценивать по сокращению задержек в аналитике, снижению объема копирования данных, уменьшению числа операций на централизованных хранилищах и ускорению прототипирования. Важно зафиксировать базовые показатели до внедрения и регулярно мониторить показатели после внедрения: время отклика, частоту повторного анализа, нагрузку на хранилище и скорость разработки новых пайплайнов.
- Какие инструменты и практики стоит сочетать с DuckDB для устойчивой аналитики?
В сочетании с DuckDB эффективны инструменты мониторинга производительности запросов, CI/CD для пайплайнов и миграций схем, а также каталоги данных и политики безопасности. В рамках практик DevOps/DataOps применяются тестирование SQL‑пайплайнов, управление версиями схем и автоматизированные проверки на совместимость между DuckDB и остальными компонентами data stack.


