

Создание витрины данных для телеком-оператора средствами Apache Airflow
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: NTA @NewTechAudit
В современном мире витрины данных становятся неотъемлемой частью любого бизнеса, так как позволяют прогнозировать будущие изменения. В данном посте рассмотрим процесс создания витрины данных для телеком‑оператора с использованием Apache Airflow.
Описание задачи
Передо мной стояла задача исследовать возможность автоматизации процесса анализа данных телеком оператора. Это необходимо для того, чтобы аналитикам было проще анализировать поведение клиентов, пользующихся продуктами телеком‑оператора, выявлять тенденции и определять, какие услуги и предложения наиболее востребованы.
Выбор инструмента
Для решения этой задачи я выбрала платформу Apache Airflow.
Apache Airflow — это система управления и автоматизации рабочих процессов, написана на языке Python и использует открытый исходный код.
Чем же хорош Apache Airflow? Основные плюсы этого инструмента приведу ниже:
- Гибкость: Airflow позволяет создавать рабочие процессы любой сложности, включая параллельные задачи и зависимости между ними.
- Масштабируемость: Платформа может обрабатывать огромное количество данных и выполнять множество задач одновременно.
- Интеграция с другими инструментами: Airflow может быть интегрирован с другими инструментами обработки и анализа данных, такими как Spark, Hadoop и т. д.
- Мониторинг и отчетность: Airflow предоставляет инструменты для мониторинга и отчетности о выполнении задач, что позволяет оперативно реагировать на возникающие проблемы.
Именно поэтому, я остановила выбор на этом инструменте. Apache Airflow поможет автоматизировать процесс анализа данных. Он позволит создавать рабочие процессы, которые будут автоматически обрабатывать данные и предоставлять результаты анализа. Это позволит аналитикам сосредоточиться на анализе данных, а не на выполнении рутинных операций.
Узнать более подробно о возможностях Apache Airflow, его основных сущностях и компонентах можно на официальном сайте (https://airflow.apache.org).
Итак, начнем воплощать идею в код.
Моделирование
Для реализации, описанной выше задачи, в первую очередь необходимо сгенерировать данные. Останавливаться на этом этапе подробно не буду, так как основной задачей в данном случае является обработка данных.
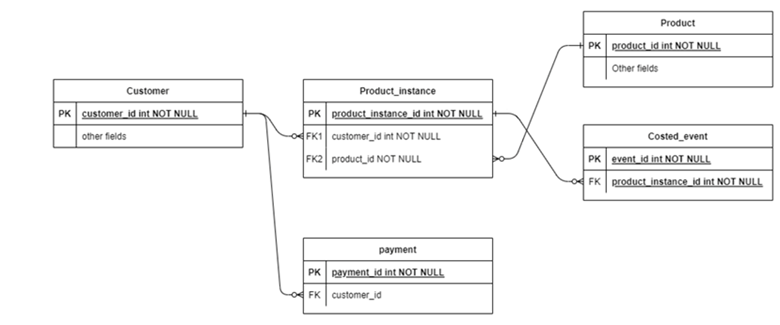
Для того чтобы сгенерированные данные были максимально схожи с реальными, я провела исследование телекоммуникационных услуг. В конечном итоге у меня получилось создать 5 таблиц:
- Customer — информация о клиентах, включающая: уникальный ID, имя и фамилия, дата рождения, пол, согласие на рекламные рассылки, номер банковской карты, email, номер телефона, статус (активный, то есть пользующийся услугами оператора или неактивный), категория (физическое или юридическое лицо), регион и некоторые дополнительные поля;
- Product — информация о доступных тарифах (ID, уникальное имя продукта, тип (тариф или дополнительная услуга), стоимость и объем подключенных услуг);
- Payment — информация об оплате телекоммуникационных услуг клиентами (уникальный идентификатор, id клиента, способ оплаты, дата совершения платежа, цена);
- Product_instance — информация о продуктах, которые были приобретены клиентами (id клиента, id продукта, дата активации, дата отключения, статус (активный, приостановлен, отключен));
- Costed_event — информация о всех операциях, совершенных клиентами (product_instance_id, дата совершения события, тип события (смс, звонок, интернет), количество потраченных минут, смс или Мб, вид звонка (входящий или исходящий) и номера телефонов (кто звонил и кому)).
Итоговая модель исходных данных представлена на рисунке.
Реализация
Основными сущностями в Apache Airflow являются DAGs (Directed Acyclic Graphs), задачи (tasks), и операторы (operators).
DAG — это способ визуализировать процесс обработки данных, который состоит из задач и операторов. Он представляет собой схему, на которой видно какие операции нужно провести, в каком порядке и какие зависимости между ними. Это полезно, потому что позволяет заранее обнаружить и исправить ошибки в логике процесса, а также понять, насколько он оптимален.
Поэтому следующим этапом в обработке данных является создание DAG. В первую очередь импортирую все необходимые библиотеки и модули:
from airflow import DAG
import pandas as pd
from airflow.hooks.base import BaseHook
from airflow.operators.dummy import DummyOperator
from airflow.operators.python import PythonOperator
from os import getenv
from sqlalchemy import create_engine
from datetime import datetime
from sqlalchemy.sql.ddl import CreateSchema
После этого объявлю DAG посредством указания необходимых параметров:
with DAG (
         dag_id="SIMPLE",
         description="Dag to transfer data from csv to postgres",
         schedule_interval="@hourly",
         default_args={'start_date': datetime(2020, 1, 1), 'depends_on_past': False},
         is_paused_upon_creation=True,
         max_active_runs=1,
         catchup=False
         ) as dag:

    # создаем задачи для определения порядка выполнения задач
    start_task = DummyOperator(task_id='START', dag=dag)
    end_task = DummyOperator(task_id='END', dag=dag)
Запуски DAG планируются в основном на основе двух параметров: schedule_interval (интервал запуска, по умолчанию один день) и start_date (первая дата, когда будет выполнен DAG). В моем случае DAG запускается ежечасно и находится в paused состоянии (не запускается автоматически при создании). Параметр depends_on_past, равный False, при запуске задним числом (backfill) дает запустить DAG вне зависимости от статуса предыдущего запуска. Параметр catchup — настройка, отвечающая за то, будет ли DAG наверстывать пропущенное выполнение. Данные параметры позволяют управлять поведением рабочего процесса и адаптировать его под конкретные требования.
После объявления DAG необходимо добавить задачи (tasks) и зависимости (dependencies) между ними. Задачи представляют собой отдельные операции, которые выполняются в рамках рабочего процесса, а зависимости определяют порядок выполнения этих операций. Это помогает организовать рабочий процесс и избежать ошибок.
В моем случае сначала создаются два DummyOperator (start_task и end_task), которые не выполняют никаких действий, а служат только для обозначения начала и конца рабочего процесса.
Далее добавляю PythonOperator и функцию load_csv_pandas для загрузки данных из CSV‑файлов в базу данных:
customer_table_name = "customer"
# создание задачи, которая будет выполняться в DAG
load_customer_raw_task = PythonOperator(
                            dag=dag,

                            # уникальный идентификатор задачи
                            task_id=f"{DAG_ID}.RAW.{customer_table_name}",

                            # функцию, которая будет вызываться в задаче
                            python_callable=load_csv_pandas,

                            # параметры для функции
                            op_kwargs = {
                                "table_name": customer_table_name,
                                "schema": "raw",
                                "conn_id": "raw_postgres"
                            }
                        )

# функция для загрузки данных из csv-файлов в базу данных Posgres
def load_csv_pandas(table_name: str, schema: str = "raw", conn_id: str = None) -> None:

    # создание объекта соединения с базой данных
    conn_object = BaseHook.get_connection(conn_id or DEFAULT_POSTGRES_CONN_ID)
    jdbc_url = f"postgresql://{conn_object.login}:{conn_object.password}@" \
               f"{conn_object.host}:{conn_object.port}/postgres"
    df = pd.read_csv(file_path)

    # создание движка базы данных
    engine = create_engine(jdbc_url)
    df.to_sql(table_name, engine, schema=schema, if_exists="append")
RAW — слой сырых данных, в котором хранятся данные различных форматов.
Функция load_csv_pandas загружает данные из CSV‑файла в таблицу PostgreSQL. Она принимает следующие параметры: название таблицы, название схемы базы данных (по умолчанию «raw») и идентификатор соединения с базой данных. Сначала функция создает объект соединения с базой данных (conn_object). Затем добавляется протокол передачи данных JDBC URL на основе логина, пароля, хоста и порта из объекта соединения. После чего создается объект движка базы данных (engine) на основе полученного JDBC URL.
После этого данные из датафрейма сохраняются в таблицу базы данных с указанным именем. Если такая таблица уже существует, ее содержимое дополняется новыми данными.
Далее аналогичным образом добавлю еще две задачи create_schema_raw и create_schema_datamart, которые создают схемы RAW и DATAMART:
create_schema_raw = PythonOperator(
                        dag=dag,

                        # уникальный идентификатор задачи
                        task_id=f"{DAG_ID}.RAW.CREATE_SCHEMA",

                        # функция, которая будет вызываться в задаче
                        python_callable=create_schema,

                        # параметры для функции
                        op_kwargs = {
                            "conn_id": "raw_postgres",
                            "schemaName": "raw"
                        }
                    )
create_schema_datamart = PythonOperator(dag=dag,
                            task_id=f"{DAG_ID}.DATAMART.CREATE_SCHEMA",
                            python_callable=create_schema,
                            op_kwargs={
                                "conn_id": "datamart_postgres",
                                "schemaName": "datamart"
                            }
                        )

# функция для создания схемы в базе данных Postgres
def create_schema(conn_id, schemaName):
    conn_object = BaseHook.get_connection(conn_id or DEFAULT_POSTGRES_CONN_ID)
    jdbc_url = f"postgresql://{conn_object.login}:{conn_object.password}@" \
               f"{conn_object.host}:{conn_object.port}/postgres"
    engine = create_engine(jdbc_url)
    if not engine.dialect.has_schema(engine, schemaName):
        engine.execute(CreateSchema(schemaName))
В функции create_schema создается объект подключения к базе данных conn_object, затем создается JDBC URL и движок базы данных engine. Если схемы schemaName не существует, выполняется SQL‑запрос для ее создания.
Схемы RAW и DATAMART добавляются в Airflow для разделения процессов загрузки и обработки данных. Схема RAW предназначена для загрузки данных из различных источников, таких как CSV‑файлы или базы данных, и подготовки их к обработке. Схема DATAMART используется для обработки загруженных данных и получения итоговых результатов.
Добавление этих схем позволяет организовать процесс обработки данных более эффективно и структурированно. Разделение задач на разные схемы позволяет упростить отладку и мониторинг, а также обеспечивает гибкость при изменении или добавлении новых задач.
Осталось добавить последнюю задачу customer_totals_datamart_task, которая необходима для создания витрины данных (datamart):
customer_totals_datamart_task = PythonOperator(
                                                       dag=dag,
                                                       task_id=f"{DAG_ID}.DATAMART.{datamart_table}",
                                                       python_callable=datamart_pandas,
                                                       op_kwargs = {
                                                           "table_name": datamart_table,
                                                           "schema": "datamart",
                                                           "conn_id": "datamart_postgres"
                                                       }
                                                   )

# функция для создания витрины данных datamart
def datamart_pandas(table_name: str, schema: str = "datamart", conn_id: str = None) -> None:
    conn_object = BaseHook.get_connection(conn_id or DEFAULT_POSTGRES_CONN_ID)
    jdbc_url = f"postgresql://{conn_object.login}:{conn_object.password}@" \
               f"{conn_object.host}:{conn_object.port}/{conn_object.schema}"
    engine = create_engine(jdbc_url)
    query = open(f"{AIRFLOW_HOME}/sql/datamart.sql", 'r')
    df = pd.read_sql_query(query.read(), engine)
    df.to_sql(table_name, engine, schema=schema, if_exists="append")
Функция datamart_pandas создает таблицу datamart, используя SQL‑запрос из файла datamart.sql (описание представлено ниже).
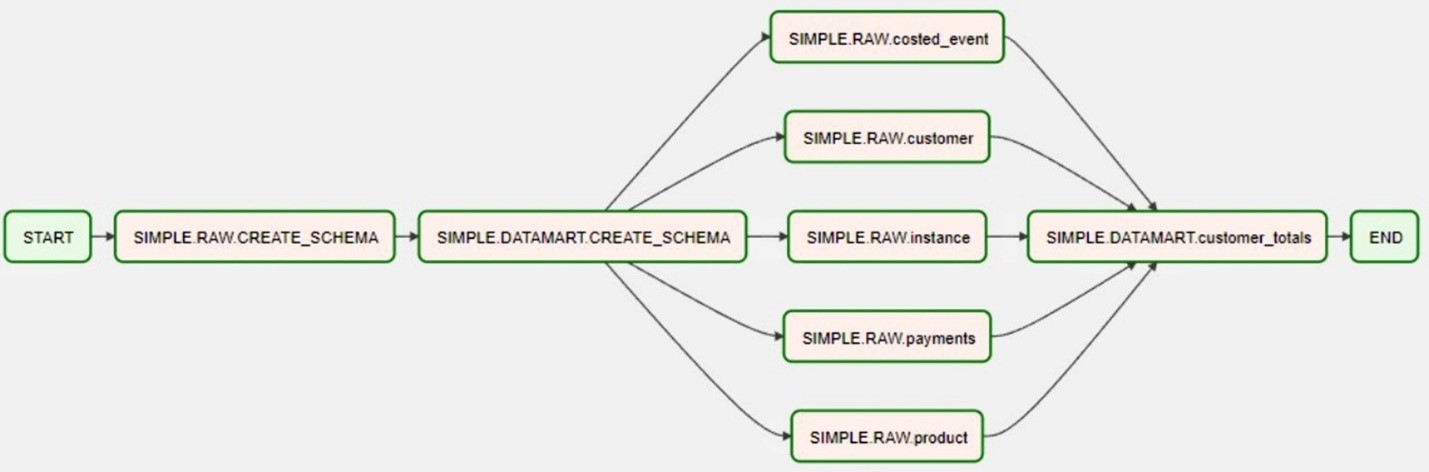
В конце необходимо задать последовательность выполнения операторов в DAG, то есть связать задачи между собой:
# определение порядка выполнения задач
start_task >>
create_schema_raw >>
create_schema_datamart >> [load_customer_raw_task,
                                               load_payments_raw_task,
                                               load_instance_raw_task,
                                               load_product_raw_task,
                                               load_costed_event_raw_task] >>
customer_totals_datamart_task >>
end_task
В итоге DAG для загрузки и агрегации данных выглядит следующим образом:
Теперь более подробно рассмотрю процесс создания витрины данных.
Создание витрины данных — это процесс сбора, очистки, анализа и визуализации данных с целью предоставления информации, которая может быть использована для принятия решений в бизнесе. Для телекома это означает возможность проанализировать поведение своих клиентов, выявить тенденции и определить, какие услуги и предложения наиболее востребованы.
Рассмотрю одну из возможностей применения методов анализа больших данных на примере повышения эффективности маркетинговых компаний. Анализ больших данных может помочь определить наиболее эффективные маркетинговые стратегии и каналы коммуникации с клиентами. Это позволит увеличить конверсию и снизить затраты на рекламу.
Создание витрины данных осуществлю по заказу от условных бизнес‑аналитиков. Необходимо выбрать целевую аудиторию для рекламных рассылок по следующим маркетинговым компаниям:
- смена тарифного плана на новый: «Всё включено»;
- продвижение тарифа для группы людей;
- предложение дополнительного пакета интернета (10 Гб).
Ограничения: рассылка производится только при наличии согласия клиента на участие в маркетинговых акциях. Статус клиента должен быть «активен».
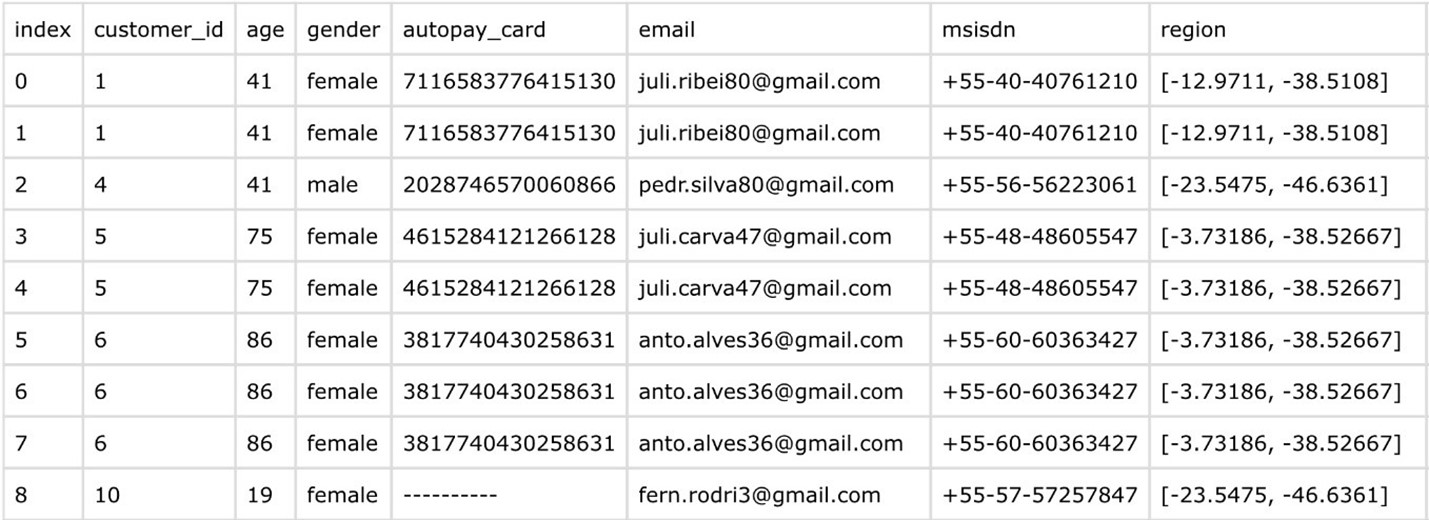
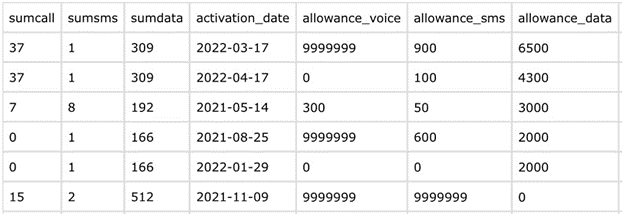
Для выполнения всех условий необходимо в итоговую витрину данных добавить следующую информацию: id клиента, его пол, возраст, номер банковской карты, email (для отправки рассылок с рекламными акциями), номер телефона, регион (для определения, какие услуги следует развивать или расширять в определенных регионах, а также для выявления зон с низкой активностью клиентов), дата активации тарифа, информация о расходованных минутах, смс и Мб, а также о тарифе, который приобрел данный клиент. А также добавлен фильтр, чтобы клиент был активным и давал согласие на рекламные рассылки.
SQL‑запрос будет выглядеть следующим образом (расположен в файле datamart.sql):
select distinct
    c.customer_id, -- id клиента
    c.gender, -- пол
    c.autopay_card, -- номер банковской карты
    c.email, -- адрес электронной почты
    c.msisdn, -- номер телефона
    c.region, -- регион
    i.activation_date, -- дата активации тарифа
    p2.allowance_voice, -- количество минут, включенных в тариф
    p2.allowance_sms, -- количество смс, включенных в тариф
    p2.allowance_data, -- количество Мб, включенных в тариф
    (select date_part('year',age(c.date_of_birth::date))) as age, -- возраст клиента
    (
                select sum(call_count)
                from raw.costed_event
                where
                    c.msisdn = raw.costed_event.calling_msisdn
                    and raw.costed_event.date::date >= date_trunc('day',current_timestamp - interval '1 month')
                    and raw.costed_event.date::date < date_trunc('day',current_timestamp)
    ) as sumcall, -- количество потраченных минут
    current_timestamp as execution_timestamp – текущая дата и время
from raw.customer as c
join raw.payments as p
    on c.customer_id = p.customer_id
join raw.instance as i
    on c.customer_id = i.customer_id
join raw.product as p2
    on i.product_id = p2.product_id
join raw.costed_event as c2
    on i.product_instance_id = c2.product_instance_id
where
    c.agree_for_promo = 'Yes' – согласие на рекламные рассылки
    and c.status = 'active' – статус клиента 'активный'
    and customer_category = 'phyzical' -- продвижение тарифа для группы людей 'физические лица'
    and i.status = 'active' – статус тарифа 'активный'
order by c.customer_id
Структура витрины данных представлена ниже:
Уже на основе сгенерированных и обработанных данных создам dashboard, который представлен ниже:
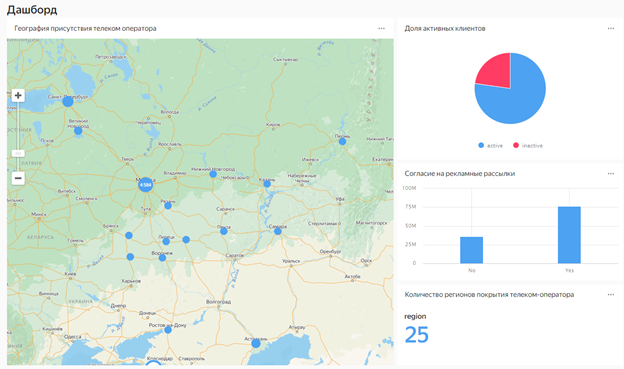
На дашборде видно долю активных клиентов (пользующихся услугами телеком‑оператора), долю клиентов, согласившихся на рекламные рассылки, географию присутствия телеком оператора, а также количество клиентов в каждом регионе.
Заключение
В этом посте я описала базовые возможности Apache Airflow и показала, как использовать его для автоматизации процесса анализа данных. Благодаря этому инструменту, телеком‑операторы могут оптимизировать свою работу, улучшить качество услуг и увеличить прибыль.
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: NTA @NewTechAudit


