

Введение в Apache Doris: цели, область применения и базовая терминология
Apache Doris представляет собой масштабируемую аналитическую OLAP-платформу, ориентированную на быстрый анализ больших объемов данных. Архитектура Doris сочетает in-memory и-ориентированное хранение, параллельное выполнение запросов и эффективную интеграцию с экосистемой бизнес-аналитики. В рамках данной главы рассмотрены цели проекта, области применения и базовая терминология, необходимая для грамотной постановки задач, проектирования схемы и эксплуатации кластера Doris в условиях промышленной архитектуры данных.
Doris эволюционировал как решение для интерактивной аналитики, где важна предсказуемость задержек, горизонтальное масштабирование и простота эксплуатации. Он поддерживает соединение через MySQL-подобный протокол, что упрощает интеграцию с популярными BI-инструментами и моделирование данных в формате звезды/снежинки. В контексте корпоративной цифровой трансформации Doris выступает как часть стека аналитических платформ, ориентированной на отчеты, дэшборды и оперативную аналитику над историческими и реальными данными.
Ключевые вопросы, которые освещаются в главе:
- как устроена архитектура Doris и какие компоненты отвечают за метаданные, хранение и исполнение запросов;
- какие задачи решаются Doris в контексте OLAP и как выбираются подходы к моделированию данных;
- какие терминологии применимы к кластеру Doris, таблицам и процессам загрузки данных;
- какие практики эксплуатации, мониторинга и масштабирования применимы на практике.
Краткое содержание главы
- Архитектура Doris: FE и BE, взаимодействие и режимы исполнения.
- Область применения и сценарии аналитики: типы нагрузок, требования к задержке и масштабируемости.
- Базовая терминология: cluster, tablet, partition, rowset, MV и другие ключевые понятия.
- Интеграция, развёртывание и базовые паттерны эксплуатации кластера.
- Производительность, оптимизация и управление ресурсами в Doris.
- Мониторинг, устойчивость и операционные практики: метрики, алерты, резервное копирование и обновления.
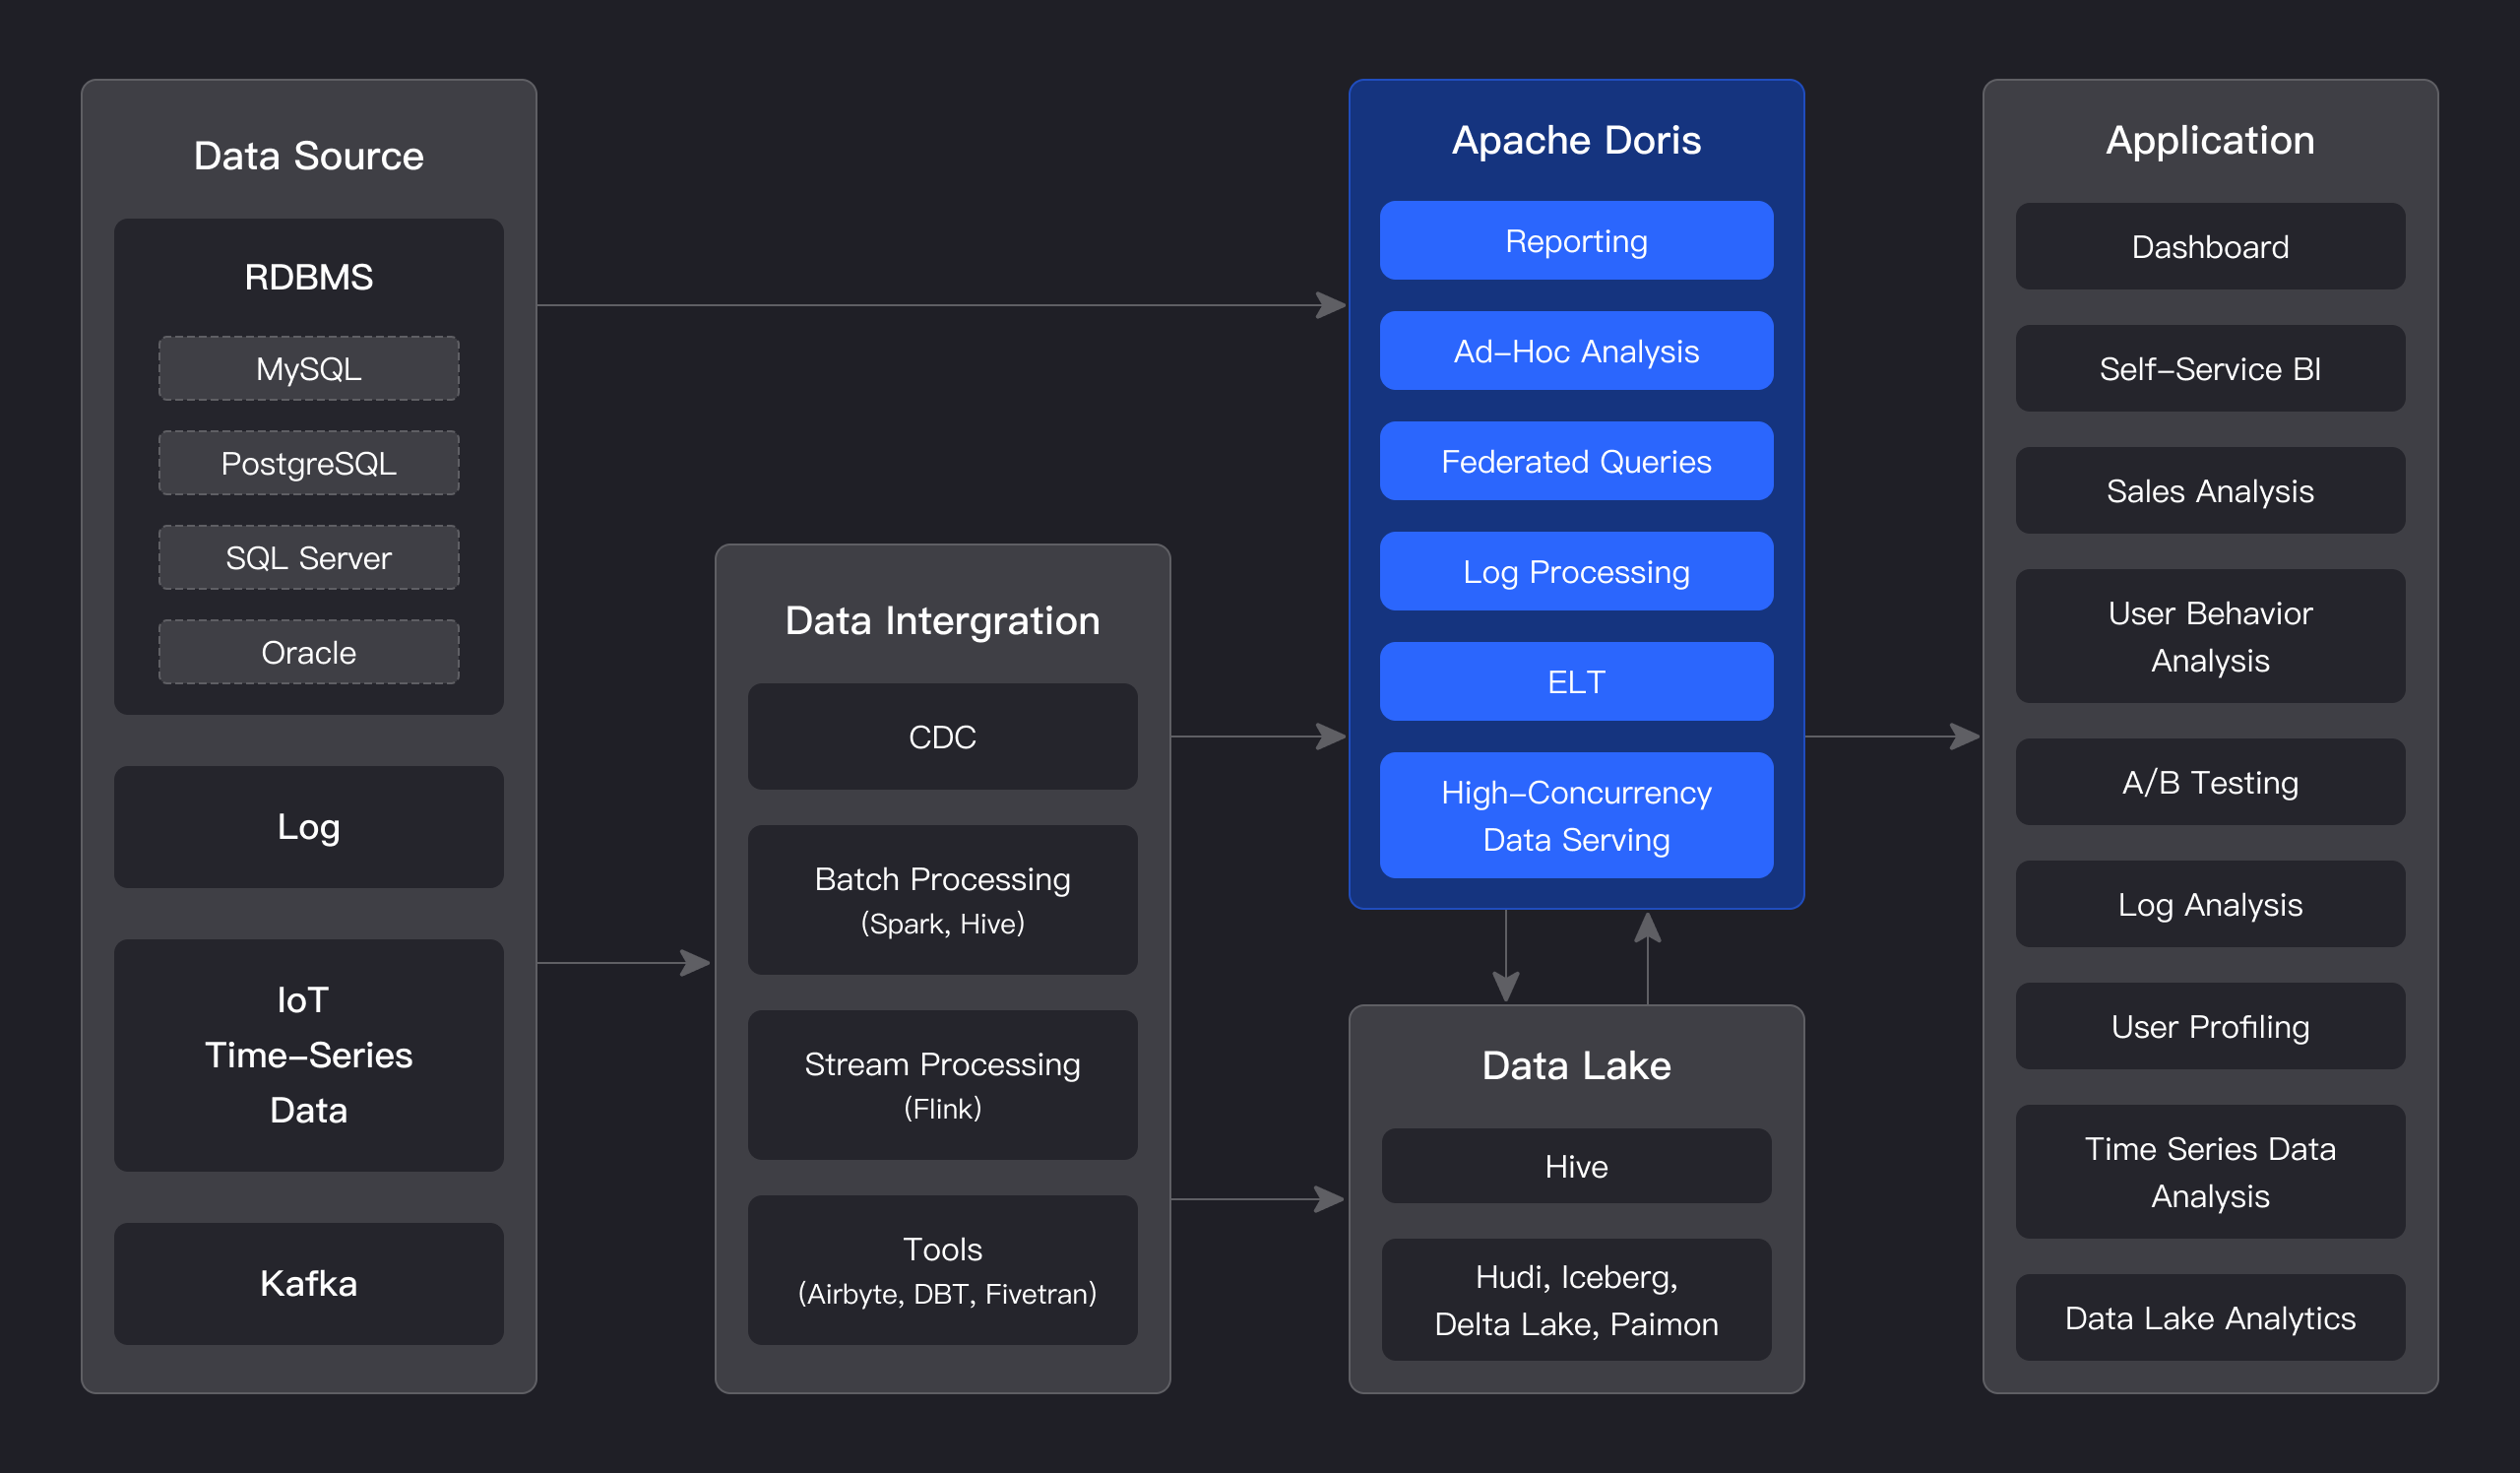
Архитектура Doris: FE и BE, механизмы планирования и выполнения
Архитектура Apache Doris строится вокруг двух основных типов сервисов: Frontend (FE) и Backend (BE). FE отвечает за метаданные, анализ и оптимизацию запросов, планирование выполнения и управление каталогом объектов - базами данных, таблицами, разделами и привязками пользователей. BE обеспечивает хранение данных и вычислительную мощность для выполнения планов запросов на уровне распределённых узлов. В рамках данного раздела раскрываются принципы взаимодействия компонентов и их роль в обеспечении производительности аналитических рабочих нагрузок.
FE выступает как точка входа клиентов, собирать SQL-запросы, кэшировать статистику и предоставлять глобальное представление о кластере. В реальном времени FE формирует распределённый план выполнения запроса, учитывая доступность узлов BE, данные на них и текущую загрузку. План разбивается на фрагменты, которые затем отправляются в BE для параллельного выполнения. Такой подход обеспечивает горизонтальное масштабирование и способность достигабельной пропускной способности при росте объёмов данных и числа пользователей.
BE отвечает за чтение данных с дисков, применение фильтров, агрегацию, джоины и прочую вычислительную логику. Данные Doris хранятся в колоночной форме и разделены на сегменты и tablet-единицы, которые распределяются по BE-нодам. Это распределение поддерживает параллелизм выполнения и позволяет реализовать гибкую балансировку нагрузки. Важной характеристикой является способность BE выполнять операции над данными локально на ноде, минимизируя передачи по сети и уменьшая задержки.
Коммуникация между FE и BE осуществляется по определённым протоколам и контрактам. Клиентские приложения подключаются к FE через совместимый протокол, аналогичный MySQL, что упрощает интеграцию с существующими инструментами BI и SQL-аналитики. FE отправляет клиенту план выполнения и прогон запроса на уровне параллельной обработки, BE координирует распараллеливание задач по узлам кластера, осуществляет сканирование данных, фильтрацию и агрегацию. Важную роль играет механизм распределённой координации, который обеспечивает согласованность метаданных, согласование схемы и устранение конфликтов между параллельными операциями.
Особенности реализации и алгоритмы, влияющие на производительность Doris:
- колоночное хранение и векторизованное выполнение: ускорение операций агрегации и сканирования больших наборов данных;
- распределённая архитектура и балансовая стратегия: обеспечение равномерной загрузки и отказоустойчивости;
- оптимизация планирования: применение фильтров на ранних этапах (predicate pushdown), пропуск диапазона (partition pruning) и статистического отбора;
- работа с метаданными: кэширование статистики и схем, поддержка версии таблиц и Rollup-объектов;
- загрузка данных: поддержка различных каналов загрузки (Broker Load, Stream Load) и конвейеров данных, интеграция с внешними хранилищами (HDFS, S3, локальные файловые системы) через брокеры;
- MV и Rollups: предвычисляемые представления и агрегаты для ускорения частых запросов.
Дизайн Doris ориентирован на взаимодействие между удобством эксплуатации и эффективной производительностью. Архитектура FE/BE позволяет разделять задачи управления метаданными и физическим исполнением запросов, что особенно важно в средах с множеством пользователей и постоянной загрузкой данных.
Взаимосвязь компонентов и жизненный цикл запроса
Происходит последовательность шагов: клиент инициирует соединение к FE, FE парсит SQL, строит план, применяет оптимизации и формулирует распределённый план исполнения. Затем BE выбираются для выполнения фрагментов плана, данные сканируются, фильтры применяются, а результаты агрегации собираются и возвращаются FE, который координирует окончательный набор результатов к клиенту. При этом Doris применяет параллелизм на уровне узлов BE и на уровне внутри узла, что позволяет обрабатывать крупные срезы данных по нескольким векторам параллельных потоков.
Не менее важной является система метаданных. FE хранит каталог объектов, версии схем, привязки пользователей и политики доступа. Изменения в схеме таблиц или данные обновляются через атомарные операции, что обеспечивает консистентность во всем кластере. В высоконагруженной системе реализованы механизмы отката и повторного выполнения, чтобы обеспечить устойчивость к сбоям и сетевым задержкам.
Область применения и сценарии аналитики
Doris оптимизирован под OLAP-аналитику, где необходимо выполнять агрегации, группировки и фильтрацию по большим наборам данных в интерактивном режиме. Наборы сценариев варьируются от классических бизнес-анализов до сложной аналитики поведения пользователей и финансовой аналитики. Основные рабочие сценарии включают:
- дэшборды и интерактивные отчеты: быстрые агрегации по ключевым метрикам, фильтрация по временным диапазонам и демографическим признакам;
- анализ временных рядов: скользящие агрегации, разрезы по датам и сравнения периодов;
- аналитика по звездной схеме: поддержки типовых запросов с большими факт-таблицами и небольшими справочными измерениями;
- гибридная аналитика: объединение исторических и поступающих данных для сравнения и обнаружения трендов;
- подготовка данных для машинного обучения: извлечение агрегатов и материалов для последующей обработки в обучающих пайплайнах.
Ключевым преимуществом Doris является способность обеспечивать низкую задержку при обработке больших объемов данных в реальном времени за счет параллельной обработки и эффективного сканирования. Благодаря поддержке гибких схем и механизмов материализованных представлений, Doris может существенно уменьшать вычислительную стоимость повторяющихся запросов, что важно для организаций с регулярными бизнес-аналитическими потребностями.
Рассматриваемые сценарии внедрения предполагают тесную интеграцию с BI-инструментами и данными из различных хранилищ. Doris, как часть стек аналитики, может стать центральной точкой для хранения и обработки агрегатов, позволяя сохранить консистентность данных между источниками и упрощая доступ к ним для дэшбордов и аналитических подсчетов. В контексте цифровой трансформации Doris способствует ускорению принятия решений за счет снижения задержек на этапах подготовки и анализа данных.
Базовая терминология и концепции Doris
Эта секция Introduces ключевые понятия, которые будут использоваться в последующих главах и обучающих материалах. Знание базовой терминологии обеспечивает единый язык между аналитиками, инженерами по данным и администраторами кластера.
- кластер (cluster): совокупность узлов FE и BE, объединённых единым каталогом и политиками доступа. В рамках кластера распределяются данные и вычислительная нагрузка.
- Frontend (FE): сервис управления метаданными, планирования и каталога объектов; отвечает за разбор SQL, формирование планов и координацию между нодами BE.
- Backend (BE): сервисы исполнения и хранения данных; выполняют сканирование, фильтрацию, агрегацию и другие операции на уровне физического хранения.
- tablet: единица хранения данных в Doris, соответствующая части таблицы на конкретном BE-ноду. Таблеты являются основными фрагментами, по которым осуществляется параллельное выполнение запросов.
- partition: раздел таблицы, обеспечивающий управление данными по диапазонам значений (например, по дате) или по хэш-распределению. Разделение улучшает локализацию I/O и ускоряет пр проблемные запросы.
- rowset: набор строк внутри tablet, который может быть представлен одним или несколькими файловыми сегментами на диске. Rowset служит единицей загрузки, обновления и компакции.
- columnar storage: принцип хранения данных по столбцам, обеспечивающий эффективную компрессию и ускорение сканирования при аналитических запросах.
- vectorized execution: исполнение запросов с использованием векторной обработки данных, что повышает пропускную способность при агрегациях и сканировании.
- materialized view (MV): предвычисленное представление, используемое для ускорения повторяющихся запросов за счёт сохранения заранее рассчитанных результатов.
- rollup: дополнительные агрегаты или частично предварительно рассчитанные данные, создаваемые для ускорения конкретных запросов.
- load job: процесс загрузки данных в Doris. Включает разные режимы, такие как Broker Load и Stream Load, для интеграции с внешними источниками данных.
- replication factor: количество копий данных, размещённых на разных BE-узлах, обеспечивающее отказоустойчивость и доступность кластера.
- catalog: центральный реестр метаданных кластера, позволяющий FE и BE согласованно работать с базами данных, таблицами, разделами и правами доступа.
- query execution plan: план выполнения запроса, который FE формирует на основе статистики и правил оптимизации, распределяя работу по BE-узлам.
- metadata consistency: согласованность метаданных между FE и BE, обеспечиваемая транзакционными операциями и координацией изменений.
- Broker Load / Stream Load: механизмы загрузки данных из внешних источников в Doris; Broker Load работает через файловые хранилища, Stream Load - через потоковую передачу данных.
Интеграция, развёртывание и базовые паттерны эксплуатации кластера
Успешная интеграция Doris в инфраструктуру требует внимательного проектирования кластера, распределения ресурсов и определения политики безопасности. Основные аспекты включают выбор архитектуры узлов, настройку пулов ресурсов, стратегий репликации и планирования обновлений. Важно заранее определить требования к задержке, объёмам данных и скорости загрузки, чтобы подобрать подходящую конфигурацию для FE и BE.
С точки зрения эксплуатации Doris следует рассматривать как систему с несколькими слоями ответственности: управление схемой и пользователями, контроль качества данных и обеспечение доступности. В процессе развёртывания полезно определить следующие шаги:
- дизайн схемы таблиц и распределение данных: выбор ключевых полей для хеш-распределения и схема разделения по диапазону; избегать скопления данных в одном сегменте, чтобы предотвратить перегрузку отдельных BE-узлов;
- настройка политик доступа и аутентификации: принципы минимальных привилегий и аудит действий пользователей;
- конфигурация ресурсов и приоритетов: выделение пулов памяти, CPU, сетевых ресурсов на FE и BE; настройка лимитов параллелизма;
- загрузка данных: выбор между Broker Load и Stream Load в зависимости от сценария (периодическая загрузка vs потоковая подача данных); обеспечение согласованности данных и обработку ошибок загрузки;
- обеспечение устойчивости: резервное копирование и восстановление, процедуры обновления без простоя, стратегии обработки сбоев;
- мониторинг и алертинг: настройки мониторинга метрик, интеграция с Prometheus и Grafana, определение порогов для алертов.
Опыт внедрения Doris особенно полезен в случаях, когда существует необходимость среднесрочного и долгосрочного масштаба: добавление новых узлов BE для увеличения пропускной способности, добавление FE для повышения доступности каталога и уменьшения задержек при планировании. Важно помнить, что расширение кластера требует пересмотра распределения данных и метрик, чтобы сохранить баланс между вычислениями и чтением данных. Правильное использование материалов типа MV и Rollup может существенно снизить стоимость выполнения часто возникающих запросов и обеспечить более предсказуемые времена ответа.
Производительность и оптимизация: принципы и практики
Производительность Doris в значительной степени зависит от качества планирования запросов, структуры данных и стратегий загрузки. Основные принципы оптимизации включают:
- архитектура и хранение: колоночное хранение и векторизованное выполнение позволяют быстро сканировать и аггрегировать столбцы, что особенно эффективно для запросов с агрегациями и фильтрами по нескольким столбцам;
- распределение данных: грамотное распределение по HASH/Buckets и по Partition-политикам позволяет снизить перегрузку отдельных BE-узлов и повысить параллелизм;
- раннее применение фильтров: predicate pushdown и partition pruning помогают отсеять несущественные данные на ранних стадиях выполнения, уменьшая объем сканирования;
- статистика и витрины данных: сбор и использование статистики по столбцам (cardinality, distinct values, histogram) позволяют оптимизатору принимать более выгодные планы;
- MV и Rollup: использование предвычисленных результатов и агрегатов для ускорения частых запросов, особенно в сценариях с большим количеством точечных выборок и группировок;
- настройка параллелизма и памяти: оптимальное значение параллелизма и контроль потребления памяти на FE и BE важны для предотвращения перегрузки и нехватки ресурсов во время пиковых нагрузок;
- индикаторы производительности: CTR, количество прочитанных строк, время сканирования и задержки на этапах планирования и исполнения - эти метрики сообщают о проблемах в конкретной части конвейера и позволяют быстро реагировать.
Производительность Doris напрямую зависит от грамотного моделирования данных и выбора подходящих механизмов ускорения. В частности, применение MV и Rollup требует баланса между временем загрузки данных, стоимостью их поддержания и выгодой от ускорения реальных запросов. Не менее важны контроль качества данных, оптимизация схем и профилактические мероприятия по поддержке кластера в актуальном состоянии: обновления, модернизации и тестирование новых паттернов эксплуатации.
Мониторинг, устойчивость и операционные практики
Надёжность и предсказуемость Doris во многом зависят от эффективного мониторинга и оперативных процедур. Ключевые направления включают:
- метрики и наблюдаемость: систематический сбор метрик по FE и BE (latency, throughput, scanned rows, I/O] с использованием Prometheus и визуализация в Grafana); мониторинг состояния узлов, загрузки дисков и сети;
- алертинг: настройка порогов по задержкам выполнения, количеству отклонённых загрузок и статусам репликации, чтобы своевременно реагировать на сбои;
- устойчивость к сбоям: наличие резервирования узлов BE, автоматическое переключение на доступные копии и повторные попытки выполнения операций;
- обновления и миграции: планирование безостановочных обновлений кластера, тестирование изменений в стейдж-окружении и детальное планирование откатов;
- резервное копирование и восстановление: регулярное создание снимков метаданных и данных, процедуры восстановления в случае потери узлов или дисков;
- безопасность и аудит: управление доступом, журнал аудита и соответствие требованиям корпоративных политик.
Эти практики обеспечивают непрерывность бизнеса и минимизацию риска потери данных при изменениях архитектуры кластера, а также позволяют поддерживать высокий уровень обслуживания пользователей. В сочетании с грамотной политикой мониторинга Doris становится надёжной базой для аналитических процессов и принятия управленческих решений.
Key takeaways
- Doris разделяет архитектуру на Frontend и Backend, что обеспечивает разделение ответственности за метаданные и выполнение запросов.
- Колоночное хранение, векторизованное исполнение и параллелизм на уровне tablet-единиц позволяют достигать высокой пропускной способности при аналитических запросах.
- Планирование запросов в Doris использует раннее применение фильтров и разделение по Partition, что ускоряет выполнение и снижает объём сканируемых данных.
- Поддержка MV и Rollup позволяет ускорять частые запросы без изменения источников данных и бизнес-логики.
- Интеграцию Doris в BI-стек обеспечивает совместимый протокол подключения (MySQL-подобный), а также поддержка загрузок через Broker Load и Stream Load.
- Грамотная настройка кластера, мониторинг метрик и устойчивость к сбоям являются критическими для устойчивой эксплуатации в продакшн-среде.
- Проекты по цифровой трансформации выигрывают за счёт снижения задержек аналитики и повышения предсказуемости результатов благодаря Doris.
FAQ
- Что такое Doris и чем он отличается от обычной базы данных?
- Doris - это масштабируемая аналитическая OLAP-платформа, ориентированная на низкие задержки и высокую пропускную способность при больших объемах данных. Она сочетает колоночное хранение, векторизированное исполнение и параллельную обработку данных. Отличие от транзакционных БД - фокус на аналитике, оптимизация под агрегации и фильтрацию по столбцам, а не на точной поддержке транзакций в режиме ACID для частых операций записи.
- Какие роли выполняют FE и BE в Doris?
- FE отвечает за метаданные, анализ и планирование запросов, каталог объектов и управление пользователями. BE обеспечивает хранение данных и вычисления - выполнение сканирования, джоинов и агрегаций на уровне распределённых узлов. Взаимодействие FE и BE обеспечивает горизонтальное масштабирование и устойчивость к сбоям.
- Как Doris выгодно использовать для интерактивной аналитики?
- Doris оптимизирован для быстрых агрегаций по большим наборам данных и поддержки интерактивной аналитики через параллельное выполнение и эффективное сканирование столбцов. Поддержка MV и Rollup позволяет заранее готовить результаты для типовых запросов, снижая время отклика и вычислительную стоимость.
- Какие типы нагрузки Doris наилучшим образом поддерживает?
- Doris хорошо подходит для звездной/снежинокидной схемы, агрегаций по нескольким измерениям, фильтраций по дате и другим признакам, а также для умеренно высокой частоты обновления данных через потоковую загрузку. Для реального времени Doris поддерживает механизмы потоковой загрузки данных и быстрое обновление агрегатов.
- Какие типовые паттерны моделирования данных подходят в Doris?
- Часто встречаются схемы звездной или снежинки с колоннарной структурой и распределением по HASH или PARTITION по дате. Важного значения достигают стратегия партиционирования и порядок столбцов, который влияет на эффективность сканирования и фильтрации.
- Как загружать данные в Doris и какие режимы существуют?
- Doris поддерживает Broker Load для загрузки из внешних источников (HDFS, S3 и т.п.) и Stream Load для потоковой загрузки данных. В зависимости от требований к задержке загрузки и консистентности можно выбрать подходящий режим и настраивать логику обработки ошибок и повторных попыток.
- Какие метрики и инструменты нужны для мониторинга Doris?
- Важны latency и throughput запросов, объем прочитанных строк, скорость сканирования, загрузка CPU и памяти на FE/BE, а также состояние репликации и доступности узлов. Для мониторинга часто применяют Prometheus для сбора метрик и Grafana для визуализации и алертинга.
- Какие шаги необходимы для безопасного и устойчивого развертывания кластера Doris?
- Планирование архитектуры (FE/BE, числа узлов, балансировка), настройка политик доступа и аудита, определение порогов алертов, обеспечение резервного копирования и восстановления, а также проведение тестов обновления в стейдж-окружении перед миграцией в продакшн.
- Какие ограничения и риски следует учитывать?
- Ограничения зависят от объема данных, требований к задержке и доступности. В некоторых сценариях, особенно при очень больших объемах обновлений в реальном времени, важно внимательно управлять нагрузкой на сеть и память, правильно настраивать партиционирование и MV-структуры.
- Как планировать миграцию данных в Doris или переход на Doris как часть существующей инфраструктуры?
- Требуется определить новую модель данных, схему и миграционные стратегии (переходные режимы, параллельная миграция, сохранение целостности источников). Проводится поэтапный тестовый запуск, затем масштабируемое развёртывание и мониторинг в продакшн-среде с минимальным влиянием на пользователей.
Глубокое понимание архитектуры Doris, связок FE и BE, базовой терминологии и принципов эксплуатации позволяет проектировать и внедрять решения, которые обеспечивают предсказуемую производительность аналитики на масштабах всей организации. Выбор стратегий загрузки данных, оптимизация планирования и эффективные паттерны мониторинга - ключевые элементы успешной реализации Doris в реальных условиях.


