

Модель выполнения Spark: DAG, стадии, задачи и планировщик
Spark реализует вычисления как ленивые преобразования над данными, которые формируют граф зависимостей (DAG). Этот граф превращается в план выполнения на кластере, где узлы графа разбиваются на стадии и задачи, распределяемые между ресурсами кластера. Понимание того, как формируется DAG, как образуются стадии и задачи, и как работает планировщик, критично для эффективной эксплуатации Spark-платформы: от оптимизации производительности до диагностирования сбоев и настройки ресурсов. Глава позволяет переходить от концепций к практике, показывая механизмы, протоколы и точки интеграции со службами управления ресурсами и мониторинга.
Spark оперирует на нескольких уровнях абстракции: логический план, физический план и граф исполнения. Логический план формируется на уровне DataFrame/DataSet или RDD и отражает операторы трансформации. Логический план оптимизируется Catalyst (для DataFrame/DataSet), после чего формируется физический план, включающий конкретные операции и порядок их исполнения. В дальнейшем физический план конвертируется в DAG, где узлы соответствуют стадиям, а ребра - зависимости между ними, включая shuffle-операции, требующие перераспределения данных между узлами кластера. Именно на этом этапе активируются механизмы DAGScheduler и TaskScheduler: первый отвечает за разбиение DAG на стадии и планирование их исполнения, второй - за распределение задач по executors и мониторинг выполнения.
Краткое содержание главы
- Концептуальная рамка исполнения Spark: ленивые вычисления, DAG, стадии и задачи, роль планировщика и shuffle-операций.
- Архитектура DAG и физический план: как логический план превращается в DAG, различия между узлами исполнения и данными зависимостями, роль Catalyst и shuffle.
- Разделение на стадии и задачи: границы между этапами, механика распределения задач и обработка ошибок.
- Планирование ресурсов и распределение задач: взаимодействие с менеджером ресурсов, параметры параллелизма, динамическое масштабирование и локальность данных.
- Мониторинг и диагностика исполнения: Spark UI, метрики, журналы событий и методы устранения узких мест.
- Практические выводы и принципы устойчивой эксплуатации Spark-платформ.
Концептуальная рамка: DAG, ленивые вычисления и трансформации
Основу модели выполнения Spark составляют ленивые вычисления и граф зависимостей. Трансформации, применяемые к данным, не выполняются немедленно; они строят DAG из операций и данных, которые будут обработаны только при вызове действия (collect, count, saveAsTable и т. п.). Такой дизайн позволяет Spark оптимизировать план исполнения, повторно использовать промежуточные результаты и сводить к минимуму лишних вычислений.
DAG в Spark охватывает зависимости между частями данных и операциями над ними. Для RDD это явные зависимости между РЕДами, а для DataFrame/DataSet - опора на логический план и Catalyst-оптимизации. Важными элементами DAG являются типы зависимостей: узкие (Narrow) и Shuffle-зависимости (Wide). Узкие зависимости означают, что данные читаются напрямую из соседнего раздела, без перераспределения. Shuffle-зависимости требуют перераспределения данных между узлами, что неизбежно приводит к разделению графа на более мелкие части - стадии.
Промежуточные результаты, записанные на диске или в памяти, обеспечивают устойчивость к сбоям: если узел падает, Spark может переиспользовать DAG и заново выполнить недостающие части. В контексте производительности критическую роль играет shuffle: объем и характер shuffle-операций определяют размер и число стадий и влияют на требования к сети, памяти и диску. Применение таких концепций как сортировка и хеш-распределение данных внутри shuffle-операций диктует выбор конкретных стратегий перераспределения и структур хранения.
На практике DAG - это мост между логическим и физическим планом. Логический план отражает намерения пользователя и трансформации, физический план - конкретные физические операции, которые система планирует выполнить. Преобразование логического плана в DAG включает в себя выбор стратегий распараллеливания и границы между стадиями, возникающие в результате перераспределения данных (shuffle). В этом переходном процессе DAGScheduler играет центральную роль: он анализирует зависимости и строит граф стадий, обеспечивая корректное упорядочение задач и обработку неидеальных случаев, таких как сбои узлов или задержки в сети.
Ключевые принципы:
- ленивые вычисления дают возможность оптимизации и повторного использования вычисляемых данных;
- DAG предоставляет абстракцию для планирования зависимостей и перераспределений;
- shuffle-операции становятся точками разрыва между стадиями и определяют требуемые ресурсы и время выполнения.
Узкие и широкие зависимости как мотор планирования
Узкие зависимости позволяют конвейерной обработке идти без перераспределения. В таких случаях стадии могут содержать длинные конвейеры трансформаций, где часть вычислений выполняется в рамках той же задачи без передачи данных через shuffle. Широкие зависимости возникают, когда данные должны быть перераспределены по ключам (например, после groupByKey, join с repartition). Это приводит к завершению текущей стадии и запуску следующей после переполнения сетевых каналов и промежуточного хранения.
Важно: граница стадии чаще всего совпадает с точкой shuffle, когда результат одной стадии становится входом для другой. Поэтому понимание схемы зависимостей и характера операций в рамках каждой стадии напрямую влияет на настройку параметров параллелизма, памяти и стратегии буферизации данных.
Архитектура и протоколы: DAGScheduler и TaskScheduler
DAGScheduler отвечает за анализ DAG, создание стадий и планирование их выполнения. Он принимает на вход граф зависимостей и управляет зависимостями между стадиями, включая обработку сбоев, повторное выполнение и управление зависимостями типа ShuffleMapStage и ShuffleDependency. После формирования графа стадий DAGScheduler координирует работу TaskScheduler, который непосредственно распределяет задачи по executors в кластере. TaskScheduler обращается к Cluster Manager (YARN, Kubernetes, Standalone) для выделения ресурсов и запуска задач на соответствующих узлах.
Такой разделение обязанностей обеспечивает модульность и устойчивость: DAGScheduler держит в фокусе корректность плана и зависимостей, тогда как TaskScheduler фокусируется на исполнении и управлении ресурсами. Взаимодействие между ними реализуется через сообщения и очереди задач, статус задач и события завершения, что позволяет Spark гибко адаптироваться к изменяющимся условиям кластера.
Общие принципы реализации:
- DAG строится на основе зависимостей между RDD/DataFrame-операциями;
- стадии формируются на границах shuffle;
- каждый этап состоит из множества задач, исполняемых параллельно на partition-уровне;
- сбои приводят к повторному вычислению недостающих частей DAG;
- механизмы мониторинга и логирования позволяют отследить прогресс и узкие места.
Архитектура DAG и физический план
Переход от логического плана к физическому плану включает выбор стратегий оптимизации и конкретных реализаций операций. Для DataFrame/DataSet критически важна Catalyst-оптимизация, которая преобразует логический план в эффективный физический план, минимизирующий стоимость вычислений и объем данных, передаваемых через shuffle. Физический план затем конвертируется в граф исполнения, где вершины - стадии, а ребра - зависимости.
Логический план содержит операции преобразования данных, возможно, со статистикой и предположениями об уникальности ключей. Физический план выбирает конкретные реализации операций: например, выбор между сортировочным или хешируемым способом выполнения join, порядок применения фильтров и проекции, стратегий сортировки. В контексте DAG и shuffle-операций выбор стратегии влияет на размер shuffle-данных и распределение нагрузки между узлами кластера.
Разделение на стадии зависит от зависимости между операциями. Если операция потенциально приводит к перераспределению (shuffle), Spark должен создать новую стадию, чтобы данные могли быть перераспределены безопасно и независимо от предыдущих этапов. Таким образом, структура DAG и число стадий отражают характер перераспределения и организации вычислений.
Внедрение DAG в реальное выполнение требует учета таких факторов:
- локальность данных: Spark может пытаться располагать задачи ближе к данным, чтобы минимизировать сетевые переносы;
- свойства операций: узкие зависимости позволяют длительные конвейеры внутри одной стадии, в то время как широкие зависимости требуют синхронизации через shuffle;
- ресурсы: размер и конфигурация executors, объем доступной памяти и дискового пространства влияют на время выполнения и устойчивость к сбоям.
Несколько практических аспектов:
- Shuffle-операции являются узким местом и часто служат индикатором необходимости перераспределения партиций и изменения параметров;
- выбор численности и размера партиций (partitions) влияет на эффективность снабжения узлова заданной нагрузкой;
- конфигурации Spark, управляющие параллелизмом и разделением задач, определяют показатели времени выполнения и нагрузку на сеть.
Разделение на стадии и задачи: механика исполнения
Разделение DAG на стадии основывается на зависимости между операциями и наличии shuffle. ShuffleMapStage формирует промежуточные результаты, которые должны быть перераспределены для последующих операций, и отправляет данные на shuffle-буферы. ShuffleDependency связывает входные и выходные данные между стадиями, обеспечивая корректность данных после перераспределения. В рамках каждой стадии Spark создает набор задач (TaskSet), где каждая задача обрабатывает определенную партицию входного набора данных.
Каждая задача выполняется на Executor и имеет характерный набор локальных ресурсов: память, CPU-ядра и локальные буферы. Число задач в стадии равно числу партиций входного набора. Высокое число задач может привести к значительным накладным расходам на координацию, но с другой стороны, слишком крупные задачи уменьшают степень параллелизма. Поэтому баланс между количеством партиций и размером задач - одна из ключевых задач операционного tweаking.
Выполнение задач осуществляется в рамках TaskScheduler. В случае сбоя задача пересобирается и повторно выполняется. Spark поддерживает различные стратегии повторного выполнения и обработки неустойчивых узлов. В контексте производительности значимые параметры включают:
- режим повторного выполнения (retry attempts) и пороговое число попыток;
- локальность исполнения (locality levels) и ожидания данных;
- использование Speculative Execution для "догоняющих" задач, чтобы минимизировать влияние неравномерной загрузки;
- сериализация и кернелы памяти: эффективная сериализация reducing overhead и уменьшение столкновений памяти.
Разделение на стадии чаще всего приводит к следующей структуре:
- ShuffleMapStage: вычисление и сохранение промежуточных данных перед перераспределением.
- ShuffleDependency: обмен данными между стадиями.
- ResultStage: финальная стадия, где данные собираются для вывода (collect, write, save и т. п.).
Эта архитектура обеспечивает практически линейное масштабирование при росте объема данных и числе узлов кластера, при условии аккуратной настройки параллелизма, размера партиций и характеристик shuffled данных. В реальных задачах критически важно следить за распределением времени между стадиями и задержками на shuffle-узлах, поскольку именно здесь чаще всего возникают точки перегрузки.
Планирование ресурсов и распределение задач
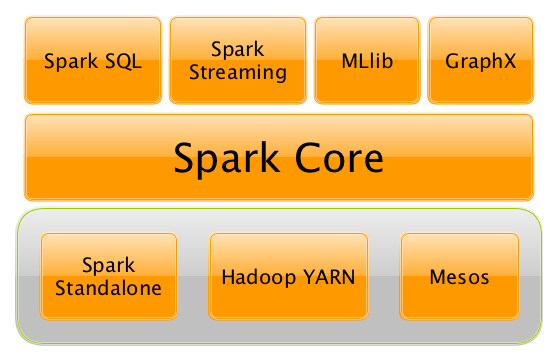
Эффективное выполнение Spark-тасков требует корректной настройки параметров планирования и взаимодействия с менеджером ресурсов. Основной механизм здесь - согласование между DAGScheduler и TaskScheduler и умение согласовывать запросы на исполнение с возможностями кластера (YARN, Kubernetes, Standalone).
Ключевые аспекты планирования и распределения задач:
- параллелизм и базовый уровень: число доступных ядер во всём кластере задаёт базовую меру параллелизма. Значение spark.default.parallelism должно соответствовать ожиданиям по workloads и архитектуре кластера.
- динамическое масштабирование: Dynamic Allocation позволяет увеличивать или уменьшать число executors в зависимости от загрузки, что влияет на задержки и стоимость исполнения.
- локальность данных: Spark может пытаться располагать задачи ближе к данным (data locality). Параметры локальности (например, spark.locality.wait) управляют «порогами» ожидания ближайших нод и балансом между задержкой и локальностью.
- ресурсные ограничения executors: размер памяти и число ядер на executor определяют, сколько задач может выполняться параллельно на конкретном узле; чрезмерная нагрузка может приводить к частым сборкам мусора и задержкам.
- управление памятью: memory fractions (spark.memory.*, spark.memory.storageFraction) и стратегия spill-to-disk влияют на стабильность в памяти при работе с большими данными.
- управление Shuffle: количество партиций (spark.sql.shuffle.partitions) влияет на количество задач и нагрузку на сеть; увеличение количества партиций может снизить узкие места, но возрастает overhead координации.
Интеграции с кластерными менеджерами важны для корректного планирования. Например:
- YARN или Kubernetes управляют выделением ресурсов и изоляцией между приложениями;
- Standalone кластер предоставляет базовую инфраструктуру планирования и мониторинга;
- современные кластеры поддерживают локальные политики планирования и кооперативное использование ресурсов между задачами разных приложений.
Гибкость настройки достигается за счет набора конфигурационных параметров и практик:
- устанавливать разумный базовый параллелизм, соответствующий размеру кластера;
- включать динамическое масштабирование там, где есть вариативная нагрузка;
- настраивать локальность и ожидания данных в зависимости от того, как данные хранятся и перемещаются в системе хранения;
- использовать оптимизированные форматы хранения и эффективные стратегии сериализации, чтобы уменьшить нагрузку на сеть и память.
Особое внимание следует уделить параметрам, влияющим на планирование в реальном времени: баланс между скоростью выполнения и потреблением ресурсов, адаптация к меняющейся нагрузке и минимизация времени простоя из-за перегруженности узлов. Важной задачей администратора является поддержание стабильности исполнения и обеспечение высокой предсказуемости времени выполнения задач в рамках доступных бюджетов ресурсов.
Мониторинг, диагностика и эксплуатация DAG
Эффективная эксплуатация Spark требует систематического мониторинга исполнения DAG и задач. Основной источник информации - Spark UI, где можно увидеть:
- общее состояние работы Jobs, Stages и Tasks;
- распределение времени по стадиям, задержки на shuffle и время выполнения;
- детали по каждой задаче, включая количество обработанных партиций и статистику памяти;
- эффективность shuffle-операций: объем прочитанных и записанных данных, количество задач, время ожидания и задержки.
Дополнительно важны журналы событий и история исполнения. SparkEventLog обеспечивает трассировку событий выполнения, а History Server позволяет анализировать прошлые запуски и сравнивать их между собой. Метрики можно экспортировать в внешние системы мониторинга (Prometheus, Grafana и т.п.), что особенно полезно для кластерных сред и крупных проектов.
В практике диагностика чаще всего начинается с проверки следующих аспектов:
- неравномерная загрузка по узлам: наличие straggler-подзадач или неравномерное распределение задач между executors;
- избыточное использование памяти и сборки мусора: частые GC-циклы свидетельствуют о неустойчивой памяти;
- перераспределение данных через shuffle: большие shuffle-объемы и высокий коэффициент перераспределения сигнализируют о неэффективной архитектуре планирования;
- задержки и простои на уровне сетевых операций: задержки сети или перегрузка сети приводят к задержкам в shuffle;
- проблемы повторной попытки: понижение эффективности из-за повторных попыток задач или падение узлов.
Для снижения риска и повышения устойчивости рекомендуется:
- внимательно подбирать число партиций и размер задач;
- включать динамическое масштабирование и следить за статусом executors;
- оптимизировать формат данных и схему хранения;
- настраивать параметры локальности и ожидания данных в зависимости от среды выполнения;
- регулярно использовать исторический анализ для выявления изменений в производительности и причин сбоев.
Практические сценарии: как это применяется на практике
- Приложение обработки больших логов: логический план складывается из множественных фильтров и агрегаций, затем формируютсяShuffle-зависимости перед агрегациями по временным окнам. В таком сценарии критично настроить разумный параллелизм и параметры shuffle, чтобы снизить объем данных, проходящих через сеть.
- Объединение несколько источников данных: join-операции приводят к широким зависимостям и перескоку на новые стадии. Эффективность зависит от выбора стратегии join и распределения данных по ключам, что требует внимательного тестирования на небольших тестах и последующей адаптации.
- Потоковая обработка и микро-батчи: DAG должен эффективно поддерживать быстрый выпуск результатов и минимальные задержки. В этом случае важны баланс между временем выполнения и ресурсами, а также настройка локальности и параметров планирования.
- Интеграция с Kubernetes: планирование задач и распределение ресурсов должны учитывать особенности окружения и возможности горизонтального масштабирования. Динамическая адаптация числа executors и ограничение потребления памяти помогают поддерживать стабильность в условиях переменной нагрузки.
Key takeaways
- Spark строит вычисления как DAG, где стадии возникают на границах shuffle и на основе зависимостей между операциями.
- DAGScheduler и TaskScheduler работают последовательно: первый проектирует граф стадий, второй распределяет задачи по executors и управляет ресурсами.
- Разделение на стадии и количество задач напрямую зависят от разреза shuffle-зависимостей и числа партиций; балансирование этих факторов критично для производительности.
- Планирование ресурсов включает параллелизм, динамическое масштабирование, локальность данных и управление памятью; корректная настройка параметров существенно влияет на время выполнения и устойчивость.
- Мониторинг исполнения DAG через Spark UI и журналы событий позволяет диагностировать узкие места и отклонения от ожидаемого поведения.
- Практические оптимизации включают настройку shuffle-партиций, локальности, использования памяти и режимов повторной попытки задач.
- Глубокое понимание DAG и планирования обеспечивает более эффективную диагностику, настройку и эксплуатацию Spark-платформ в условиях реальных нагрузок.
FAQ
- Что такое DAG в контексте Spark и чем он отличается от физического плана?
DAG - это граф зависимостей между операциями обработки данных, созданный на этапе планирования. Он определяет порядок выполнения и перераспределение данных между операциями. Физический план - конкретная реализация операций и их порядок на уровне исполнения, который Spark выбирает на основе оптимизации. Разница в том, что DAG фокусируется на структурной зависимости и границах стадий, а физический план учитывает конкретные реализации и выбор операций на уровне выполнения.
- Что вызывает создание новой стадии и как это влияет на планирование?
Новая стадия создается при наличии shuffle-зависимости между операциями. Это происходит, когда данные должны быть перераспределены по ключам или по условиям объединения. Появление новой стадии означает новую точку синхронизации, перераспределения и новый набор задач, что влияет на время ожидания, сетевые ресурсы и общий параллелизм выполнения.
- Как планировщик распределяет задачи по executors и какие параметры этому мешают или помогают?
TaskScheduler получает набор задач и распределяет их по executors, учитывая доступные ресурсы и локальность данных. Параметры, влияющие на это, включают spark.executor.cores, spark.executor.memory, spark.dynamicAllocation.enabled, spark.sql.shuffle.partitions и локальность (spark.locality.wait). Правильная настройка снижает задержки, уменьшает перегрузку на узлах и обеспечивает равномерную загрузку.
- Как управлять локальностью данных и почему она важна?
Локальность данных минимизирует сетевые переноса и ускоряет выполнение. Spark пытается запускать задачи ближе к данным (data locality). Важно настраивать параметры ожидания локальности и планирования так, чтобы балансировать между задержкой на поиск близких данных и временем ожидания задач в очереди.
- Что такое shuffle и почему он считается узким местом?
Shuffle - это операция перераспределения данных между узлами по ключам. Она требует записи промежуточных данных на диск или память, передачи их по сети и повторной загрузки, что может стать узким местом в производительности. Эффективность shuffle зависит от числа партиций, объема данных и конфигурации памяти.
- Какие параметры планирования чаще всего требуют адаптации под реальные нагрузки?
Чаще всего это spark.default.parallelism, spark.sql.shuffle.partitions, spark.dynamicAllocation.enabled, spark.memory.fraction и локальность (spark.locality.wait). Их настройка влияет на параллелизм, распределение задач, потребление памяти и устойчивость к сбоям.
- Как мониторы и журналы помогают в диагностике DAG и исполнения?
Spark UI предоставляет обзор по задачам, стадиям, Shuffle-операциям, задержкам и ресурсам. Журналы событий и History Server позволяют анализировать прошлые запуски, сравнивать конфигурации и выявлять повторяющиеся проблемы. Метрики экспорта в Prometheus/Grafana облегчают долгосрочный мониторинг.
- Какие типичные проблемы возникают при эксплуатации DAG и как их решать?
Типичные проблемы включают неравномерную загрузку узлов, чрезмерное количество shuffle-операций, частые перерасходы памяти и задержки из-за большого количества партиций. Решения включают перераспределение партиций, настройку параметров памяти и параллелизма, включение динамического масштабирования и оптимизацию планирования на этапе выбора физических операторов.
- В чем роль Catalyst и как она влияет на DAG в Spark DataFrame?
Catalyst отвечает за оптимизацию логического плана DataFrame/DataSet и выбор эффективного физического плана. Это влияет на структуру DAG за счет того, какие операции и как будут конструироваться, включая порядок фильтров, проекций и выбор стратегий join. Эффективная оптимизация снижает объем shuffle и время выполнения, что напрямую влияет на распределение задач и их исполнение.
- Какие практики можно перенять для эксплуатации Spark-платформ в продакшене?
Рекомендуются: проводить тестирование на небольших данных для выбора оптимальных параметров, использовать динамическое масштабирование и мониторинг, регулярно анализировать Spark UI и логи, настраивать shuffle-партиции в зависимости от объема данных и характера workloads, оптимизировать формат хранения и настройки памяти, поддерживать документацию по конфигурациям и процедурам восстановления после сбоев.


