

Управление сегментами и масштабирование: добавление/удаление сегментов, зеркалирование, rebalance
В этой главе рассматриваются ключевые механизмы управления сегментами в Greenplum: архитектура кластера, процессы добавления и удаления сегментов и зеркалирования, а также принципы балансировки данных (rebalance) после изменений конфигурации. Рассматриваются как теоретические основы, так и практические подходы к реализации без простоумного простого повторения инструкций. В конце - сценарии внедрения и контроль качества на этапах масштабирования аналитических систем.
- Презентация архитектурных принципов работы с сегментами и зеркалами: как данные распределяются, какие метаданные задействованы и как поддерживается консистентность в кластере.
- Этапы и риски расширения и снижения размера кластера: подготовка, изменение конфигурации, валидация и обратная совместимость.
- Механизмы зеркалирования и отказоустойчивости: роль зеркальных сегментов, поток WAL-логов и согласованность данных.
- Алгоритмы и практики балансировки (rebalance): когда и зачем нужен ребаланс, какие затраты несет операция и как минимизировать влияние на запросы.
- Рекомендации по мониторингу, тестированию и управлению изменениями.
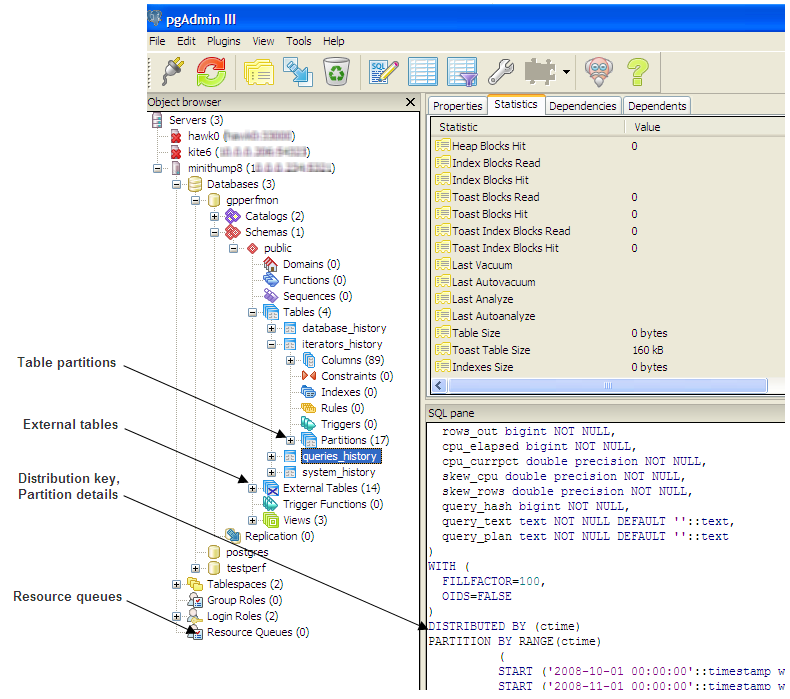
Архитектура и принципы управления сегментами
Greenplum представляет кластер, в котором мастер-узел (master) координирует выполнение запросов, а набор сегментов (primary и mirror) отвечает за хранение и обработку данных. Основная концепция - разделение данных на сегменты, распределение по серверам и зеркалирование для обеспечения отказоустойчивости. Каждая пара первичного сегмента и зеркала относится к конкретной content-единице (content id) кластерной топологии. При выполнении запросов планировщик распределяет операции по сегментам, а результаты аккумулируются на мастере.
-
Распределение данных: данные внутри таблиц попадают на сегменты согласно распределению по ключу (DISTRIBUTED BY). Это определяет, как строки будут размещаться между сегментами и как будет происходить агрегация на уровне кластера.
-
Хранение и зеркалирование: каждому первичному сегменту сопоставлено зеркало. Зеркальные сегменты дублируют записи и принимают WAL-лог-изменения, обеспечивая устойчивость к сбоям. В обычной работе квантовые операции чтения и записи совершаются через диспетчер и сегменты.
-
Метаданные и мониторинг: состояние сегментов хранится в системной таблице gp_segment_configuration и других глобальных реестрах. Координация изменений выполняется через инструменты управления этапами развертывания и поддержания целостности кластера.
-
Сложности баланса: из-за изменяющихся нагрузок и емкости узлов, распределение по сегментам может стать неравномерным. В таких случаях требуется перебалансировка (rebalance) для перераспределения данных и поддержания равномерной загрузки.
-- Пример запроса к системной таблице для проверки конфигурации сегментов SELECT content AS segment_id, role AS segment_role, status, hostname, port, databaseid FROM gp_segment_configuration ORDER BY content; -
Взаимодействие с инструментами управления: основной пакет действий по расширению и балансировке выполняется через инструмент gpexpand и сопутствующие утилиты. Эти инструменты читают текущую конфигурацию, взаимодействуют с настройками и обновляют метаданные кластера.
Добавление и удаление сегментов: процесс, задачи и риски
Расширение и сокращение числа сегментов является критическим изменением топологии кластера. Такие операции требуют тщательного планирования, чтобы минимизировать влияние на производительность и обеспечить корректную перераспределение данных.
-
Принципы планирования: прежде чем добавлять новые сегменты, необходимо оценить емкость узлов, требования к диску, сетевую пропускную способность и влияние на текущие операции. Важна проверка согласованности времени на серверах, совместимости версий ПО и общей политики отказоустойчивости.
-
Подготовка к изменениям: создаются новые сегменты на целевых хостах (или выделяются ресурсы на существующих узлах), настраиваются зеркала и согласовывается новая конфигурация кластера. В этот этап входят обновления в hostfile/ topology и корректировки параметров конфигурации.
-
Сам процесс добавления: расширение кластера обычно выполняется через инструмент gpexpand (или сопутствующие команды в зависимости от версии). Он автоматически добавляет новые сегменты и зеркала, перераспределяет часть данных и обновляет метаданные. В процессе могут временно увеличиться задержки и нагрузка на сеть.
-
Удаление сегментов: удаление обычно сопровождается переводом сегментов в режим обслуживания, перераспределением данных и удалением ненужных сегментов и зеркал. Важна тщательная валидация целостности данных и корректности восстановления после снятия сегментов.
-
Влияние на доступность: в зависимости от текущего баланса и размера данных, операции могут потребовать кратковременной блокировки некоторых процессов. Планирование меньших окон обслуживания и выполнение изменений поэтапно помогают снизить риск.
-
Риски и меры: риск потери данных минимизируется за счет зеркалирования и корректной синхронизации WAL-логов. Важно иметь резервные копии и план отката. Проверки на каждом этапе: консистентность каталогов, валидность распределения и корректность выполнения запросов после изменений.
-
Пример последовательности действий (обобщенный сценарий, без привязки к конкретным флагам):
- Проверить текущее состояние кластера и доступность зеркал.
- Подготовить новые узлы/ресурсы и убедиться в их соответствие требованиям.
- Запустить процесс расширения через инструмент управления (gpexpand).
- Выполнить валидацию: проверить gp_segment_configuration, запустить тестовые запросы и нагрузочные тесты.
- При необходимости выполнить перебалансировку данных.
-- Пример базовых SQL-запросов для проверки после изменений
SELECT content, role, preferred_role, status
FROM gp_segment_configuration
ORDER BY content;

-- Проверка доступности сегментов
SELECT gp_id, instance_port, role FROM gp_segment_configuration WHERE status = 'd';
-
Балансировка после расширения или сокращения: данные должны перераспределиться так, чтобы загрузка сегментов стала более равномерной. Это достигается за счет перераспределения блоков данных и перенаправления нового ввода на обновленный набор сегментов.
Подготовка и валидные сценарии удаления
- Версии и совместимость: при удалении сегментов особенно важно убедиться, что зеркала работают корректно и не падают в несогласованности с мастером.
- Контроль над дисковым пространством: удаление не должно привести к нехватке места на оставшихся узлах; мониторинг емкости обязателен.
- Пошаговый сценарий: перенести части данных на другие сегменты, отключить удаляемые сегменты, проверить целостность, затем удалить конфигурацию и узлы.
Зеркалирование: роль, принципы и эксплуатация
Зеркальные сегменты обеспечивают отказоустойчивость и защиту данных. В концепции Greenplum каждый первичный сегмент имеет соответствующее зеркало. Основные аспекты:
-
Роль зеркал: зеркало принимает копии WAL-логов и поддерживает синхронизацию данных с первичным сегментом. В случае сбоя первичного сегмента зеркало позволяет продолжить обработку без потери данных.
-
Синхронизация и задержки: режимы синхронизации варьируются по настройкам, но в стандартной конфигурации стремятся к минимальной задержке между изменениями на первичном сегменте и его зеркале.
-
Влияние на производительность: зеркалирование влечет за собой дополнительную нагрузку на запись, что следует учитывать при планировании емкости и пропускной способности сети.
-
Проверка консистентности: регулярные проверки на соответствие данных между парой первичный/зеркало помогают своевременно обнаружить отставания или несоответствия.
-
Рекомендации по их поддержке:
- Регулярно контролируйте статус зеркал через gp_state/ gp_segment_configuration и мониторинг пула.
- Обеспечьте достаточный запас вычислительных и сетевых ресурсов для WAL-логов.
- Настройте автоматические сигналы аварий к администратору и процедуры отката.
Механизмы балансировки данных: rebalance
rebalance - это процесс перераспределения данных между сегментами после изменений в топологии кластера. Он обеспечивает равномерное использование дискового пространства и вычислительных мощностей, что важно для поддержания производительности в условиях растущей или сокращающейся емкости. Основные моменты:
- Когда выполнять rebalance: после добавления или удаления сегментов, изменения в конфигурации узлов, значительного перераспределения нагрузки или при росте фрагментов таблиц.
- Как работает rebalance: инструмент оценивает текущую загрузку и емкости сегментов, затем инициирует перераспределение данных. В процессе возможно частичное временное замедление запросов, но цель - минимизировать общее время выполнения операции.
- Влияние на производительность: rebalance** - ресурсоемкий процесс, который может затронуть длительные аналитические запросы. Рекомендуется планировать такие операции на окна низкой активности или параллельно с агрегированными задачами.
- Практические рекомендации: заранее оценить желаемый баланс по ключевым параметрам (емкость, IO, задержки сети), ограничить влияние на критичные процессы и после завершения проверить консистентность данных.
Принципы реализации rebalance
- Планирование: вычислить целевые распределения для сегментов, определить минимально необходимое количество перемещений данных и принять решение о порядке перемещения.
- Безопасность данных: сохранить консистентность на каждом шаге и иметь точку отката.
- Валидация: после rebalance обязательно проверить корректность распределения и доступность запросов на новых сегментах.
Мониторинг, валидация и эксплуатационные практики
Эффективное администрирование требует постоянного мониторинга состояния кластера, своевременной валидации изменений и документирования процессов. Ключевые элементы:
- Мониторинг состояния сегментов: следить за статусами, задержками репликации, загрузкой CPU, IO и свободным пространством.
- Мониторинг производительности запросов: анализ планов выполнения, распределение нагрузки, задержки в обмене данными между сегментами.
- Контроль целостности: регулярные проверки gp_segment_configuration и соответствующих журналов, анализ WAL-логов и трассировку ошибок.
- Тестирование после изменений: запуск тестовых нагрузок, проверка консистентности и устойчивости к сбоим.
- Документация изменений: ведение журнала операций по добавлению/удалению сегментов и rebalance, фиксация параметров и сценариев восстановления.
Практические сценарии внедрения
- Масштабирование с нуля: при создании нового кластера сначала определяются требования к нагрузке, затем выбираются хосты, создаются сегменты и зеркала, настраиваются параметры сети и дискового пространства. После этого выполняется первый больших объем данных и валидируются показатели производительности.
- Поэтапное расширение: добавляются узлы порциями, а затем выполняется rebalance для перераспределения данных. Такой подход снижает риск перегрузки и упрощает мониторинг.
- Удаление узлов: задача состоит в безопасном переносе данных на оставшиеся сегменты, подтверждении консистентности, затем удаление конфигурации и освобождение ресурсов. После каждого этапа выполняются проверки с целью предотвращения потери данных.
Key takeaways
- Архитектура Greenplum обеспечивает отказоустойчивость за счет парSegment- mirroring и централизованного диспетчера запросов.
- Добавление и удаление сегментов требует тщательного планирования, подготовки ресурсов и безопасной перераспределения данных.
- Зеркалирование обеспечивает устойчивость к сбоям, но увеличивает требования к дисковому Space и сетевой пропускной способности.
- Reb rebalance - ключ к поддержанию равномерной загрузки и эффективности после изменений топологии.
- Мониторинг состояния сегментов и консистентности данных необходим на каждом этапе изменения конфигурации.
- Практическая реализация требует соблюдения порядка действий, контроля рисков и документирования процессов.
- В рамках методологий внедрения рекомендуется сочетать планирование, тестирование и поэтапное масштабирование с оценкой влияния на текущую работу аналитических систем.
FAQ
- Какие принципы лежат в основе выбора момента для rebalance?
- Балансировка целесообразна после любого добавления или удаления сегментов, а также при значительном изменении емкости узлов. Основная цель - равномерная загрузка и избегание узких мест. Временная нагрузка на систему и периодическая активность запросов должны учитываться: лучше планировать rebalance на окна минимальной активности или совмещать его с сезонными задачами.
- Как понять, что добавление сегментов прошло успешно?
- Убедитесь, что gp_segment_configuration отражает новые сегменты, зеркало присутствует и синхронизация WAL-логов стабильна. Валидация проводится через запросы к системным представлениям и выполнение тестовых запросов, чтобы подтвердить корректность распределения данных.
- Какие риски связаны с удалением сегментов?
- Основные риски - потеря данных при некорректной перераспределенности, нехватка места на оставшихся сегментах, несоответствие между первичным сегментом и зеркалом. Рекомендуется осуществлять удаление поэтапно, с подтверждениями целостности после каждого шага и наличием резервной копии.
- Как влияет зеркалирование на производительность?
- Зеркалирование требует дополнительной записи WAL-логов и синхронизации между парой сегментов. Это может снизитьWRITE пропускную способность в краткосрочной перспективе, но обеспечивает устойчивость к сбоям и повышает целостность данных. При планировании следует учитывать требуемый запас пропускной способности сети и дисков.
- Какие инструменты чаще всего используются для управления сегментами?
- Основные инструменты: gpexpand для расширения/сокращения платформы; gp_segment_configuration для мониторинга состояния сегментов; gpstate и gpperfmon для мониторинга производительности и состояния кластера; вспомогательные скрипты и утилиты для валидации после изменений.
- Можно ли выполнить частичное обновление после rebalance без остановки всего кластера?
- В большинстве случаев rebalance выполняется без полной остановки кластера, но часть операций может потребовать временного блокирования отдельных запросов или фазовую перераспределенность. Планирование и контроль помогают минимизировать влияние на доступность.
- Как реализовать безопасное откат после неудачного расширения?
- Важно иметь заранее созданную точку восстановления, копии конфигураций и журнал изменений. При необходимости отката - вернуть конфигурацию к состоянию до расширения, проверить консистентность данных и, при необходимости, повторить перенос данных на соответствующие сегменты.
- Какие практики применяются для тестирования изменений в среде подготовки?
- Рекомендуется реплицировать изменения в тестовом окружении, выполнять нагрузочные тесты под реалистичными сценариями, проверять консистентность данных и проводить стресс-тесты с большим объемом данных, чтобы выявить потенциальные проблемы до их применения в продакшене.
- Какие цифры критичны во время планирования масштабирования?
- Емкость дискового пространства на сегментах и зеркалах, сетевые пропускной способности, текущая загрузка CPU/IO, средний размер и рост базы данных, а также доступность резервов для WAL-логов. Эти параметры определяют темпы расширения и ожидаемое время rebalance.
- Какие open-source или отечественные инструменты применимы в контексте Greenplum?
- В рамках ограничений упоминаются общие подходы к мониторингу и управлению, а также интеграционные решения. В контексте открытых и отечественных инструментов можно рассмотреть аналоги мониторинга и управления кластерами баз данных, которые поддерживают схожие принципы, например, системы мониторинга (Prometheus/Grafana) и инструменты для автоматизации развертывания, но непосредственные replace-решения для Greenplum следует применять с осторожностью и после проверки совместимости с версией и архитектурой кластера.


