

ClickHouse FAQ: Kafka, бэкапы, кластеры и MergeTree
Этот FAQ помогает разбирать эксплуатационные задачи ClickHouse: сбои чтения из Kafka, резервное копирование, репликацию и поведение MergeTree. Начинайте с симптома и проверки состояния; одна строка ошибки редко определяет единственную причину.
StorageKafka: Can't get assignment. Will keep trying — что проверить
Сообщение означает, что потребитель Kafka пока не получил назначение партиций. Кратковременное появление возможно при перебалансировке группы. Если оно повторяется и данные не поступают, проверяйте подключение к брокерам, параметры группы и состояние потребителей.
-
Зафиксируйте версию ClickHouse, имя Kafka-таблицы, топик и consumer group. Сверьте
kafka_broker_list,kafka_topic_listиkafka_group_nameв определении таблицы. -
Проверьте DNS и сетевую доступность адресов из
advertised.listeners, затем ошибки TLS/SASL в соседних строках журнала. - Сопоставьте число партиций с числом активных потребителей группы. Потребителей может быть больше, чем доступных назначений.
- Проверьте, поступают ли сообщения в топик и меняется ли lag. Отдельно проверьте материализованное представление, которое переносит сообщения в целевую таблицу.
SELECT version();
SHOW CREATE TABLE db.kafka_events;
DESCRIBE TABLE system.kafka_consumers;
SELECT * FROM system.kafka_consumers
WHERE database = 'db' AND table = 'kafka_events'
FORMAT Vertical;
db.kafka_events — пример: замените его своим именем. Набор полей системной таблицы зависит от версии. Не сбрасывайте offsets и не меняйте consumer group как универсальное «лечение»: это может привести к повторному чтению. Прямой SELECT из Kafka-таблицы также не следует использовать как безобидную проверку потока.
Бэкап ClickHouse: что должно войти в проверку
Разделяйте встроенные BACKUP/RESTORE и внешний clickhouse-backup: параметры этих инструментов не взаимозаменяемы. Выберите способ для своей версии, включите нужные данные и метаданные, проверьте пользователей и права отдельно. Успех создания копии подтвердите восстановлением на отдельном стенде и контрольными запросами.
ALTER TABLE ... FREEZE создаёт локальный снимок частей через жёсткие ссылки. Сам по себе он не переносит копию на независимое хранилище. Учитывайте занятое место и жизненный цикл снимков.
MergeTree, шард и реплика — разные понятия
MergeTree определяет организацию данных таблицы. Шарды делят набор данных, реплики хранят его копии. Distributed направляет запросы к таблицам на узлах. Наличие Distributed-таблицы само по себе не создаёт резервную копию.
SELECT database, table, count() AS active_parts,
       sum(rows) AS rows, formatReadableSize(sum(bytes_on_disk)) AS size
FROM system.parts
WHERE active
GROUP BY database, table
ORDER BY sum(bytes_on_disk) DESC;
Если задача повторяется в рабочем кластере, сопоставьте схему загрузки и настройки с программой курса по ClickHouse. Для сопровождения действующей базы — настройка и поддержка баз данных.
Документация
Бэкап
Вопрос. как перенести всех пользователей Clickhouse в новый CH? С их паролями?
точная схема
clickhouse-backup create_remote --rbac --schema

clickhouse-backup restore_remote --rbac --schema
но сервер надо рестартануть, иначе rbac из бекапа применить нельзя, к сожалению...
при резервном копировании моих таблиц с помощью clickhouse-backup я вижу такие журналы, как ALTER TABLE FREEZE...
повлияет ли это на что-нибудь, если я использую этот инструмент для резервного копирования на производстве?
я имею в виду, как это работает, замораживает ли таблицу до тех пор, пока не будет запущено резервное копирование конкретной таблицы?
https://github.com/AlexAkulov/clickhouse-backup
using this tool;
Оно делает хардлинки в shadow, не трогая ничего в основной таблице. Из-за данной функции может увеличиваться занимаемое место на диске
подскажите, пожалуйста, как ускорить процесс удаления данных с диска? Я сделал обычный DROP DATABASE, прошел час и место еще не освободилось. Надо было добавить SYNC в конце команды, но я забыл это. А что теперь можно сделать?
Так скорее всего бекап. Смотрите размер /shadow /backup
есть кластер, сейчас у каждого шарда две реплики, три базы данных, в сумме порядка 50 таблиц. Добавляю новую реплику, есть ли возможность не создавать каждую базу и таблицу отдельно на каждой из новых реплик, а сделать как то переносом файлов метаинформации или что нить такое?
Можно сделать бэкап схемы и развернуть его.
Ну или попробовать вытянуть данные создания таблиц из system.tables и выполнить
внутреннего инструмента в бэкапе схемы не припоминаю
но вот тут точно есть https://github.com/AlexAkulov/clickhouse-backup
если у вас только таблицы то посмотрите system.tables там есть поле отражающее create table скопируйте оттуда все и вставьте на новом сервере и выполните. Будет быстрее чем разобраться, есть ли бэкап схемы внутри Clickhouse
Подскажите, пожалуйста, а существуют ли какие-то правильные подходы, либо примеры, позволяющие забекапить схему данных (бд, таблички, вьюхи, словари и тд) на кластере? попробуйте https://github.com/AlexAkulov/clickhouse-backup
shema only
А кто-то бэкапит на s3 ClickHouse?/
Как можно использовать роль в авс а не указывать аксесс и сикрет кей
AWS_ROLE_ARN
попробуйте через переменную окружения задавать, которую clickhouse-server будет видеть
Кластер

У нас была 1 нода, сделали 3 (кластер). Хотим сделать ReplicatedMergeTree таблицы. Подскажите как лучше перенести данные с 1 ноды на 3?
По какой причине узел кластера переходит в статус Inactive в system.distributed_ddl_queue и как его вернуть в Active без рестарта? Не нашел команд для манипуляций с distributed_ddl_queue
Возможно были проблемы с ZK, но это не точно. Сейчас ZK работает нормально, команды расползаются по кластеру, только нода инициатор сидит в inactive и не исполняет.
потому что это readonly таблица нет там никаких манипуляций, это просто прокси таблица к ZK в котором по определенному пути distributed_ddl лежит
смотрите на проблемном узле
SELECT event_time, ProfileEvent_ZooKeeperHardwareExceptions FROM system.metric_log WHERE ProfileEvent_ZooKeeperHardwareExceptions > 0 AND event_date = today()
active = 0
обычно значит, что не успело в течении 180 секунд ваш distributed ddl исплониться
Кластер(к8с) Clickhouse 1 реплика 1 шард жили и все было хорошо, но пришло время расширяться. Поставили зукипер, увеличили через конфиги до 3 реплик и шардов. Все обновили, кажется без проблем. Подключаемся через бобра, а старых схем/таблиц нет. Захожу в под(volume старые) данные на месте, а запросы к ним не идут(для новых все пусто) . Кто сталкивался с этим или знает где почитать?
логи контейнера clickhouse-operator смотрите в deployment clickhouse-operator
таблицы с каким движком были? MergeTree раз без zookeeper
значит они не отреплицировались а просто схема пустая скорее всего создалась... или даже не создалась, смотря какая версия operator
сначала надо было ZK добавить и сконвертировать MergeTree в ReplicatedMergeTree
https://kb.altinity.com/altinity-kb-setup-and-maintenance/altinity-kb-co...
а потом уже конфиг менять
Возможно ли как то соединить два Clickhouse между собой так, чтобы данные из одного стримились в другой? Хотим сделать один CH как хранилище данных, к которому подключаются другие CH, которые выполняют роль стендов. Или на роль хранилища данных лучше взять не Clickhouse?
Много серверов==кластер. Если вам просто для тестов, то можете сделать как на Replicated, так и на Distributed
Стоит такая задача
Есть топик на 12 партиций
Кластер на 6 машин
Как лучше организовать чтение из топика?
- сделать на каждой машине 2 kafka table с дефолтными настройками + 2 mat view для переноса данных
- сделать 1 mat view + 1 kafka table с настройкамий kafka_num_consumers = 2 и kafka_thread_per_consumer = 1
Судя по доке алтинити советуют создавать прям отдельные таблицы но мб в новых версиях CH можно сделать через 1 таблицу
Кто чем пользовался, поделитесь)
делайте var2 где всего по одному :) И не надо увеличивать количество kafka_num_consumers пока не поймете что начинает падать скорость работы.
И вам надо почитать немного про кафку, что такое перебалансировка партиций в консьюмере.
если я запускаю delete c подзапросом вида
ALTER TABLE some_table ON CLUSTER my_cluster

DELETE

WHERE cl IN (

SELECT cl

FROM some_table

);
delete выполнится на каждой ноде кластера, а подзапрос? тоже на каждой ноде или только на которой был выполнен запрос?
на каждой ноде отдельно вычислит список для удаления.
КХ запишет ровно то, что вы написали в своем алтере в таблицу distributed_ddl_queue, а потом выполнит оттуда на каждой ноде. И по умолчанию не даст вам это сделать, потому как может случиться рассинхронизация данных на репликах.
см allow_nondeterministic_mutations (надо ставить в профиле на всех хостах).
подскажите, пожалуйста, можно ли использовать материализованное представление созданное в кластере с distributed engine для получения данных из системных таблиц в кластере (parts, tables, log-query)
Можно делать что угодно (это обычные MT таблицы). А вот что получится - зависит от того что вам нужно. А вот этого вы и не сказали. Я могу предположить и рекомендовать почитать тут - https://kb.altinity.com/altinity-kb-setup-and-maintenance/sysall/
но может вы про что-то иное.
подскажите как правильно почистить из схемы system таблицы query_log, query_thread_log, trace_log и прочие*_log. Можно ли дропнуть на кластере? В доке указано, чтоClichouse их пересоздаст. Или так нельзя?
Можно, так и будет, дроп.
Только помните про отложенный механизм при дропе, либо используйте
drop table .... on cluster ... SYNC
Есть проблема с Zookeeper (версия 3.8.0). Ноды перестают отвечать на команды ruok и рестартуются Kubernetes по кругу (минут через 9-10 работы).
Из подозрительного - большой трафик на запись в диски Zookeeper (4-6 MB/s). Соответственно большие логи.
В кластере Clickhouse 3 копии данных. Как я понимаю, такое можно ожидать при большом кол-ве небольших вставок данных.
И до сегодняшнего дня было подозрение на проблему работы RabbitMQ Engine. Сегодня обновили CH, который пофиксил проблему с RabbitMQ и по логам вроде как прежняя проблема не наблюдается.
Но проблем с Zookeeper продолжаются.
Можно ли подсчитать количество выполняемых вставок во всем кластере CH, как их разбить по таблицам?
Может есть какие-то метрики со стороны ZK?
Под ZK выделен xmx4G. Размер базы данных ~45MB.
https://github.com/pravega/zookeeper-operator/issues/475
меняйте на обычный bash и readinessProbe вообще можно убрать
Есть distributed таблица (шарды без реплик), необходимо приджойнить в запросе другую таблицу, которую шардировать не получится (не имеет смысла) и надо хранить целиком на каждом шарде. Если просто положить ее локально на каждом шарде, то будет ли она использоваться на каждом шарде независимо при выполнении запроса с присоединенной distributed таблицой? Или все таки все выберется из distributed и далее обработается на ноде, на которой выполняется запрос? Если второе, то поможет ли создание кластера с 1 шард и полной репликацией на тех же нодах? Оптимизатор поймет, что можно эту таблицу использовать на каждой ноде независимо до отправки результата на инициатор? Спасибо.
> Если просто положить ее локально на каждом шарде, то будет ли она использоваться на каждом шарде независимо при выполнении запроса с присоединенной distributed таблицой?
Или все-таки все выберется из distributed и далее обработается на ноде, на которой выполняется запрос? Если второе, то поможет ли создание кластера с 1 шард и полной репликацией на тех же нодах?
не понял разницы, но будет локальная таблица на каждой ноде использоваться. Можно делать кластер (1 шард все реплики), можно руками везде создать и грузитью.
если совсем лень, можно перед запуском запроса сделать темп таблицу на инициаторе и джоинить её, тогдаClichouse сам разошлет её по шардам.
> Оптимизатор поймет, что можно эту таблицу использовать на каждой ноде независимо до отправки результата на инициатор?
да. Но есть нюансы в многоуровневых запросах с вложенными subquery. Верхние уровни будут выполнятся на инициаторе.
Устранение ошибок
подскажите пожалуйста, не могу понять что за ошибка. использую питоновский модуль clickhouse_connect, client.command'ом дергаю с csv файла queries... текст ошибки:
Code: 62. DB::Exception: Syntax error (Multi-statements are not allowed): failed at position 76 (end of query): ;
в query_log можно смотреть, скорее вот с таким типом (ExceptionWhileProcessing) и уже вычленять
Возникает ошибка, причину которой не понимаю
Ошибка при таком запросе с groupArray:
select visitID, groupArray(click_link) as click_link_arr

from srch_clr

where action = 'click_link'

group by visitID
Если сделать просто select * from srch_clr, то запрос отрабатывает
Не понятно почему не найден столбец clientID в блоке, когда он там есть
пока проблема вроде решилась. А была она в подзапросе в where. Без него работает. В итоге вынес подзапрос в отдельный CTE и заменил на join


Есть CSV файл, в колонках которого есть строки такого типа:
column1, Картина Три Медведя, column3
То есть могут быть строки с двойными кавычками внутри
Clichouse при попытке их считать падает с ошибкой.
Подскажите пожалуйста, есть ли способ все же считать такие данные не редаектируя CSV файл?
CustomSeparated
Столкнулся со странным поведением поля типа JSON. Есть две таблицы одинаковой структуры, в них по такому полю.
Запрос
SELECT OrderId, t1.JsonField, t2.JsonField FROM table1 t1 JOIN (SELECT * FROM table2) t2 USING OrderId WHERE JsonField != t2.JsonField
Срабатывает верно и сравниваются поля из разных таблиц, в ответе тоже поля из разных таблиц
А если сделать вот так:
SELECT OrderId, t1.JsonField.Guid, t2.JsonField.Guid FROM table1 t1 JOIN (SELECT * FROM table2) t2 USING OrderId WHERE JsonField.Guid != t2.JsonField.Guid
То получим ошибку Missing columns: ‘JsonField.Guid’ на where
Если вернуть первое условие и сделать такой запрос
SELECT OrderId, t1.JsonField.Guid, t2.JsonField.Guid FROM table1 t1 JOIN (SELECT * FROM table2) t2 USING OrderId WHERE JsonField != t2.JsonField
То ошибок не будет, условие сработает, но в результатах вместо t2.JsonField.Guid будет значение из такого же поля t1
Если поля в разных таблицах назвать по-разному, то в третьем варианте будет ругаться на несуществующее поле, если отключить алиасы - тоже самое
Есть ли возможность после JOIN добраться до вложенных полей из колонки второй таблицы?
Не надо использовать select * в подзапросе.
* - это список колонок, так как это указано в определении таблицы. Никакие внутренние туплы тут не раскрываются. Если вы делаете подзапросы - явно указывайте все элементы туплов, которые вы хотите выдать наверх.
из-за чего вылазит ошибка аутентификации при работе с словарем?
SQL:
SELECT dictGet('dict-test', ('date'), 2323641414416316)
Error:
default: Authentication failed: password is incorrect or there is no user with such name: While processing dictGet
скорее всего неправильная аутентификациия в настройках словаря
Подскажите, пожалуйста, делаю вставку в csv примерно так:
cat test.csv |clickhouse-client --format_csv_allow_double_quotes=0 -q 'insert into csv format CSV'
в test.csv ровно те же столбцы, что и в таблице csv
а как сделать так, чтобы в таблицу csv писалось время вставки?
пробовал сделать столбец _time, в который писал now() - логично, что ошибка, тк к-во столбцов разное
мат.вью - это по сути же будет копия основной таблицы +столбец?
https://clickhouse.com/docs/ru/sql-reference/table-functions/input/
Как можно включить настройку stream_like_engine_allow_direct_select, нужно создать таблицу, которая считывает данные из очереди RabbitMQ.
Сейчас при попытке это сделать, появляется следующая ошибка:
Direct select is not allowed. To enable use setting stream_like_engine_allow_direct_select
Так вы пытаетесь читать непосредственно из очереди, а не из таблицы, в которую бы складывались данные из неё.
Пользуемся CH для ssa отчётности. Запросы поступают от read-only юзеров. Появилась необходимость делать запросы с модификацией опций (обойти ошибку: Cannot modify ... setting in readonly mode), а именно, хотим запускать с SETTINGS distributed_product_mode = 'local'.
Возник вопрос, изменение параметра readonly с режима 1 на режим 2 в конфиге позволит это делать, но какие у этого есть риски? Существуют ли какие-то settings, которые дают возможность readonly юзеру сломать базу?
Может быть есть альтернативные решения? Например включение определённых SETTINGS определённому пользователю?
конечно можно выдавать readonly пользователю пресеттинги <ch>
    <profiles>

        <readonly>

            <distibuted_product_mode>local</distibuted_product_mode>

            <distibuted_group_by_no_merge>1</distibuted_group_by_no_merge>

        </readonly>

    </profiles>

    <users>

        <readonly>

             ...

            <profile>readonly</profile>

             ...

        </readonly>

    </users>

</ch>
Схема такая StreamLikeEngineTable -> MaterializedView ->MergeTreeFamilyTable, делать выборки только из последней
некорректно работает вставка в таблицу. Таблица distributed, кластер поднимается в docker из одного шарда и одной реплики. В таблицу пишем с помощью http. В чем может быть проблема? Вот пример поведения:
может срабатывать дедубликация insert'a и повторная вставка такого же батча не происходит.
Вставьте вторым запросом другое значение и проверьте count
Ну и ещё хорошо бы понимать с каким движком таблица стоит за distributed
Спустя несколько месяцев стабильной работы серваки в кластере начали уходить в 100% рам и отваливаться. По логам ошибка = too many parts(301). Сходу решили не увеличивать кол-во партов, а поменять ttl. Не помогло. Подскажите пожалуйста как правильно полечить?
Ключ партиционирования неправильно выбран
Вижу в доке, что вроде как можно изменять порядок колонок с помощью стейтмента:
alter table db.table modify column col1 after col2;
С какой версии это должно работать и не ошибся ли я в синтаксисе? У меня падает с такой ошибкой:
Code: 62. DB::Exception: Syntax error: failed at position 71 ('col2'): col2. Expected one of: AFTER, CODEC, end of query, REMOVE, INTO OUTFILE, ALIAS, FIRST, TTL, Comma, SETTINGS, FORMAT, DEFAULT, MATERIALIZED, COMMENT, token. (SYNTAX_ERROR) (version 21.11.3.6 (official build)) https://fiddle.clickhouse.com/15456515-23c4-4754-921e-8de165942a08
использую в docker-compose образ clickhouse/clickhouse-server, ошибка при запуске:
/entrypoint.sh: running /docker-entrypoint-initdb.d/init_clickhouse.sql

Code: 74. DB::ErrnoException: Cannot read from file (fd = 0), errno: 21, strerror: Is a directory. (CANNOT_READ_FROM_FILE_DESCRIPTOR)
Такая ошибка пояляется в CI, при локальных запусках её нет. Файл .sql копирую так:
volumes:
- ./clickhouse-init/initdb.sql:/docker-entrypoint-initdb.d/init_clickhouse.sql
Проблема в том, что прокидывали докер через --docker-volumes=/var/run/docker.sock:/var/run/docker.sock, если это убрать то все заработает
Нубский вопрос: почему в запросе клик ругается на сиротскую колонку dt, хотя все колонки dt указаны вместе с алиасами родительских таблиц?
SELECT

    d.dt + toIntervalDay(n.number) AS start_time,

    count()

FROM

(

    SELECT toDateTime('2022-11-04 00:00:00') + toIntervalSecond(n.number) AS dt

    FROM numbers(0, 3000000000) AS n

) AS pto

CROSS JOIN numbers(10, 30) AS n

CROSS JOIN

(

    SELECT toDateTime('2022-12-04 00:00:00') AS dt

) AS d

WHERE (pto.dt >= (d.dt + toIntervalDay(n.number))) AND (pto.dt < (d.dt + toIntervalDay(n.number + 1)))

GROUP BY n.number

ORDER BY n.number ASCОшибка:
Received exception from server (version 22.11.2):

Code: 47. DB::Exception: Received from :9000. DB::Exception: Unknown identifier: dt; there are columns: number, count(): While processing dt + toIntervalDay(number) AS start_time, count(). (UNKNOWN_IDENTIFIER)
На подзапрос для pto не обращайте внимания, в нормальном запросе вместо него у алиса pto нормальная таблица (именно с ней и проявилась ошибка первый раз)
Ругается на этап SELECT. Разве этап select не выполняется поле этапа всех джойнов?
он ругается на то, что вы делаете группировку в первом запросе, но в ней нет поля dt
Хотим создать кастомный профиль с дефолтными настройками (на скрине).
Получаем ошибку: Unknown setting distributed_product_mode
Есть идеи, что делаем не так?
скорее всего вы забыли букву r в слове distributed

Возникла потребность удалить часть записей из таблицыClichouse по сложному условию.
Есть селект на таблицу в БД с именем dwh
select event_ts, event_id, category_id from dwh.events where ....сложное условие с субселектами
возвращающий список строк, которые необходимо удалить.
Пытаюсь подставить это список строк в delete так:
delete from dwh.events where (event_ts, event_id, category_id) in ( предыдущий селект)
и получаю ошибку
Code: 60. DB::Exception: Table default.events doesn't exist. (UNKNOWN_TABLE) (version 23.1.2.9 (official build))
т.е. что-то внутри delete почему-то пытается обратиться к таблице в БД default, а не моей dwh. И в селекте и в делете везде прописал имя БД, но ошибка так и осталась.
Попробовал alter table delete, результат такой же. В смысле ошибка такая же.
Попробовал вместо delete сделать select, вернуло те записи, которые необходимо удалить.
Как можно не прибегая к скриптам на bash и т.п. удалить из таблицы некоторое количество записей по селекту с несколькими полями в условии для удаления?
https://kb.altinity.com/altinity-kb-queries-and-syntax/update-via-dictionary/
В docker, network host mode, ClickHouse после перезапуска не открывает сетевые порты. Раньше всё нормально было. В логах идут ошибки Too many parts (300)... - может из за этого сервер не открывать порт? Как можно чекнуть прогресс мёрджа?
from airflow_clickhouse_plugin.operators.clickhouse_operator import ClickHouseOperator
Пытаюсь закачать в Clickhouse из s3 данные. Есть таблица с engine=s3, тип файлов - Parquet. Пытаюсь сделать к ней запрос - и контейнер выдает ошибку. в логах нашел такое
{} <Error> ServerErrorHandler: Code: 241. DB::Exception: Memory limit (total) exceeded: would use 3.48 GiB (attempt to allocate chunk of 1048591 bytes), maximum: 3.40 GiB
RAM на сервере немного (4гб), но паркеты в s3 по размеру не превышают 1Гб.
max_server_memory_usage_to_ram_ratio=2 - не помогает.
S3 и hadoop требовательные системы. Поможет добавление RAM. Вероятно Parquet сжатые (snappy, whatever), и при распаковке в памяти начинают занимать больше места
insert into history

SELECT

now() as CreatedAt,

JSONExtract(body,'Номер', 'String') as OrderCode,

JSONExtract(body,'GUID', 'String') as OrderGuid,

JSONExtractRaw(body) as Data

FROM queue

settings stream_like_engine_allow_direct_select=1
работает нормально
а
CREATE MATERIALIZED VIEW IF NOT EXISTS consumer TO history AS

SELECT

now() as CreatedAt,

JSONExtract(body,'Номер', 'String') as OrderCode,

JSONExtract(body,'GUID', 'String') as OrderGuid,

JSONExtractRaw(body) as Data

FROM queue
выдает ошибку
void DB::StorageRabbitMQ::streamingToViewsFunc(): Code: 27. DB::ParsingException: Cannot parse input: expected ']' before: '{\n <тут кусок JSON>’: While executing RabbitMQ. (CANNOT_PARSE_INPUT_ASSERTION_FAILED)При этом сама queue имеет одну колонку body String и формат JSONAsString
в таблице очереди необходимо прописать rabbitmq_max_block_size = 1. Иначе сообщения читаются сплошным потоком без разделения и формат ломается
Вопрос такой, хочу из google sheets
пробросить табличку, в табличке одна из колонок массив со строками
Вопрос почему Массив интов без проблем загружается, а массив строк выдает ошибку
ожидается кавычка, а обнаруживается e
Нужно каждую строку в кавычки обернуть


как в ClickHouse драйвер параметризовать название таблицы?
table = 'my_table'

query = alter table %(table)s delete where Veh = %(veh)s
так получаю ошибку
Syntax error: failed at position 13 (''my_table'') Во всех sql нельзя в prepared statements сувать названия таблиц и бд
стоит задача в том, чтобы из Clichouse достать значения из столбцов, имена которых до этого создались автоматически и я заранее их не знаю, но знаю, что они удовлетворяют паттерну, например hello_*, где вместо астериска может быть какая-то строка. вопрос, как мне выбрать данные из таких колонок? пришла идея, что имена колонок можно получить, сделать describe table <table_name>, обернуть это все в select и уже потом как-то там отфильтровать через where, но использовать describe как вложенный select не получается, падает с ошибкой синтаксиса:
select name from (describe table my_table) where islike(name, hello_%);
ошибка:
syntax error: failed at position 19 ('DESCRIBE')сталкивался кто с таки или может есть другой способ сделать select from columns by column prefix?
либо, даже если у меня и получится провернуть этот трюк и получить имена колонок подходящие под паттерн, я все равно не смогу сделать что-то вроде:
select (
<здесь подзапрос, который вернет имена колонок>
) from my_table;
?
https://clickhouse.com/docs/en/sql-reference/statements/select/#columns-expression
Обучение
Есть какие-нибудь курсы по клику?
https://www.youtube.com/playlist?list=PLO3lfQbpDVI-hyw4MyqxEk3rDHw95SzxJ
https://education.biconsult.ru/courses/
Есть ли какое-нибудь обучение по CH в Казахстане, а именно в Алматы? Либо онлайн, проверенные.
https://altinity.com/clickhouse-training/
Кто-нибудь пользовался функциями машинного обучения в ClickHouse, как это работает и что оно умеет?
оно умеет предикты делать. по зафиченым моделям
https://clickhouse.com/docs/en/sql-reference/functions/machine-learning-functions/
обучение внутрь clickhouse не встроили
evalMLMethod плохо документирован
в общем достаточно все печально у ClickHouse в MachineLearning
MergeTree
Как дедуплицировать таблицу? У меня MergeTree с PRIMARY KEY (id) и при этом ряды с одинаковыми id присутствуют.
PRIMARY KEY это не UNIQUE как в других базах
прочитайте про ReplacingMergeTree в документации
Подскажите как выяснить какие процессы отъедают память и по сколько.
Словари, лайввью, primary key from parts уже отпрофилировал, мержи и мутации просмотрел, Кэши почистил, но все равно непонятно куда утекает порядка 40-45 Гб оперативки. Какие еще способы есть чтобы понять какие процессы самого Clichouse потребляют память и в каких количествах.. Логи почти все отключены, а основной лог запросов переделан в mergeTree. Запросов на чтение и запись почти нет (у основных пользователей еще утро-ночь) Clichouse 22.8.4.7 lts
Можно включить memory profiler перегрузить сервер и посмотреть растет память или нет
Можно построить flamegraph через https://github.com/Slach/clickhouse-flamegraph/
в документации clickhouse на русском и английском версиях написаны противоположные утверждения, которому верить?
https://clickhouse.com/docs/en/engines/table-engines/mergetree-family/cu...
Partitioning does not speed up queries (in contrast to the ORDER BY expression).
Это позволяет оптимизировать работу с данными, так как при обработке запросов будет использоваться только необходимое подмножество из всевозможных данных.
русская менее точная
правильно выбранные PARTITION BY запросы все-таки ускоряет за счет того, что производится PARTITION prunning
https://kb.altinity.com/engines/mergetree-table-engine-family/pick-keys/
Имеется база данных в CH являющаяся репликой базы PostgreSQL через MaterializedPostgreSQL. Данные в PSQL добавляются через upsert. Есть задача - создать витрины данных (materialized) в CH для последующей визуализации (применить GROUP BY, JOINы к исходным). Правильно я понимаю, что в данном случае нужно использовать
CREATE MATERIALIZED VIEW table_name ENGINE = MergeTree AS SELECT ...
и обновлять данные через DROP / CREATE (из-за upsert) или есть более оптимальное решение?
Прежде всего лучше забыть про такой способ создания MV, и всегда использовать синтаксис с To и самостоятельно созданной таблицей хранения.
Если вы хотите отказаться от полного пересоздания, то надо научиться делать инкрементальные обновления.
MaterializedPostgreSQL вставляет не только строки с данными, но и строки коррекции с _sign=-1 Используя этот стобцец вы можете построить агрегацию, которая будет вычитать старые значения, и прибавлять новые. Например, обычный сумматор выглядит не как sum(value), а sum(_sign*value). Про count() можно забыть и использовать sum(_sign), и так далее. Не всегда просто подобрать агрегационную функцию, но в большинстве случаев это реализуемо. Задавайте вопрос по конкретным столбцам и агрегационным функциям.
Почему в партицированной таблице с движком ReplicatedReplacingMergeTree команда OPTIMIZE TABLE table ON CLUSTER '{cluster}' FINAL может не схлопывать дубликаты по ключу? Даже мутация не появляется. Запрос select * from table final возвращает коректные данные и если убрать партиции с таблицы все тоже работает как надо. Версия 22.3.12.21.altinitystable
У вас optimize_skip_merged_partitions случайно не включено?
Я тоже сталкивался с подобным. На 22.10
Поборолся оптимизацией по одной партиции. Список партиций в которых больше 1-го парта построить не трудно.
Как я могу удалить строчку из таблицы в ClickHouse по ключу?
пробовал способом
ALTER TABLE my_table DELETE WHERE key=‘MY_KEY’
не удаляется - движок таблице MergeTree
Если данный ключ используется в другой таблице, то необходимо удалять с помощью каскадной функции не только эту строчку, но и связанную строчку из другой таблицы
ALTER TABLE child_table_name

  ADD CONSTRAINT fk_name

  FOREIGN KEY (child_column_name)

  REFERENCES parent_table_name(parent_column_name)

  ON DELETE CASCADE
как удалить ненужные значения в таблице clickhouse? использую MergeTree, что-то я не могу найти команду
допустим у меня есть 200 строк, которые я хочу удалить, как это сделать? по дате например
ALTER TABLE ... DELETE WHERE ...
если версия свежая, то можно DELETE FROM, по классике
это разные механизмы. в документации соответственно
https://clickhouse.com/docs/en/sql-reference/statements/alter/delete
https://clickhouse.com/docs/en/sql-reference/statements/delete/
А SYSTEM STOP MERGES действует до перезагрузки?
да. До detach / attach таблицы, или до system start merges, и наверное system restart replica тоже стартанет мержи
Подскажите как выполнить дедубликацию в таблице MergeTree запросом через clickhouse_driver? Вылетает timeout:
TimeoutError: timed out
Сам запрос:
client.execute(

     OPTIMIZE TABLE table1 FINAL DEDUPLICATE BY  phrase, updated_at

)
Настройки подключения:
settings = {

    connect_timeout: 9999,

    receive_timeout: 9999,

    send_timeout: 9999,

    'columnar': True,

    'use_numpy': True,

    'compression': True

}
Нужен параметр {send_receive_timeout: 18000}
In reply to this message
Вот это тут https://clickhouse-driver.readthedocs.io/en/0.2.5/api.html?highlight=Connection#connection
Вот предложенное решение
https://github.com/mymarilyn/clickhouse-driver/issues/196
При создании таблицы типа MergeTree
Если не указать Primary key то его значение возмется автоматом из строки ORDER BY
Если я укажу Primary key отличный от ORDER BY
то OPTIMIZE FINAL чем будет руководствоваться?
https://clickhouse.com/docs/en/engines/table-engines/mergetree-family/replacingmergetree/
The engine differs from MergeTree in that it removes duplicate entries with the same sorting key value (ORDER BY table section, not PRIMARY KEY).
У меня вопрос про репликацию и распределенные ddl запросы. Работают ли они для ReplicatedMergeTree или только для Distributed таблиц? В доке написано, что для реплик некоротые опреции (REATE, DROP, ATTACH, DETACH и RENAME) придется выполнить на каждой реплике отдельно, можно ли без этого обойтись и заюзать ON CLUSTER ?
Alter table реплицируется во все реплики шарда.
ON CLUSTER нужен если шардов несколько и всегда нужен если движок таблицы не Replicated (т.е. например для Distributed как раз нужен всегда)
есть еще Database Engine=Replicated там все само реплицируется для всех движков.
А когда есть смысл делить таблицу на партиции? может есть советы какие то? сколько данных на партицию считается ок?
https://kb.altinity.com/engines/mergetree-table-engine-family/pick-keys/
партиции имеют смысл если имеет смысл partition prunning
то есть допустим у вас запросы в 90% случаев берут данные за последний месяц
то тогда партицирование по месяцам позволяет очень быстро не сканировать большинство старых партов. партиции полезны бывают для оперирования данными (перенести куда-то, отключить часть выборки и т.д.).
И при партиционировании таблицы стоит помнить о том, что вставка может не пройти в неё, если за раз модифицируется большое количество партиций. Например, таблицу побили по дням, а потом первичные данные откуда-то загружают в разбивке иной, по регионам, допустим, и начинают данные заливать сразу в большое число партиций.
почему при таком синтаксисе создается пустая вьюшка (сам запрос select работает корректно)?
CREATE MATERIALIZED VIEW view_name

ENGINE = SummingMergeTree

ORDER BY id

AS

SELECT ... FROM ...
поля в select и таблице должны называться одинаково.
SummingMergeTree НЕ ХРАНИТ НОЛИКИ (строки где все метрики равны 0)
помогите разобраться плиз, нужно раз в день делать джойн четырех таблиц каждая по 200kk по 3-ем колонкам. хотел использовать клик чтобы было быстро, данные преагрегированны и вылиты в ClickHouse. Таблицы отсортированы по 3 ключам и отпартишены по ним же. движок MergeTree.
короче клик не нагружает все CPU. как можно заставить его разбрасывать нагрузку по все CPU? может сеттинг какой есть?
можете попробовать уменьшить количество тредов SETTINGS max_threads = N
таблица имеется engine = replacingmergetree, использую запрос-обновление insert ... select. Через какое время произойдет слияние? в доке вроде пишут в любой момент. может какие то факторы на слияние дубликатов еще влияют, чтобы хоть ориентироваться как-то.
В версии 22.10-22.11 завезли 2 параметра - min_age_to_force_merge_seconds, min_age_to_force_merge_on_partition_only. Они позволяют принудительно запускать мерджи по времени

Есть потребность проливать в табличку в Clickhouse данные раз в несколько часов, а затем докидывать в эту таблицу апдейты определенных записей (некоторые колонки хотят меняться).
Хочется лить туда апдейты пачками, накапливать их по несколько минут. Посмотрел доступные вClichouse движки и ни один не подошел (нет возможности хранить в приложении старое состояние обновляемых записей).
Существуют ли альтернативные способы актуализации состояния таблицы вClichouse если есть потребность в точечных апдейтах? При условии что табличка не очень большая (несколько сотен миллионов записей и несколько десятков колонок).
Возможно можно хранить апдейты в соседней табличке и наливать строить матвью поверх этого (но тогда нужен способ эффективно на уровне селекта склеить сырые данные с апдейтами?)
А вам не подходит ReplacingMergeTree?Clichouse в фоне их смержит. Если важна актуальность данных, то можно использовать FINAL, но при этом может пострадать производительность
Можете предложить советы как вClichouse обновить/удалить всего пару строк что бы результат был сразу же ?
Вызов обновления/удаления может быть частым и может быть, что будут затронуты очень старые данные.
На ум приходит только использование CollapsingMergeTree и использование агрегации при запросе данных, но может быть есть ещё какой нибудь способ который я не вижу
все варианты описаны тут - https://kb.altinity.com/altinity-kb-schema-design/row-level-deduplication/
Решайте прежде всего, что для вас важнее - быстрые insert или select
Collapsing ценен если у вас поверх этой таблицы будут агрегирующие MV. Если нет, то достаточно будет Replacing.
А можно в существующую и заполненную данными таблицу engine = SummingMergeTree добавить колонку и эту колонку вставить в список агрегируемых, указываемых в engine?
Можно через simpleaggregatefunctiion.
Если таблица replicated, то придется пере аттачивать парты в таблицу с другим списком
В какой то момент времени приходят данные по транзакции ( с разным временем и разными ивентами) , каунт считается прелестно , а вот время я так понял агрегирует каким то странным образом
Да, нужен AgregatingMergeTree, но для min/maх/count лучше использовать SimpleAggregateFunction, и без State/Merge. Там весь стейт - это само значение.
На самом деле можно даже оставить SummingMergeTree - оно стерпит.
https://fiddle.clickhouse.com/906e3183-3202-494c-a78e-9bacff4fd5e9
подскажите правильный синтаксис для значений по-умолчанию для массивов
CREATE TABLE x (`a.b` Array(Int8) DEFAULT [-1]) ENGINE = MergeTree ORDER BY tuple();

INSERT INTO x VALUES ([null]);

SELECT a.b FROM x;
хочу получать -1, а не 0
вставляйте тогда null вместо [null]
Возможен-ли вариант , когда вновь-установленному серверу Clickhouse подсунуть диск с базами от старого КХ ?
Типа: переезд на более производительное железо и более свежую ОС
возможен
собственно вся база — это файлики в /var/lib/clickhouse/data/
/var/lib/clickhouse/store/
/var/lib/clickhouse/metadata/
но есть ньюанс. в виде всяких штук типа значения макроса {replica}
и вообще надо понимать как ReplicatedMergeTree таблицы работают
В логах clickhouse вижу большое количество сообщений вида:
Warning> CollapsingSortedBlockInputStream: Incorrect data: number of rows with sign = 1 (2) differs with number of rows with sign = -1 (0) by more than one (for key: 19398, 6029, 6673288564376851156). : 1
Используем табличку с CollapsingMergeTree engine и следующими полями группировки:
ENGINE = CollapsingMergeTree(sign) PARTITION BY toYYYYMM(ts) ORDER BY (ts_day, host, session) SETTINGS index_granularity = 8192
При выборе из таблички вижу следующие записи:
SELECT *

FROM requests

WHERE session = 6673288564376851156


┌─sign─┬──────────────────ts─┬─────ts_day─┬─host─┬─────────────session─┬─load─┬─request─┬

│ -1   │ 2023-02-10 17:09:55 │ 2023-02-10 │ 6029 │ 6673288564376851156 │   1  │       0 │

│  1   │ 2023-02-10 17:09:55 │ 2023-02-10 │ 6029 │ 6673288564376851156 │   1  │       1 │

└──────┴─────────────────────┴────────────┴──────┴─────────────────────┴──────┴─────────┴
Количество +1 и -1 в столбце sign по одному, лог же утверждает, что c +1 две записи и -1 - 0 записей.
Подскажите как можно диагносцировать причину, т.к. на тестовом стенде воспроизвести такую ситуацию не получается?
как предположение этот варнинг выдается в формате блока заинсерченого, может если по всем блокам - у вас все норм, а вот в блоке получилось несхождение
https://clickhouse.com/docs/en/operations/settings/settings/#settings-max_insert_block_size
Есть таблица на движке MergeTree с ключем ORDER BY (id, post_name). Необходимо проапдейтить поля в post_name. Я же верно понимаю что это сделать невозможно. И нужно создавать новую таблицу, наполнять ее верными данными, потом удалять старую и ренеймить новую. Или есть какой-то другой способ?
Есть ограничения.
Нельзя менять значения, входящие в ключ (если он не отличатся от ORDER BY, то поле ТС туда войдёт):
https://clickhouse.com/docs/en/sql-reference/statements/alter/update
Кроме перезаписи в другую таблицу можно ещё попробовать так: https://clickhouse.com/docs/en/engines/table-engines/mergetree-family/mergetree#choosing-a-primary-key-that-differs-from-the-sorting-key
Формат
хочу создать remote табличку из PostgreSQL , у одного из полей такой формат данных , в PostgreSQL это называется interval
Описывая структуру таблицы , и понял что не знаю какой формат задать этому полю.
Подскажите , есть ли похожий формат в ClickHouseе , чтобы он не ругался на разные соответствия типов
Скорее всего обычный String, Clichouse не имеет сравнимый тип данных

а я правильно понимаю, что формат даты в стиле ‘YYYY-MM-DDTHH:MM:SSZ’ без трансформации DateTime не понимает ?
единственное поле, которое не дает мне сделать insert into format jsoneachrow
Параметр https://clickhouse.com/docs/en/operations/settings/settings#date_time_input_format
надо установить в best_effort
Пытаюсь clickhouse-driver питоновским выполнить INSERT INTO tbl FORMAT JSONEachRow и никак, все время получаю CANNOT_PARSE_QUOTED_STRING, хотя та же самая операция спокойно проходит через ch клиент из консоли. Что может быть не так ?
отказаться от ClickHouse driver и сделать через bash
Есть ли способ выводить дробные числа с фиксированным количеством знаков после запятой с сохранением формата Float?
Например, 4.2 -> 4.2000
SELECT toDecimal32(4.2, 4)

FORMAT CSV

SETTINGS output_format_decimal_trailing_zeros = 1

Query id: e148ffcc-0313-498b-a952-7e1dc35a2d9b

4.2000
Как можно сделать дату по ее формату?
Например toDate(10.01.23', 'd.m.y')?
select parseDateTimeBestEffort('31.01.23');
Есть таблица План, в которой в колонке Период строками записаны даты в формате '01.01.2022'. Хочу поменять тип со строк на даты.
SELECT toDate(Период) FROM План
Ругается:Code: 6. DB::Exception: Cannot parse string '01.12.2010' as Date: syntax error at position 8 (parsed just '01.12.20'): while executing 'FUNCTION toDate(Период :: 0) -> toDate(Период) Date : 1'.
select parseDateTimeBestEffort('01.12.2010');
делаю insert FORMAT TabSeparated, блок для вставки данных начинается со слова settings, из-за чего CH походу начинает это интерпретировать как некую команду и начинает ругаться:
Expected one of: SET query, compound identifier, list of elements, identifier. (SYNTAX_ERROR) (version 22.3.15.33 (official build))
Если использовать синтаксис без ключевого слова values, то есть смысл вставить перевод строки перед данными.
Подскажите, а откуда Clichouse пытается прочитать типы при загрузке из CSV?
У меня есть валидный csv файл, в котором количество колонок-хедеров соответствует количеству колонок в строках с данными. Но получаю вот такое
SELECT *

FROM file('/var/lib/clickhouse/user_files/test.csv', 'CSVWithNames')

LIMIT 2

Received exception from server (version 22.8.6):

Code: 117. DB::Exception: Received from localhost:9000. DB::Exception: The number of column names 96 differs with the number of types 93: Cannot extract table structure from CSVWithNames format file. You can specify the structure manually. (INCORRECT_DATA)
Ниоткуда, поэтому и предлагает указать руками
Коллеги, не нашел в настройках выгрузки csv из S3 указание кодировки. У меня в файле win1251, и кириллица поплыла, можно ли где то указать кодировку
Можно при загрузке данных в clickhouse воспользоваться convertCharset(s, from, to)
Как в клике можно быстро вставить большую csv?
https://clickhouse.com/docs/en/integrations/data-ingestion/insert-local-files
https://clickhouse.com/docs/en/integrations/data-formats/csv-tsv
как посмотреть текущий размер mark cache?
SELECT *, formatReadableSize(value)

FROM system.asynchronous_metrics

WHERE metric like '%Cach%'
Подскажите, а можно за один проход из таблички где есть
товар/номер заказа/сумма по строке
получить табличку сгруппированную следующим образом
Товар/Сумма по всем продажам товара/ сумма заказа(Полная сумма заказа)где этот товар участвовал?
https://fiddle.clickhouse.com/7d7e0226-0039-4f59-8edd-c35a14205866
date_time_input_format надо было прописывать в настройках при создании таблицы...
как экспортировать данные из ClickHouse с названием колонков, with headers не работает
WithNames?
https://clickhouse.com/docs/en/interfaces/formats/
Существует ли драйверв с поддержкой INSERT INTO tbl FORMAT JSONEachRow ?
Можно сделать через mysql. Подключаемся через insert into table format TabSeparated далее перевод строки и затем csv
Есть запрос, который возращает 2 столбца с массивами. Возможно ли создать новую таблицу, в которой колонками будут элементы первого массива, а значения колонок - элементы второго массива. Что-то вроде такого:
insert into test select * from

(

select

['tag1', 'tag2'],

['value1', 'value2']

)

format JSONCompactEachRowWithNames
В общем случае нельзя. В частном случае (на фиксированные имена колонок) - можно.
Есть такой жсон, что будет приходить на my_subject в NATS:
{

    id: 1,

    type: event,

    body: {

        elements: [

            {

                field_a: test1,

                field_b: 1,

                field_c: 2

            },

            {

                field_a: test2,

                field_b: 10,

                field_c: 20

            },

            {

                field_a: test3,

                field_b: 100,

                field_c: 200

            }

        ],

        total: 3

    }

}
Есть какая то такая табличка
CREATE TABLE events (

    field_a String,

    field_b Int64,

    field_c Int64

  ) ENGINE = NATS

    SETTINGS nats_url = 'localhost:4222',

             nats_subjects = 'my_subject',

             nats_format = 'JSON';
Можно ли сделать так, чтобы ClickHouse из жсона доставал массив [body][elements] и мапил объекты в массиве на строчки в таблице?
вытащить в массив, arrayJoin, JSONExtract, PIVOT
https://fiddle.clickhouse.com/06bcc1ca-3f31-4fd4-bc3a-15e13ca9cfcb
Ребят, короче такая история. Сижу туплю как сделать из
quantity | date
1 | 2022-01-01
3 | 2022-01-03
вот это:
quantity | date
1 | 2022-01-01
1 | 2022-01-02
3 | 2022-01-03
подскажет кто?
Сталкивался ли кто-то с типом hstore от PostgreSQL? Делаем импорт из источника постгрес базы и есть поле типа hstore. Сейчас оно импортируется как String, например,
А=>2400, PAN=>XXXXXXXXXXX67XX, RRN=>066842979174
Можно ли это привести, например, в json?
regex вам поможет. Ищите в документации функции extractAllGroupsHorizontal/Vertical. Там есть хороший пример как такие данные свернуть в удобную структуру
Вставляю данных из JSON. В таблице поле типа Дата, а в файле приходит Дата и Время, как сделать чтобы нормально парсилась дата?
Поменять в таблице поле на DateTime, либо sed'ом парсить и заменять в json на лету
SELECT toDateOrZero(JSONExtract('{date_time:2022-05-13T11:37:25}', 'date_time', 'String'))
Проблема с парсингом Decimal из json с массивом.
Но если парсить сначала в String, а потом переводить в Decimal, то работает
Это не баг?
ClickHouse-QA :) with ('[{index:517,amount:5.000000}]') as json

                     SELECT

                         JSONExtract(data, 'index', 'UInt32')                   as index,

                         JSONExtract(data, 'amount', 'Decimal64(9)')            as amount

                     FROM (

                              SELECT arrayJoin(JSONExtractArrayRaw(json)) as data);


WITH '[{index:517,amount:5.000000}]' AS json

SELECT

    JSONExtract(data, 'index', 'UInt32') AS index,

    JSONExtract(data, 'amount', 'Decimal64(9)') AS amount

FROM

(

    SELECT arrayJoin(JSONExtractArrayRaw(json)) AS data

)


Query id: 3e3120ba-58ce-4173-bbd0-4e24885d2d6c


┌─index─┬─amount─┐

│   517 │      0 │

└───────┴────────┘


1 row in set. Elapsed: 0.002 sec.


ClickHouse-QA :) with ('[{index:517,amount:5.000000}]') as json

                     SELECT JSONExtract(data, 'index', 'UInt32')                  as index,

                            toDecimal64(JSONExtract(data, 'amount', 'String'), 9) as amount

                     FROM (

                              SELECT arrayJoin(JSONExtractArrayRaw(json)) as data);


WITH '[{index:517,amount:5.000000}]' AS json

SELECT

    JSONExtract(data, 'index', 'UInt32') AS index,

    toDecimal64(JSONExtract(data, 'amount', 'String'), 9) AS amount

FROM

(

    SELECT arrayJoin(JSONExtractArrayRaw(json)) AS data

)


Query id: fbcf55a9-97c2-4b41-bf42-ded745a2bcfb


┌─index─┬─amount─┐
│   517 │      5 │
└───────┴────────┘


1 row in set. Elapsed: 0.002 sec.
Проблемы в версии, вы её не указали при отправке сообщения, на последней версии всё хорошо https://fiddle.clickhouse.com/47e012f2-8a0c-4188-9dc4-f6a6957674a5
Работа с данными
Надо к словарю подключить источник S3. Если такая реализация source в словаре ?
нет https://github.com/ClickHouse/ClickHouse/issues/39851
НО можно сделать view as select ... from s3( ) и прописать это вью как источник local словаря
Подскажите пожалуйста какой-нибудь источник по оптимизации запросов в клике? https://clickhouse.com/docs/en/guides/improving-query-performance/sparse-primary-indexes/
Запустил chroxy, подключился, в указанную папку для кэша на диск ничего не сохраняется, ошибок в процессе работы нет. В плагине grafana-clickhouse от Altinity отсутствует вариант выбора источника proxy как в документации, есть server и browser. Выбрано server. chproxy 1.21.0, plugin 2.5.3.
Надо указать имя кэша (longterm) в блоке users
Столкнулись с тем, что при добавлении WHERE с фильтром на одну из колонок типа DateTime рвётся соединение от CH к mysql (SQL Error [1000] [08000]: Poco::Exception. Code: 1000, e.code() = 2013, mysqlxx::Exception: Lost connection to MySQL server during query), воспроизвели на версиях 22.12.2.25 и 22.7.2.15 (прод + стенд для обкатки новых версий). При этом при использовании других колонок (в том числе того же типа) соединение не рвётся, при отсутствии фильтров вообще -- не рвётся, что колонка не nullable на обеих сторонах проверили, min-max на источнике в диапазоне 2021-2023, таймауты для table engine выставили в 300 (5 минут) какие нашли -- connection_wait_timeout, connect_timeout, read_write_timeout.
ну через tcpdump трафик снимите на clickhouse server в сторону mysql сервера на 3306 порт
а потом в wireshark
он умеет mysql смотреть
ну или pt-query-digect на снятый pcap натравить
вообще там простой алгоритм
все операции GROUP BY и ORDER BY делаются на стороне clickhouse
а в конечный запрос на MySQL
по максимуму стараются прокинуть WHERE условия, чтобы выбрать нужный кусок таблицы...
можно ли в ClickHouse из коробки лить данные прометеуса и потом их также анализировать в графане?
Посоветуйте, пожалуйста: создал таблицу с данными, в которой один столбец это сырой JSON, а остальные - MATERIALIZED - столбцы с JSONExtract-выражениями поверх этого json.
Что хочу - чтобы в запросах SELECT * FROM материализованные колонки отображались первыми в списке. Сначала они у меня совсем не отображались, но я нагуглил параметр asterisk_include_materialized_columns - теперь они отображаются, но после исходного не-материализованного столбца. Есть ли возможность, чтобы столбцы возвращались в порядке объявления, либо, мб, есть возможность вообще спрятать столбец из select * - запроса?
select * except (column) from ...
Откройте статью про select - там много интересного.
Но на вашем месте я бы попробовал новый тип JSON. Он пока экспериментальный, но у нас работает стабильно.
нужно использовать в Clichouse данные из postgres, но чтобы данные в materialized view в Clichouse обновлялись с учётом новых данных в postgres. По идее хорошо подходит MaterializedPostgreSQL и репликация postgres в КХ, но смущает, что этот функционал указан как экспериментальный. На сколько этот функционал готов к продакшену и есть ли какие то моменты, при которых не стоит его использовать?
Самое правильное в таком случае, это прочитать все ишью - https://github.com/ClickHouse/ClickHouse/search?q=MaterializedPostgreSQL...
Если все еще не страшно, то можно использовать.
Коллеги, нуждаюсь в совете
У меня есть таблица с тайм-сериес данными, например логами
Я их группирую с toStartOfInterval() и count()
Хочу найти такое время в котором нет значения — дырки в последовательном списке.
Придумал что можно сгенерировать список дат с numbers() по диапазону, от них взять такие же toStartOfInterval(), но дальше нужно как-то сджойнить два результата и в этом месте я уже теряюсь
Наверняка это не уникальная задача, вдруг вы сталкивались, подскажите пожалуйста
SELECT * FROM visits_missing_some_dts

ORDER BY dt ASC WITH FILL STEP 1
мув партиций это мнгновенная операция на метаданных или ресурсоемкая с копированием?
подскажите пожалуйста, в документации по clickhouse настройке пользователей, ролей и прочего, пишут, что использовать предпочтительно grants, такой вопрос, как через grants задать ip который может слушать сервер, чтобы отправлять с этого ip данные
Что-то нигде найти не могу, есть настройки в user.xml <ip></ip>, но как сделать через grants нигде не написано
ALTER USER user_name HOST IP '192.168.1.0/24'
Для интеграционного тестирования работы с ClickHouse хочется сравнить состояние базы после теста с ожидаемым. Будет ли работать побайтовое сравнение директории /var/lib/clickhouse/data/... ? Таблица Distributed, ClickHouse поднимается в докере. Спасибо
В distributed таблице ничего нет. Это прокси и очередь. И сама идея сравнения так себе. Если вам надо сравнивать данные то select ... except. Если ddl, то выковыривать тексты из system.tables и запускать diff
Можно ли выполнить произвольный запрос из CH в чужих движках баз данных?
Можно через dictionary. Но с ограничениями на условия вытекающие из логики обращения к словарям.
Умеет ли ClickHouse автоматически создавать таблицу, на основании данных из другой?В первой таблице есть колонка с текстом, во второй нужны колонки, получаемые путём парсинга текстовой колонки из первой таблицы
Можно попробовать через внешние функции это сделать
https://clickhouse.com/docs/ru/sql-reference/functions/#executable-user-defined-functions
Подскажите как оформить структуру данных.Раз в секунду приходит сообщение с небольшой текстовой строкой, записывается timestamp, отправляется в КХ.Но хранить требуется только те записи, когда строка, в сравнении с прошлым сообщением, изменилась.Как эффективно использовать ClickHouse в таком сценарии?
window view (проще до Clickhouse)
нужно ли пересоздавать MV после переименовки таблиц из которых берутся данные ?
да
Сжатие будет применяться только для новых данных таблицы?
Да
Такой вопрос тем кто углубляться в MaterializedView.
Он срабатывает на добавление данных в базы и обрабатывает только добавленные?
да
Подскажите можно ли взять часть данных из таблицы и изменить в них какую-то часть и добавить измененную копию? пример: есть несколько колонок, одна из которых дата, вытащить данные за определенное число, изменить дату и вернуть обратно.
insert into yourtable(...)
select ... from yourtable where ...
А какой самый простой способ добавить новую колонку с данными? У меня условно есть таблица, где для каждой строки по ключу понятно какое значение проставить.
Я хочу добавить это значение для каждой исторической строки. И при этом эта колонка не описывается SQL функциями (т.е. совсем новое значение :))
https://kb.altinity.com/altinity-kb-schema-design/backfill_column/
Можно ли вывести формулу, по которой можно достоверно точно по ключу шардирования определить номер шарда куда легли данные или лягут в дальшейнем?
если вы про запись в Distributed то вот тут всё описано
https://clickhouse.com/docs/en/engines/table-engines/special/distributed...
но вы можете реализовать свою схему шардирования на стороне приложения
на чтение из Distributed это никак не влияет
Есть необходимость удалить данные старше определенного периода.
Как лучше мне это делать?
Партиции у меня разбиты по дням.
Я могу сделать ALTER TABLE data DROP PARTITION '2020-11-21', но здесь я не могу указать перио
ALTER TABLE data DROP PARTITION '2020-11-21', DROP PARTITION '2020-11-22' ... и т.д.
запрос сгенерировать сами сможете?
если период до секунды то
ALTER TABLE data DELETE WHERE date BETWEEN '2020-11-01 00:00:00' AND '2020-11-21 23:59:59'
есть таблица с колонкой AggregateFunction(uniqExactIf). Можно ли как-то данные перегнать в таблицу с колонкой AggregateFunction(uniqCombined64If)? ClickHouse версии 20.4.4.18
теоретически да,
SELECT hex(uniqExactState(number))

FROM numbers(3)

Query id: b75b1349-162c-49fd-b21e-007bc3ce80a4

┌─hex(uniqExactState(number))────────────────────────┐

│ 03000000000000000001000000000000000200000000000000 │

└────────────────────────────────────────────────────┘
if -- вам не нужен кстати, он только мусорит
Может кто сталкивался с задачей на основании данных групировки вывести что-то похожее на словарь
да Tuple / Map
есть вопрос по хранению исторических данных, как их хранить понятно, как удалять старые данные? ну либо как хранить данные так чтоб удалить можно было пачку? может кто сталкивался с подобным. Кейс: храним историю заказа (флоу движения от покупки до доставки), данные актуальны пол года, дальше хранить неохота, сжирает много места, да и не зачем, может кто подскажет как в клике подобное можно организовать?
1. Сделайте партиции по месяцу и дропайте партиции.
2. Используйте TTL.
Можно ли сделать оконку поверх всех данных? без partition и group
можно, почему нет
select sum(x) over() from ...
Я аналитик и пишу для датаинженеров заготовку ETL скрипта на Клике.
Скрипт будет брать данные из нескольких таблиц и инсертить в витрину.
Вопрос вот в том как лучше мне организовать свою работу в клике?
И ниже я опишу почему свой вопрос я так сформулировал.
Раньше я писал процедуры в MSSQL и использовать темповые таблицы чтобы переиспользовать агрегированные данные несколько раз.
Здесь же на клике я использую DBEAVER , который подключается по порту 8123.
А скрипты пишу для дальнейшего использования в AIRFLOW, который будет подключаться, скорее всего, по порту 9000 питоновским драйвером.
И тут, мне кажется есть разница в работе наивного подключения и HTTP подключения.
Вот, к примеру, пишу я:
CREATE TEMPORARY TABLE IF NOT EXISTS t1 as
select …
Дальше отдельным запросом я могу сделать
Select * from t1
Могу сделать
DROP TABLE IF NOT EXISTS t1
А когда я пытаюсь запустить этот код вместе друг за другом? Как процедуру в MS, я получаю сообщение Multi-statements not allowed
B тут я не могу нагуглить:
Не то ли есть способ написать код, одинаково годный для запуска в DBEAVER и в AIRFLOW.
Не толи мне надо вести разработку в другой программе? В какой?
Помогите советом: Как соединить этот код в DBEAVER в единую процедуру?
CREATE TEMPORARY TABLE IF NOT EXISTS t1 as
select …;
Select * from t1;
DROP TABLE IF NOT EXISTS t1;
Подскажите другую программу.
Другой совет?
Поделитесь опытом кто как организовал подобную работу?
Заранее спасибо!
https://www.google.by/search?q=dbeaver+clickhouse+multi+statement+not+allowed
первая ссылка
https://github.com/dbeaver/dbeaver/issues/2244#issuecomment-333441954
Сейчас нашел только как через allow_databases ограничить доступ к одной базе и через filter прописать доступные данные по фильтру. а вот как оставить доступ только на одну конкретную таблицу, не нашел.
<databases>

<database_name>

<!-- filter all rows from table -->

<table1>

<filter>1 = 0</filter>

</table1>

</database_name>

</databases>
И придется для каждой таблички прописывать фильтры.
Возможно, кто-то подскажет.
В качестве буфера для накопления значений перед записью используется MySQL.
Там есть varchar(255) поле landing_id. В CH есть аналогичное поле landing_id, но с типом UInt8.
Возможно ли порча данных при таких типах столбцов?
В буфере, в строке имею значение 282 в landing_id, а при переносе в CH оно превращается в 26.
UInt8 - это восьмибитное число. Т.е. от 0 до 255
UInt8 — [0 : 255] 282-256=26
надо использовать минимум UInt16
пробую через ENGINE=Kafka загнать данные из kafka в ch. внутри кафка топиков json с вложеными полями. такое не будет работать ? везде просто вижу эксепшны, что в таблицах с engine kafka не поддерживается Object('json') как и в materialized view
можно из кафки забирать данные джисоном, а не по конкретным полям, я забирал их в виде строки, а после с помощью матвью обрабатывал эти строки как джисоны и извлекал нужные мне поля
А расскажите плз как работают буферные таблицы. Интересует момент рестарта CH… сбрасывается ли содержимое в файловую систему или же теряются данные из буферов?
Когда сервер останавливается с помощью DROP TABLE или DETACH TABLE, буферизованные данные также сбрасываются в целевую таблицу.
Подскажите как можно реализовать подобный сценарий для БД. Нужно в БД хранить только изменившиеся данные (это может определить провайдер данных), но при запросе за период нужно возвращать данных с заданным периодом (т.е недостающие данные необходимо интерполировать). Здесь самая загвозка в том, что клюем данных является колонка время/дата т.е значение не поменялась а дата/время должно тикать. Может есть уже решения?
https://clickhouse.com/docs/ru/sql-reference/statements/select/order-by/#orderby-with-fill
можно ли как-то в запросе Clickhouse, как-то внедрить подзапрос который отправляется в базу MySQL? Требуется для того чтобы данные внедрить в условие IN, а данные для этого условия хранится в MySQL
Можно создать таблицу на движке MySQL и делать запрос в неё.
Пример - SELECT id, date FROM default.table WHERE id IN(SELECT id FROM default.table2), где table2 - таблица на движке MySQL.
Либо вы можете сразу создать отдельную базу на движке MySQL и точно так же делать в неё запросы
если таблица небольшая в mysql, то можно сделать словарь, регулярно обновляющийся из данных из mysql
Можно ли хранить JSON объекты как отдельный тип данных?
https://clickhouse.com/docs/en/guides/developer/working-with-json/json-semi-structured
Это экспериментальная функция, иногда это ломает таблицу.
Подскажите, пожалуйста. Сколько приблизительно соединений держит нормально хост (около 96 ядер) на котором установлен только ClickHouse? Данные вставляются скриптом (используя JDBC драйвер) из других БД (не ClickHouse) которые расположены на других хостах (то есть на каждом таком хосте есть БД и скрипт и оттуда данные выбираются и вставляются в хост с ClickHouse).
соединений много 4096
но одновременных QUERY
по умолчанию 100
Отработает ли матвьюшка на сервере 2, когда данные с сервера 1 реплицируются на сервер 2? На обоих серверах и будет отрабатывать, у вас mv должно быть создано через TO
Если ClickHouse допустимо остановить, можно ли перенести его данные на другой сервер, перенеся саму папку с данными?
да, через https://clickhouse.com/docs/ru/sql-reference/statements/attach/
Нужна помощь в составлении запроса
Есть таблица, куда отправляются данные с таймстемпами. Колонки примерно такие:
provide_id, ts, value(bool)
Мне нужно составить такой запрос, который будет возвращать provide_id, если между его последними двумя записями прошло 10+ часов
Список всех возможных provider_id у меня есть и он не большой (до 15)
https://fiddle.clickhouse.com/5936dfda-bb91-4d2d-8ff2-9c60e53d01db
Есть таблица, куда отправляются данные с таймстемпами. Колонки примерно такие:
provider_id, device_id, ts
Задача такая: вывести две последние записи по каждому device_id в отсортированном по времени ts порядке по заранее известному провайдеру
Часть запроса я уже написал, но вышеуказанным требованиям он естественно не соответсвует
SELECT ts, device_id

FROM metrics

WHERE provider_id = '22222’

ORDER BY device_id, ts_int desc
SELECT ts, device_id

FROM metrics

WHERE provider_id = '22222’

ORDER BY ts_int desc

limit 2 by device_id
вот у меня есть таблица данных аналитики которая собирается с нескольких сотен вебсайтов.
У меня есть cube.dev с помощью которого я считаю, к примеру, число посетителей (группировка по столбцам siteId, host)
теперь я хочу считать топ-3 популярных url (столбец path) для каждого сайта.
я мог бы запрашивать данные по каждому сайту с помощью фильтра, но что-то мне подсказывает, что SQL и ClickHouse в том числе позволяет сделать это более оптимально, вернув в одном большом запросе необходимый мне top-3 популярных урлов. как это сделать?
пока что я увидел что можно делать группировку по timestamp с детализацией по дням, но это мне не совсем подходит.
ORDER BY url LIMIT 3 BY url
https://clickhouse.com/docs/en/sql-reference/statements/select/limit-by/#examples
подскажите как можно перелить данные с базы на базу есть может инструменты какие
Через DBeaver получилось без проблем. Нужно было разово один рас перелить
1. Являются ли ATTACH PARTITION FROM (и подобные) атомарными операциями?
2. При запросах выше будет сохраняться дедубликация блоков данных (скопированных) (как, например, для INSERT в Replicated таблиц)? Если да, то какой настройкой её конфигурировать? да атомарные, парты иммутабельные, при ATTACH PARTITION FROM парты копируются (через hardlink) в новуб таблицу. парты получают новые имена, но дедупликации блоков для репликации нет
это не INSERT
и для репликейтед таблиц, вместо репликации сначала будет пытаться теже самые парты аттачить на других репликах
но если там нет, то тогда уже будет replication data parts fetch
Источники
При работе с постгрес у меня есть удобный флаг для отображения логов запросов базы, но в кликхаус я не вижу возможность как увидеть логи.
использую docker-compose для контейнеризации базы, есть ли команда которая будет отображать запросы к кликхаусу ?
select * from system.query_log
Select * from system.processes
Show processlist
Запрос
Выполняю через DBeaver команду DELETE FROM hits_all WHERE Date = '2024-03-28'. При этом Update rows - 1, когда там под тысячи строк. Почему так?
1 - это количество операций, в данном случае операция удаления. Ch не показывает количество измененных строк.
Хотел узнать, как передавать в соединение через clickhouse_driver - библиотеку питона парамерт memory_usage? При обычном задании "SET max_memory_usage" пишет, что multi-statement queries are not allowed
Передайте через settings в конце
Как сделать чтобы в одном запросе выдать количество записей за
Сегодня
Вчера
Текущая неделя
Прошлая неделя
Текущий месяц
Прошлый месяц?
или другие какие-то определённые временные интервалы, на которые надо посчитать количество записей одним запросом
countIf(date >= x and date < y), countIf(date>=a and date< b)
Хотим хранить логи в кликхаусе, подскажите пару каммон кейс: 1) стоит ли использовать шардинг? Или репликации достаточно 2)еслм юзать шардинг, рандомный ключ шардирования? 3)на сколько понял, если таблица шардированая, нужно создавать на неё ещё distribute table, да? Спасибо
шарды нужны если у вас поток вставки в один не вмещается и запросами надо перелопачивать десятки терабайт
Делаю запрос
ALTER TABLE T MODIFY COLUMN C CODEC(NONE), запрос отрабатывают очень быстро и когда смотрю на размер колонки в сжатом и несжатом виде они разные. После OPTIMIZE TABLE FINAL кодек работает как надо, данные в сжатом и несжатом виде идентичные по размеру.
Все именно так и работает - быстрое изменение метаданных таблицы и запись новых данных с актуальным кодеком. OPTIMIZE TABLE FINAL перезаписали всю таблицу, поэтому и кодек поменялся.
У меня простейшая, на первый взгляд, задача в БД на две таблицы (три, третья, RESULT - для результата).
В одной таблице - телефонные номера списком (NUMS):
номер - ИНН собственника
Во второй - диапазоны номеров (FAS):
начало - конец - ИНН собственника
Нужно по факту эти две информации, данные в разных видах, сравнить и в результирующую таблицу положить номера, которые по второй таблице должны иметь один ИНН, а согласно первой имеют другой ИНН.
Не имея большого опыта с SQL я не придумал ничего лучше, как
1. пройтись по второй таблице и каждую строку преобразовать в запрос в первую:
INSERT INTO RESULT
SELECT
номер , ИНН
FROM NUMS
WHERE
NUMS.номер >= FAS.начало AND NUMS.номер <= FAS.конец
AND NUMS.ИНН <> FAS.ИНН
- вот эти все запросы скидываются в файл 1.sql
2. Файл 1.sql скармливается кликхаусу повторно, каждый запрос выполняется, наполняя таблицу результатов.
Такое вот порождающее программирование: из данных делаем код на первом шаге, на втором шаге этот код сами же и выполняем.
Есть ли какой-то вариант кэшировать результат СТЕ в параметризованном вью, чтобы при нескольких обращениях к нему не надо было всё заново вычитывать? или единственный вариант это уходить от мат вью и переделывать всё под параметризованный запрос с temp tables?
нет и вообще CTE - это просто include
Что-то не получается реализовать INSERT SELECT чтобы это все работало в асинхронном режиме.
Задача реализовать в рамках запроса.
1. создаем таблицу
2. вставляем из старой в новую
3. старую удаляем.
Если по-простому делать INSERT SELECT требуется очень много памяти для извлечения исходной таблицы.
Есть какие-то другие варианты без выгрузки данных с сервера внутри эффективно перелить таблицу.
ALTER не подходит, так как меняется сортировка и партиционирование.
Пробовал insert FORMAT select FORMAT и получил ошибки
QL Error [117] [07000]: Code: 117. DB::Exception: Expected end of line: (at row 1)
: Could not print diagnostic info because two last rows aren't in buffer (rare case)
: While executing WaitForAsyncInsert.
Экспортировать в файл. Затем импортировать из файла.
Подскажите, пожалуйста, как быть если в запросе матвьюшки левая таблица маленькая, а правая очень большая, тип джоина global right semi join? Как можно ускорить такие запросы?
МВ срабатывает только по левой таблице
JOINы в МВ - прямой путь к потери данных
У нас потребность переехать с Impala/hadoop на что-то простое и надежное. Уже были попытки внеднения clickhouse, но они были неуспешные в основном из-за осебенностей наших запросов к базе. Их много и переделывать долго/некому. Одна из проблем, которую я запомнил - ограничения where на вьюху не транслировались в исходный sql, т.о. select * from view1 where dt='2024-01-01' делала фулскан, а потом фильтровала по dt. Как сейчас с этим обстоят дела?
это называется WHERE PUSHDOWN. Оно работает теперь. Но сама по себе идея "переехать ничего не меняя" - ложная в своей основе. Лучше не стоит.
Как можно соединить две таблицы в один? Структура практически идентична за исключением одной колонки.
Таблицы дубликатов не имеют, одно продолжение другой. Пробовал через VIEW и union объеденить, но он просто напросто всё сканит и не подставляет введенные условия в сам запрос UNION.
Как можно добиться того, чтоб в union каждый запрос подхватывал условия заданную вьюхе?
predicate pushdown в views с union работает
вот простой пример
https://fiddle.clickhouse.com/b7c22e4a-9f52-47e0-bb6c-4cf955ef6f8b
Можете подсказать на сколько эффективен следующий сценарий в кх - есть табличка которая заполняется пачками условно большими по 5 минут каждая, и данные частично неструктурированные(ну поля с жсонами) и вот сейчас запросы с использованием таких полей уже стали медленными из за добавления логики в эти поля и в целом усложнения логики запроса. На сколько гуд - просто раз в день складывать в разложенном виде и там частично отфильтрованным в другую табличку инкрементально, увижу ли я дополнительно еще какой то прирост например по уплотнению файлов самой таблицы при insert as select за больший период времени (день)
в целом вполне себе работоспособный подход...
еще можете добавлять просто в основнуб таблицу поля типа field_name MATERIAZLIED JSONExtract...и выбирать по ним
union all при функции sum() может захватывать дублирующиеся строки?
Если у вас запрос, где есть select... union all select..., то для того, чтобы sum() считал сумму по обеим выборкам, вам надо сделать нечто вроде with cte as (select... union all select...,) и считать сумму от результата выборки, с группировками по необходимости.
Пытаюсь в Yandex Cloud Clickhouse -> сделать обычный INSERT INTO Table.ClickHouse
SELECT
field1,
field2
FROM file('s3.csv', CSV,
field1 Type1,
field2 Tipe2), получаю ошибку Not enough privileges. To execute this query, it's necessary to have the grant CREATE TEMPORARY TABLE, FILE ON *.*. (ACCESS_DENIED) .... запрос выполняю под админской учеткой, как у нее не может быть привилегий ? пробовал уже и нового пользователя создавать и грантить ему эти права на временные таблицы не помогло
делайте это в нативном клиенте
А еще вопрос есть касаемо библиотеки clickhouse_driver и его метода execute_iter()
Это для стриминга данных. Я правильно понимаю, что это стриминг со стороны кликхауса? Я имею ввиду - это поможет мне размазать нагрузку на сам клик, или это размазывание нагрузки именно на клиентской стороне и клик отдаёт всё равно всё сразу? Я тут видимо попутал что-то, но энивей - прошу помощи.
если у вас какой-то сложный group by/order by или join который жрёт память, то нет - не поможет, запрос надо сначала посчитать перед тем как можно стримить
если у вас простой селект, который можно читать кусочками, да поможет с потреблением памяти
Проблема в том, что у нас очень большое количество данных, которые хранятся на разных дисках. И что-то из доки не особо понял как поведет себя запрос с alter.
Может кто-то уже делал подобное? Можете поделиться опытом?
Лучше рядом сделать столбец, кинуть в него, проверить и дропнуть ненужное. LowCardinality займет сильно меньше места, проблем с этим быть не должно
Задумал поменять тип данных колонки String -> LowCardinality(String). Но опасаюсь, что что-то может пойти не так.
Проблема в том, что у нас очень большое количество данных, которые хранятся на разных дисках. И что-то из доки не особо понял как поведет себя запрос с alter.
Может кто-то уже делал подобное? Можете поделиться опытом?
Лучше рядом сделать столбец, кинуть в него, проверить и дропнуть ненужное. LowCardinality займет сильно меньше места, проблем с этим быть не должно
Вводные:
- кластер из двух реплик
- внутри kafka_engine c 80K сообщений в секунду, kafka_num_consumers = 8
- размер базы 1,5TB
Проблема:
Периодически дергают очень жирные запросы, которые кладут проц в потолок на одной из реплик, может 20-30 минут обрабатываться такой запрос. Пока одна из реплик курит запрос, в кафке начинает расти lag, ну и бывают прилетаю краткосрочно алерты типа Clickhouse have too many parts in one partition.
Собственно вопрос к знатокам. Есть ли варианты резервировать цп под kafka-consumers и процессы репликации? Ну или может совет какой-то, как реализовать правильно такую схему работы на двух репликах. Сам вижу вариант добавления дополнительных реплик, только на обработку запросов, но пока ограничен в ресурсах.
Последнее обычно и делают, как ни крути единственный нормальный выход.
Сливать на какой-то сервак со всех реплик под бекапы и аналитику
Почему при выполнении этого запроса я получаю несколько чисел?
Судя по всему для каждой реплики.
И как я могу получить просто количество шардов?
SELECT shardCount()
FROM cluster('cluster_1S_2R', system.clusters)
WHERE cluster = 'cluster_1S_2R';
просто прочитайте из system.clusters на любой ноде, без использования функции cluster
Есть ли возможность выполнить CH запрос против определнной ноды кластера?
Может, через settings как-то передать параметр или что-то вроде этого...
Можно воспользоваться remote, https://clickhouse.com/docs/en/sql-reference/table-functions/remote
https://clickhouse.com/docs/en/sql-reference/table-functions/remote
Есть задача: разрешить менять пользователям при запросе только некоторые settings. В доке прочитала, что в режиме readonly=1 можно добавить исключение через changeable_in_readonly, но оно дает послабление только для min/max settings. А мне нужно разрешить log_comment.
Нет ли способа установить white list при readonly=1, подскажите пожалуйста
Только то, что в списке ограничений можно сделать READONLY ну и квоты.
Добрый день, в managed клике есть настройка data_cache_max_size (по дефолту 1 гб) подскажите пожалуйста, он кэширует данные, или результаты запросов? Если диск позволяет, есть ли резон выкручивать его в 100 гб? Будет ли выигрыш или возможны побочные негативные эффекты?
это под данные из объектного хранилища Object Storage
Подскажите, пожалуйста, можно как-то в запросе select в секции where подготовить данные для условий?
Например у меня есть хеш, в нем массив. Надо проверить элементы массива по нескольим условиям. Можно сначала извлечь массив, а потом его проверять? среди полей запроса это массив не нужен. А, извините JSON. Вернее достаточно кривая строка, из которой надо вытащить json, из него по ключу массив, а с массивом работать уже.
Даже есть json нормальный, то все равно писать такое не хочется
JSONExtractArrayRaw(changes, 'some_id')[1] != 'null' AND
JSONExtractArrayRaw(changes, 'some_id')[2] > value1 AND
JSONExtractArrayRaw(changes, 'some_id')[3] < value2 AND ...
WITH JSONExtractArrayRaw(changes, 'some_id') AS some_id
SELECT ... FROM ... WHERE some_id[1] != 'null AND some_id[2] > value
В подобных запросах indexOf(code, 20) будет выполнен только один раз или для каждого выражения (даже если они полностью идентичны) этот индекс (или другие подобные функции) будет вычислен повторно?
WITH data AS (
SELECT
['str1', 'str2', 'str3'] as str,
[111, 222, 333] as num,
[10, 20, 30] as code
)
SELECT
COALESCE(
arrayElement(str, indexOf(code, 20))::Nullable(String),
arrayElement(num, indexOf(code, 20))::Nullable(String)
) result
FROM data;
Иными словами, имеет ли смысл выносить повторяющиеся выражения в отдельную колонку как тут (читаемость запроса не рассматривается как решающий фактор в моей задаче):
WITH data AS (
SELECT
['str1', 'str2', 'str3'] as str,
[111, 222, 333] as num,
[10, 20, 30] as code
)
SELECT
indexOf(code, 20) as idx,
COALESCE(
arrayElement(str, idx)::Nullable(String),
arrayElement(num, idx)::Nullable(String)
) result
FROM data;
Меня интересует для версии кх 22.2.2.1
Clickhouse сам оптимизирует запрос и выполнит код единожды
Как написать запрос? Нужно добавить колонку со временем: для action='block' время следующего action='unblock' этого же device_id
SELECT *
FROM values(
'device_id UInt32, event_at_local_tz DateTime, action String',
(366, '2024-04-20 07:27:22', 'block'),
(366, '2024-04-20 07:27:32', 'block'),
(569, '2024-04-20 11:14:10', 'unblock'),
(569, '2024-04-20 13:01:27', 'block'),
(569, '2024-04-20 14:14:19', 'unblock'),
(569, '2024-04-20 15:01:15', 'block'),
(569, '2024-04-20 16:18:19', 'unblock'))
minIf(event_at_local_tz, action = 'unblock') over( partition by device_id order by event_at_local_tz desc)
Подскажите, пожалуйста, с чем может быть связано
В dbeaver при запросе каждые 50-60 секунд запроса появляется такая плашка
Потом через время запрос слетает и пишет Connection refused: no further information
ну видимо запрос длинный... вам бы timeout выставить нормальный в настройках соединения…
Connection failed at try №1, reason: Code: 210. DB::NetException: I/O error: Broken pipe, while writing to socket
помогите, что подкрутить если это ошибка на большой запрос с подзапросом по шардам? Жирное тело, еррорит редко, но кажется какие-то таймауты я бы подкрутил (connect_timeout_with_failover_ms мб или это не имеет смысла?)
1 секунда по умолчанию... увеличьте до 10 Рис 139
важно в смысле надо обратить на это внимание... что может что-то сломаться...увеличивайте
Нужно выгрузить метрики САП (такие как время выполнения заданий, название итп) из БД ORACLE в Clikhouse. Как лучше это сделать? Сейчас дали какой то пример скрипта с абап программой, которая это делает на другом проекте. Но я не пойму зачем она нужна в моем случае, можно ли просто sql запросами это сделать в clickhouse?
подключите oracle через odbc
https://gist.github.com/Slach/9f9449a722091a13a9069b79f8dc7da7
и делайте на стороне clickhouse
INSERT INTO db.table SELECT ... FROM odbc(...)
Таблицы
Подскажите, как сослаться на вложенное поле при определении PARTITION BY/TTL для таблицы? Возможно ли это в принципе? В таком синтаксисе база кидает ошибку
Code: 47. DB::Exception: Missing columns: 'header.openedDateTime' while processing query: 'toDate(parseDateTimeBestEffortOrZero(header.openedDateTime))', required columns: 'header.openedDateTime' 'header.openedDateTime'. (UNKNOWN_IDENTIFIER) (version 23.3.19.32 (official build)). (UNKNOWN_IDENTIFIER) (version 23.3.19.32 (official build))
header.11
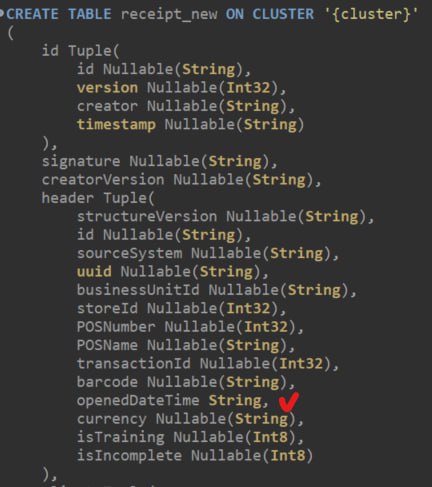
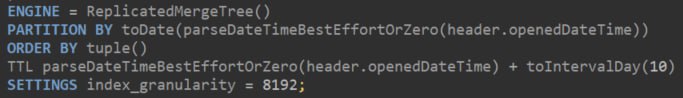
Подскажите: имеется таблица на движке Kafka, dest_table и MV их связывающий
Хочется изменить структуру MV. я же правильно понимаю, что для этого можно сделать:
1) drop MV
2) create MV (со всеми изменениями)
и при этом не будет никаких потерь данных, вне зависимости от того сколько времени прошло между шагами 1) и 2) ?
Верно. Когда дропаете MV, таблица Kafka ничего не вычитывает и не помечает записи в топике прочтенными. Потери данных могут быть, только если вы создадите MV через, скажем, 2 дня, а в топике время хранения записей - 1 день.
CREATE TABLE reg_agr2_load_log
(
*
*
*
)
ENGINE = MergeTree
ORDER BY load_time DESC
SQL Error [62] [07000]: Code: 62. DB::Exception: Syntax error: failed at position 269 ('DESC') (line 9, col 20): DESC. Expected one of: token, Dot, OR, AND, IS NOT DISTINCT FROM, IS NULL, IS NOT NULL, BETWEEN, NOT BETWEEN, LIKE, ILIKE, NOT LIKE, NOT ILIKE, REGEXP, IN, NOT IN, GLOBAL IN, GLOBAL NOT IN, MOD, DIV, PARTITION BY, PRIMARY KEY, SAMPLE BY, TTL, SETTINGS, EMPTY AS, AS, COMMENT, INTO OUTFILE, FORMAT, end of query. (SYNTAX_ERROR) (version 24.1.8.22 (official build))
Не подскажите, почему ввели запрет на
ORDER BY colname DESC в CREATE TABLE ?
можно обходиить это ограничение приводя дату к отрицательному числу
Есть ли в CLI CH что-то типа less?
хочу посмотреть одну таблицу show create обрезается, а при format Vertical уходит из буфера терминала
clickhouse-client --query="show create ...." | less
Подскажите плз как будет вести себя MATERIALIZED VIEW ENGINE = AggregatingMergeTree с SELECTом из таблицы REPLACING MERGE TREE. Что будет происходить в случае если в таблицу будут лететь не оптимизированные данные…
будет вставлять несколько раз в Aggregating
Replacing ничего не знает про Aggregating потому что MV это протсо триггер AFTER INSERT ...
Подскажите какой самый надежный способ дополнять данные в таблицу. Исходные данные лежат на s3. Предполагается что по триггеру когда новая порция данных будет готова она должна попасть в целевую таблицу. Хотелось бы убедить что данные будут записаны и в случае проблем избежать дублирования записи
Не вставляйте новые данные сразу в целевую таблицу. Вставляете в промежуточную (той-же структуры), а потом делайте ATTACH PARTITION. Эта операция атомарная. В случае неучачи - стираем все в промежуточной и пробуем снова.
А сработают ли при этом materialized view на целевую таблицу?
При ATTACH? Конечно нет. Но на временную - сработают. Но там будет такая-же проблема, так что придется аттачить все зависимые таблицы отдельно, что уже будет не очень транзакционно.
Так что если у вас развесистая структура MVs, то возможно лучше остаться на обычном INSERT, но сделать его идемпотентным. И не забыть включить deduplicate_blocks_in_dependent_materialized_views
Но для идемпотентности вам придется где-то хранить список файлов, которые вы взяли на S3 и попытались вставить. Нельзя ни в коем случае при переповторе добавить еще один свеже появившийся файлик.
Т.е. вы сами должны сделать что-то типа транзакции:
- проверить что сохраненный список файлов пуст
- взять список новых файлов
- сохранить список новых файлов
- сделать вставку
- удалить список новых файлов
Подскажите, пожалуйста, как лучше реализовать следующий кейс. Есть кластер из N шард. В него постоянно из Кафки загружаются данные по транзакциям равномерно распределены по шардам по хешу. Данных в день около 200 млн записей. Так же надо из Кафки забрирать данные по кастомерам их всего около 300 млн. Данные приходят как новые так и изменения поэтому используются таблицы ReplacingMergeTree. Для выборок по транзакциям сделана таблица дистрибутивная. Данные по транзакциям и по кастомерам надо джоинить для отчётов. Как лучше реализовать забор данных по кастомерам? распределять их по шардам на сколько я понимаю нет смысла. можно ли на их основе делать dictionary или это не будет работать ввиду большого количества записей? в какую сторону лучше смотреть?
Джойн - не очень приятная процедура для кликхауса, если использовать словари, то они должны гарантированно содержать уникальный ключ иметь приемлимый размер в озу, в противном случае вы получите не масштабируемую систему, при огромном количестве роста данных.
Использование словаря Direct, который не висит в памяти, может привести к замедлению производительности и ошибкам. Необходимо тестирование на Ваших данных.
Рассмотрите возможность использования инсерта из кафки с помощью Materialized вью, не большими партициами производите джойн при вставке.
для конкретной таблицы с Engine=Kafka нужно указать специфичные параметры аутентификации. это можно сделать в файле конфигурации
<yandex>
<named_collections>
<kafka_preset1>
<kafka_broker_list>...</kafka_broker_list>
<kafka_topic_list>foo.bar</kafka_topic_list>
<kafka_group_name>foo.bar.group</kafka_group_name>
<kafka>
<security_protocol>...</security_protocol>
<sasl_mechanism>...</sasl_mechanism>
<sasl_username>...</sasl_username>
<sasl_password>...</sasl_password>
<auto_offset_reset>smallest</auto_offset_reset>
<ssl_endpoint_identification_algorithm>https</ssl_endpoint_identification_algorithm>
<ssl_ca_location>probe</ssl_ca_location>
</kafka>
</kafka_preset1>
</named_collections>
</yandex>
Есть вопрос на счет mv, хочу повесить mv, который будет обновляться. Вопрос, правильно ли я делаю truncate отправлю на mergetree траблицу и делаю insert большой пакет данных, будет ли мой mv обновляться?
лучше DETACH/ATTACH после TRUNCATE на таблице MergeTree, то MV, который зависит от этой таблицы, не будет автоматически обновлён. Это связано с тем, что TRUNCATE удаляет все данные из таблицы, но не генерирует данные для потока изменений, который обычно используется для обновления MV.
можно через транк, но надо таблицу потрогать тогда чтобы обновилась вьюха это не всегда очевидно
Я правильно понимаю по этим данным что у меня всего один шард и две реплики?
И можно ли все таблицы называть репликами? Реплика это относительное понятие?
Такой вопрос возникает из строки replica_num
Да, в этом кластере один шард из двух реплик. Но реплицированных таблиц вы не создали.
Вероятно, про реплики лучше почитать какую-нибудь классику. Или, например, посмотреть видео конкретно про ClickHouse https://www.youtube.com/watch?v=4DlQ6sVKQaA В целом, для развертывания без понимания "что и как работает и как должно работать" у вас все замечательно.
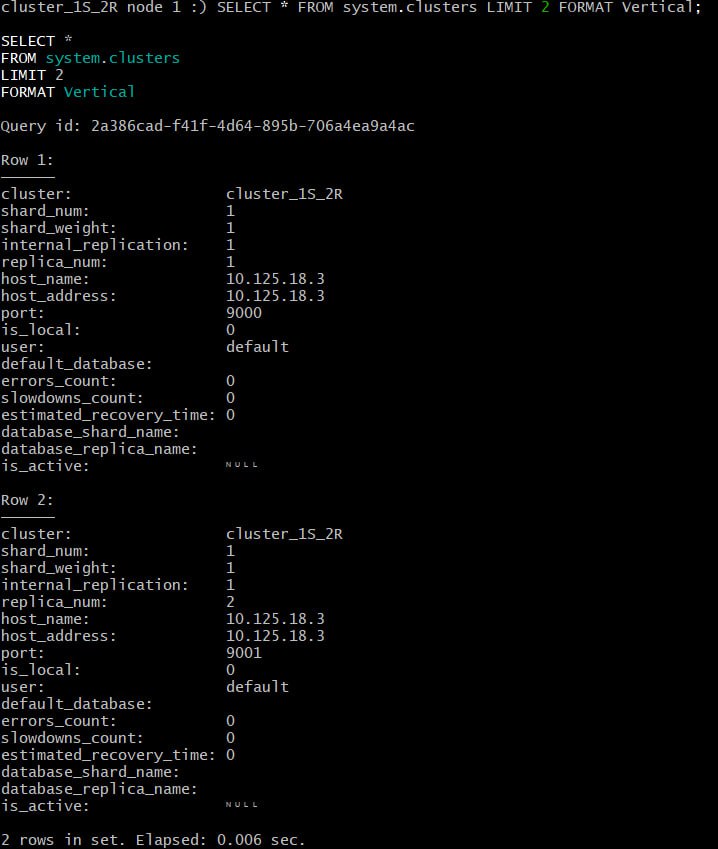
Подскажите, пожалуйста, почему может долго не схлопывает данные в таблице с движком ReplacingMergeTree? Может есть параметр который можно выставить, чтоб быстрее происходила дедубликация. Вчера смотрел, спустя 4 часа данные дедубликации еще не было. Если выполнить optimize table, то все ок сразу дедубликация происходит
Увы, но ответа на этот вопрос не существует. В офф. документации прямо написано, что процесс схлопывания не детерминирован и может произойти в любое время от секунды до хз когда...
https://clickhouse.com/docs/ru/engines/table-engines/mergetree-family/replacingmergetree
Не могу разобраться как правильно создать distributed таблицу..дано: на кластере 6 host_name (как я понимаю 6 нод)..мне нужно создать локальные таблицы на каждой из них, а потом на них направить distributed таблицу и в нее уже инсертить. Логика есть?
Таблицу на кластере
CREATE TABLE table ON CLUSTER
И таблица для вставки с
ENGINE = Distributed

Скажите, правильно я понимаю, что если в кластере один шард, то в distributed таблицах нет смысла, можно только сделать репликацию?
Конечно, дистрибьютед - это как раз распределенные по шардам
Всем привет, есть 2 диска, и таблица расположена на обоих дисках, как понять, сколько места она занимает на каждом из дисков ?
Через system.parts
Есть способы заставить при join’e local_table и remote не выбирать всю таблицу из remote?
Нет удаленная БД не знает про ваши ограничения в локальной
Мы можем как то указать базе данных, чтобы все таблицы в ней создавались на определенном диске ?
можно сделать отдельную storage_policy
но надо явно указывать явно
CREATE TABLE ...SETTINGS storage_policy=...
к сожалению, нельзя ее в profile прокинуть или сделать какие то настройки <merge_tree> только для какого то профиля...
Есть табличка my на одном инстансе, есть my-replicated на двух. Когда я делаю alter table my-replicated add partition xxx from my - у меня же не едут терабайты на второй инстанс? Но при этом count(*) на обоих одинаковый.
Подскажите, где магия?
терабайты не едут, но если у вас в partition гигабайты, то поедут эти гигабайты... вы там фактически регистрируете новый парт в replicated на инстансе
Подскажите, пожалуйста, как мне узнать на каких серверах и шардах сервера располагается конкретная таблица?
SELECT database, table, engine, hostName() h FROM clusterAllReplicas('cluster-name',system.tables)
Как можно сменить кластер в терминале? Ну, например, чтобы создать таблицу на определенном кластере
так можно же обратиться к кластеру (если он виден) create table on cluster (cluster_name)
Подскажите, если у меня в кластере из 2 реплик, одна отвалится на продолжительное время. При возвращении ее встрой, КХ перельет на нее все изменения из реплицированных таблиц? КХ развернут с использованием zookeeper. Мое представление что в зукипере будет храниться мета, что данные изменились, и при возвращении в строй измененные куски данные возьмутся с живой ноды.
Не нашел ответ в документации https://clickhouse.com/docs/ru/engines/table-engines/mergetree-family/re...
Да.
Подскажите, плиз, если создаешь таблицу таким образом CREATE TABLE ff2 (
name String,
age Int8,
height UInt8
)
ENGINE = MergeTree
PRIMARY KEY (height)
ORDER BY (height, name) - то в итоге п
DER BY ?
Ну да
Хотел бы посоветоваться: как безболезненно поменять ReplicatedMergeTree таблицу с одного пути в ZK на другой в рамках шарда внутри которого три реплики? для версии 23.8.5 ;) чтобы без read-only продолжая вставку или можно вставку остановить? именно, с сохранением возможности вставки по возможности.
так не получится... данные в ZK нельзя по новому пути перенести "тразакционно"...
максимум что можно это минимизировать время, когда вставка будет фейлиться...
Есть вопрос про Клик и кафку.
Есть два кластера кафки, в первом высоконагруженные топики (25-30ктпс), в другом и близко такого нет, буквально пара топиков по 200-300 тпс.
Клик настроен на вычитку из первого и вычитывает с очень приемлемым лагом, потерь нет.
Теперь добавляем в Клик через Kafka engine подключение к топикам на втором кластере (так же, как и к первому кластеру), но ошибаемся в аутентификации. В результате в логах видно, что:
1) Клик постоянно пытается переподключиться ко второму кластеру, отваливается, пишет сообщение (can't get assignment), опять пытается, опять отваливается, и т. д.
2) в это время резко падает скорость вычитки из первого кластера и начинается перевычитка (неоднократная вычитка данных), и дубли на вставке в таблицы, т. е. вычитано больше, чем реально уникальных данных лежит.
Так продолжалось, пока не детачнули сбойные топики на втором кластере. После этого вычитка с первого кластера пришла в норму.
Почему? Понимаю, что тут что-то связанное с ребалансом при переподключении, может быть, кто-то сможет сформулировать?
Количество потоков на работу с кафкой лимитировано пулом. В вашем случае часть потоков начала заниматься бесполезной работой, а не гонять данные
Не подскажите как настроить TTL для системной таблицы trace_log и metric_log? В доке нашел что надо в config.xml надо менять, но как именно TTL задать не понятно.
в config.d делаете xml файлы такого содержания
<?xml version="1.0"?>
<yandex>
<trace_log replace="1">
<database>system</database>
<table>trace_log</table>
<engine>ENGINE = MergeTree PARTITION BY (event_date)
ORDER BY (event_time)
TTL event_date + INTERVAL 14 DAY DELETE
</engine>
<flush_interval_milliseconds>7500</flush_interval_milliseconds>
</trace_log>
</yandex>
При импортировании csv файла выходит ошибка. Кто сможет помочь? Буду признателен! Error occurred during batch insert
(you can disable batch insert in order to skip particular rows).
Причина:
SQL Error [252] [07000]: Code: 252. DB::Exception: Too many partitions for single INSERT block (more than 100). The limit is controlled by 'max_partitions_per_insert_block' setting. Large number of partitions is a common misconception. It will lead to severe negative performance impact, including slow server startup, slow INSERT queries and slow SELECT queries. Recommended total number of partitions for a table is under 1000..10000. Please note, that partitioning is not intended to speed up SELECT queries (ORDER BY key is sufficient to make range queries fast). Partitions are intended for data manipulation (DROP PARTITION, etc). (TOO_MANY_PARTS) (version 24.3.2.23 (official build))
, server ClickHouseNode
Всего скорее слишком мелкие партиции в таблице, в большинстве случаев партиционирование не нужно, так что уберите либо укрупните размер партиций
У кого был опыт интеграции S3 и ClickHouse, подскажите, пожалуйста: при переносе ряда партиций в s3 чтение таблицы происходит в несколько раз медленнее. Это нормальная история? Можно ли с этим как-то бороться?
Очевидно же, что при прочих равных быстрее почитать с ssd локально, чем сходить за данными по сети, где они всё равно будут прочитаны с ssd. Нужно знать какая скорость чтения в локальной ФС, какая пропускная способность сети и с какой скоростью отдаёт данные S3. Тогда будет понятно, медленно это, или нет
Скажите пожалуйста если создаёшь ROW POLICY на определённую таблицу можно как-то сохранить права старым пользователям или необходимо на каждую группу пользователей писать политики заранее?
Создаю политику
CREATE ROW POLICY topic_policy ON analytics.web FOR SELECT USING kafka_topic = 'desktop' TO restrict_users
После этого делая show tables от имени сервисной учётки которая пишет в БД эта, таблица не отображается вовсе
По умолчанию всем все разрешено. Как только вы создадите одну запись считается, что всем все запрещено, помимо того, что вы указали. Так что добавляйте сами что нужно. Это указано в документации.
Подскажите, что используется для UI документации clickhouse?
Судя по примечаниям в коде, Docusaurus :
Попробовал убить тестово одну шарду из двух, во время большого Insert в общую Distributed таблицу.
Данные продолжили заливаться. Но доступна в итоге только половина если сделать селект. Что логично при ключе rand ()
Интересный момент в том что как только я подключаю обратно втору шарду данные на нее откуда то из первой заливаются и ничего таким образом не теряется.
На шарде живой есть какой то кеш до тех пор пока вторая шарда не оживет? И она его потом перекидывает?
Я именно о шардах, не репликах.
Нашел папочку интересную на той шарде что живая и там похоже ждут данные оживания второй шарды
store/1b6/1b640b46-40d0-4fc1-9239-4cbd65f82eee/shard2_all_replicas/
Если не указан ключ партиционирования, то таблица все равно будет разбита на партиции (судя по данным из system.parts). По какому принципу тогда будет разделение?
На парты она разобьются, а партиция будет одна
привет, подскажите Кликхаус быстро джойнит данные из таблицы AggMergeTree у которой ключ агрегации отличается от ключа по которому джойнятся поля в другую таблицу? Пример
CREATE TABLE t1
(
a String,
b String,
c String
)
ENGINE = AggregatingMergeTree
ORDER BY a
===============
LEFT JOIN t1 ON (t1.b = t2.b) AND (t1.c = t2.c)
У меня опасение что такой джойн может быть медленным та как клик начнет сексканить по двум поля b и с
Все гораздо хуже. Без WHERE он прочитает обе таблицы целиком. Почитайте вот эту серию статей для начала - https://clickhouse.com/blog/clickhouse-fully-supports-joins-how-to-choose-the-right-algorithm-part5
Есть ли какой-то способ глянуть сколько приходит строков в кликхаус
Мы очень много пишем в клик , но само собой в сотни разных таблиц
И встал вопрос оценить прирост кол-ва данных из месяца в месяц , можно ли как то грубо прикинуть ?
Чтоб не sql в каждую таблицу идти и счиать каунт за месяц последний
select sum(rows) from system.parts where active
Записываете количество и дату. Через N времени повторяете, вычисляете разницу)
Есть 1 кластер из 2 нод CH
Есть 2 таблички, к примеру
logs_real
logs_real_local
Удаление данных работает только посредством
alter table logs_real_local ON CLUSTER cluster_name DELETE where foo = 123;
Так оно удаляет всю инфу через заданный фитри на всем кластере но если я пробую
alter table logs_real ON CLUSTER cluster_name DELETE where foo = 123;
то выдает ошибку
SQL Error [48] [07000]: Code: 48. DB::Exception: There was an error on [1a.clickhouse.name:9000]: Code: 48. DB::Exception: Table engine Distributed doesn't support mutations. (NOT_IMPLEMENTED) (version 22.3.6.5 (official build)). (NOT_IMPLEMENTED) (version 22.3.6.5 (official build))
Все правильно. Distributed таблицы предназначены только для чтения и записи. Удалять надо из локальных таблиц с on cluster
Подскажите как сделать insert select из большой таблицы по партициям?
вот тут можно посмотреть. Там посложнее тема, потому как копируется с другого сервера, но суть таже самая. И оптимизации тоже.
вопрос: есть ли какой нибудь лайфхак в Clickhouse, чтоб в таблице всегда оставалась только первая запись по uuid, даже если поверх нее прилетит еще несколько c тем же uuid? не хочется делать select from where id in ()
грубо говоря аналог в Postgres INSERT INTO ... ON CONFLICT id DO NOTHING
CREATE TABLE only_first(
uuid UUID,
value String,
_time DateTime64 DEFAULT now64() EPHERMAL,
_version Int64 DEFAULT 0-toUInt64(_time)
) engine=ReplacingMergeTree(_version)
ORDER BY uuid
Можно ли во view изменить тип column от исходной таблицы? ну например переделать int в string ?
Конечно можно, приведение типа сделайте и все toString, например. Если создаете create view as select это легко.
Буквально недавно начал работу с ClickHouse, подскажите пожалуйста, бизнесово стоит задача вынести отчеты по заказам с разными параметрами из PostgreSQL в CH, так как текущая схема отчетности не очень удобная, инстансы PostgreSQL децентрализованы, локализованы по городам, для выгрузки отчетов приходится заходить на каждый сервер и вручную выгружать, также есть проблема с кучей JOIN-ов. Вопрос: как лучше создавать таблицы в CH, лучше сделать одну большую, с большим количеством колонок, либо перенести как есть и также выполнять JOIN, просто теперь все будет грубо говоря в одном месте. Как большое количество колонок отобразится на производительности CH? Спасибо за внимание и возможный ответ! Если есть какой-то полезный материал по этой теме, будьте добры, поделитесь пожалуйста)
Делать одну большую таблицу, на производительность не будет влиять почти
Есть задача - перевезти КХ кластер в новый ДЦ без даунтайма.
Если мы:
- добавим новые реплики в шарды.
- создадим таблицы на новых репликах.
- подождём синхронизации
- удалим старые реплики в старом ДЦ (не забываем про (SYSTEM DROP REPLICA)
Насколько такая схема жизнеспособна?
тут описано, как зукипер делать
Подскажите плиз, лежат в кафке такие массивы [{"id": 1, "name": "name1"}, {"id": 2, "name": "name2"}](имеется ввиду список словарей) как правильно это все распарсить движком kafka и залить в таблицу? обычно питоном разбиваю словарь, но сейчас нет возможности(
JSONEachRow сам с таким справляется, вставит несколько строчек.
Дополнительно
Для таблицы с движком distributed, zookeeper не используется?
нет, дистриб может быть хоть сверху Engine=не-реплицируемый
Python клиент clickhouse_connect выдает ошибку multi statement not allowed, подскажите плз кто сталкивался, каким способом оптимально мульти-стейтменты в клике запускать извне? Стейтмент создаёт несколько temp tables и по пути делает несколько inserts в таблицу логов, задействованы query parameters, запускать нужно в цикле для init загрузки данных. Спасибо!
можно попробовать в рамках одной сессии сделать. Особенно если через http.
Как вычислять date из datetime utc, если нужен операционный день?
Например:
01.04.2024 04:00:00 - 02.04.2024 03:59:59 - это операционный день 1 апреля.
SELECT if(toHour(operation_datetime_field)<4,toDate(operation_datetime_field) - INTERVAL 1 DAY, toDate(operation_datetime_field)) AS operational_day
Прошу подсказать - кто подключался из redash к Clickhouse как правильно коннект прописывали? Ошибка ""Connection error to: clickhouse://{host}:8123 (InvalidSchema)." Нашел issues только "Now Redash supports only http(s) connection and port 8123 is used for it. Try to change the scheme from clickhouse to https or http.", но в коннекте в Redash вообще не вижу, чтобы где-то задавалась scheme
Простой url напишите http с портом 8123. Вы используете ещё старую версию, тут ошибки не отображаются на новом клике, в новой версии уже отображаются
А есть ли какой-то надежный способ перебросить партиции средствами clickhouse (через freeeze rsync не хочется)?
А то отваливается по каким-то причинам и повторно уже не запустить.
xxxx :) ALTER table xxx.xxxx FETCH PARTITION ('2024-02-19',200) FROM '/clickhouse/tables/01/rtb/xxxx';
ALTER TABLE xxx.xxxx
FETCH PARTITION ('2024-02-19', 200) FROM '/clickhouse/tables/01/rtb/xxxx'
Query id: 88d54e43-bfe9-4e5f-ab77-dc3359d81957
0 rows in set. Elapsed: 4682.147 sec.
Received exception from server (version 23.8.11):
Code: 999. DB::Exception: Received from localhost:9000. Coordinatiion::Exception. Coordination::Exception: Session expired. (KEEPER_EXCEPTION)
там есть параметр в zookeeper секции конфигов называется session_timeout_ms и operation_timeout_ms посмотрите в доке
сейчас лтс последний релиз v24.3.2.23-lts, а стейбл v24.2.2.71-stable в лтс, судя по ченджлогу есть все фичи стейбл, но в стейбл нет фич лтс, хотя по идее они должны проходить через стейбл ветку... в связи с этим вопрос, какие все-таки релизы надо использовать для тестирования фич, а какие для стабильного прода?
отличие lts от stable просто в том что баг фиксы будут дольше выпускаться
а так каждый месяц новый релиз и раз в полгода один из этих релизов lts
stable - jan
stable - feb
lts - mar
stable - apr
...
stable - jul
lts - aug
stable - sep
…
А таблички system.text_log больше не существует,да?
Отдельно включить можно
Каким образом после импорта из одной бд в другую всех данных кол-во строк может уменьшится? Клик делает дедупликацию данных при импорте?
Сделайте select count() from table final :)
Слышал, что в кликахусе в map() появилась возможносто что value может быть нефиксированного типа, а такого типа какой положишь. это правда? если так то Не могу понять как кастовать такую мэпу тогда. подскажите ссылку на доку ищите в github по словам Variant и Dynamic
это все подготовка к замене JSON
Столкнулся с интересной проблемой.
Данные писать могу. И данные читаются.
Но df -h показывает следующее. Для примонтированного диска где я храню данные кликхауса:
Filesystem Size Used Avail Use% Mounted on
/dev/mapper/u01-u01 49T -61T 107T - /u01
Что-то не понимаю почему отрицательные значения
Ребята говорят что делали через lv.
На деле у меня диск общий обьем должен быть на 49Тб
И из него данные кх забито чутка 4Тб
это значение формируется из занятого и зарезервированного места, просто зарезервировало чуть больше, чем диск, попробуйте сократить резерв до 2% tune2fs -m 2 /dev/mapper/u01-u01
Вопрос про сторадж в click house и развертывание:
кх может хранить данные в себе - как бд
а можно ли развернуть кликхаус просто как надстройкак типо как hive на хадуп? то есть данные хранятся в др хранилище а сам клик хаус работает как быстрый движок?
Можно. Называется clickhouse-local. Но работает не так быстро, как хотелось бы - метадата в памяти все-таки помогает.
что поменять в настройках, что бы на сервере всегда любая DateTime была в UTC. сейчас при фильтре по дате Date(event_at) = '2024-04-04'::Date и потом группировке данных по toStartOfHour(event_at) в результатах вижу 2024-04-03 23:00:00... т.е. поправка на мой часовой пояс. если я на сервере запрошу поставить Utc или в настройках клика, чего будет достаточно?
Лучше тип поля сразу указывать в UTC - DateTime64(3, 'UTC'), тогда не будете зависеть от часового пояса сервера.
Коллеги можно сделать mv как distributed engine?
Нет, но судя по формулировке вопроса вы не ответ на задачу ищете, а уже придумали для себя решение и пытаетесь его теперь реализовать. напишите изначальную задачу - скорее всего решение будет
Подскажите, решил воспользоваться named collection и получаю ошибку нет привелегий при попытке создать. а этим кто-то пользуется или как прятать пароли от внешних db в клике?
Нужно в настройках сервера включать точнее можно прочитать тут https://clickhouse.com/docs/en/operations/access-rights#enabling-sql-user-mode
Ребят подскажите плиз как клик справляется с нагрузкой 10к селектов в пике в течение пары секунд, такое будет напимер 1-2 раза в день
Клиенты получат ошибку too many connections. Если это терпимо - оставьте как есть. Если надо их обслужить с задержкой - включайте queries queue сеттингом connection_pool_max_wait_ms
Подскажите можно ли при вставке записей из CSV изменить дефолтную вставку "0" в поле с типом UInt8?
("0" вставляется если вставляемое значение поля в CSV - пустое значение "")
namefield uint8 default
У нас используется экспериментальная refreshible materialized view.
Но каждый раз после перезапуска сервера отваливается настройка
SETTINGS allow_experimental_refreshable_materialized_view = 1;
и вьюха перестает обновляться.
Приходится дропать ее и создавать заново, что не очень хорошо.
Как это вылечить? куда смотреть что где прописать?
В папке config.d создайте файл с произвольным именем типа settings.xml, пропишите туда параметр
<clickhouse>
<settings> <allow_experimental_refreshable_materialized_view>true</allow_experimental_refreshable_materialized_view>
</settings>
</clickhouse>
Есть задача считать балансы через SummingMergeTree, но хочется избежать шанса двойного сложения при прочитывании сообщений из Кафки (допустим, продьюсер или консьюмер продублировали сообщение) Есть ли какой-то паттерн для таких случаев? Или summing mergee tree всегда неидемпотентен и нет возможности восстановить данные если вдруг в кафке продублировались сообщения?
Если надо все очень быстро и реал-тайм, то делайте exactly-once delivery от продюсера до консьюмера. Без этого не обойтись. Никаких дубликатов. Если задержка на 10-20 минут вас не беспокоит - сохраняйте в промежуточную MergeTree и читайте из нее.
Что лучше использовать zookeeper или clickhouse keeper? Деплою clikchouse через altinity operator. Лучше в плане надежнее, сейчас есть сомнения по поводу использование zookeeper, потом придется переезжать, а без даунтайма вроде бы это нельзя сделать.
Плюс зукипера - универсальность. В некоторых системах используется кластер зукипера, который обеспечивает репликацию не только клика, но и других компонентов системы. В этом случае использовать кипер избыточно и клик подключают к имеющемуся кластеру. Если репликация у вас в системе нужна только для клика, то вендор рекомедует использовать кипер, который уже идёт из коробки, обеспечивает более быструю репликацию и потребляет меньше ресурсов.
А если внешними средствами дёргать вставку, то какой подход лучше:
1. Ждать долго синхронного результата вставки большого количества данных
2. Предпринимать существенные усилия чтобы вставка была меньшими пачками
3. Не ждать синхронно результата вставки, а дёргать периодически query_log ?
1. Ждать долго синхронного результата вставки большого количества данных
2. Ждать, но в клик вставка очень быстрая большим батчем.
Возможно ли сделать селект из инфайла?
Хочу что-то такое -q "SELECT * FROM INFILE 'data.csv'" < data.csv
https://clickhouse.com/docs/en/sql-reference/table-functions/input такое решение подходит
Есть ли смысл использовать ключ сортировки, если он будет аналогичен партиционированию? Или в таком случае tuple() ограничиться?
Есть
Подскажите, пожалуйста, что по вашему опыту в ClickHouse быстрее работает, построчное хранение данных, или массивы?
колоночное хранение...
построчного там вообще в явном виде нет... есть компакт парты... но только пока у вас мелкие вставки...
Подскажите, можно ли в КХ сделать следующее:
1. Для каждой строки есть свое json-значение
2. Для каждой строки есть имя ключа из этого json
3. Необходимо вытащить value из json по ключу
При попытке это сделать через visitParamExtractRaw(json, param) ругается Argument at index 1 for function simpleJSONExtractRaw must be constant
А как то по-другому это можно сделать?
вот так сработало JSONExtract(json_column, key, 'String')
без 'String' - нет
А есть какой-то способ ребалансировать данные в кластере? Есть кластер из 6и шардов (0 реплик у каждого шарда), на первых двух шардах 70% данных, на остальных 4ех — 30% данных. Соответственно хотелось бы какой-то безболезненный способ это сделать, данных достаточно много, порядка 100млрд строк на этих двух больших шардах
Общепризнанного инструмента нет. Все работают на скриптах. Примерно так:
- чистите /detached folder от накопившегося мусора на всех шардах
- идете на переполненный шард,
- читаете system.parts и считаете что куда стоит перенести
- detach all selected parts
- scp .../db/table/detached/part dest_shard:....db/table/deached/
- attach parts on dest_shard
Вместо scp лучше использовать FETCH PART. Возможно, логика удаления парта на источнике будет чуть сложнее, а может быть и проще.
Подскажите пожалуйста, а команда BACKUP DATABASE не сохраняет вьюхи, да?
UPD: Сохраняет, но по какой-то причине они не восстановились из мета-информации
На сайте отдельной командой вызываются. Подробнее: https://clickhouse.com/docs/en/operations/backup
Подскажите, возможно ли при создании питоновской chDB задать default time zone?
У нас вся инфра в utc. Я в другой часовой зоне.
И вот по умолчанию chDB подхватывает часовой пояс моего ноутбука. Что неудобно.
Хочется, что бы мой chDB in memory как и вся инфра был в UTC
Если загрузка идет не через ваш ноутбук, то таймзона вашего ноутбука ни на что не влияет.
Возможно, вы не верно трактуете то, что показывает вам ваш клиент это можно задать у них в дискорде может быть нужно просто при введении данных задать желаемую таймзону.
Не совсем понял идею с WHERE, я итерируюсь через OFFSET + LIMIT, если LIMIT 1000, OFFSET 1000, то он прочитает 2000 строк от 0? Ваше предложение итерироваться по блокам ms_of_day внутри промежутков? WHERE ms_of_day > N AND ms_of_day < N?
Да, он прочитает 2000 строк. И чем дальше вы будете от начала, тем хуже.
В КХ надо итерировать по WHERE. Но У вас должна быть подходящая колонка и надо быть аккуратным с краями условия
Подскажите плиз, закончилось место на диске, хотел почистить данные DELETE FROM my_table WHERE created_at < date_sub(MONTH, 2, '2024-04-11'::timestamp );
Получаю ошибку Exception happened during execution of mutations 'mutation_16190300.txt, mutation_16190624.txt' with part '202404_15790551_15858430_97' reason: 'Code: 243. DB::Exception: Cannot reserve 1.71 GiB, not enough space. (NOT_ENOUGH_SPACE) (version 23.3.2.37 (official build)
Выходит, тривиальным способом не удалить?
Вы так не почистите место
delete это мутация, создается новый парт без тех данных, которые вы выбрали
сделайте через drop partition если это подходит
Сделал drop database DB_NAME;
бд пропала, но место на диске осталось занятым, как будто данные целы.
Подскажите как заставить кликхаус удалить это все с диска?
Нужно чуть-чуть подождать, чтобы освободилось
Вопрос: как-то можно это же сделать посредством create named collection? вроде, там синтаксис не подразумевает вложенные ключи.
Появилось в 24.2 (https://github.com/ClickHouse/ClickHouse/pull/59710)
Делаю группировку по toStartOfInterval(), но иногда данных нет и получаются пропуски. Есть ли эффективный способ генерировать “засечки”, даже, если данных нет и чтобы в них агрегировались нули, например? Спасибо.
ORDER BY time WITH FILL дальше в документации, найдете
Есть ли либа питоновская стабильная для чтения данных и записи потоково с кликхауса ?
clickhouse_driver
Подскажите пожалуйста, можно ли с помощью remote функции создать dictionary на определенной ноде кластера или просто выполнить sql?
Нет, DDL можно ток через ON CLUSTER
SELECT можно выполнить через функцию remote + view
Коллеги, ищу по чату и увидел что много у кого проблема есть, но не понял как решить. Ставлю consumer на kafka
<clickhouse>
<named_collections>
<primary_kafka_settings>
<kafka_broker_list>kafka.kafka:9092</kafka_broker_list>
<kafka>
<security_protocol>sasl_plaintext</security_protocol>
<sasl_mechanism>PLAIN</sasl_mechanism>
<sasl_username>username</sasl_username>
<sasl_password>password</sasl_password>
</kafka>
</primary_kafka_settings>
</named_collections>
</clickhouse>
В логах вижу следующую ошибку,
<Warning> StorageKafka (tasks_queue): sasl.kerberos.kinit.cmd configuration parameter is ignored.
<Warning> StorageKafka (tasks_queue): Can't get assignment. Will keep trying.
https://kb.altinity.com/altinity-kb-integrations/altinity-kb-kafka/altin...
Закрывает большинство Kafka провайдеров
Подскажите, как создать materialized view, если стандартный create materialized view ... populate as ... падает по памяти?
Достаточно ли делать несколько insert into .inner.xxxx SELECT ... например с фильтрацией по дате (вставить как бы несколько чанков)?
Я думаю видео вам поможет разобраться https://www.youtube.com/watch?v=1LVJ_WcLgF8&list=PLO3lfQbpDVI-hyw4MyqxEk3rDHw95SzxJ&t=7597s&ab_channel=ClickHouse
Подскажите пожалуйста, что это значит? В логе после перезапуска
<Information> DatabaseOrdinary (default): 70.85610200364299%
Это % подключенных партов, как помню.
Подскажите, а есть способ приостановить обновление словарей? Например по аналогии с system stop merges;
можно пересоздать словарь через CREATE OR REPLACE DICTIONARY db.dict_name
с большим LIFETIME
но однократная загрузка при этом все равно будет...
простите за нубский вопрос:
насколько плохо если в качестве ключа партиционирования использовано такое:
где tenant - это константа
PARTITION BY (
tenant,
toDate(timestamp)
)
?
Партиции это min max индекс в каждом парте чтобы делать partition pruning во время SELECT отсекая лишние данные от выборки парты из разных партиций не мержатся между собой во время background merges то есть если у вас 99% запросов содержит tenant и в каждом tenant там десятки миллионов записей... то имеет смысл PARTITION BY tenant сделать...в остальных случаях сделайте PARTITION BY toYYYYMM(timestamp) https://kb.altinity.com/engines/mergetree-table-engine-family/pick-keys/
Подскажите, куда можно посмотреть? Видим, что кластер Клика (наполнение вычиткой из кафки) при сохранении уровня входящей нагрузки и тех же настройках начал сыпать ошибками too_many_parts и (видимо, как следствие) сильно просела скорость вычитки. На графике Max Parts Count for partition видим, что раньше по каждой ноде была "пила" с максимумом в 300 parts, а сейчас там нормальные такие всплески до 400, 500, 600, которые быстро не снижаются. Рестарт кластера не помог. Параметры
min_insert_block_size_rows и min_insert_block_size_bytes дефолтные, 1млн и 268 Мб.
Куда имеет смысл копать?
Либо вы вставляете данные слишком часто (для engine kafka есть параметр; сколько раз в секунду?), либо у вас почему-то медленные мержи.
Возможно кто-то сталкивался с таким кейсом. Сейчас на проекте есть связка psql -> debezium -> clickhouse. Clickhouse стоит в единственном экземпляре(без репликации) и используется для поиска данных. Если clickhouse падает, то все данные теряются (для нас это ок). Сейчас написан костыль, который при старте clickhouse переливает данные на прямую из psql. Есть ли инструменты, которые помогу уйти от этого костыля, чтобы при старте cliclhouse он инициализировал данные из psql?
Я бы предложил поигратся.Мб сделайте фича реквест на вашу задачу проверить консистентность и перелить если что
https://github.com/Altinity/clickhouse-sink-connector
Подскажите плиз куда копать
SELECT arrayMap(tz -> toDate('2024-04-18', tz), ['Etc/GMT+12', 'Etc/GMT+11'])
Received exception from server (version 24.2.2):
Code: 44. DB::Exception: Received from localhost:9000. DB::Exception: Argument at index 1 for function toDate must be constant: while executing 'FUNCTION toDate('2024-04-18' :: 1, tz :: 0) -> toDate('2024-04-18', tz) Date : 2'. (ILLEGAL_COLUMN)
SELECT arrayMap(tz -> concat('2024-04-18 ', tz), ['Etc/GMT+12', 'Etc/GMT+11'])
OK
SELECT toDateTime(now(), 'Etc/GMT+12')
OK
ну строковая константа ожидается, потому что там один раз смещение считается во втором случае функция concat просто строки склеивает
в третьем случае у вас реально константа передается вторым параметром... единственная функция, которая поддерживает non-constant timezone это formatDateTime и toString
https://fiddle.clickhouse.com/46b4aa2b-ddc0-402a-8f3d-f0e121875305
А как можно сделать саггрегировать Bitmap в один большой Bitmap через OR?
Что-то типа SELECT bitmapOr(bitmapColumn) FROM table
Где table.bitmapColumn это значение типа Bitmap
groupBitmapOrState
А можете подсказать, сериализация и десериализация именно значений типов данных в Native и RowBinary форматах одинаковая? Т.е. в случае какого-нибудь отдельно взятого значения String, например, это в обоих форматах будет последовательность байт с префиксом длины в формате unsigned LEB128?
По-моему, в Native поедет сначала список длин строк, а потом - одним сплошным шматом сам контент строк.
Подскажите можно ли на MacOS поставить clickhouse-client без скачивания. самого сервера или не компилируя из исходников?
докер еще есть
Вопрос: для движка PostgreSQL есть ли какая-то опция, чтобы секция LIMIT отрабатывала на стороне Постгри, а не Клика? Кажется, что это что-то очевидное, но этого почему-то нет :(
Пришлось делать на стороне postgress вьшку c limit внутри
intersect работает в CH? вижу в документации он есть, но у меня в sql пишет ошибку при выполнении Syntax error: failed at position 298 (end of query) (line 9, col 10): . Expected one of: ALL, DISTINCT, SELECT query, subquery, possibly with UNION, SELECT subquery, SELECT query, WITH, FROM, SELECT, end of query. (SYNTAX_ERROR) (version 23.8.9.54 (official build))
документация билдится для текущего master возможно в 23.8 INSTERSECT нет сделайте простой пример на fiddle.clickhouse.com и поиграйтесь с версиями
как посмотреть тип возвращаемого значения в клике?
toTypeName()
Подскажите такой момент. Была версия 23.3. У нее опция http_max_field_value_size была по умолчанию 1048576 Обновились до 23.8, значение параметра поменялось на 131072 и стали ловить ошибку Field value too long. В описании релиза 23.8 явно прописано, что это важное изменение. Можно ли увеличить значение http_max_field_value_size и чем это может быть чревато? В документации не нашел описания параметра...
Что делать с проблемой неработающего TTL? читал, конечно, что отрезайте партициями...но все же?!?
посмотрите в system.parts
там есть поля, отвечающие за TTL
посмотрите, что в них рассчитано и как...
Как выключить аутентификацию по паролю? чтобы сразу заходил
Пустой пароль должен помочь
Дополнительно
есть 4 таблицы идентичных по структуре, надо во все выполнить одинаковый запрос запрос и вывести результат, как это можно реализовать? Пыталась гуглить всякие loop процедуры и т.п., но ничего подобного не нашла
Запрос по типу SELECT count(*) as $ FROM table_$. $ - в данном случае номер таблицы. Название всех таблиц содержит tablename_number
Merge table engine

merge table function
Подскажите работа neighbor() связана с partition - если select идет по нескольким - сложилось впечатление что в рамках partition выбираются только соседи? https://kb.altinity.com/altinity-kb-queries-and-syntax/lag-lead/
подскажите, https://hub.docker.com/r/clickhouse/clickhouse-server/#:~:text=How%20to%... эти скрипты сработают для образа или контейнера? /docker-entrypoint-initdb.d
это для контейнера
делаете скрипты для создания схемы
и через volume в контейней в /docker-entrypoint-initdb.d/ монтируете
исполняется при старте
подскажите, пожалуйста, где можно почитать про оптимизацию запросов на ClickHouse, какие-то особенности, которые именно относятся к этому движку
https://clickhouse.com/docs/en/optimize
попробуйте разобраться в чем разница между sorting key и primary key
и как работают data skip indexes
подскажите возможно ли в ClickHouseе использовать такую конструкцию?
SELECT case column_value_1 when column_value_1 LIKE ('%неизвестность%') then 'известность' else column_value_1 end ...?
При попытке использовать ругается так: First argument and elements of array of second argument of function transform must have compatible types: both numeric or both strings.: while executing 'FUNCTION caseWithExpression, кастуй в стринг/не кастуй, всё время вылезает
Тип в значения после then и после else должен совпадать
Подскажите, у меня есть таблица вида id, timestamp, val и id повторяются c разными timestamp. Мне нужно выбирать самую новую запись для каждого id. Нужно использовать MV? Записи в таблицу только добавляются и потом никак не меняются. Записи могут добавляться очень быстро.
select argMax(tuple(id, value) , timestamp) from table
добавлен tuple так как по условию нам нужно выбрать саму новую запись со значение, одного id мало)
Один clickhouse-operator может управлять разными инстансами Clickhouse (в разных namespace)?
да, https://github.com/Altinity/clickhouse-operator/issues/1064#issuecomment-1360930379
При смене мастера ZK все реплики во всех шардах сваливаются в RO пока мастер ZK не вернется на старую ноду. Может что-то в настройках надо поменять или версию CH обновить?
в новых версиях clickhouse 22.11+
есть
insert_keeper_max_retries=10 (пока не документировано)
На старых версиях по-другому сделать нельзя
А есть ли варианты чтобы CH при использовании движка POSTGRESQL брал логины/пароли из ENV?
https://clickhouse.com/docs/en/operations/named-collections/
как одним запросом убить все запросы в Clickhouse на текущий момент ?
KILL QUERY WHERE 1=1
подскажите что будет быстрее работать по функциям поиска, фильтрации, поиска уникальных значений как key,так и value - может кто то тестил или есть знающие люди поэтому поводу, работа с map(String, String) или array(tuple(String,String))
и то, и другое подтормаживать будет, потому что и там, и там под капотом массивы...
Ковыряю питон либу clickhouse-driver и не могу понять умеет она работать с http и портом 8123 или только 9000 и 9440?
Судя по параметрам, не умеет, там только флаги на секьюр и не секьюр, а порт какой не передаешь всегда пытается в TCP
Речь в вопросе идет о другом драйвере. Согласно документации, он умеет работать с портом 8123 для http протокола
https://clickhouse-driver.readthedocs.io/en/latest/
а есть какой-то правильный способ по определению порядка и количества полей сортировки? то есть, если будет поле А - 1000 значений и поле Б - 1м значений, я отсортирую табличку по А получу 30к гранул, а если по А и Б - 60к гранул. Как это связать с операциям IO, чтобы они не были бутылочным горлышком от слишком большого количества гранул? и будет ли фильтр по А работать одинаково с т.з. скорости в первом и втором случае без Б?
Если кинете видео или лекцией или статьей про поиск золотой середины - будут премного благодарен.
кол-во гранул зависит только от числа строк (index_granularity=8192)
Здравствуйте, у меня в таблице хранятся гео координаты (lat, lon) , как из таблицы получить все координаты лежащие в радиусе 1 км от заданной точки.? Честно с математикой у меня не очень, смотрю в доке на функции для работы с гео и ничего не понимаю.
SELECT

    ppl.user_id,

    ST_DISTANCE_SPHERE(POINT(lat, lon),

            POINT(lon, lat))  AS distance

FROM

    `mtytable` AS ppl

WHERE

  user_id  > 1

HAVING distance < 1000
это очень тяжелый запрос будет, не советуем его использовать
Возможно ли в конструкции ALTER USER foo ADD HOST IP каким-то образом указать массив IP адресов, вместо того, чтобы для добавления каждого IP делать отдельный ALTER USER?
Есть N юзеров и X IP в белом списке, хочется вызвать N альтеров, вместо N*X.
Можно. add host ip '192.168.1.1', ip '192.168.1.2'
ClickHouse научился делать multiple join или проблема ещё актуальна
SELECT *

FROM

    (SELECT 1 AS `column`) AS `T`

JOIN

    (SELECT 1 AS `column`) AS `T2` ON(`T2`.`column` = `T`.`column`)

LEFT JOIN

    (SELECT 2 AS `column`) AS `T3` ON(`T3`.`column` = `T`.`column`)
DB::Exception: default: Not enough privileges. To execute this query it's necessary to have grant SHOW USERS ON *.*. (ACCESS_DENIED) (version 22.6.7.7 (official build))
дать права на show users
А как можно узнать, в какой версии появилась та или иная функция? Например, age и date_diff?
найти коммит в котором добавили функцию и посмотреть в какие теги он включён. Это для тех, кто дружит с гитом. Для остальных чтение ченджлогов.
Фраза в документации Для таблиц должна быть задана одинаковая политика хранения (диск, на котором хранится партиция, должен быть доступен для обеих таблиц). намекает что копировать никто ничего не собирается.
КХ, когда порождает новый парт, обычно делает hardlink'и для всех файлов в парте. Так что эта операция не совсем атомарная, и не совсем на метаданных, однако достаточно быстрая.
lickhouse-server.log слишком большой. Даже в сжатом состоянии 100+Mb
что с этим лучше сделать?
Можно периодически его чистить или понизить уровень логгируемых событий.
скажите пожалуйста, для ip_trie не планируется в ближайшее время PRIMARY KEY по нескольким ключам(как у LAYOUT(COMPLEX_KEY_HASHED()))?
У ip_trie ключ это IP адрес сети. Какой смысл там делать какой-то другой ключ?
Подскажите пожалуйста - есть ли возможность в функции EXPLAIN Clichouse провести анализ сколько времени уходит на какую часть запроса?
На удаление вам надо TTL описать
При создании представления есть ли разница установить настройку join_use_nulls или делать для полей cast(field,’Nullable(Int32)’)?
почти нет. join_use_nulls иногда работает не так как хотелось бы https://github.com/ClickHouse/ClickHouse/issues?q=is%3Aissue+is%3Aopen+join_use_nulls
как в клике объединить два запроса в одну транзакцию?
В клике нет транзакций
Насколько эффективно ClickHouse сжимает строки с повторяющимся текстом? Блоки повторения от 5 до 700 символов
zstd хорошо сжимает.
вы можете сделать так
mycol String Codec(ZSTD(1)) или mycol String Codec(ZSTD(3))
1 быстро, 3 выше уровень компресии, макс уровень 22, но там будет очень медленно.
В таблице system.part_log постоянно вижу такого рода строки
event_type = NewPart

part_name = 202301_2696947_2696947_0

partition = 202301

path_on_disk = /opt/clickhouse-hdd/hdd/data/my_database/my_table/tmp_insert_202301_2696947_2696947_0/

error = 389
правильно ли я понимаю, что это логи дедупликации партов?
таблица если что реплицированная
да
Репозиторий по ссылке недоступен:
https://packages.clickhouse.com/deb/pool/stable
По адресу ссылки отображается сообщение: Not Found
перенесли в другое место https://packages.clickhouse.com/deb/pool/main/c/clickhouse-server/
Как удалить из базы повторяющиеся строки?
Есть большая база содержащая дату, хост, цифры.
Есть дупликаты полностью повторяющие близнецов
При потытке клонировать таблицу как
INSERT INTO table_clone SELECT date, fqdn, any(number) FROM table_orig GROUP BY date,fqdn;
сервер падает из-за нехватки памяти.
`Progress: 52.43 million rows, 5.71 GB (3.60 million rows/s., 391.45 MB/s.) (7.6 CPU, 43.45 GB RAM)
Code: 32. DB::Exception: Attempt to read after eof: while receiving packet from localhost:9000. (ATTEMPT_TO_READ_AFTER_EOF)`
https://stackoverflow.com/questions/71686567/how-to-delete-duplicate-rows-in-sql-clickhouse
а есть способ удалить по дате? если у меня datetime, потому что как я понимаю, лайк не работает с датой
where toDate(column) = '2023-01-01'
ну или column >= '2023-01-01 00:00:00' and column < '2023-01-02 00:00:00'. зачем там like вообще непонятно)
Существует ли какой-нибудь способ при вставке в PostgreSQL через функцию, движок таблицы, или движок бд, не важно, получить ON CONFLICT DO NOTHING?
Если хранить в ClickHouse очень длинные строки, каких проблем с производительностью стоит ожидать?
Пропопорционально объёму, если выборку делать по этому полю. Ну или почти нет, если в WHERE этого поля нет.
Подскажите, пожалуйста, а есть какая-нибудь документация для реализации такого?
select JSONExtract.... from http( . )
Не нашёл, как реализовать from http()
https://clickhouse.com/docs/en/sql-reference/table-functions/url/
при создании UDF - как потом посмотреть её DDL?
select *

from system.functions

where origin = 'SQLUserDefined'
Помогите разобраться почему у меня Clichouse вылетает?

Подскажите, пожалуйста, можно как-то для распределённой реплицированной таблицы проверить на каких машинах она ATTACHED, а на какие нет?
На некоторых могли отсоединять, а ходить по всем как-то муторно
Detached tables are not shown in system.tables.
Поэтому берете clusterAllReplicas, и считаете counts по всем своим таблицам. Если большинство таблиц приатачено правильно, то нехватка будет видна сразу.
как заполнить столбец из другой таблицы в ClickHouse?
INSERT INTO table1 ( column1 )

SELECT col1

FROM table2
как вывести название месяца на русском? Пробовал дописать 'Europe/Moscow'- не помогло
WITH toDateTime(now()) AS date_value

SELECT monthName(date_value);

monthName(date_value)|

---------------------+

January              |
никак, там в коде только на англ.
просто напишите [Янв, фев, март][month(date_value)]
Подскажите, пожалуйста, как/куда вынести пароль/пользователь для подключения к postgres engine.
Пример:
CREATE TABLE postgresql_db.postgresql_replica (key UInt64, value UInt64)

ENGINE = MaterializedPostgreSQL('postgres1:5432', 'postgres_database', 'postgresql_replica', 'postgres_user', 'postgres_password')

PRIMARY KEY key;
А в Clickhouse сейчас нужен рестарт для применения настроек или нет? ратио менялся
Подскажите, пожалуйста, почему может не работать
SET DEFAULT ROLE ALL TO user;
?
Я создал новую бд, выдал все права на нее роли и сделал роль DEFAULT для пользователя, но права у пользователя так и не появились.
Если сделать ALTER другим ролям, должно заработать
А подскажите пожалуйста, синтаксис нескольких with в кх: with... with. Не нашла в документации.
With l as (), l2 as (), ...
Select …
Подскажите. У меня есть запрос, который выводит две колонки. В одной из колонок массив. Можно ли его преобразовать в строки? Чтобы, например, если в колноке строки массив из 5 элементов, получилось на выходе 5 строк?
arrayJoin
есть ли возможность сделать SELECT * FROM 'table_name' переменной из другого запроса? где table_name список полученный другим запросом
За один раз не выйдет - в Clickhouse статическая компиляция кода, как в C++
Но можно через генерацию кода и повторную отправку на исполнение. Что-то типа такого:
clickhouse-client -q select 'select * from ' ';' from tables | clickhouse-client -mn
Ну или подобный трюк на каком-то шаблонном движке питона или golang.
Подскажите, можно ли при OPTIMIZE передать несколько partition_id?
Хотелось бы сделать что-то вроде
PARTITION ID in ('202202', '202203')
У таблицы:
PARTITION BY toYYYYMM(create_stamp)
Нет


по механизму действия ALTER TABLE MODIFY COLUMN, меняю кодек сжатия (устанавливаю) для одного из столбцов таблицы и не наблюдаю изменений в размере таблицы.
Когда срабатывает репликация то MaterializedView не тригерится?
не триггерится

Если не сложно подскажите почему не работает фильтрация на IN есть массив получен из запроса в CTE
https://fiddle.clickhouse.com/75e86d69-a65d-41d8-9424-6919f0b0125b
Received exception from server (version 22.12.3):

Code: 130. DB::Exception: Received from localhost:9000. DB::Exception: Array does not start with '[' character: while executing 'FUNCTION in(name : 0, users_arr :: 1) -> in(name, users_arr) UInt8 : 2'. (CANNOT_READ_ARRAY_FROM_TEXT)

(query: with

(select groupArray(name ) from users) as users_arr

select name from users where name in (users_arr);)
Более правильное решение
select name from users where name in (select name from users);
С использованием CTE:
with u as (select name from users) select * from users where name not in u;
У меня есть таблица на движке PostgreSQL и мне надо изменить пользователя postgres. Есть ли для этого какой-то синтаксис (без drop table и потом create table с новым паролем)?
https://clickhouse.com/docs/ru/operations/named-collections/
есть таблица событий
t1 (id,date)
итаблица событй1
t1 (id,date)
как событиям t1 приклеить события ближайшее более раннее событие t2
например
1, 2022-01-03
2, 2022-01-05
—
1, 2022-01-03
2, 2022-01-03
2, 2022-01-04
Должно дать
1, 2022-01-03, 1, 2022-01-01
2, 2022–01-05, 2, 2022-01-04
ON t1.id = t2.id and t1.date=t2.date
даст только одну запись
t1.date >=t2.date даст три записи
Asof join
возможен ли CamelCase в названиях таблиц и колонок? Какие проблемы или неудобства?
Никогда такой ерундой не занимался, а тут химические элементы подъехали и в lowercase выглядят убого
да возможен, это не мешает работе системы, но может сказаться на удобстве написания запросов
необходимо сделать индекс по DateTime, какой лучше выбрать? В таблице 80млн уникальных пользователей, DateTime - дата регистрации, ключ сортировки order by(user_id)
Для DateTime хорошо подходит min_max, т.к. это просто число. Но skip index это не тот индекс к которому вы скорее всего привыкли. Если user_id монотонно возрастающий и коррелирован с временем, то индекс будет работать, если же user_id - случайное число, то нет. Сделайте стандартное партиционирование по месяцам по этому времени, и на ваших 80М вам скорее всего будет более чем достаточно для приличной скорости запросов.
есть что-то для иерархий? вроде connect by prior в oracle или WITH RECURSIVE HIERARCHY, JOIN HIERARCHY в sybase?
Иерархические словари
из-за чего колонка written_rows из system.query_log в два раза больше реального значения? То есть встаявлеться 1 строка, а записывается как 2
там мусор хранится
distributed и matView умножают кол-во вставленных записей
если есть таблица
t (type Int32, value Unt64)
и если сделать по ней словарь
то как использовать для задачи
code in (select Value where type = 2)
или
JOIN t ON type = code?
второе вроде как просто в секцию from вставить dictGet(dict,type,code)
а первое?
https://fiddle.clickhouse.com/e8e8774e-253b-44fd-857a-f5648a66888f
задача выбрать только новичков
по старинке решается с подзапросом в котором для каждого идентификатора выбирается минимальнаа дата
Есть ли вClichouse способ покрасивее?
https://fiddle.clickhouse.com/d159b2f1-ba3e-4741-b1a2-925269fc2c8c
если новичок — это дата, то самое простое:
select * from t order by dt limit 1 by id
а есть ли у ClickHouseа аналог LEFT/RIGHT ?
substr
Подскажите пожалуйста как можно удалить секцию DEFAULT для колонки
alter table {table} modify column {column_name} REMOVE DEFAULT
я правильно понимаю команда OPTIMIZE не параллелится? утилизирует только 1 ядро
это сложный вопрос, мерж на одну партицию работает однопоточно, optimize с некоторых пор научился запускать несколько мержей на разные партиции, раньше было последовательно
можно ли смержить два стейта? Например два Uniq, чтобы получился общий Uniq?
из разных колонок что-ли? Откуда и в каком виде они приходят? Потому как если они идут в одной колонке, то все достаточно обычно - как это и задумывалось с -State and -Merge. Если же вдруг надо из разных колонок, то можно собрать в массив (или массивы) и применить к ним arayReduce:
arrayReduce('uniqMergeState',[col1,col2])
Использую kafka engine с mv в конечную таблицу(22.9.7.34). При парсинге json получаю: Code: 43. DB::Exception: Function JSONExtract doesn't support the return type schema: Date ... Подскажите, пожалуйста, где я могу посмотреть все типы, которые имеют поддержку. Может есть какая-то табличка соответствия. Спасибо
а ранее загруженные даные можно перекроить но новые партиции?
типа были месяц - надо перекроить на день?
или перезаливать надо?
можно скопировать внутри сервера. Но простой чудесной манипуляции нет
подскажите по вопросам:
1. наClichouse в yc планируем увеличить ресурсы. что приоритетно увеличивать - cpu, ram ?
понятно, что задачи у всех разные и вероятно сложно посоветовать, но может быть уже есть какие-нибудь бестпрактис ?
2. какие ключевые моменты в текущих/прогнозируемых задачах позволяют делать упор на cpu или ram ? На что стоит обратить внимание?
хост один, планируем увеличивать его мощность.
скорее RAM
вы посмотрите сколько в среднем CPU используется на текущем хосте
а есть вариант получить index, когда юзаешь hasSubstr ? Тоесть найти индекс с которого была найдена последовательность
position
пытаюсь запустить в докере Clickhouse и потом накатить миграции Python сркиптом
использую
from clickhouse_driver import Client
ch = Client(host='clickhouse', port=8123)
и вот такой docker-compose
version: '3'

services:

  clickhouse:

    image: yandex/clickhouse-server

    ports:

      - 8123:8123

    volumes:

      - ./clickhouse-data:/var/lib/clickhouse

      - ./config:/etc/clickhouse-server

    environment:

      - CLICKHOUSE_CONFIG_HTTP_PORT=8123

  migration:

    image: python:3.11-slim-buster

    volumes:

      - ./migration.py:/app/migration.py

    depends_on:

      - clickhouse

    command: sh -c '/usr/local/bin/python -m pip install --upgrade pip && pip3 install clickhouse-driver aioclickhouse asyncio && python3 /app/migration.py'
но при запуске оно упорно не хочет соеденяться и пишет
Failed to connect to clickhouse:8123
в config.xml есть такое
<listen_host>::</listen_host>
<listen_port>8123</listen_port>
clickhouse-driver же по tcp работает 9000 порт ( а не 8123 )
А проекции вообще не помогают ускорить order by?
не помогают, и не должны.
Помогите пожалуйста, голова уже кипит:
- объединяю таблицу саму с собой
- один из параметров ON должен содержать знак <
- но Click упорно не хочет его воспринимать, хотя в документации написано что этот способ рабочий. Аналогичный код в BQ отрабатывал норм (
Может есть еще какой нибудь вариант сджойнить по условию:
- t1.день = t2.день
- t1.время < t2.время
Джойн по неравенству, это ASOF JOIN в CH. Остальные работают по точному соответствию

подскажите пожалуйста почему работает такой запрос? Select f from table where f>'5' если поле f типа Uint16 . Про это можно в доке где то найти? Случаем не Си++ поведение?
видимо где-то конвертацию типов добавили, но как-то криво и неконсистентно
https://fiddle.clickhouse.com/9ca6328d-a5fa-48e4-8348-f9881dd98544
вообще это стандартное для ANSI SQL поведение, когда тип правого операнда (литерала) приводится к типу левого операнда ( колонки )
но только не помню для всех ли это операций ...
это никак не документировано нормально и лучше всегда явно либо конвертировать тип. либо задавать значения
скажем для DateTime нужно YYYY-MM-DD HH:II:SS а YYYY-MM-DD уже не подойдет...
подскажите пожалуйста можно ли одним запросом собрать все уникальные значения и количество каждого уникального?
SELECT column, COUNT() FROM table GROUP BY column
а что у Clickhouse с multiple OR on JOINs?
они есть https://clickhouse.com/docs/en/sql-reference/statements/select/join/#on-section-conditions
Пытаюсь агрегировать значение, но результат продолжает выдавать вместо общей суммы разбивку по категориям.
Как изменить поведение скрипта?
Суть скрипта:
2 запроса объединены по union all
С целью подсчитать поведение в приложении и на ПК.
Общих полей у них нет, поэтому объединила по union all.
Но теперь встал вопрос, как эти суммы сложить.
С помощью Sum + group by не получается.
Вместо 1 выдает 2 строки.
Select sum(поле) from (select ...ваш запрос объединения)
Через подзапрос получается.
в group by только поле дата, а числовые агрегируйте.
ON Section Conditions
An ON section can contain several conditions combined using the AND and OR operators. Conditions specifying join keys must refer both left and right tables and must use the equality operator. Other conditions may use other logical operators but they must refer either the left or the right table of a query.
ну вот либо я что-то не понимаю, либо это всё-таки баг
Вы можете сделать workaround (например, как там описано через full join). Можете поменять/упростить/усложнить ваш запрос, чтобы баг ушел. Я бы для начала попробовал сделать подзапрос, в котором вычислил бы все эти JSONs. Или же вы можете попробовать сделать тест кейс, и зарепортить его.
Пытаясь подружить ClickHouse с Airflow, но пока не понял какой коннектор использовать. JDBC? from airflow_clickhouse_plugin.operators.clickhouse_operator import ClickHouseOperator
Подскажите запрос чтобы узнать первичный ключ у таблицы
select database, name, sorting_key, primary_key from system.tables

where name=''
выберете нужное)
А можно ли как-то через users.xml дать пользователю доступ только к одной табличке, а ко всему остальному запретить?
Кто пользуется kafka engine подскажите, пожалуйста, на что при настройках обратить внимание. Да, можно почитать по ссылке
https://altinity.com/blog/2020/5/21/clickhouse-kafka-engine-tutorial
+kafka_thread_per_consumer
kafka_num_consumers
вопрос: можно ли как-то конвертировать array [x,y,z] в обычную колонку с рядами соответственно x,y,z ? Select-insert
clickhouse использует basic или digest авторизацию? Или это зависит от клиентского приложения?
может в basic auth
может по заголовкам
может отдельно по клиентским сертификатам авторизовать
может ldap
digest авторизация кажется есть только при коннекте из clickhouse в zookeeper но обычно там авторизацию вообще отключают
возможно ли использование скип индексов на materialized view таблице?
Дак там обычная таблица внутри
подскажите как удалить несколько таблиц\диктов\... из списка?
удаление таблиц(объектов бд) происходит через команду drop.
Подскажите, пожалуйста, аналог STRING_SPLIT из MsSQL для CH
splitByRegexp
Есть ли способы детально посмотреть, как происходит взаимодействие Clickhouse и MySQL сервера при использовании MySQL table engine / function? В частности, посмотреть отправляемый запрос.
насколько сильно проседает производительность при использовании restapi по отношению к нативному протоколу?
Вообще нет разницы почти, в некоторых случаях http быстрее
Возможно ли изменить kafka_topic_list для таблицы с kafka engine? Возможное решение:
DETACH TABLE materialized_view_from_engine_kafka;

ALTER TABLE kafka_engine_table MODIFY SETTINGS ...

ATTACH TABLE materialized_view_from_engine_kafka
Можно ли переменной allow_suspicious_low_cardinality_types задать значение через конфигурационный xml файл или только путём изменения через запрос в таблице system.settings?
/etc/clickhouse-server/users.d/allow_suspicious_low_cardinality_types.xml
<clickhouse>

  <profiles>

    <default>

      <allow_suspicious_low_cardinality_types>1</allow_suspicious_low_cardinality_types>

    </default>

  </profiles>

</clickhouse>
как можно изменить запрос в мат представлении. Структура не меняется.
удалить мв и создать новое
поддерживает ли кафка енджин offset latest or earliest - ?
https://clickhouse.com/docs/en/engines/table-engines/integrations/kafka#...
auto_offset_reset
https://github.com/confluentinc/librdkafka/blob/master/CONFIGURATION.md
значения тут
в auto.offset.reset
Почему последний запрос возвращает пустую строку, а не 'name2' (под каждым запросом на скрине напечатал его вывод)?
select extract('name2 asdf','(name1|name2)')
Регулярка неправильная

простите, это снова я со своим динамическим TTL, а можно как-то посмотреть, сколько осталось жить конкретной записи?
Например в таблице system.query_log стоит такой TTL event_date + toIntervalDay(7)
Тогда запросом можно проверить select event_date + toIntervalDay(7) <= now(),* from system.query_log limit 10
А подскажите пожалуйста, можно ли как-то clickhouse-local использовать из кода Python или PHP?
хочу делать запросы в .cvs файлах на S3
clickhouse-local - это же обычная консольная программа. Значит её можно запускать стандартными средствами Python/PHP. Например в Python можно использовать subprocess.check_output()
у меня задача хранить минимальный и максимальный dttm по транзакциям , и их каунт.
Имеется вот такой примерчик
https://fiddle.clickhouse.com/378c56d8-a6a5-4d81-8338-bf1d941dd0cc
Логика поступления строчек будет плюс минус такая же.
Не работает запрос
—-
with

    map(

        '0', [0,2,4,6,8],

        '1', [1,3,5,7,9])               as is_even,

    t1 as (

        SELECT  number                  as col1,

                toString(number%2)      as key

        FROM    numbers(10)

    ),

    t2 as (

        SELECT  number as col1

        FROM    numbers(10)

    )

select      col1,

            arrayFirst( (x) ->

                x in is_even[key],

                [col1])                 as rr

from        t2

left join   t1

    using   col1
-
https://fiddle.clickhouse.com/646b214b-ac83-48c0-8e1d-99b25ddbadd0
проявляется в функциях перебора массива только. Т.е. если просто сджойнить и вывести значение value из мапы по ключу, то всё ок
Замените in на функцию has
https://fiddle.clickhouse.com/0f567e24-1a57-47e8-b0c7-14b7845d0e4c


Есть replicated таблица. Есть два сервера.
И есть мат вьюшка на эту таблица.
На сервере 1 произошла вставка в эту таблицу.
какие есть удобные способы работать с ClickHouseом, если он запущен на локальном сервере?
Пробовал использовать tabix, не зашло, сыроватый дизайн, из консоли не удобно редактировать и писать запросы.
datagrip, но вообще есть
https://clickhouse.com/docs/en/interfaces/third-party/gui
CLI is OK, так как часть функционала, доступному CLI, интерфейсы могут не предоставить
Подскажите пожалуйста есть ли возможность в самом Clickhouse вызывать автоматический инсерт селект по времени? Например каждые 20 мин
Нет
Подскажите, пожалуйста, флаг is_frozen в таблице system.parts снимается сразу при выполнении unfreeze или после очередного мержа кусков?
Сделал freeze и unfreeze в system.parts вижу часть кусков с is_frozen=1 хотя в shadow/ пусто
is frozen не отражает реальность после unfreeze, но хардлинки на самом деле удаляются
https://github.com/ClickHouse/ClickHouse/issues/42404
у Clickhouse есть встроенное АПИ, чтобы можно было направлять json запросы?
нет, а к JSON-е будет звучать
select a, toUInt32(a) as b

from (

select * as a from system.numbers

)

order by a limit 1 by b
Есть реплика PostgresQL —> Clickhouse. Через MaterializedPostgreSQL.
Вопрос такой где и как можно смотреть состояние этой репликации? Активна она или нет?
Иногда случается, что она просто отваливается без причины будто. В логах что-то ничего по реплике, будто, не видно.
в логах /var/log/clickhouse-server/
но не всегда
Очень интересует вопрос неявных приведений на уровне where-clause запроса.
CREATE TABLE test_table (

    value Float32

);


SELECT value FROM test_table WHERE value > 1.1 ORDER BY value LIMIT 1;

-- Row 1:

-- ──────

-- value: 1.1
Насколько это очевидное поведение со стороны CH и как бороться с таким поведением? Только явные приведения типов?
да, в данном случае только явное приведение типов WHERE value > toFloat32(1.1)
1.1 это литерал, который по умолчанию float64
При джойне 2х табличек через left join, все поля в правой таблице, где я ожидаю увидеть null, заполняются пустыми строками
из-за этого не могу вспользоваться coalesce
Подскажите, пожалуйста, что нужно сделать
ver 22.8.12.45
SETTINGS join_use_nulls = 1
Простой вопрос, есть условия WHERE some IN (), <—— как здесь пустой список правильно указать? in (Null)
Подскажите, пожалуйста, а что будет быстрее работать:
Есть колонка (type: String), в ней лежат UUID
мне нужно приджойнить к ней другую таблицу, где такая же схема, как выше (джойн будет по колонке с UUID)
Мне лучше сначала переделать type: String -> type: UUID и потом джойнить, или забить и джойнить строки?
скорее всего UUID быстрее будет, тк строчка весит 32 байта, а UUID - 16
если я удаляю строки из таблицы с помощью alter table, очищается ли при этом проекция этой таблицы?
Эти должны очистится.
Delete производится через mutations и должен их зааффектить.
См. 43 слайд.
https://presentations.clickhouse.com/percona2021/projections.pdf
Подскажите пожалуйста по вопросу подключения в ClickHouseу
Нужно подключить инструмент к managed CH, и сделать это можно только через sqlalchemy
Ждет вот такую строку:
dialect+driver://username:password@host:port/database
Где взять ссылку я понимаю, но как правильно ввести dialect+driver?..
https://clickhouse-sqlalchemy.readthedocs.io/en/latest/connection.html#driver-options
Вопрос: Как перенести пользователей ClickHouse на новый сервер?
Ответ: Для переноса пользователей, ролей и прав можно использовать clickhouse-backup с параметрами RBAC и schema. После восстановления может потребоваться перезапуск сервера, чтобы RBAC из бэкапа применился корректно.
Вопрос: ALTER TABLE FREEZE блокирует таблицу при бэкапе ClickHouse?
Ответ: ALTER TABLE FREEZE создает hard links в директории shadow и не изменяет основную таблицу. Обычно это не блокирует рабочие данные, но может временно увеличить занимаемое место на диске.
Вопрос: Почему после DROP DATABASE в ClickHouse не освободилось место?
Ответ: Место может освобождаться не сразу, особенно если есть бэкапы, shadow-копии или фоновые процессы удаления. Стоит проверить директории shadow и backup, а для синхронного удаления использовать команды с SYNC там, где это применимо.
Вопрос: Как перенести схему ClickHouse на новый кластер?
Ответ: Один из вариантов — сделать бэкап только схемы через clickhouse-backup. Также можно получить CREATE TABLE из system.tables и выполнить эти выражения на новом сервере или реплике.
Вопрос: Можно ли бэкапить ClickHouse в S3 без явного access key и secret key?
Ответ: Да, в AWS можно использовать IAM role и передавать настройки через переменные окружения, доступные процессу clickhouse-server или инструменту резервного копирования.
- ClickHouse для новичков: введение, характеристики и начало работы
- Что такое Parquet: преимущества и случаи использования
- ETL и ELT: 5 основных отличий
- Что такое DWH и почему без них данные компании почти бесполезны


