

Antalya: архитектура LakeHouse на базе ClickHouse с Iceberg, Parquet и S3 - принципы, реализации и экономическая эффективность
Аннотация проекта Antalya: цели, контекст и ключевые преимущества
Проект Antalya представляет собой концепцию LakeHouse на базе СУБД ClickHouse, адаптированную под использование формата Iceberg в озерах данных и хранение данных в Parquet на объектном хранилище S3. Цель проекта - унифицировать рабочие нагрузки аналитики в реальном времени и работы с долговременным архивом через разделение вычислений и хранения, сохранив при этом бесшовный доступ к единым данным через единое SQL-API ClickHouse. Это позволяет одновременно поддерживать скорость точечных запросов и экономическую эффективность долговременного хранения.
Ключевые преимущества Antalya заключаются в нескольких взаимодополняющих эффектах. Во-первых, за счет миграции устаревших данных в Iceberg и использования Parquet на S3 достигается существенная экономия на хранении без потери согласованности доступности и управляемости данных. Во-вторых, разделение вычислений и хранения обеспечивает более гибкое масштабирование: горячие данные остаются в ClickHouse, cold-данные оборачиваются в Iceberg и читаются через параллельные вычислительные пайплайны. В-третьих, ускорение чтения параллельных Parquet-файлов достигается за счет кэширования метаданных Iceberg и самого Parquet-файла, а также за счет оптимизаций уровня запроса, таких как PREWHERE и Bloom-фильтры. Наконец, архитектура поддерживает потоковую загрузку и двойную запись в оба хранилища, что обеспечивает устойчивость и совместимость с различными потребителями данных.
Для специалистов по данным Antalya выступает как методическая база: она объясняет принципы организации LakeHouse-архитектуры на базе открытых форматов и предоставляет практические рекомендации по проектированию, внедрению и эксплуатации. В рамках проекта важно понимать целевые сценарии: от мониторинга логов и веб-аналитики до регуляторно-ориентированных задач и ML-пайплайнов, где объём обучающих данных растет быстрее скорости их обработки. В статье будут детально расписаны механизмы реализации, ограничения и экономический эффект, который достигается за счет сочетания Iceberg, Parquet и S3 в связке с ClickHouse и Swarm.
Стратегически Antalya руководствуется принципами современных LakeHouse-архитектур: единая логика доступа к данным, независимое масштабирование вычислений и хранения, управление метаданными через каталоги и эффективная поддержка потоковых нагрузок. Это позволяет организациям не только снизить совокупную стоимость владения, но и повысить скорость вывода аналитики, улучшить качество данных и ускорить внедрение ML-решений на базе больших объемов исторических данных.
Архитектурная парадигма LakeHouse на ClickHouse: Iceberg, Parquet и S3
LakeHouse объединяет лучшие свойства Data Lake и традиционных хранилищ данных. В контексте Antalya ключевыми компонентами выступают:
- Iceberg - открытый формат таблиц для озер данных, который обеспечивает оптимизированный метаданные-слой, поддержку крупномасштабных таблиц и эволюцию схем без разрушительных миграций. Iceberg позволяет выносить управляемые метаданные и статистику вне самой памяти рабочих узлов, что критично при росте объема данных.
- Parquet - колонночный файл-формат, ориентированный на эффективное сжатие и скоростное чтение больших наборов строк. Parquet хорошо сочетается с Iceberg как физическое хранилище файлов внутри озера.
- S3 - объектное хранилище на основе REST-интерфейсов, обеспечивающее масштабируемое, устойчивое и экономичное хранение данных. Iceberg хранит в своей каталожной структуре ссылки на файлы Parquet, лежащие в S3, а ClickHouse осуществляет быстрый доступ к данным через параллелизм и эффективные стратегии чтения.
На практике Iceberg выступает как внешний каталог и физическое представление таблиц, Parquet - как формат хранения, а S3 - как низкоуровневое хранение файлов. ClickHouse при этом обеспечивает высокую скорость SQL-запросов к горячим данным, а Iceberg через каталог задаёт контекст для чтения архивов. Взаимодействие между этими компонентами позволяет скачать одну и ту же таблицу в рамках единой аналитической абстракции: пользователю достаточно писать SQL-запрос через ClickHouse, не думая, где реально находятся данные - в Hot ClickHouse-таблицах или в Iceberg-таблицах на Iceberg-каталоге.
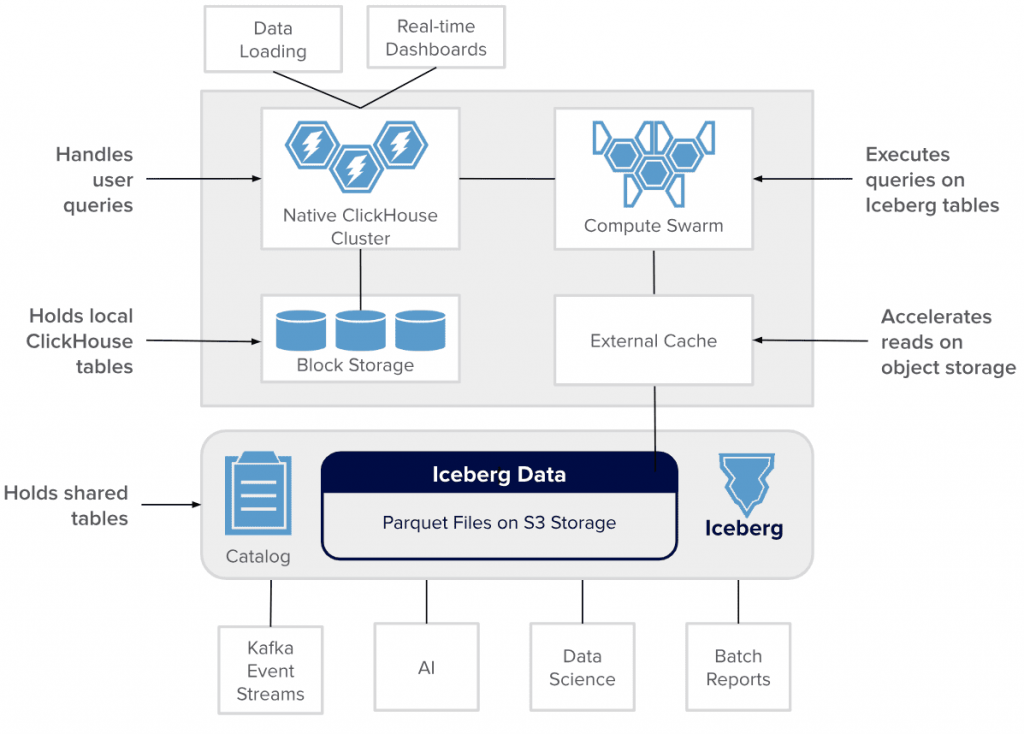
Такой подход разрешает противоречие между потребностью в мгновенной аналитике над активной лентой данных и необходимостью долговременного хранения, управляемого и экономичного. Он также облегчает миграцию устаревших данных без разрушения существующих рабочих нагрузок: пользователи видят одну таблицу, но физически данные хранятся на разных уровнях хранения, адаптированных под погодные требования времени жизни информации и частоту доступа.
В контексте реализации Antalya применяются следующие принципы:
- единое поведение SQL для доступа к горячим и холодным данным через ClickHouse;
- разделение путей чтения: быстрый путь к данным в ClickHouse и параллельные развёртки Iceberg для архивов;
- использование Iceberg-таблиц как ведущей архитектурной модели для долговременного хранения и облегчение горизонтального масштабирования;
- кэширование на уровне метаданных и файлов Parquet для снижения задержек и экономии на операциях в S3.
Эти принципы образуют основу архитектуры LakeHouse, которая одновременно упрощает эксплуатацию, обеспечивает устойчивость к росту данных и предоставляет возможности для ML-обработки на больших выборках.
Декомпозиция технических компонентов Antalya: Iceberg, Parquet, ClickHouse, Swarm и интеграции
Архитектура Antalya распознаёт роли каждого элемента и их взаимодействия в общую структуру. Ниже приведена детальная декомпозиция:
- Iceberg как каталог и формат хранения. Iceberg управляет метаданными таблиц, поддерживает эволюцию схем, разделение и параллельное чтение. Iceberg-таблицы хранятся в виде метаданных и ссылок на Parquet-файлы в S3, что обеспечивает устойчивость к изменениям схемы и масштабируемость при больших объёмах данных.
- Parquet как физический формат хранения. Parquet обеспечивает эффективную компрессию и быстрый доступ к столбцам, что критично для OLAP-нагрузок и ML-препроцессинга. Parquet-данные могут располагаться как в Iceberg, так и отдельно в S3, но чаще всего являются частью Iceberg-таблиц.
- ClickHouse как вычислительный движок. ClickHouse обеспечивает высокопроизводительные SQL-запросы к горячим данным и реализует концепцию частичного разделения вычислений. В Antalya ClickHouse выступает как фронтенд для анализа в реальном времени, в то время как Iceberg оборачивает архивные данные.
- Swarm как механизм распределённых вычислений. Docker Swarm обеспечивает stateless вычислительные узлы, которые можно масштабировать динамически. Swarm оборачивает чтение Parquet из S3 и ускоряет обработку за счёт кэширования и параллельного сканирования.
- Интеграции и каталоги. В основе интеграции лежит связка Iceberg-таблиц и ClickHouse-таблиц через схему каталога данных. Это позволяет ClickHouse читать метаданные Iceberg и корректно сопоставлять данные, независимо от того, где они физически расположены.
Уточним, что Swarm не ограничен только Iceberg-таблицами: он может сканировать любые Parquet-данные на S3, включая таблицы Hive и файлы Parquet с использованием подстановочных знаков. Это расширяет применимость Antalya к разнообразным источникам данных в экосистеме LakeHouse и подчеркивает гибкость конфигурации под конкретные требования бизнеса.
Взаимодействие между Iceberg, Parquet и ClickHouse имеет практическую форму: Iceberg предоставляет структурированное представление исторических данных, Parquet обеспечивает эффективное хранение и чтение внутри озера, а ClickHouse обеспечивает скорость анализа и доступ к данным через SQL. Swarm выступает как горизонтальный слой вычислений, который ускоряет загрузку и сканирование холодных данных и позволяет экономично использовать спотовые узлы без сохранения состояния между сессиями.
Механизмы ускорения чтения Parquet и масштабирование вычислений через Swarm
Ускорение чтения Parquet достигается за счёт нескольких взаимодополняющих механизмов. Во-первых, кэширование метаданных Iceberg на инициирующих узлах ClickHouse. Это снижает стоимость планирования запроса и уменьшает количество обращений к Iceberg-каталогу во время выполнения анализа. Во-вторых, Swarm-кластеры кэшируют блоки файлов Parquet и метаданные файлов в локальных кэшах, что позволяет снизить задержку доступа к данным, особенно при повторных запросах одного и того же набора данных. В-третьих, внешние HTTP-кэши, используемые для запросов к S3 API (например, ListObjects, GetObject), снижают сетевую нагрузку и задержку, сохраняя данные на уровне кэша и уменьшая количество повторных вызовов к объектному хранилищу.
Эти механизмы дополняются автоматическим масштабированием через стандартные инструменты Kubernetes. Узлы Swarm автоматически добавляются при росте загрузки и исчезают при снижении потребности, что обеспечивает эластичность инфраструктуры без постоянного перепланирования ресурсов. В контексте стоимости использование спотовых экземпляров является ключевым фактором экономии: Swarm может работать на спотовых ресурсах, что значительно снижает стоимость вычислений, особенно в условиях периодических пиков и повторяющихся запросов к большим объёмам данных.
Важно подчеркнуть, что ускорение чтения Parquet и масштабирование вычислений через Swarm не ограничиваются одним типом данных. Swarm способен обрабатывать любые Parquet-данные в S3, включая данные Hive-совместимых источников и прочие файлы Parquet с использованием подстановочных масок. Это расширяет спектр сценариев применения Antalya и позволяет централизованно управлять вычислениями без жесткой привязки к конкретному формату данных.
Таким образом, механизмы ускорения чтения Parquet и распределённого вычисления через Swarm - это не только технологические принципы, но и стратегический инструмент управления затратами. Ключевые эффекты включают сокращение задержек на уровне 90% и более, снижение затрат на облачное хранение за счет эффективного кэширования, а также возможность быстрого масштабирования инфраструктуры под растущие требования анализа и ML-нагрузок.
Многоуровневое хранение: миграция устаревших данных в Iceberg и экономия
Одной из центральных идей Antalya является многоуровневая архитектура хранения, которая разделяет горячие данные, используемые для оперативной аналитики в ClickHouse, и холодные данные, предназначенные для длительного архивирования и последующего анализа через Iceberg. Такой подход позволяет резко снизить стоимость владения, сохранив при этом непосредственный доступ к данным через единый SQL-интерфейс.
Механизм миграции устаревших данных в Iceberg реализуется с учётом следующих принципов:
- автоматизация перемещения: по мере истечения срока хранения, данных перемещают из рабочих таблиц ClickHouse в Iceberg-таблицы, сохраняя контрольную точку и метаданные миграции.
- консолидация данных: Iceberg-таблицы обеспечивают эффективное сжатие и агрегацию метаданных, что минимизирует размер архивов и упрощает управление версиями.
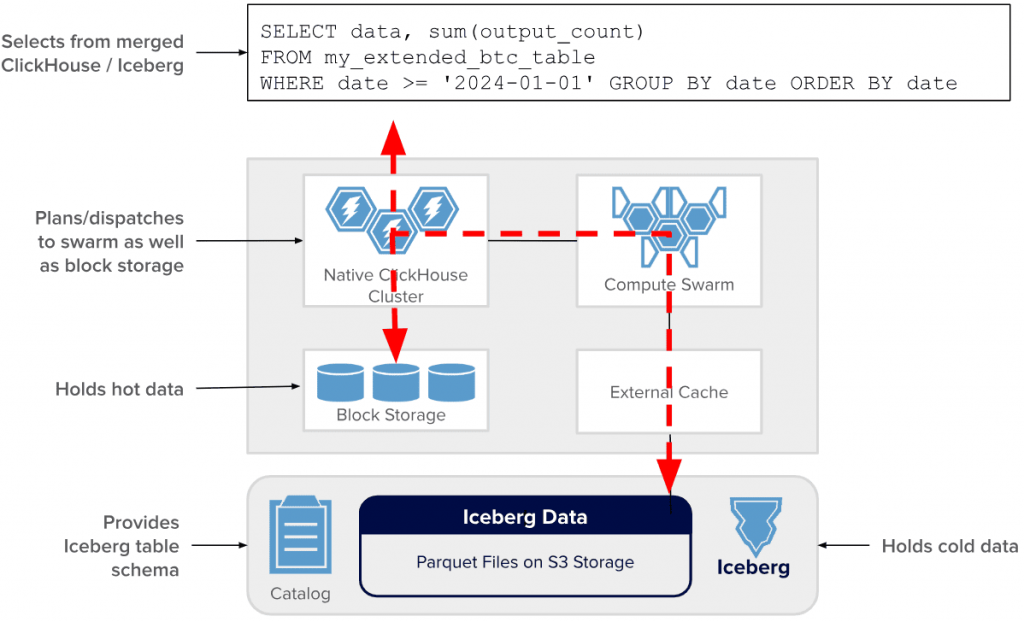
- единая видимость: пользователи продолжают работать через единое представление таблиц в ClickHouse, которое автоматически направляет запросы к горячим данным и при необходимости обращается к Iceberg-архивам.
- чтение обоих слоёв: запросы, затронувшие холодные данные Iceberg, обрабатываются через параллельные потоки Swarm и локальных кешей, что минимизирует задержку при доступе к архивам.
Эффект от такой миграции двоякий. Во-первых, экономическая эффективность возрастает за счёт снижения затрат на хранение: Iceberg на S3 обеспечивает меньшую стоимость хранения по сравнению с размещением полноценных MergeTree-таблиц ClickHouse в кластере. По данным проекта Antalya, стоимость хранения устаревших рядов может снижаться примерно в 10 раз. Во-вторых, многие запросы аналитики по-прежнему возвращаются в единый интерфейс, потому что данные доступны через однаковый SQL-путь к таблицам, без необходимости вручную переключаться между компонентами озера и хранилища.
Реализация многоуровневого хранения включает в себя:
- механизмы автоматизированной миграции данных между уровнями;
- кэширование политик доступа и метаданных на уровне Swarm и ClickHouse для ускорения повторных запросов;
- мониторинг и аудиторские трассы, фиксирующие перемещение данных и статус Iceberg-таблиц;
- поддержку churn-процессов, когда данные перемещаются обратно при изменении критических параметров хранения.
Таким образом, многоуровневое хранение в Antalya обеспечивает устойчивость к росту объёмов данных, позволяет держать горячие данные в оперативной памяти и ускорять доступ к архивам через Iceberg, при этом значительно снижая затраты на хранение и упрощая долговременную стратегию управления данными.
Интеграция метаданных и каталогов данных: взаимодействие Iceberg и ClickHouse
Ключевая задача интеграции Iceberg и ClickHouse состоит в обеспечении согласованного доступа к метаданным и физическим данным. Iceberg обеспечивает управляемый набор метаданных для озерных таблиц, включая схемы, разделы, версии и историю изменений. ClickHouse, в свою очередь, реализует эффективные исполняемые планы, параллельное выполнение запросов и богатые возможности SQL. Объединение этих возможностей достигается за счёт следующих процессов:
- каталог Iceberg как источник истины. ClickHouse читает Iceberg-каталог для определения структуры таблицы, столбцов и соответствующих Parquet-файлов на S3. Это позволяет работать с большими архивами как с единым логическим пространством.
- маппинг метаданных. В рамках интеграции метаданные Iceberg сопоставляются с метаданными ClickHouse: типы данных, разделы, версии и статистика таблицы синхронизируются для оптимизации планирования и выполнения запросов.
- единая точка доступа. В результате пользователи получают единое представление таблиц: независимо от того, какие данные расположены в горячем ClickHouse и какие - в Iceberg, запрос выполняется как единый аналитический сценарий.
- консистентность и версионность. Iceberg обеспечивает поддержку версий, что позволяет отслеживать эволюцию данных и восстанавливать ранние состояния без нарушения целостности текущих операций.
Интеграция Iceberg и ClickHouse требует продуманной стратегии каталогов и механизмов синхронизации, чтобы избежать рассинхронизации между metadatas и реальными данными. В Antalya эти механизмы реализованы через адаптивные коннекторы и кэш-слои, которые минимизируют сетевые задержки и позволяют ClickHouse быстро находить необходимые Parquet-файлы, независимо от того, где они физически хранятся. Результатом является эффективное комбинирование оперативной аналитики и долговременного хранения с минимальными задержками и единым интерфейсом доступа.
Оптимизации доступа к данным: Bloom-фильтры, PREWHERE и кэширование метаданных Parquet
Оптимизация доступа к данным в Antalya строится на нескольких взаимодополняющих техниках, направленных на снижение задержек и ускорение аналитики:
- Bloom-фильтры. В Parquet Bloom-фильтры позволяют быстро исключать нерелевантные блоки файлов и сокращать количество прочитанных данных. Это особенно важно при работе с очень большими наборами данных, когда фильтры по ключам позволяют значительно сузить объем сканирования.
- PREWHERE. В ClickHouse оператор PREWHERE позволяет заранее фильтровать данные до выполнения более сложных выражений в основной части запроса. Это снижает I/O и ускоряет выполнение, особенно для широких таблиц и больших выборок.
- кэширование метаданных Parquet. Кэширование файловых метаданных, таких как статистика столбцов и блоков Parquet, ускоряет планирование и чтение. Быстрый доступ к метаданным снижает задержку на старте выполнения запроса и уменьшает нагрузку на сетевые вызовы к S3.
- кэширование Iceberg-метаданных. В инициирующих узлах ClickHouse кэшируются ключевые блоки Iceberg-метаданных (таблица, разделы, версии), что уменьшает частоту обращения к Iceberg-каталогу и ускоряет чтение.
- внешние HTTP-кэши к S3. Для сокращения задержек при ListObjects и прочих вызовах к S3 применяются HTTP-кэши, которые уменьшают задержку и консумптивную стоимость доступа к объектному хранилищу.
Эти оптимизации совместно создают высокоэффективную среду для чтения больших Parquet-объёмов, делая возможной скорость, близкую к оперативной аналитике, даже при работе с архивами в Iceberg. В результате пользователи получают последовательный и предсказуемый отклик на запросы, а архитектура сохраняет экономическую целесообразность за счёт сокращения числа операций в S3 и уменьшения времени планирования запросов.
Потоки данных и загрузка: Kafka, топики, подписчики и двойная запись
Интеграция Antalya опирается на современные подходы к потоковым данным и их загрузке в аналитические хранилища. Основные принципы включают:
- потоковая передача через Kafka. Данные публикуются в топики (topics) Kafka и потребляются несколькими подписчиками, что обеспечивает параллельную загрузку в разные целевые хранилища.
- двойная запись. В рамках архитектуры допускается двойная запись: данные дублируются в ClickHouse и Iceberg-таблицы на озере данных. Это обеспечивает независимость потребителей, упрощает доступ и повышает устойчивость к сбоям.
- соотношение доставляемости и консистентности. Предпочтение отдается именно append-only сценариям, где новые события добавляются последовательно, чтобы минимизировать конфликты и упростить восстановление в случае сбоев.
- распределённая обработка. Swarm-подобные вычислительные кластеры читают Parquet-данные в реальном времени, что позволяет оперативно обрабатывать потоковые данные и поддерживать единое представление для аналитиков.
Эта модель потока данных обеспечивает широкие возможности для мониторинга, алертинга и ML-пайплайнов. Данные, поступающие через Kafka, становятся доступными для анализа в ClickHouse в режиме near real-time, а Iceberg хранит долгосрочную историю для последующего обучения моделей и ретроспективного анализа. Двойная запись обеспечивает надёжность и упрощает соответствие требованиям по регуляторному учету, сохраняя целостность данных независимо от того, какой слой используется конечным потребителем.
Append-Only режимы и консистентность данных между озером и хранилищем
Append-only режимы в Antalya поддерживают целостность и согласованность данных в условиях разделения вычислений и хранения. Этот режим характерен для непрерывного добавления новых записей без удаления или обновления существующих данных в исходном виде. В контексте LakeHouse это означает, что новые события добавляются в две параллельные траектории: в ClickHouse для оперативной аналитики и в Iceberg для архива и последующего ML-обучения.
Консистентность между озером и хранилищем достигается через синхронное и асинхронное взаимодействие слоев, а также через контроль версий Iceberg. Приемлемо использовать «мягкие» задержки между слоями: обновления в горячих таблицах отражаются в Iceberg через периодическую очередность миграций, а единая точка доступа к данным обеспечивает непрерывность анализа. В случае необходимости можно реализовывать политики tombstone-отметок и схему обновления, чтобы корректно обрабатывать удаление или изменение параметров без нарушения целостности данных.
Append-only режимы особенно эффективны в сценариях мониторинга и веб-аналитики, где потоковая природа событий требует немедленного добавления данных и устойчивости к избыточной загрузке. При правильной настройке они минимизируют риск рассинхронизации и упрощают аудит изменений, что особенно важно в регуляторных контекстах.
Инфраструктура и оркестрация: Swarm, Docker, Kubernetes и облачные шаблоны
Архитектура Antalya строится вокруг прочной инфраструктурной основы, где Swarm и Kubernetes работают в тандеме для обеспечения масштабируемости и управляемости. Основные элементы:
- Swarm как Stateless вычислительный слой. Узлы Swarm регистрируются по мере появления в кластере и исчезают по мере освобождения ресурсов. Это позволяет гибко масштабировать вычислительную мощность под нагрузку и эффективно использовать спотовые ресурсы для снижения затрат.
- Docker и контейнеризация. Swarm функционирует на контейнерах Docker, что обеспечивает переносимость и повторяемость окружения. Контейнеры упрощают развёртывание и обновление сервисов, таких как движки чтения Parquet, кэш-сервисы и адаптеры Iceberg.
- Kubernetes как оркестратор управления. Облачные шаблоны и автоматическое масштабирование в Kubernetes позволяют координировать развёртывание Swarm-узлов, мониторинг, логирование и обновления кластера. Это включает автоскейлинг по CPU/памяти, управление жизненным циклом подов и автоматическую регенерацию узлов.
- Облачные шаблоны и инфраструктурная автоматизация. Шаблоны развертывания поддерживают развертывание Antalya в любом месте: частном облаке, публичном облаке или гибридной среде. Это обеспечивает переносимость и облегчает миграцию существующих систем в LakeHouse-архитектуру.
Эта инфраструктура обладает адаптивностью: можно быстро увеличить вычислительную мощность для пиковых процессов анализа и ML-нагрузок, а затем вернуть ресурсы к базовым уровням, сохранив при этом целостность и доступность данных. Разумеется, для эффективного управления потребуются продуманные политики мониторинга, логирования и безопасности. Но в рамках Antalya стремление к предсказуемости, автоматизации и повторяемости окружения сохраняется на каждом этапе жизненного цикла проекта.
Разделение вычислений и хранения: принципы, реализация и влияние на стоимость
Ключевая идея Antalya состоит в разделении вычислений и хранения, что даёт возможность гибко масштабировать каждую часть независимо. Такой подход позволяет сохранить высокую скорость запросов, одновременно снижая затраты на хранение за счёт перехода исторических данных в Iceberg на S3 и использование Parquet как формата хранения.
Принципы реализации:
- разделение горячих данных в ClickHouse и холодных - Iceberg. Горячие данные обслуживаются оперативными запросами в ClickHouse, холодные - доступны через Iceberg и читаются при необходимости через Swarm.
- независимое масштабирование вычислений. Вычислительная мощность Swarm и ClickHouse может быть увеличена без пропорционального роста объема хранилища, что особенно важно для пакетной обработки и ML-циклов.
- экономия на хранении. Iceberg на S3 обеспечивает более низкую стоимость хранения по сравнению с полноценно реплицируемыми таблицами в ClickHouse. Миграция устаревших данных в Iceberg приводит к существенной экономии.
- унифицированный доступ. Пользователь видит одну таблицу через ClickHouse, а фактические данные могут находиться в нескольких слоях, что упрощает доступ и управление.
Влияние на стоимость выражается в снижении затрат на хранение (за счёт Iceberg) и на вычисления (за счёт распределённых, но дешёвых Swarm-узлов и возможности использования спотовых ресурсов). В сочетании с эффективной кэш-политикой, Bloom-фильтрами и PREWHERE эти преимущества становятся достаточно ощутимыми для крупных аналитических инфраструктур, работающих с широкими таблицами и высокими скоростями.
Производительность и использование для реального времени и ML
Архитектура Antalya ориентирована на задачи реального времени и машинного обучения, где важны как скорость отклика, так и объём обучающих данных. Ниже приведены ключевые особенности производительности:
- параллелизм внутри ClickHouse. Мощности ClickHouse используются для параллельной обработки и быстрого ответа на запросы, особенно для широких таблиц и агрегаций.
- ускорение чтения Parquet. Swarm-узлы эффективно читают Parquet-файлы, распараллеливая обработку и минимизируя задержки. Кэширование блоков Parquet и метаданных позволяет быстро разворачивать данные при повторном доступе.
- оптимизационная работа со старыми данными. Iceberg обеспечивает эффективное чтение архивов без значительной задержки, благодаря индексации и эффективной структуре метаданных.
- поддержка ML-пайплайнов. Наличие единообразного доступа к данным и возможность быстро извлекать обучающие выборки из Iceberg-архивов позволяют строить и обучать модели на больших наборах данных, не теряя скорости анализа.
- реальная временная аналитика и мониторинг. Архитектура поддерживает сценарии мониторинга в реальном времени, агрегации и дашбордов с минимальными задержками, что критично для оперативной реакции на события.
Стратегический эффект состоит в том, что архитектура обеспечивает баланс между скоростью анализа и экономической эффективностью при работе с большими данными и ML-нагрузками. Реальное время достигается за счёт параллелизма и кэширования, а ML-проектам предоставляется доступ к крупным историческим наборам данных без травмирующей задержки при загрузке и обработке.
Примеры сценариев применения: мониторинг логов и веб-аналитика
Анталия находит широкие применения в сценариях мониторинга и веб-аналитики благодаря сочетанию скорости и экономичности. Ниже приведены два типовых кейса:
- мониторинг логов. В реальном времени собираются логи с многочисленных источников через Kafka. Данные попадают в ClickHouse для быстрого анализа и дашбордов, а устаревшие логи периодически мигрируют в Iceberg на S3. В запросах используются Bloom-фильтры и PREWHERE для эффективной фильтрации по временным окнам и ключам. Это позволяет оперативно обнаруживать аномалии и генерировать оповещения.
- веб-аналитика. Пиковые потоки авиалиний пользователей и кликов требуют быстрых агрегаций и построения коэффициентов конверсии. Горячие данные обрабатываются в ClickHouse, тогда как исторические данные для ретроспективного анализа и ML-обучения хранятся в Iceberg. Архивирование позволяет сохранять точность и полноту анализа без перегрузки вычислительных кластеров.
Эти сценарии демонстрируют, как Antalya повышает скорость доступа к данным и одновременно снижает издержки на хранение и вычисления. В рамках аналитических процессов можно эффективно комбинировать оперативную аналитику и долговременную оценку трендов и моделей на одной и той же базе данных, не прибегая к сложным ETL-процессам между слоями.
Экономика проекта: снижение затрат на хранение и вычисления
Экономическая эффективность Antalya достигается за счёт нескольких факторов:
- снижение затрат на хранение на порядок. Iceberg на S3 и Parquet позволяют уменьшить стоимость хранения исторических данных, поскольку Iceberg оптимизирует хранение и обеспечивает эффективную эволюцию схем, снижая расходы на управление большими архивами.
- разделение вычислений и хранения. Возможность масштабировать вычисления отдельно от хранения обеспечивает экономию, так как вычислительная нагрузка может быть спроектирована под конкретные задачи, а хранилище - под объём и срок годности данных.
- использование спотовых ресурсов. Swarm-узлы могут работать на спотовых экземплярах, что дополнительно снижает вычислительные затраты, особенно при пакетной обработке больших объемов данных.
- ускорение чтения и снижения задержек. Кэширование метаданных Iceberg и Parquet, а также оптимизации PREWHERE и Bloom-фильтры, снижают задержки и сокращают количество обращений к дорогим операциям в S3 и планирование запросов.
Прогнозируемые эффекты включают значительное снижение затрат на хранение исторических данных, уменьшение эксплуатационных расходов на вычисления и упрощение архитектуры управления данными. Это делает Antalya привлекательным решением для предприятий, которым необходима масштабируемая архитектура LakeHouse с экономной и предсказуемой стоимостью владения.
Применение Antalya в экономических секторах: финансы, телеком, ритейл, гос сектор
Целевые отрасли получают от Antalya ряд конкретных преимуществ:
- финансы. В условиях регуляторной и аудиторской дисциплины Iceberg обеспечивает управляемость истории транзакций и соответствие требованиям аудита. Разделение данных и вычислений поддерживает требования к скорости аналитики и гибкость в проведении регуляторных отчётов и риск-аналитики.
- телеком. Большие потоки метрик и логов обслуживания требуют быстрой обработки и возможности аггрегации за длинные временные периоды. LakeHouse-архитектура обеспечивает гибридную обработку: горячие данные в ClickHouse, архивы в Iceberg, с эффективной доступностью через единый SQL.
- ритейл. Для веб-аналитики и мониторинга продаж архитектура подходит для обработки больших массивов кликов и транзакций, а также ML-нагрузок по рекомендациям и персонализации за счёт доступа к историческим данным и оперативной аналитике на одном уровне.
- гос сектор. В условиях необходимости прозрачности, подотчетности и долгосрочного хранения данных Iceberg обеспечивает надёжную архивацию, а ClickHouse обеспечивает реальное время аналитики и оперативное взаимодействие с службами.
Экономическая стратегия для каждого сектора строится на возможности унифицировать доступ к данным, управлять версиями и сохранять данные в защищенной среде, соответствующей нормативным требованиям. Antalya предоставляет единое решение, которое может быть адаптировано под конкретные регуляторные требования, географическую локализацию и инфраструктурные ограничения.
Риски, уязвимости и ограничения: оценка и метрики эффективности
Как и любая сложная архитектура, Antalya имеет ряд рисков и ограничений, которые следует учитывать:
- консистентность и задержки. Механизмы миграции данных между ClickHouse и Iceberg требуют мониторинга и управления версиями, чтобы исключить рассогласование между слоями в режиме реального времени.
- сложность инфраструктуры. Наличие нескольких слоёв хранения, каталогов и слоёв вычислений увеличивает сложность эксплуатации и управления безопасностью. Требуется дисциплина в области мониторинга, лицензирования и обновления компонентов.
- зависимость от форматов. Хотя Iceberg и Parquet работают очень хорошо вместе, необходимость поддержки новых форматов может потребовать изменений в конвертационных пайплайнах и коннекторах.
- требования к навыкам. Эффективная реализация зависит от квалификации команд по ClickHouse, Iceberg, Parquet, Swarm и Kubernetes. Необходимо инвестировать в обучение и развитие компетенций.
- ограничение по latency в определённых сценариях. Для самых критичных к задержкам операций предикаты на Iceberg могут вносить некоторую задержку по сравнению с чисто горячим path в ClickHouse, хотя оптимизационные техники минимизируют этот эффект.
Метрики эффективности включают: задержку выполнения запросов, пропускную способность потоковых пайплайнов, долю данных, доступных через единый интерфейс, общую стоимость владения (TCO), долю сэкономленной памяти и дискового пространства, а также устойчивость к сбоям и скорость восстановления после инцидентов.
Конкурентный анализ: Delta Lake, Hudi, Iceberg и преимущества Antalya
На рынке платформ Data LakeHouse действуют несколько конкурирующих подходов. Delta Lake (Databricks), Apache Hudi и Iceberg - три ключевых каркаса для управления метаданными и файловой структуре озер. Iceberg обеспечивает наиболее развитый и открытый подход к управлению схемами, разделению и окружению метаданных, что делает его особенно удобным для интеграции с ClickHouse и потоковыми пайплайнами. Delta Lake имеет сильную экосистему и глубокую интеграцию с Apache Spark, но может быть менее универсальным в контексте SQL-ориентированной аналитики в ClickHouse. Hudi фокусируется на транзакционности и обновлениях в больших наборов данных, но Iceberg предлагает более гибкую карту чтения и масштабирования.
Привлекательность Antalya как архитектурного решения заключается в сочетании нескольких конкурентных преимуществ:
- единый SQL-доступ к данным независимо от их физического расположения;
- интеграция с Iceberg как ведущим каталогом и форматом хранения для архивов;
- ускорение чтения Parquet через Swarm и кэширование;
- эффективное разделение вычислений и хранения, что позволяет оптимизировать затраты и ускорить эволюцию архитектуры;
- поддержка многоуровневого хранения и автоматической миграции данных, что упрощает жизненный цикл данных и уменьшает сложность операций.
Эти особенности позволяют Antalya выделяться на фоне конкурентов, обеспечивая реальную экономическую выгоду и техническое преимущество в сценариях онлайн-аналитики и ML-обработки на больших объемах данных.
Практические рекомендации по внедрению, миграции и оценке эффективности
Для успешного внедрения Antalya следует придерживаться практических шагов:
- начальная оценка. Оцените требования к нагрузке, объему данных и целям ML. Определите пороги для миграции данных в Iceberg и зоны доступа в ClickHouse.
- пилотный проект. Реализуйте пилотную схему на ограниченном объёме данных, чтобы проверить совместимость Iceberg, Parquet и ClickHouse, а также способность Swarm кэшировать данные и масштабироваться.
- миграционная дорожная карта. Разработайте план миграции: какие таблицы сначала, как обеспечивать согласованность, как работать с версионностью и как минимизировать влияние на текущие бизнес-процессы.
- архитектура и безопасность. Обеспечьте контроль доступа, RBAC и аудит. Обеспечьте безопасность передачи и хранения данных в Iceberg на S3.
- мониторинг и метрики. Внедрите мониторинг задержек, throughput, процент доступа к Iceberg и кэш-показатели. Регулярно оценивайте TCO и окупаемость проекта.
- операционная устойчивость. Организуйте процедуры бэкапа, аварийного восстановления и тестирования гибкости к сбоям. Учитывайте требования к регуляторике и сертификации.
Практическое внедрение требует способности адаптировать архитектуру под конкретные потребности: отрасли, нормативные требования, географическую локализацию данных и специфику обработки. В рамках Antalya рекомендуется рассматривать постепенное внедрение: начать с горячих данных в ClickHouse, затем расширить Iceberg-поддержку для архивов и внедрить Swarm для ускорения чтения Parquet, параллельно наращивая опыт и адаптируя процессы под масштабы бизнеса.
Вопрос-Ответ:
-
Вопрос: Что такое LakeHouse и почему Antalya выбирает Iceberg как базовый формат хранения?
Ответ: LakeHouse сочетает характеристики Data Lake и хранилищ данных. Iceberg обеспечивает управляемые метаданные, версионность и масштабируемость таблиц озера, что упрощает миграцию и доступ к архивам, сохраняя единый SQL-API через ClickHouse. -
Вопрос: Как достигается экономия на хранении в Antalya?
Ответ: Экономия достигается за счёт перемещения устаревших данных в Iceberg на S3, использования Parquet как эффективного формата хранения и многоуровневого хранения, что снижает стоимость хранения примерно в 10 раз по сравнению с полноценно реплицируемыми таблицами в ClickHouse. -
Вопрос: Какие роли выполняют Swarm и Kubernetes?
Ответ: Swarm обеспечивает эластичную, Stateless-вычислительную инфраструктуру для чтения Parquet и ускорения обработки данных, в то время как Kubernetes управляет оркестрацией и автоматическим масштабированием, обеспечивая устойчивость и повторяемость окружения. -
Вопрос: Какие сценарии лучше всего подходят для Antalya?
Ответ: Мониторинг логов, веб-аналитика, регуляторные задачи и ML-нагрузки с большими историческими данными - все эти сценарии выигрывают от унифицированного доступа к данным и эффективного разделения вычислений и хранения. -
Вопрос: Какие риски связаны с внедрением Antalya?
Ответ: Риск связан с сложностью инфраструктуры, требованиями к квалификации сотрудников и необходимостью обеспечения согласованности между слоями хранения. Эффективность достигается через тщательное планирование миграции, мониторинг и автоматизацию. -
Вопрос: Какова роль Bloom-фильтров в производительности?
Ответ: Bloom-фильтры помогают быстро исключать нерелевантные блоки Parquet, сокращая объем чтения и ускоряя время ответа на запросы, особенно при работе с крупными наборами данных. -
Вопрос: Какие преимущества дает разделение вычислений и хранения?
Ответ: Разделение вычислений и хранения позволяет масштабировать каждую часть независимо, снижать затраты на вычисления за счёт использования спотовых ресурсов и ускорять обработку за счет параллелизма Swarm и оптимизации планирования запросов. -
Вопрос: Как обеспечивается целостность данных между слоями?
Ответ: Целостность обеспечиваются через единое представление таблиц, версионность Iceberg, управление метаданными и миграционными процедурами, которые поддерживают согласованность и аудит изменений. -
Вопрос: Какую роль играет Parquet в архитектуре Antalya?
Ответ: Parquet служит эффективным форматом хранения столбцов и обеспечивает быструю загрузку и чтение больших массивов данных, что критично для высокопроизводительных аналитических запросов и ML-пайплайнов. -
Вопрос: Какие шаги следует предпринять для миграции данных в Iceberg?
Ответ: Определить наборы данных, проверить совместимость схем, спланировать миграцию по разделам, внедрить целостность и аудиторию, настроить кэш и мониторинг, затем запустить поэтапный переход с контролем качества. -
Вопрос: Какие отраслевые преимущества обеспечивает Antalya?
Ответ: В финансовом секторе - регуляторная согласованность и аудит; в телеком - масштабируемая аналитика и мониторинг; в ритейле - ускорение операций и ML-оптимизации; в гос секторе - прозрачность, безопасность и долговременная архивация. -
Вопрос: Как измерить экономическую эффективность проекта?
Ответ: Стоимость владения (TCO), экономия на хранении, экономия на вычислениях, время отклика запросов, скорость миграции данных и общая окупаемость инвестиций - все это следует отслеживать через KPI проекта. -
Вопрос: Какие ограничения стоит учитывать при выборе Antalya?
Ответ: Необходимость обучения персонала, управление сложной инфраструктурой, требования к регуляторике и совместимость с существующими коннекторами и данными - эти факторы следует учитывать на стадии планирования. -
Вопрос: Какие преимущества предоставляет единая SQL-практика в Antalya?
Ответ: Единый SQL-доступ облегчает использование аналитических инструментов и сокращает время обучения команд, поскольку данные доступны через один интерфейс, независимо от их реального расположения. -
Вопрос: Какие шаги необходимы для масштабирования архитектуры на крупных клиентов?
Ответ: Расширение Iceberg-архивов, увеличение числа Swarm-нοдов, внедрение дополнительных коннекторов и адаптация стратегии к регуляторным требованиям, а также расширение мониторинга и управления безопасностью. -
Вопрос: Каковы перспективы развития Antalya?
Ответ: Развитие будет направлено на углубление интеграций с ML-операциями, расширение поддержки форматов данных и улучшение автоматизации миграций, а также на усиление гибкости оркестрации и оптимизации затрат за счёт новых паттернов развертывания.
Вопрос-Ответ:
-
Вопрос: Какие принципы лежат в основе Antalya и LakeHouse?
Ответ: Antalya опирается на LakeHouse-подход: единый SQL-доступ к данным, разделение вычислений и хранения, использование Iceberg как каталога и формата хранения, Parquet как физический формат и S3 как хранилище, а Swarm - как слой вычислений. -
Вопрос: Какова роль Iceberg в управлении данными?
Ответ: Iceberg обеспечивает версионность, эволюцию схем и эффективное управление метаданными таблиц для больших архивов, что делает архивы устойчивыми к изменениям и масштабируемыми. -
Вопрос: Какие преимущества предоставляет параллельное чтение Parquet?
Ответ: Параллельное чтение Parquet позволяет обрабатывать большие массивы данных быстрее, уменьшает задержки и повышает пропускную способность аналитических пайплайнов. -
Вопрос: Какова практика миграции между слоями хранения?
Ответ: Миграция проводится через автоматизированные процедуры, которые сохраняют единое представление таблиц, обеспечивают консистентность и минимизируют влияние на бизнес-процессы. -
Вопрос: Какие требования к инфраструктуре для реализации Antalya?
Ответ: Требуются контейнеризированные сервисы (Docker), оркестрация (Kubernetes), механизм распределённых вычислений (Swarm) и гибкая настройка облачного окружения. -
Вопрос: Какие KPI стоит использовать для оценки эффективности проекта?
Ответ: Ключевые показатели включают задержку запросов, throughput, стоимость хранения, стоимость вычислений, долю архивируемых данных, время миграций, доступность и стабильность работы кластера. -
Вопрос: Какие меры безопасности критичны для внедрения Antalya?
Ответ: Управление доступом (RBAC), аудит действий, шифрование в транзите и на хранении, контроль целостности данных и соблюдение нормативов в отношении регуляторной информации. -
Вопрос: Какой путь внедрения оптимален для крупных организаций?
Ответ: Рекомендовано начать с пилотного проекта на ограниченном наборе данных, постепенно расширять область применения, внедрять миграцию в Iceberg и укреплять инфраструктуру мониторинга и безопасности.
Итоги и перспективы развития Antalya
Анталия представляет собой интегративное решение, объединяющее возможности ClickHouse, Iceberg, Parquet и S3 для создания эффективной LakeHouse-архитектуры. Разделение вычислений и хранения, ускорение чтения Parquet через Swarm и адаптивные механизмы кэширования обеспечивают как экономическую эффективность, так и высокую производительность аналитики в реальном времени. Архитектура поддерживает многослойное хранение, потоковую загрузку и единый доступ к данным - всё это делает Antalya подходящим вариантом для непрерывной аналитики и ML-обработки на масштабируемых данных.
Кроме того, Antalya остаётся открытым проектом, который продолжает развиваться в сторону повышения устойчивости, расширения поддержки форматов и улучшения инструментов мониторинга. Ориентир на экономическую эффективность, совместимость с существующими промышленными стеками и гибкость в развёртывании в облаке и локально делают Antalya привлекательной для организаций разных отраслей, стремящихся реализовать современные LakeHouse-архитектуры без чрезмерного увеличения расходов и сложности эксплуатации.


