

JOIN в ClickHouse: архитектура, алгоритмы выполнения и практика оптимизации
Введение: цели обзора и контекст использования JOIN в ClickHouse
JOIN-операции являются одной из наиболее сложных и критичных для производительности частей SQL-запросов в современных аналитических системах. В ClickHouse, где основное восприятие данных строится вокруг колоночного хранения и распределенной обработки, характер реализации JOIN существенно отличается от традиционных реляционных СУБД. Цель данного обзора - систематизировать знание о типах JOIN, алгоритмах их выполнения, механизмах выбора и адаптации планов, а также очертить практические подходы к оптимизации в реальных сценариях.
Контекст использования JOIN в ClickHouse включает задачи по обогащению данных на лету, агрегацию и фильтрацию связанных фактов, временное выравнивание наборов данных, а также интеграцию данных из внешних источников. Особенности архитектуры ClickHouse - столбчатое хранение, высокая степень параллелизма и возможность распределенной обработки - обуславливают особенности планирования JOIN: выбор схемы соединения, порядок размещения таблиц, работа конвейера запросов и использование памяти. В этом контексте понимание не только того, какие типы JOIN поддерживаются, но и как они реализуются на уровне движков таблиц и конвейера, становится необходимостью для проектирования эффективных аналитических решений.
Задача статьи - не только перечислить типы и алгоритмы, но и углубиться в принципы их работы, показать, как за кулисами формируется план выполнения, какие параметры управляют ресурсами и какие практические компромиссы возникают при работе с большими объемами данных и ограниченными ресурсами. В конце приводятся кейсы и рекомендации по проектированию запросов, позволяющие минимизировать задержку и потребление памяти при JOIN в ClickHouse.
Теоретические основы соединения: концепции эквивалентности, сложности и модели выполнения

Соединение двух наборов данных по ключу является базовой парадигмой извлечения совместимой информации. В теоретическом плане различают внутреннее экви-соединение (equijoins) и неравные или неэквивалентные формы, где условия соединения включают дополнительные предикаты. В ClickHouse, как и в большинстве современных аналитических СУБД, основная модель - это equi-join, где условия равенства по ключу определяют пары строк. Однако поддерживаются и расширения вроде ASOF JOIN, SEMI/ANTI/ANY JOIN, которые дают дополнительные способы фильтрации и агрегации без создания полного декартово произведения.
Сложность выполнения JOIN напрямую зависит от двух факторов: размера входных наборов и доступности памяти. В классической схеме Hash Join-операций меньшая таблица строит в памяти хэш-таблицу, после чего другая таблица подается линией и ищутся соответствия. Merge Join в свою очередь требует упорядоченных входов и сортировки по ключу, что может занимать значительную часть времени, но часто экономит память. В ClickHouse поведение гибко усваивает структуру данных - архитектура столбцового хранения позволяет считывать только необходимые столбцы и экономить I/O. Распределенная архитектура добавляет аспекты локальности данных, передачи между узлами и консолидации фрагментов при выполнении JOIN.
Эти принципы определяют ключевые подходы к планированию: какую таблицу размещать слева и справа, какие столбцы требуется извлечь, как управлять подсчетами и промежуточными структурами, и какие режимы памяти допускаются в рамках текущего запроса. В рамках ClickHouse введены адаптивные механизмы выбора алгоритма join и динамического переключения «на лету», что позволяет снизить риск досрочной остановки по лимитам памяти и повысить устойчивость к разноразмерным наборам данных.
Архитектура ClickHouse и роль столбчатого хранения в операциях JOIN
Архитектура ClickHouse опирается на две базовые идеи: столбчатое хранение и распределенная обработка. Столбчатое хранение обеспечивает эффективную выборку подмножества столбцов, что особенно важно для операций JOIN, где задействованы лишь небольшие сочетания столбцов из широких таблиц. Это снижает объем считываемых данных, уменьшает потребление памяти и ускоряет пропускной поток.
Роль распределенной обработки проявляется в возможности параллельного выполнения JOIN на нескольких узлах кластера, синхронизации промежуточных результатов, использовании локальности данных и минимизации сетевой передачи. В ClickHouse процесс построения результата JOIN реализуется через конвейер запросов (Query Pipeline), который динамически распараллеливает обработку и позволяет адаптивно изменять план в процессе исполнения в зависимости от текущей загрузки, доступной памяти и характеристик входов.
Два фундаментальных элемента непосредственно участвуют в процессе JOIN:
- хэш-таблица: используется в алгоритмах hash join и direct join через словари; хранит ключи и данные в памяти или внешнем хранилище в зависимости от объема.
- словари (Dictionary): представления данных в формате ключ-значение, поддерживаемые движками словарей и используемые для быстрого доступа к вспомогательным данным. Это особенно важно для реализации Direct Join и быстрого обогащения данных.
Роль конвейера запросов заключается в обеспечении высокого уровня параллелизма и доставки данных между этапами. Уровень параллелизма ограничивается параметром max_threads и ресурсами машины. В процессе выполнения JOIN ClickHouse оптимизирует чтение столбцов, распределение computa-tion и переработку результатов так, чтобы минимизировать сетевые перенесения и задержки.
Декомпозиция технических компонентов и их взаимодействия: хэш-таблица, словари, конвейеры, ключи JOIN
Внутреннее исполнение JOIN в ClickHouse опирается на сочетание нескольких технологий и структур:
-
Хэш-таблица: базовая структура данных для быстрого поиска соответствий между ключами. При Hash Join правая таблица зачастую «загружается» в память, формируется хэш-таблица, а левая таблица последовательно или параллельно проверяется на наличие совпадений. Эффект зависит от размера меньшей стороны; если она не умещается в память, может применяться внешняя память или частичное слияние.
-
Словари (Dictionary): механизмы в ClickHouse, реализующие доступ к внешним данным в формате «ключ-значение» с минимальной задержкой. Они бывают разных типов движков Dictionary (например, flat, hierarchical) и служат основой для Direct Join, когда правая сторона может обслуживаться словарем с очень низкой задержкой.
-
Конвейеры запросов (Query Pipeline): архитектурная модель ClickHouse, обеспечивающая высокую параллельность. Каждый этап конвейера может работать своим потоком, передавая партии данных между этапами. Параллелизм регулируется параметрами max_threads и настройками планировщика.
-
Ключи JOIN: набор полей, по которым выполняется сопоставление строк между таблицами. В ClickHouse поддерживаются как простые равенственные ключи, так и составные ключи, а также гибридные случаи с нестрогими условиями (ASOF) и специальными типами соединения (SEMI, ANTI, ANY). Важной концепцией является "меньшая сторона" для выбора оптимальной схемы выполнения, особенно в Hash Join.
Эти элементы взаимодействуют так: холдинг ключей и структуры данных определяет, какие таблицы будут задействованы в конкретном алгоритме (Hash, Merge, Direct), как будут читаться столбцы (столбцовый доступ), как будет строиться хэш-таблица и как будет происходить поиск по словарю. Взаимодействие между движками таблиц (MergeTree, Memory, Dictionary) влияет на план, потому что наличие внешних словарей, материалов и индексов влияет на скорость доступа к данным и на необходимость сортировки.
Типы JOIN в ClickHouse: обзор и функциональные различия
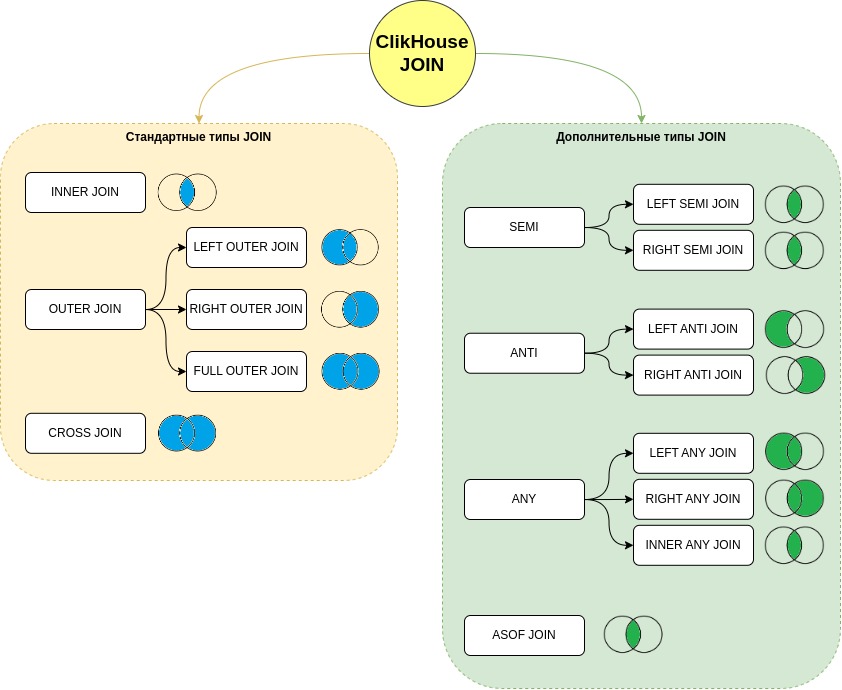
ClickHouse поддерживает широкий набор видов JOIN, включая стандартные INNER, LEFT OUTER, RIGHT OUTER, FULL OUTER, CROSS, а также специализированные варианты SEMI, ANTI и ANY, и особые ASOF JOIN. Ниже кратко охарактеризованы ключевые различия:
-
INNER JOIN: возвращает только совпадающие строки по ключам. Это основной тип, который чаще всего реализуется через hash-join или merge-join, в зависимости от структуры входов.
-
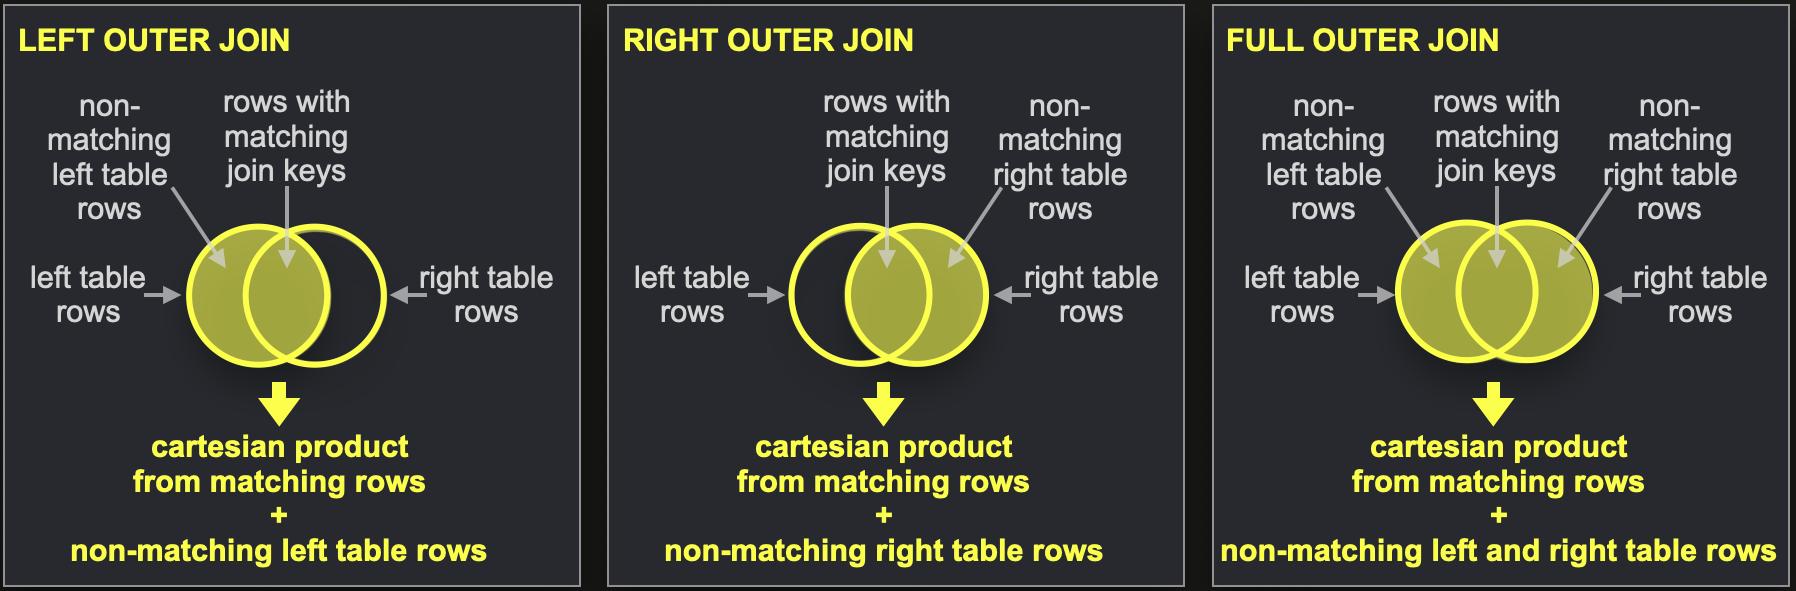
LEFT OUTER JOIN: возвращает все строки из левой таблицы и совпадающие строки из правой. Если совпадений нет, значения правой стороны заполняются значениями по умолчанию; можно опустить ключевое слово OUTER, сохранив семантику.
-
RIGHT OUTER JOIN: аналогично LEFT OUTER, но приоритет отдаётся правой таблице. Все строки правой таблицы включаются; строки левой таблицы без соответствий получают значения по умолчанию.
-
FULL OUTER JOIN: объединение левой и правой частей, включая строки без совпадений с обеих сторон, с заполнением пустых ячеек. Для получения NULL-значений вместо дефолтов нужно использовать join_use_nulls.
-
CROSS JOIN: декартово произведение двух таблиц без учета условий соединения. В ClickHouse CROSS JOIN может быть переписан как INNER JOIN, если в WHERE присутствуют выражения соединения. Альтернативный синтаксис - перечисление таблиц через запятую в FROM.
-
SEMI JOIN и ANTI JOIN: возвращают строки по левым (SEMI) или правым (RIGHT SEMI) сторонам, удовлетворяющим условиям соединения, без декартового произведения. SEMI возвращает строки левой таблицы, если есть хотя бы одно совпадение; ANTI исключает совпадающие строки.
-
ANY JOIN: частично или полностью отключает декартово произведение для стандартных видов соединений; LEFT ANY требует сохранения максимум одного совпадения по сути, а RIGHT ANY - аналогично с правой стороны. INNER ANY JOIN - аналог INNER JOIN с отключенным декартовым произведением.
-
ASOF JOIN и LEFT ASOF JOIN: предназначены для последовательностей с нечетким совпадением по времени или другим непростым ключам. В них применяется ближайшее соответствие из правой таблицы к левой на основе заданного критерия времени или другого метки.
Типы JOIN отражают разные требования к выводам, управлению размером промежуточных результатов и характеру обработки данных. Выбор типа JOIN влияет на выбор алгоритма выполнения и на требования к памяти, сортировке и сетевым взаимодействиям в распределенной среде.
INNER JOIN: семантика, поведение и типичные сценарии использования
INNER JOIN обеспечивает соединение только между строками, где существуют совпадения по указанному ключу. В ClickHouse реализация INNER JOIN обычно ориентируется на наиболее эффективные маршруты: hash-join, когда одна сторона существенно меньше другой, и merge-join, когда данные приходят уже упорядоченными или требуют упорядочивания.
Типичны сценарии: объединение фактов с атрибутами по ключам, когда нужно сохранить только те строки, у которых существуют соответствия в обеих таблицах. INNER JOIN служит базовой операцией, которая лежит в основе большинства аналитических конвейеров, где целью является построение согласованных фактов и измерений.
Рассматривая производительность, важно помнить о следующих принципах:
- размещение меньшей стороны справа может улучшить память и время выполнения при hash-join;
- выбор столбцов для чтения должен ограничиваться теми, которые нужны в результате, чтобы уменьшить I/O;
- использование агрегаций до JOIN или после может повлиять на оптимизацию конвейера и на потребление памяти.
LEFT OUTER JOIN и RIGHT OUTER JOIN: семантика, реализации и нюансы
LEFT OUTER JOIN возвращает все строки левой таблицы в сочетании с совпадающими строками правой. Если совпадений нет, правые столбцы получают значения по умолчанию, а строки левой таблицы все равно попадают в результат. RIGHT OUTER JOIN реализуется аналогично, но приоритет отдаётся правой таблице.
Ключевые нюансы:
- в практике часто полезно двигаться от INNER JOIN к OUTER, чтобы увидеть, сколько строк выходит без соответствий, и оценить влияние на размер промежуточной выборки;
- использование join_use_nulls может повлиять на то, как заполняются пустые значения в итоговой таблице (NULL vs дефолтные значения);
- если результирующая размерность становится большой, нужно рассмотреть фильтрацию на ранних шагах или перенос части вычислений в подзапросы.
FULL OUTER JOIN: семантика, ограничения и сценарии применения
FULL OUTER JOIN возвращает все строки обеих таблиц, заполняя отсутствующие значения NULL в соответствующих столбцах. Это позволяет получить полный контекст по ключам, независимо от того, с какой стороны данных отсутствуют совпадения. В ClickHouse реализация FULL OUTER JOIN требует внимания к памяти и к тому, как наполняются NULL-значения и дефолты.
Типичные сценарии включают агрегацию фактов и атрибутов из разных источников там, где нет полного соответствия между источниками. В практике следует внимательно смотреть на размер результата и на необходимость дальнейших фильтраций, чтобы избежать неэффективного роста памяти.
CROSS JOIN: особенности, альтернативы синтаксиса и переработка в ClickHouse
CROSS JOIN порождает декартово произведение таблиц, соединяя каждую строку одной таблицы с каждой строкой другой. Это может привести к быстрому росту объема результата, и поэтому в реальных рабочих нагрузках CROSS JOIN часто заменяют на эквивалентные конструкции с условиями в WHERE или на использование SEMI/ANTI JOIN, если задача сводится к фильтрации, а не к полноценно декартовому произведению.
Существуют альтернативные синтаксисы: указание нескольких таблиц в FROM через запятую. В ClickHouse CROSS JOIN может быть переписан как INNER JOIN при наличии условий соединения в WHERE; это позволяет оптимизировать план выполнения и минимизировать размер временных структур.
Специализированные типы JOIN: SEMI JOIN, ANTI JOIN, ANY JOIN и их сочетания
- SEMI JOIN возвращает строки только из левой таблицы, которые имеют как минимум одно совпадение по ключу во второй таблице, без создания декартового произведения.
- ANTI JOIN возвращает строки левой таблицы, которые не имеют совпадений во второй таблице.
- ANY JOIN - сочетание стандартного типа с элементами SEMI/ANY, которое позволяет частично отключать декартово произведение, сохраняя вывод по ключу.
- LEFT ANY JOIN и RIGHT ANY JOIN - гибриды, которые объединяют функции OUTER и SEMI/ANY, позволяя выводить либо полные строки с правой стороны, либо только одну запись для каждого совпадения, экономя память.
- INNER ANY JOIN - аналог INNER JOIN с отключением декартового произведения для ускорения планирования и уменьшения объема промежуточных данных.
Эти типы расширяют возможности обработки в сценариях, где полноценное декартово произведение недопустимо или неэффективно, и особенно полезны для ускорения обработки больших наборов при сложной фильтрации.
ASOF JOIN и LEFT ASOF JOIN: неточное соответствие, требования к данным и примеры использования
ASOF JOIN реализован для случаев, когда точного соответствия по ключам нет или оно не требуется в точности, а между записями важна близость по времени или другой метке. В ClickHouse для ASOF JOIN требуется специальный столбец-ключ соответствующего типа (Int, UInt, Float, Date, DateTime, Decimal). Пример использования: присоединение данных о событиях к реальному времени по ближайшей временной метке.
Условия ASOF JOIN позволяют задать два типа условий: equi_cond и closest_match_cond, где первое - равенство по ключу, второе - ограничение на ближайшее совпадение. Число и тип условий может варьироваться, но важно, что алгоритм применим только к ситуациям, где требуется «близкое» соответствие во времени или близкой метке, и не заменяет точного соединения там, где он необходим.
Алгоритмы выполнения JOIN в ClickHouse: Hash Join, Merge Join, Direct Join/Dictionary, Partial Merge
В ClickHouse реализуются несколько базовых алгоритмов выполнения JOIN:
-
Hash Join: используется по умолчанию и является наиболее универсальным. Малая сторона загружается в память как хэш-таблица; большая сторона проверяется на совпадения. Эффективен для неравных размеров наборов данных.
-
Merge Join: применяется к равномерно упорядоченным данным; требует полной сортировки по ключу соединения. Менее требовательен к памяти, но может потребовать значительных затрат на сортировку.
-
Direct Join / Dictionary: работает через словари (Dictionary) - когда правая таблица поддерживается словарем, и данные уже находятся в памяти в виде структуры ключ-значение. Поддерживает ограничение: чаще всего LEFT ANY. Позволяет очень быстрое выполнение за счет низкой задержки доступа.
-
Partial Merge: компромиссный алгоритм, который частично комбинирует преимущества Hash и Merge, применим в условиях ограничений памяти.
Выбор алгоритма зависит от характеристик входов, типа ключей и требуемой точности. В ClickHouse характерный режим авто-выбора (join_algorithm = auto) пытается hash join, и при перерасходе памяти переключается на partial merge join. Этот механизм подчеркивает адаптивность системы и зависимость от доступных ресурсов.
Механизм выбора алгоритма и адаптивная настройка: авто режим, переключение в рантайме, настройка join_algorithm
Концепция авто-режима предполагает, что базовый планировщик пытается заранее оценить стоимость различных стратегий и выбрать оптимальную из них. При включенном auto-clickhouse выполняет hash join по умолчанию; если возникает превышение допустимой памяти, механизм переключается на partial merge join. Это переключение происходит динамически в рантайме, что минимизирует необходимость повторной компиляции запроса и повторной загрузки данных.
Пользователи могут принудительно указать желаемый алгоритм через настройку join_algorithm и получить явное поведение. Включается trace logging для наблюдения за тем, какой алгоритм был выбран и какие ресурсы потреблялись. Адекватная настройка может быть критична для сценариев с ограничениями памяти и для оптимизации под конкретный набор данных и аппаратной конфигурации.
Взаимодействие с движками таблиц: MergeTree, Memory, Dictionary и влияние на план выполнения
Движки таблиц существенно влияют на план выполнения JOIN в ClickHouse. MergeTree-движок, как правило, лучше подходит для больших объемов данных с упорядоченной структурой, где можно применить Merge Join или эффективно организовать Hash Join. Движок Memory служит для временных и кэшированных таблиц, где скорость доступа к данным выше, но память ограничена. Dictionary-движки позволяют реализовать Direct Join через структуры ключ-значение и обеспечивают очень быстрый доступ к данным.
С точки зрения планирования, совместимость между движками и типами таблиц способен сильно повлиять на план выполнения: например, сравнение MergeTree против Memory может определить, нужно ли дополнительно сортировать данные, или можно обойтись без тяжелой сортировки. В распределенной среде ClickHouse также может выполнять JOIN на каждом шарде локально или собирать данные на узле-инициаторе перед обработкой, в зависимости от задачи и настроек.
Управление памятью и ресурсами при JOIN: max_memory_usage, join_use_nulls, мониторинг и ограничения
Управление памятью - ключевая задача для выполнения JOIN в ClickHouse. Основные параметры:
- max_memory_usage: лимит памяти, выделяемой под операцию JOIN. Превышение приводит к аварийному завершению запроса или к другим стратегиям перераспределения ресурсов.
- join_use_nulls: управляет заполнением NULL-значений в результирующих столбцах, что влияет на совместимость с стандартным SQL и на поведение агрегаций.
- Мониторинг и ограничение: трассировка, логи, метрики использования памяти и времени выполнения для каждого этапа конвейера позволяют выявлять узкие места и корректировать план.
Эти механизмы требуют балансировки между скоростью выполнения и потреблением памяти, особенно в условиях больших ширин таблиц и ограниченного объема RAM. Практически это означает выбор порядка размещения таблиц, использование сокращения выбранных столбцов и применение дополнительных фильтров на ранних этапах.
Оптимизация выполнения JOIN: порядок размещения таблиц, выбор меньшей стороны, локальность данных
Эффективная оптимизация JOIN в ClickHouse строится на нескольких принципах:
- размещение меньшей стороны справа в hash-join позволяет создать более компактную хэш-таблицу и снизить требования к памяти.
- ограничение выборки столбцов до тех, что необходимы в результате, уменьшает I/O и ускоряет конвейер.
- локальность данных - попытки минимизировать передачу данных между узлами кластера, использование локальных словарей и предзагруженных структур.
- выбор типа алгоритма (hash, merge, partial merge) в зависимости от характеристик входов и доступной памяти.
- использование ASOF JOIN или SEMI/ANTI вариантов, когда задача связана с фильтрацией или отсутствием полного соответствия.
Эти принципы применяются как на уровне отдельных запросов, так и в составе сложных аналитических конвейеров.
План выполнения JOIN и роль конвейера запросов: параллелизм, max_threads, trace logging
План выполнения JOIN строится на концепции Query Pipeline - конвейера, в котором данные проходят через последовательные этапы: чтение, фильтрация, джойн, агрегации и финальная обработка. Основной фактор параллелизма - max_threads, обычно привязанный к числу доступных ядер процессора. Чаще всего ClickHouse может выполнять большую часть этапов в 4 или более потоках на сервере с несколькими ядрами.
Trace logging позволяет отслеживать, какой алгоритм и какие ресурсы были задействованы на каждом этапе. В процессе анализа производительности можно увидеть:
- какой JOIN-алгоритм был применен;
- насколько эффективно использовалась память;
- как распределялся потоковый конвейер между задачами.
Учет этих данных позволяет разработчикам и администраторам точечно настраивать параметры и корректировать стратегию выполнения запроса.
Производительность, метрики и мониторинг: память, задержка, пропускная способность и диагностика
Производительность JOIN оценивается по нескольким направлениям:
- память: объем используемой хэш-таблицы и общего потребления RAM;
- задержка: время до получения первого результата и полное время выполнения;
- пропускная способность: количество обрабатываемых строк в секунду и скорость передачи между стадиями конвейера.
- диагностика: трассировка, метрики системы (CPU, I/O), анализ планов выполнения и сравнение реальных и ожидаемых затрат.
Для анализа применяют профилирование запросов, логи трассировки и внешние мониторинги. Эффективная диагностика позволяет определить узкие места - например, чрезмерно крупные хэш-таблицы, неэффективное использование памяти или затраты на сортировку.
Кейсы применения в реальных сценариях: аналитика, обработка потоков и обогащение данных на лету
- Аналитика: объединение фактов с справочными данными для формирования детализированных панелей и витрин. В таких сценариях важны точный план и минимальная задержка на каждый запрос.
- Обработка потоков: join в реальном времени с минимальными задержками. Часто применяются SEMI/ANY-join для фильтрации без создания декартова произведения.
- Обогащение данных на лету: использование словарей и внешних источников для добавления атрибутов к событиям.
Эти кейсы отражают практическую ценность JOIN в экосистеме ClickHouse и показывают, как архитектура и алгоритмы позволяют решать реальные задачи аналитики.
Интеграция технологических стеков и синергия: словари, Dictionary-движки, внешние источники
Интеграция словарей и Dictionary-движков позволяет поддерживать быстродействие при обогащении данных на лету. Взаимодействие с внешними источниками (например, базы данных, файловые источники, REST-API) реализуется через адаптивные словари и внешние подключения. Это открывает возможность значимого ускорения Join-операций за счет раннего кэширования и эффективного доступа к вспомогательным данным.
Синергия достигается за счет сочетания столбчатого хранения, словарей и конвейерной архитектуры: словари служат быстрым источником данных, концентрируя доступ к определенным ключам, а столбчатая модель минимизирует количество прочитанных столбцов. В результате достигается более низкое время отклика и повышенная производительность при больших объемах.
Возможности применения в различных экономических секторах: финансы, телеком, ритейл, аналитика
- Финансы: сложные сценарии объединения транзакций, реестров и справочников с требованиями к задержке и точности.
- Телеком: обработка событий по времени и агрегации для анализа сетевой активности.
- Ритейл: объединение продаж с данными клиентов и инвентаризацией, требующее быстрого обновления и точного сопоставления.
- Аналитика: создание витрин и панелей, объединение множества фактов и измерений из разных источников.
JOIN в ClickHouse обеспечивает возможности для реализации этих сценариев за счет адаптивной архитектуры и широкого набора типов соединений.
Риски, уязвимости и ограничения: безопасность, совместимость, ограничения по памяти и времени выполнения
- безопасность: фильтрация данных и контроль доступа остаются критическими аспектами, особенно при работе с внешними источниками и кэшами данных.
- совместимость: различные реализации и версии файловых источников требуют поддержки специфических форматов и типов данных.
- память и время выполнения: ограничение памяти и потенциал задержек при больших объемах данных или сложных условиях соединения.
Эти риски требуют проактивного мониторинга, тестирования и настройки параметров, чтобы обеспечить устойчивость в условиях продвинутых аналитических нагрузок.
Метрики эффективности и методы оценки: бенчмаркинг, тестирование производительности JOIN
- бенчмаркинг: использование референсных наборов данных и стандартных сценариев для оценки поведения JOIN под различной нагрузкой.
- тестирование производительности: анализ времени выполнения, потребления памяти, скорости чтения и скорости передачи данных.
- тестовые сценарии: сравнение алгоритмов, анализ влияния порядка размещения таблиц, экспериментирование с различными ключами и типами соединений.
Эти методы позволяют обеспечить устойчивость к изменяющимся требованиям и оптимизировать планы в реальных условиях.
Конкурентный анализ конкурирующих решений и их дифференциация
На рынке аналитических систем конкурируют реляционные СУБД, колоночные хранилища и распределенные базы данных. В ClickHouse существенные дифференциаторы включают:
- адаптивность выбора алгоритма JOIN;
- поддержка широкого набора типов JOIN и гибких стратегий;
- оптимизация под колоночное хранение и высокую параллельность;
- интеграция с Dictionary-движками и внешними источниками.
Сравнительный анализ помогает выявлять преимущества ClickHouse в сценариях больших данных, а также подсказывает области для дальнейших улучшений.
Практические рекомендации по проектированию запросов с JOIN в ClickHouse
- анализируйте размер входящих таблиц и выбирайте схему, которая минимизирует используемую память (часто правую сторону - меньшую).
- ограничивайте выбор столбцов, чтобы снизить I/O и потребление памяти.
- применяйте фильтры до JOIN, чтобы уменьшить объём данных, проходящий через конвейер.
- используйте ASOF JOIN для нестрогих соответствий по времени и SEMI/ANTI/ANY для контроля размера результатов.
- для сложных сценариев рассмотрите использование словарей и Dictionary-движков для ускорения прямых операций.
- применяйте мониторинг и трассировку для диагностики узких мест и корректной настройки параметров.
Примеры запросов и типовые шаблоны использования JOIN
- INNER JOIN: SELECT a.*, b.attr FROM events AS a INNER JOIN events_meta AS b ON a.key = b.key;
- LEFT OUTER JOIN: SELECT a.*, b.value FROM users AS a LEFT JOIN purchases AS b ON a.user_id = b.user_id;
- SEMI JOIN: SELECT a.* FROM sessions AS a SEMI JOIN events AS b ON a.session_id = b.session_id;
- ANY JOIN: SELECT a.*, b.meta FROM transactions AS a ANY JOIN accounts AS b ON a.account_id = b.id;
- ASOF JOIN: SELECT t1., t2. FROM events AS t1 ASOF LEFT JOIN market AS t2 ON t1.symbol = t2.symbol AND t2.time <= t1.time;
- CROSS JOIN (переписано через INNER JOIN с условиями): SELECT a., b. FROM customers AS a INNER JOIN products AS b ON 1=1 WHERE a.country = b.country;
Эти шаблоны демонстрируют базовые принципы и служат фундаментом для построения более сложных конвейеров.
Выводы и направления для будущих исследований
JOIN в ClickHouse сочетает в себе мощную адаптивную архитектуру и обширный набор возможностей для обработки больших данных. Архитектура столбчатого хранения, использование словарей, гибкая настройка алгоритмов и продвинутые механизмы конвейера позволяют достигать высокой производительности в распределённых условиях. Будущие направления включают дальнейшую оптимизацию памяти и плотности кеширования, развитие автоматического выбора лучших стратегий в условиях динамических нагрузок, а также углубление поддержки ASOF и ANY-типов в сценариях реального времени.
Расширение возможностей интеграции со внешними источниками, улучшение диагностики и мониторинга JOIN-операций, а также исследование новых подходов к планированию, адаптивной настройке и балансировке между локальностью данных и сетевой задержкой - все это будет способствовать повышению эффективности и предсказуемости выполнения JOIN в ClickHouse.
Вопрос-Ответ:
-
Вопрос: Что такое Hash Join и когда его стоит использовать в ClickHouse?
Ответ: Hash Join - основной алгоритм JOIN, который строит хэш-таблицу по меньшей стороне и ищет совпадения во второй. Он особенно эффективен, когда один набор данных существенно меньше другого и может помещаться в память. В условиях ограниченной памяти ClickHouse может перейти к частичному слиянию. -
Вопрос: Какую роль играют словари в процессе JOIN?
Ответ: Словари обеспечивают быстрый доступ к данным во внешних источниках и позволяют реализовать Direct Join без явной загрузки больших наборов данных в память. Это ускоряет соединения и обогащение данных на лету. -
Вопрос: Что означает join_algorithm = auto и как он работает?
Ответ: параметры auto позволяют ClickHouse автоматически выбирать между Hash, Partial Merge и другими алгоритмами в зависимости от доступной памяти и характеристик входов. Система может переключиться в рантайме, чтобы избежать превышения лимитов. -
Вопрос: Какие типы JOIN стоит использовать для избегания декартового произведения?
Ответ: SEMI, ANTI и ANY-Join позволяют ограничить создание декартовых произведений, возвращая только нужные наборы строк без полного расширения по всем парам. -
Вопрос: Как ASOF JOIN помогает работать с временными данными?
Ответ: ASOF JOIN обеспечивает близкое соответствие между записями по времени, заменяя точное совпадение на ближайшее, что полезно для сценариев временных рядов и поглощения данных из разных источников с разной временной точкой. -
Вопрос: Какие ограничения существуют при использовании FULL OUTER JOIN?
Ответ: FULL OUTER JOIN может требовать значительную память для формирования полного набора результатов и заполнения отсутствующих значений. Включение join_use_nulls может повлиять на поведение заполнения NULL-значениями и совместимость с аналитическими операциями. -
Вопрос: Как план выполнения JOIN влияет на производительность?
Ответ: Эффективность зависит от алгоритма, порядка размещения таблиц, фильтрации данных и параллелизма. Правильный выбор меняет объем промежуточных структур, задержки и потребление памяти, что напрямую влияет на производительность. -
Вопрос: Какие практические шаги можно принять для оптимизации JOIN в реальном проекте?
Ответ: Определите меньшую сторону для hash-join, ограничьте набор столбцов, применяйте фильтры до JOIN, используйте SEMI/ANTI/ANY-Join там, где возможно, и включайте мониторинг и трассировку для корректной настройки параметров. -
Вопрос: Как часто стоит обновлять статистику и планировочные параметры?
Ответ: Частота обновления зависит от характера нагрузки и изменений в данных. В условиях динамической рабочей нагрузки рекомендуется активно мониторить и возвращаться к настройкам после изменения в конфигурации или характеристик данных. -
Вопрос: Какие сценарии требуют использования ASOF JOIN наиболее сильно?
Ответ: ASOF JOIN эффективен при задачах временных рядов, где имеется необходимость привязать события к ближайшей временной метке другого набора данных, когда точное совпадение недостижимо или не требуется.


