

Согласованность без двойной записи в распределённых микросервисах: транзакционные паттерны и гарантии доставки на базе Kafka
Введение: неконсистентность данных в распределённых системах и проблема «двойной записи»
Распределённые системы по природе своей подвержены временной рассинхронизации данных. Когда бизнес‑операции затрагивают несколько технологических контуров - базу данных (БД), брокер сообщений, кэш, внешние API, - возникает потребность в атомарности на границе систем. Классическим проявлением становится проблема «двойной записи» (dual write): приложение должно одновременно зафиксировать изменения в БД и опубликовать событие в Apache Kafka. Сбой между двумя независимыми записями приводит к неконсистентности - событие опубликовано без изменения состояния в БД или наоборот. В условиях микросервисной архитектуры и EDA (Event‑Driven Architecture) такая уязвимость проявляется особенно часто, поскольку бизнес‑процессы режутся на цепочки асинхронных реакций.
Цель статьи - системно разобрать причины появления «двойной записи», показать ограничения на уровне теории и реализации, а затем представить практические паттерны, устраняющие класс проблем с учётом гарантий Kafka: Transactional Outbox, Event Sourcing и Listen to Yourself. Мы разберём компромиссы «надёжность-производительность», семантики доставки, методы дедупликации и идемпотентности, а также дадим критерии выбора решений под разные домены, нагрузочные профили и регуляторные требования.
Теоретическая база: CAP‑теорема, модели консистентности и eventual consistency
CAP‑теорема утверждает, что в условиях сетевых разделений система не может одновременно обеспечивать строгую консистентность (C), доступность (A) и устойчивость к разделениям (P). В реальных кластерах разделения неизбежны, поэтому выбор делается между «строгая консистентность» и «полная доступность». На практике это не бинарное решение: системы проектируются с учётом профилей отказов и требований к задержкам, прибегая к компромиссам, описываемым также эвристикой PACELC (при разделении - выбор между C и A; при отсутствии - между задержкой L и консистентностью C).
Важно различать модели консистентности:
- Линеаризуемость (linearizability): глобальный упорядоченный лог операций, каждая операция выглядит мгновенной между вызовом и ответом.
- Последовательная консистентность (sequential consistency): все узлы видят один и тот же порядок операций, но моментальные эффекты не гарантируются.
- Причинно‑следственная (causal consistency): сохраняются причинные зависимости между операциями.
- Итоговая согласованность (eventual consistency): при отсутствии новых обновлений все реплики сходятся.
Kafka и многие NoSQL‑хранилища выбирают причинно‑следственную и итоговую согласованность для высокой доступности и пропускной способности. Ключевой вывод: в распределённой среде «мгновенной» единой истины нет, а согласованность достигается через протоколы репликации и кворумов, неизбежно внося задержки.
ACID против BASE: требования к атомарности, изолированности и доступности в распределённом контексте
Традиционные СУБД обеспечивают ACID (Atomicity, Consistency, Isolation, Durability). Но ACID‑гарантии, как правило, действуют в рамках одного логического хранилища. Когда бизнес‑операция затрагивает разные технологии (БД и Kafka), границы транзакции расползаются. Подход BASE (Basically Available, Soft state, Eventual consistency) признаёт мягкое состояние и итоговую согласованность, что естественно для микросервисов и асинхронных потоков.
Критическое различие: атомарность на границе гетерогенных систем требует распределённого протокола (например, 2PC/XA) или архитектурного паттерна, сводящего операцию к одному источнику истины с последующей доставкой. Иначе «двойная запись» порождает недетерминированные разрывы между фактами в БД и событиями в шине.
Парадигма Event‑Driven Architecture (EDA) для микросервисов: принципы и ограничения
EDA строит взаимодействие на immutable‑событиях, публикуемых продюсерами и обрабатываемых консюмерами. Сервисы слабо связаны через лог событий: «что произошло», а не «что сделать». Это повышает масштабируемость и ускоряет эволюцию домена, но:
- Вносит асинхронность и «окна несогласованности».
- Требует идемпотентности обработчиков, поскольку повторная доставка неизбежна.
- Перекладывает ответственность за упорядочивание на ключи партиционирования и протоколы потребления.
- Обязывает к строгой работе с контрактами и схемами, иначе эволюция событий ломает потребителей.
Именно в EDA чаще всего обнаруживается «двойная запись»: командная модель меняет состояние в БД, а читательские модели и смежные домены ждут соответствующих событий.
Гомогенные и гетерогенные системы: характер консистентности и источники рассогласования
Гомогенные кластеры (одна технология) могут обеспечивать сильные инварианты через встроенные механизмы - репликацию БД или кворум Kafka. Гетерогенные (PostgreSQL + Kafka + Elasticsearch + ClickHouse) усиливают риски:
- Разные модели отказов и консистентности.
- Несовпадающие транзакционные границы.
- Различная длительность репликации/индексации.
- Отличные политики ретеншена и восстановления.
Именно разнообразие технологий усложняет сквозную атомарность и требует паттернов, в которых одна запись становится «источником истины» для остальных.
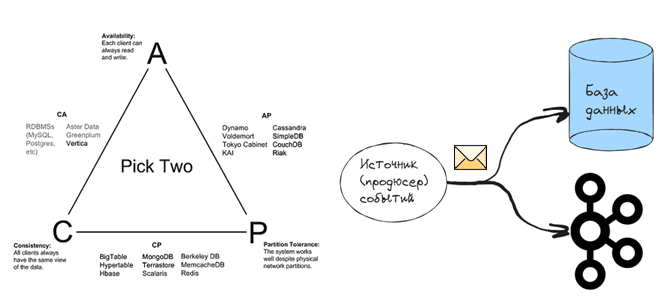
Репликация и согласование в БД и Kafka: топологии (лидер‑реплика, кольцо), механизмы и задержки
Реляционные СУБД и Kafka чаще используют лидер‑фолловер (leader‑replica) с журналом предзаписи. Cassandra применяет кольцевую топологию и настраиваемые уровни консистентности (ONE/QUORUM/ALL). В Kafka сообщения пишутся на лидера партиции и реплицируются в ISR‑набор (in‑sync replicas). Подтверждение записи определяется стратегией acks и min.insync.replicas. Задержки возникают из‑за сетевых RTT, fsync, колебаний нагрузки и фонов очисток логов.
Вывод: даже внутри одной технологии согласованность не мгновенна, а межсистемные границы добавляют новые источники задержек и потерь.
Гарантии Kafka и настройки продюсера: ack=all, кворум реплик, компромисс «надёжность-производительность»
Kafka предоставляет тонкие ручки конфигурации продюсера и кластера, влияющие на семантики доставки:
- acks=all (или -1): лидер ждёт подтверждения от кворума ISR. Повышает надёжность, снижает пропускную способность и увеличивает задержки.
- min.insync.replicas: минимальный размер кворума для подтверждения записи. В паре с acks=all задаёт жёсткие требования к репликам.
- enable.idempotence=true: обеспечивает идемпотентные повторы на уровне продюсера, устраняя дубликаты из‑за ретраев при отказах лидера.
- max.in.flight.requests.per.connection: ограничивает количество некоммитнутых запросов, снижая риск переупорядочивания сообщений при сбоях.
- retries, delivery.timeout.ms, linger.ms, batch.size, compression.type: влияют на баланс throughput/latency/надёжность.
Пример уравновешенной конфигурации для критичных событий:
enable.idempotence=true
acks=all
retries=INT_MAX
max.in.flight.requests.per.connection=5
batch.size=32768
linger.ms=10
compression.type=snappy
delivery.timeout.ms=120000
Кворум на стороне брокеров и идемпотентный продюсер вместе дают прочную основу для «по крайней мере один раз» с минимизацией дубликатов, а при использовании транзакционного продюсера - основу для EOS (Exactly‑Once Semantics) внутри Kafka.
Формализация проблемы «двойной записи»: атомарность межсистемных операций и временные окна несогласованности
Пусть операция состоит из двух шагов:
- запись состояния в БД;
- публикация события в Kafka. Между шагами существует окно T, в которое могут случиться:
- Сбой приложения после коммита БД, но до публикации в Kafka - событие потеряно.
- Успешная публикация в Kafka и сбой до коммита БД - ложное событие.
Смена порядка шагов лишь меняет, какую из двух неконсистентностей мы получим. Введение «общей транзакции» поверх БД и Kafka без согласованного протокола невозможно. Поэтому требуется архитектурный приём, который делает один шаг атомарным и наблюдаемым, а второй - воспроизводимым до успешного завершения. Именно эту роль выполняют рассматриваемые паттерны.
Карта отказов в цепочке «БД ↔ Kafka»: сетевые сбои, крахи процесса, потеря состояния, недоставленные события
Потенциальные точки отказа:
- Приложение: крах между двумя записями; утеря буфера в памяти.
- БД: отказ мастера, конфликт блокировок, откат транзакции, деградация диска.
- CDC/коннектор: падение процесса, смещение (offset) коннектора повреждено, лаг растёт.
- Kafka: недоступность лидера партиции, истощение ISR, исчерпание квоты, ретеншен удалил требуемые сообщения при длительной деградации.
- Сеть: частичная потеря пакетов, междатацентровые разделения.
- Консьюмер: дубликаты при ретраях, нарушение порядка при перебалансировках, частичное применение бизнес‑операции.
Системный дизайн должен предполагать повторяемость операции, идемпотентность обработчиков и внешние журналы прогресса (offsets, статусные таблицы), чтобы сбои в любой точке не приводили к необратимым расхождениям.
Антипаттерны и их пределы: инверсия порядка операций, объединение в транзакцию БД, повторные отправки
- Инверсия порядка (сначала Kafka, потом БД) оставляет ложные события при неуспешной записи в БД.
- Объединение через транзакцию БД не охватывает Kafka: публикация может произойти до фиксации БД.
- Повторные отправки из памяти теряют события при крахе процесса; из диска - дублируют без идемпотентности.
Эти подходы не устраняют «разрыв атомарности» и вскрывают новые риски. Нужна архитектура, где одна запись становится «опорной», а вторая - гарантированно догоняется.
Паттерн Transactional Outbox: идея, требования и гарантии целостности
Суть Transactional Outbox - записать бизнес‑состояние и «исходящее событие» в одной локальной транзакции БД. Затем отдельный процесс (поллер или CDC‑коннектор) надёжно публикует события в Kafka, повторяя попытки до успеха. Тем самым устраняется окно между несвязанными системами: атомарной становится транзакция внутри одной БД, а публикация в Kafka - детерминированно воспроизводимая.
Ключевые гарантии:
- Если бизнес‑изменение зафиксировано, соответствующее событие будет опубликовано.
- Отсутствуют «ложные события» без коммита бизнес‑состояния.
- Доставка как минимум один раз; дубликаты снимаются идемпотентностью продюсера/потребителя.
Ограничение: нужна транзакционная БД; для нереляционных и/или без ACID - см. Event Sourcing или Listen to Yourself.
Декомпозиция Transactional Outbox: таблица outbox, транзакционная запись, CDC/коннекторы (Debezium, Kafka Connect), пометки завершения
Реализация включает компоненты:
-
Таблица outbox в той же БД, что и бизнес‑сущности. Хранит payload, метаданные, ключ партиционирования, статус.
CREATE TABLE outbox_events (
  id              uuid PRIMARY KEY,
  aggregate_id    text NOT NULL,
  event_type      text NOT NULL,
  payload         jsonb NOT NULL,
  headers         jsonb,
  schema_version  int  NOT NULL,
  partition_key   text NOT NULL,
  created_at      timestamptz NOT NULL DEFAULT now(),
  published_at    timestamptz,
  status          text NOT NULL DEFAULT 'NEW', -- NEW|PUBLISHED|FAILED
  dedup_key       text UNIQUE
);
-
Транзакция: запись бизнес‑изменения + вставка в outbox одним коммитом. Это критический момент атомарности.
-
Публикатор:
- Вариант A - поллер приложением с блокировкой пачки записей, публикацией в Kafka транзакционным продюсером и обновлением статуса.
- Вариант B - CDC с Debezium + Kafka Connect. Debezium считывает изменения WAL/Redo‑логов (PostgreSQL, MySQL), формирует события Kafka. Маркировать публикацию можно сменой статуса через реконcюмера или хранить признак в служебной таблице.
- Пометки завершения и очистка:
- После успешной публикации статус меняется на PUBLISHED, published_at заполняется.
- Очистка по TTL/retention или батчевая архивация. Для аналитического аудита - перенос в архив.
Детали надёжности:
- Идемпотентный продюсер + ключ dedup_key устраняют дубликаты при ретраях.
- Партиционирование по aggregate_id сохраняет порядок событий внутри агрегата.
- Контроль backpressure - ограничение размера незавершённого outbox и механизмы деградации.
Моделирование доменных событий и контракты: схемы, версионирование и совместимость при публикации из outbox
Качество событий критично. Рекомендуемая структура:
- envelope: event_id (UUID), event_type, schema_version, occurred_at, producer, correlation_id/causation_id.
- key: aggregate_id или доменный ключ для упорядочивания.
- payload: минимально необходимая business‑данная.
Схемы:
- Avro/Protobuf с реестром схем (Schema Registry) и политиками совместимости (backward/forward/full).
- Жёсткие контракты на заголовки (Content‑Type, schema‑id) и семантику полей.
- Управление версиями через эволюцию схем без ломающих изменений; миграционные события использовать осмотрительно.
Тестирование контрактов (consumer‑driven contracts) снижает риск сломанной совместимости в проде. В outbox сохраняйте schema_version и поддерживайте маппинг версия→топик, если требуется переезд.
Паттерн Event Sourcing: журнал событий, воспроизведение состояния и аудит
Event Sourcing хранит не «текущее состояние», а неизменяемую последовательность доменных событий. Состояние восстанавливается путём воспроизведения лога. Преимущества:
- Полный аудит и трассируемость.
- Естественная поддержка ретрансляции и проекций под разные read‑модели.
- Устранение «двойной записи»: сама запись события** - это и есть изменение состояния.
Недостатки:
- Усложнение модели разработки (команды, события, агрегации).
- Необходимость снапшотов для больших агрегатов.
- Высокие требования к дисциплине схем и миграциям.
Декомпозиция Event Sourcing: хранилище событий, процессоры, проекции, публикация в Kafka, флаги публикации
Состав решения:
- Хранилище событий: append‑only лог (PostgreSQL с оптимистичной блокировкой версии, специализированные event store или Kafka как первичный лог).
- Процессоры команд (command handlers): валидация инвариантов, запись события.
- Проекции (read‑модели): асинхронные построители для запросов и отчётов (например, в Elasticsearch/ClickHouse).
- Публикация в Kafka: из хранилища событий либо напрямую (если Kafka - первичный лог), либо через CDC/поллер.
- Флаг публикации: если события лежат в БД, метка published=true и published_at позволит безопасно ре‑паблишить при сбоях.
Практические замечания:
- Партиционируйте по aggregate_id для сохранения порядка.
- Используйте снапшоты через N событий для ускорения восстановления.
- Для EOS внутри Kafka используйте транзакционный продюсер и координируйте коммиты смещений и выходных топиков.
Паттерн Listen to Yourself: Kafka как первичный источник истины и отложенное обновление БД
Идея: сервис сначала публикует собственное событие в Kafka, а затем сам же его потребляет, чтобы обновить свои хранилища. Тем самым любые изменения в БД опираются только на события, которые гарантированно попали в Kafka. Это инверсия причинности: Kafka становится источником истины для изменений состояния сервиса. Консистентность с БД - итоговая: между публикацией и применением существует окно, но «ложных» записей в БД без события не возникает.
Подходит, когда:
- Допустима краткая отложенность обновления read‑модели.
- Бизнес‑инварианты проверяются до публикации события.
- Сервис контролирует как продюсера, так и консюмера.
Декомпозиция Listen to Yourself: поток сервиса, собственный консюмер, идемпотентность и дедупликация
Поток обработки:
- Входящая команда валидируется и порождает доменное событие.
- Событие публикуется в Kafka с enable.idempotence и ключом aggregate_id.
- Собственный консюмер сервиса читает событие из Kafka и в транзакции обновляет БД.
Критический момент - атомарность «обработал событие в БД» и «зафиксировал прогресс чтения». Варианты:
- Вести таблицу «processed_events» с уникальным индексом по event_id. Сначала попытка вставить event_id, затем апдейт бизнес‑состояния; дубликаты отсеиваются БД.
- При использовании Kafka Streams/Consumer с EOS: транзакционный продюсер позволяет атомарно записать выходные сообщения и коммитнуть смещения; но коммит смещений не включает внешний апдейт БД, поэтому используйте внешнюю «таблицу смещений» в той же транзакции БД.
Идемпотентность достигается уникальными ключами и проверками версий агрегата (optimistic locking). Для долгих операций применяйте компенсации/оркестрацию.
Интеграция технологических стеков и их синергия: PostgreSQL, Cassandra, ClickHouse, Elasticsearch, Kafka, Debezium
- PostgreSQL + Debezium + Kafka: надёжная цепочка для Outbox/CDC, WAL обеспечивает упорядоченность, транзакционная целостность.
- Cassandra: для write‑heavy агрегатов и событийных журналов; гибкие уровни консистентности с вниманием к дедупликации и idempotent‑апсертам.
- ClickHouse: аналитические проекции; загрузки через Kafka Engine/Connectors с последующей материализацией.
- Elasticsearch: поисковые проекции; ingest‑конвейеры, внимание к обновлениям по id и версионности.
- Kafka Connect: стандартные коннекторы для CDC и слива проекций, централизованная конфигурация и мониторинг.
Синергия достигается строгими контрактами событий, едиными корреляционными идентификаторами и сквозной трассировкой.
Семантики доставки и транзакционность в Kafka: at‑least/at‑most/exactly‑once, idempotent producer, EOS
- At‑most‑once: минимальные задержки, риск потерь. Используется редко для критичных бизнес‑потоков.
- At‑least‑once: возможны дубликаты, но потери минимизированы. Дефолт для большинства продов; требует идемпотентных обработчиков.
- Exactly‑once (EOS) в Kafka: достигается транзакциями продюсера, координацией записи выходных сообщений и коммитов потребительских смещений. Гарантия распространяется на путь «consume‑process‑produce» внутри Kafka, но не покрывает внешние БД - там по‑прежнему нужна идемпотентность/транзакции.
Идемпотентный продюсер устраняет дубликаты публикаций при ретраях, но не снимает задачу идемпотентности на стороне потребителей.
Критерии выбора паттерна: транзакционность хранилища, требования к латентности, аудит, нагрузочные профили
- Требуется строгий аудит, детальная история, доменные инварианты сложны, транзакционная БД не обязательна - выбирайте Event Sourcing.
- Есть ACID‑БД, нужны минимальные изменения архитектуры, приемлема EDA‑интеграция - Transactional Outbox.
- Важна скорость реакции и слабое связывание, сервис контролирует свой контур, приемлема итоговая согласованность БД - Listen to Yourself.
Оценивайте латентность публикации, SLA целевых проекций, объёмы событий, сложность эволюции схем и требования к воспроизводимости (replay).
Риски и уязвимости: раздувание outbox, backpressure, «задние хвосты», потери при миграциях, рассинхронизация проекций
- Раздувание outbox: используйте TTL/архивацию, шардирование, индексы по статусу и дате, ограничение пакетов публикации.
- Backpressure: регулируйте частоту поллера, применяйте контролируемые ретраи с экспоненциальной паузой, квоты на брокере.
- Длинные хвосты (tail latency): диагностируйте узкие места - ISR‑кворумы, fsync, блокировки таблиц, перегруз коннекторов.
- Миграции: при backfill и replay соблюдайте порядок, используйте новые топики/версии схем, двойное письмо в период миграции.
- Рассинхронизация проекций: внедряйте контрольные точки (checkpoints), механизмы переиндексации проекций и инварианты сверки (audit trails).
Метрики эффективности и наблюдаемость: задержка публикации, лаг коннектора, коэффициент ретраев, пропускная способность, SLA/SLO/SLI
Наблюдаемость - обязательна. Измеряйте:
- End‑to‑end latency: от commit в БД до доставки событию потребителю.
- Lag CDC/Connect: difference в смещениях WAL/партиций.
- Retry ratio и DLQ объёмы: индикаторы качества доставки.
- Throughput (events/sec), p95/p99 задержек.
- Размер outbox и возраст старейшей записи в статусе NEW.
- SLA/SLO/SLI по задержкам публикации и доступности потребления.
Инструменты: метрики Kafka (JMX), Connect/Connectors, Prometheus/Grafana, трейсинг (OpenTelemetry), логическая корреляция по trace_id.
Кейсы применения: заказы и платежи, инвентаризация, логистика, биллинг, телеметрия, поисковые и аналитические витрины
- Заказы и платежи: Outbox для гарантий «заказ создан → событие создано», проекции для расчётов и уведомлений.
- Инвентаризация: Listen to Yourself для быстрой фиксации изменений в Kafka и асинхронного обновления складских остатков.
- Логистика: Event Sourcing для траектории посылок, аудита статусов и реконструкции маршрутов.
- Биллинг: Outbox + EOS в конвейере агрегаций, строгая идемпотентность при перерасчётах.
- Телеметрия: at‑least‑once с дешёвым дедупом на аналитике, высокая пропускная способность.
- Поиск и витрины: CDC/Outbox из PostgreSQL в Elasticsearch/ClickHouse, SLA по задержке индексации.
Отрасли экономики и сценарии использования: финтех, e‑commerce, телеком, здравоохранение, госсектор, промышленность
- Финтех: инварианты денежных операций, требования аудита** - Event Sourcing и Outbox с строгими контрольными процедурами.
- E‑commerce: высокая скорость изменений каталога/заказов - Listen to Yourself для низкой задержки, Outbox для интеграций.
- Телеком: биллинг/Cdr‑потоки - EOS в Kafka‑трубопроводах и гарантированные проекции.
- Здравоохранение и госсектор: регуляторные требования к трассируемости - событийные журналы и неизменяемые аудиты.
- Промышленность/IIoT: огромные потоки телеметрии - at‑least‑once с агрегированием и дедупликацией.
Конкурентный анализ решений: 2PC, XA, Saga (оркестрация и хореография) - гарантийные свойства и сложность внедрения
- 2PC/XA: формальная атомарность между ресурсами, но высокая связность, хрупкость при разделениях, сложная эксплуатация, ограниченная поддержка драйверами/брокерами. Часто неприемлемо по задержкам и отказоустойчивости.
- Saga: разбиение на локальные транзакции с компенсациями; оркестрация (центральный координирующий сервис) или хореография (через события). Снимает жёсткую атомарность, но требует проектирования компенсационных шагов и управления сложностью.
- Outbox/Event Sourcing/Listen to Yourself: фокусируются на детерминированной доставке событий и итоговой согласованности; проще внедряются на типовых стеках Kafka/БД и хорошо согласуются с EDA.
Ключевой критерий - стоимость владения и соответствие SLA. При сильных сетевых рисках и высокой нагрузке паттерны EDA почти всегда выигрывают по устойчивости и эволюционной гибкости.
Эксплуатация и надёжность: аварийное восстановление, тестирование отказов, миграции и эволюция событийных моделей
- DR/BCP: кросс‑кластерная репликация Kafka (MirrorMaker 2), резервные копии БД, периодические восстановительные учения.
- Тестирование отказов: fault injection/chaos testing - потеря лидера, длительные GC‑паузы, обрывы сети, деградация дисков, задержки CDC.
- Миграции: blue/green для коннекторов, поэтапный выкат схем (expand‑migrate‑contract), параллельная публикация в новые топики.
- Эволюция событийных моделей: совместимость схем как политика, инструменты reprocess/replay, версии handlers.
- Управление ключами безопасности и аудитом доступа: защита событий - это защита бизнеса.
Для outbox и event store критично иметь процедуры ре‑паблиша, дедупликации и переиндексации проекций с контролем порядков.
Ниже - пример конфигурации Debezium для PostgreSQL‑outbox и маппинга в доменный топик:
{
  "name": "inventory-outbox-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "database.hostname": "pg",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "secret",
    "database.dbname": "app",
    "slot.name": "debezium_outbox",
    "publication.autocreate.mode": "filtered",
    "table.include.list": "public.outbox_events",
    "tombstones.on.delete": "false",
    "transforms": "route",
    "transforms.route.type": "io.debezium.transforms.outbox.EventRouter",
    "transforms.route.table.fields.additional.placement": "headers:event_type:header",
    "transforms.route.route.by.field": "event_type",
    "transforms.route.route.topic.replacement": "domain.${routedByValue}"
  }
}
Такая конфигурация гарантирует, что вставка в outbox в одной транзакции с бизнес‑записью приведёт к публикации корректного события в Kafka, а дальнейшие сбои будут нивелированы ретраями и идемпотентностью.
Вопрос-Ответ:
-
Вопрос: Почему «двойная запись» неизбежно ведёт к неконсистентности в условиях отказов?
Ответ: Потому что между двумя независимыми системами нет общей транзакции; сбой в окне между записями создаёт либо потерю события, либо «ложное» событие. Нужен паттерн, сводящий атомарность к одному ресурсу и делающий вторую операцию воспроизводимой. -
Вопрос: Что даёт ack=all и enable.idempotence в Kafka?
Ответ: ack=all заставляет лидера ждать кворума реплик (минимум min.insync.replicas), повышая надёжность; enable.idempotence устраняет дубликаты публикаций при ретраях, обеспечивая упорядоченные, бездублированные записи от одного продюсера. -
Вопрос: Чем отличается Transactional Outbox от Event Sourcing?
Ответ: Outbox оставляет модель состояния в БД и публикует события из служебной таблицы; Event Sourcing хранит само состояние как журнал событий. ES даёт естественный аудит и воспроизведение, но требует иной доменной модели и инструментов снапшотов. -
Вопрос: Когда применим паттерн Listen to Yourself?
Ответ: Когда сервис может сначала публиковать событие в Kafka, а затем сам его потреблять для обновления своих хранилищ, принимая итоговую согласованность и выигрывая в скорости и простоте взаимодействий. -
Вопрос: Гарантирует ли EOS в Kafka exactly‑once для внешней БД?
Ответ: Нет. EOS охватывает путь внутри Kafka (consume‑process‑produce) и коммиты смещений. Для внешних БД по‑прежнему необходимы транзакции и/или идемпотентность с дедупликацией. -
Вопрос: Как контролировать рост outbox и лаг CDC?
Ответ: Вводить TTL/архивацию, индексацию по статусу/дате, шардирование, ограничение пачек публикации; мониторить возраст старейшей записи и лаг коннектора, масштабировать коннекторы и брокер. -
Вопрос: Какие ключевые метрики наблюдать?
Ответ: End‑to‑end задержка публикации, лаг коннекторов и консюмеров, коэффициент ретраев и объём DLQ, p95/p99, пропускная способность, размер outbox и SLA/SLO/SLI по доступности и задержкам. -
Вопрос: Почему 2PC/XA редко выбирают в микросервисах?
Ответ: Из‑за высокой связности, хрупкости при сетевых разделениях, сложности эксплуатации и существенных задержек. Паттерны EDA с Kafka достигают сопоставимых бизнес‑гарантий проще и надёжнее.