

Построение многомерных хранилищ данных с помощью dbt
Введение
Сегодня я с удовольствием приступаю к реализации увлекательнейшего проекта, связанного с использованием мощного инструмента dbt для создания передового хранилища данных.
В последнее время профессия инженера-аналитика, объединяющего в себе навыки аналитика и инженера по обработке данных, стала одной из самых востребованных в мире данных. Будучи ярым поклонником этой сферы деятельности, я стараюсь следить за всеми новыми технологиями и методами аналитического инжиниринга, что позволяет мне стремительно подниматься по карьерной лестнице и становиться экспертом, способным принести максимальную пользу своей компании.
У меня есть некоторый опыт работы с dbt, при этом я признаю, что существуют аспекты, в которых которые мне еще только предстоит разобраться, и этот новый проект – отличная возможность изучить все преимущества использования данного инструмента.
База данных: Northwind Traders
База данных Northwind Traders, созданный компанией Microsoft в целях обучения новых пользователей, представляет собой массив данных о продажах вымышленной компании, управляющей заказами, продуктами, клиентами, поставщиками и многими другими аспектами малого бизнеса.
Задача: Модернизация инфраструктуры Northwind Traders
В настоящее время компания Northwind Traders использует сочетание локальных и унаследованных систем, при этом основной системой управления реляционными базами данных является MySQL. Существующая архитектура поддерживает возможность регистрации операций между компанией и ее клиентами, а также генерирует отчеты и потенциальные аналитические решения. Однако растущие требования к отчетности приводят к замедлению работы БД, что негативно сказывается на деятельности компании в целом.
Таким образом, решение о модернизации инфраструктуры обусловлено необходимостью улучшения масштабируемости, снижения нагрузки на операционные системы, повышения скорости подготовки отчетов и защиты безопасности данных.
Рекомендованное решение: Переход на облачную платформу Google Cloud
Для решения поставленной задачи я предложил перейти на облачную платформу Google Cloud. В целях оптимизации способов составления отчетности мы планируем перенести MySQL на GCP Managed Services. Кроме того, на облачной платформе Google Cloud мы создадим многомерное хранилище данных с использованием BigQuery и сделаем его основным OLAP-решением для соблюдения всех требований, предъявляемым к отчетности. Таким образом, я предлагаю стать последователями методологии Кимбалла.
Определение основных пожеланий: Уточнение бизнес-процессов
Подробно поговорив с акционерами компании, мы выявили несколько первостепенных требований в плане отчетности:
- Анализ продаж: исчерпывающие отчеты о продажах, позволяющие понять предпочтения покупателей, выявить наиболее востребованные товары, а также товары с низкими показателями, а также получить общее представление о результатах деятельности компании;
- Анализ деятельности торговых представителей: мониторинг объема продаж и эффективности работы каждого торгового представителя в целях оптимизации комиссионных выплат, поощрения высоких показателей и корректировки деятельности агентов, работающих неэффективно;
- Анализ продукции: анализ текущих складских запасов, улучшение метода управления запасами и заключение более выгодных сделок с поставщиками;
- Анализ клиентов: предоставление клиентам информации об истории их покупок, что позволит им принимать более взвешенные решения на основе полученных данных. Этот отчет также поможет специалистам по работе с клиентами и маркетологам лучше понять потребности клиентов для проведения эффективных кампаний.
Профилирование данных: Понимание системы и данных
На данном этапе мы осуществляем профилирование данных для оценки их целостности, что позволит нам получить полную разбивку их статистических характеристик, таких как количество ошибок, количество предупреждений, процент дубликатов и т.д. Целью данного этапа является проведение детальной проверки данных, формирование концептуальной модели данных, а также ускорение процесса разработки проектных решений.
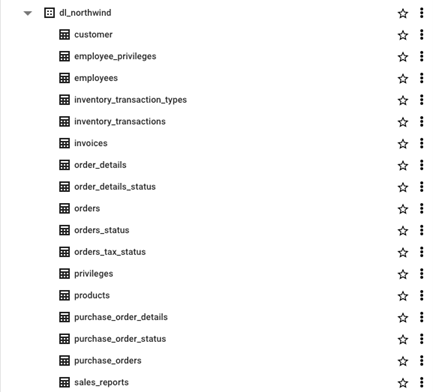
Например, наша таблица клиентов содержит 30 записей.
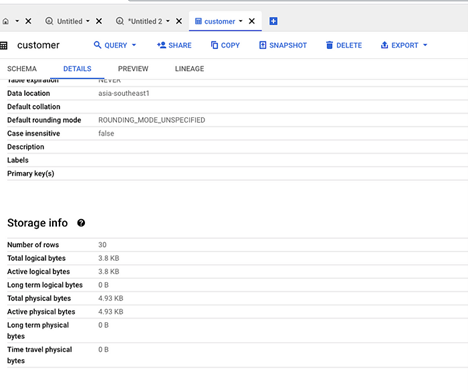
Таблица «Customer»
Напишем простой запрос, который покажет количество уникальных ID, и посмотрим на полученный результат:
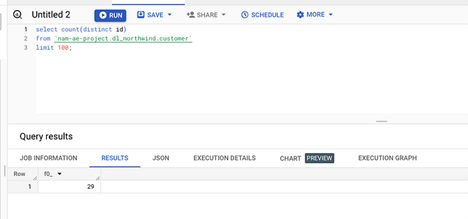
Результат 29 свидетельствует о том, что мы имеем дело с дубликатом, таким образом, во время преобразования данных на стадии staging area мы должны будем уделить внимание данной проблеме.
После того, как мы разобрались с таблицей Customer, необходимо повторить эту операцию для всех остальных таблиц, которые мы считаем необходимыми для построения размерного хранилища данных.
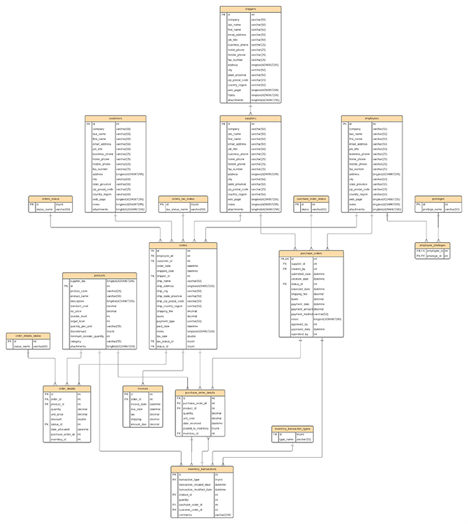
Поскольку таблиц достаточно много, предлагаю построить ER- диаграмму, которая позволит нам определить самые важные таблицы. В нашем случае это таблица “Customer”. Так что, быстро взглянув на нее, я могу сказать, что клиент - очень важная таблица, тесно связанная с таблицей “Orders”.
Бизнес – матрица и Концептуальное моделирование
Основываясь на полученной информации, мы можем смоделировать бизнес-процесс высокого уровня. Определения данного бизнес-процесса послужит отправной точкой для последующего концептуального моделирования.
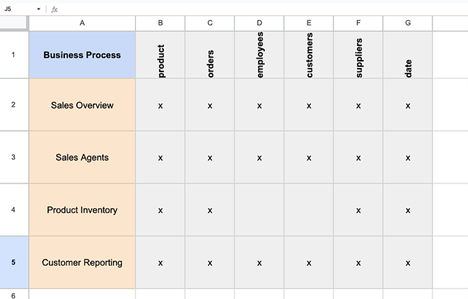
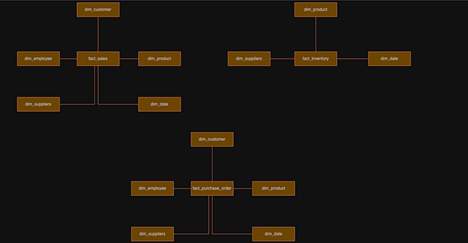
После этого мы создаем концептуальную модель, в которой описываются таблицы фактов и таблицы измерений. Эта концептуальная модель заложит основу для последующих этапов моделирования.
Итак, на основе полученной информации мы создадим бизнес-процесс высокого уровня, определенный ранее.
Проект архитектуры
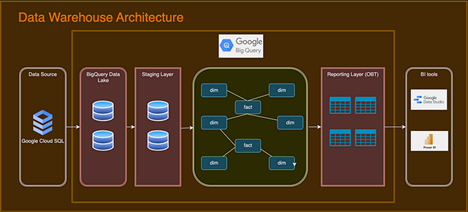
Наиболее подходящая архитектура для этого проекта аналитического инжиниринга разработана таким образом, чтобы использовать все возможности платформы Google Cloud (GCP), обеспечивая при этом эффективную и масштабируемую инфраструктуру данных:
- Источники данных и переход на платформу: проект предполагает, что команда разработчиков успешно перенесла локальное решение MySQL на платформу Google Cloud SQL. Эта миграция гарантирует доступность данных из исходных источников для дальнейшей обработки;
- BigQuery для Data Lake: необработанные данные из перенесенной базы данных MySQL загружаются в слой BigQuery Data Lake. По сути, он дублирует источники данных MySQL OLTP, создавая тем самым централизованное хранилище для всех необработанных данных. Наличие Data Lake позволяет избежать прямых запросов к источнику данных, что значительно снижает нагрузку на систему транзакционных баз данных и повышает производительность в целом;
- Staging Area: Из озера данных данные направляются в Staging Area, далее происходит преобразование и очистка данных. Этот важнейший этап обеспечивает стандартизацию и оптимизацию данных для последующих процессов моделирования;
- Слой многомерного хранилища данных: очищенные и преобразованные данные используются для построения размерных моделей на уровне многомерного хранилища данных. Этот шаг крайне важен для создания организованного хранилища данных, способствующего эффективной аналитике данных и формированию исчерпывающих отчетов;
- One Big Table (OBT): чтобы упростить отчетность и подключить данные к инструментам бизнес-аналитики (BI), я предлагаю создать OBT - консолидированную таблицу, объединяющую все необходимые данные из разных источников. Такой подход упрощает поиск данных и ускоряет процессы создания отчетов в рамках работы с данными.
Используя данную архитектуру, мы сможем провести эффективную модернизацию данных Northwind Traders. Учитывая все возможности GCP и dbt в области трансформации данных, многомерное хранилище данных снабдит Northwind Traders ценными сведениями и позволит осуществлять бизнес-аналитику в кратчайшие сроки. Кроме того, создание OBT позволит ускорить доступ к данным и расширит возможности компании в области принятия эффективных бизнес-решений.
Многомерное моделирование
Многомерное моделирование является важнейшим этапом проекта, закладывающим основу для эффективной организации данных. Этот этап основывается на концептуальной модели, при этом включает дополнительные требования для уточнения структуры данных.
На этом этапе я разговариваю с акционерами компании и уточняю их приоритеты. В результате опросов мы определили, что " Анализ продаж" и "Анализ клиентов" являются приоритетными, поскольку предоставляют ценные сведения о поведении клиентов и общей эффективности продаж. "Анализ деятельности торговых агентов" имеет средний приоритет, поскольку помогает отслеживать индивидуальные показатели продаж и соответствующим образом корректировать комиссионные выплаты. И наконец, "Анализ продукции", хотя и имеет важное значение, но все же обладает самым низким приоритетом.
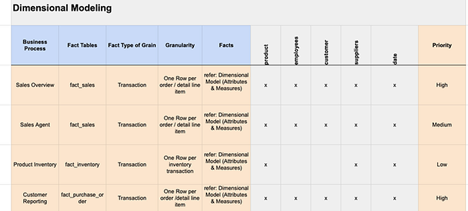
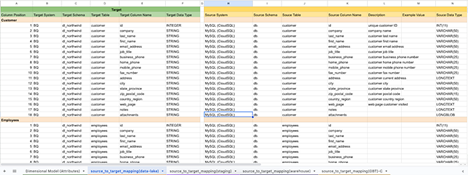
Учитывая архитектурную диаграмму, описывающую поток данных от Google Cloud SQL к Data и все уровни, упомянутые выше, я формирую общий документ, отображающий основные цели в области организации данных. Этот документ подробно разъясняет, как данные будут преобразовываться и сопоставляться на каждом этапе, обеспечивая плавный поток данных на протяжении всего процесса миграции.
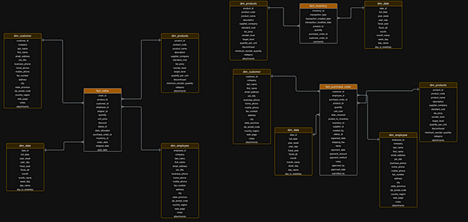
Имея полное представление о целях и приоритетах, я могу приступить к построению логической модели, которая будет отображать высокоуровневую структуру хранилища данных, а также взаимосвязи между таблицами фактов и связанными с ними многомерными таблицами.
Логическая модель
Построение логической модели предполагает работу с таблицами фактов, в которой определены основные бизнес-метрики или ключевые показатели эффективности (KPI). Они будут использоваться для последующего анализа и составления отчетности. Для каждой таблицы фактов определяются соответствующие показатели, что гарантирует оптимальную организацию данных, призванную облегчить проведение всестороннего анализа и глубокое понимание полученных инсайтов.
Физическая модель
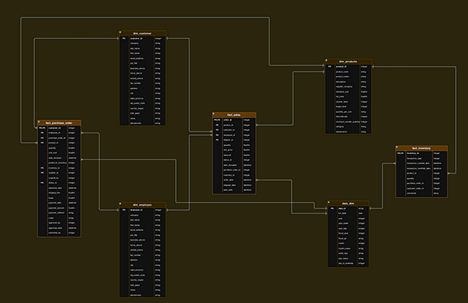
Следующий этап - это создание физической модели и разработка проекта хранилища данных. На этом этапе логическая модель преобразуется в описание конкретной реализации БД. Логическое проектирование отвечает на вопрос «ЧТО надо сделать», а физическое планирование – на вопрос «КАК это сделать?»
Документ, сопоставляющий ресурсы и цели, служит ценным справочным материалом при создании физической модели. Он направляет настройку хранилища данных в нужное русло, обеспечивая беспрепятственный поток данных от исходных систем к уровням, описанным выше.
DBT для преобразования данных
На этапе создания физической модели DBT служит основным инструментом преобразования данных, выполняющим такие функции, как очистка, агрегирование и сортировка данных. Использование DBT в разы упрощает разработку слоя хранилища данных.
На данном этапе учитываются все требования, предъявляемые к создаваемому хранилищу данных. Построенная физическая модель подробно описывает реализацию объектов логической модели, а также выводы, полученные на основе документа, сопоставляющего ресурсы и цели.
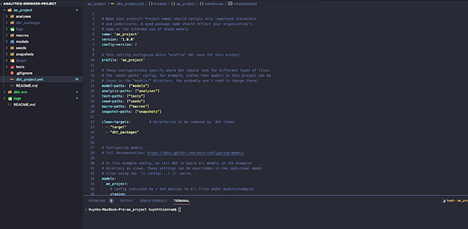
Проект dbt — это каталог файлов SQL и YAML, используемый для преобразования данных. dbt_project.yml — это файл конфигурации проекта dbt, который содержит имя проекта и информацию о файле конфигурации базы данных.
Вкратце расскажу об основных папках, облегчающих процесс преобразования данных в рамках проекта dbt:
- Макросы - универсальные фрагменты используемого кода напоминают функции в языках программирования. Они позволяют поддерживать SQL-код в состоянии DRY (Don't Repeat Yourself). Включение Jinja в папку "Macros" повышает динамичность SQL-кода, способствуя повышению его гибкости;
- Модели: «сердце» преобразования данных находится в папке "Models". Здесь в дело вступают файлы SQL, определяющие, как данные будут преобразованы, очищены и агрегированы. Используя гибкость dbt, мы можем тщательно структурировать и упорядочить наши модели, обеспечивая систематизированный подход к преобразованию данных;
- Моментальный снимок: для эффективного управления медленно изменяющимися измерениями (SCD) крайне важна папка "Snapshot". Механизм крайне важен для отслеживания изменений значений аналитических измерений в хранилище данных. Функция "Snapshot" в dbt позволяет эффективно обрабатывать эти изменения, сохраняя целостность данных;
- Тесты: в папке “Tests’’ осуществляется проверка полученных данных. С помощью возможностей тестирования dbt мы можем проверять предположения о данных и SQL-файлах. Существует два подхода к тестированию - единичное тестирование, при котором SQL-запросы возвращают неудачные записи, и генетическое тестирование, позволяющее проводить повторные тесты, такие как проверка нулевых значений или проверка уникальности.
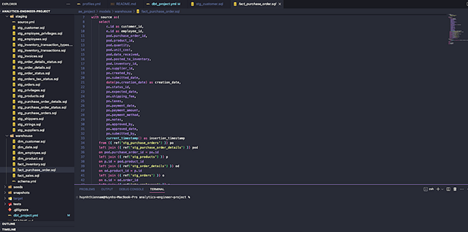
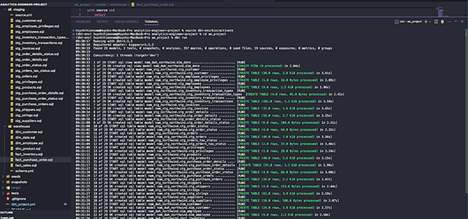
Как Вы можете видеть, я уже создал слой хранилища данных, а также OBT. Результат моих действий будет выглядеть следующим образом:
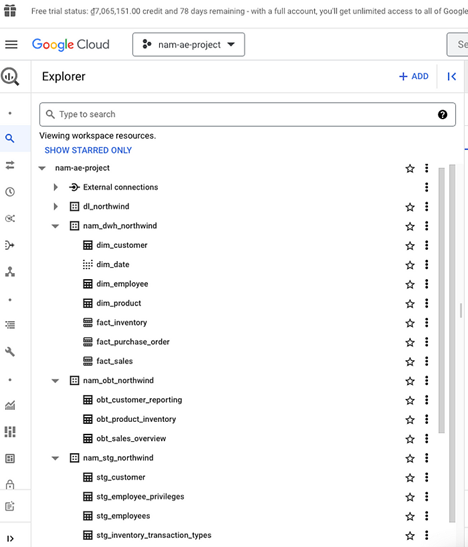
В Google BigQuery будет 3 слоя:
Репозиторий Gitlab
Для того, чтобы обеспечить бесперебойную совместную работу, я организовал и разместил весь код и ресурсы, связанные с этим проектом, на GitLab. Репозиторий доступен по следующей ссылке: https://gitlab.com/namhuynh.ftu/analytics-engineer-project
Заключение
Данный проект dbt является важнейшим этапом в процессе модернизации системы данных и отчетности компании Northwind Traders. Используя всю мощь dbt в сфере преобразования данных, мы стали на шаг ближе к получению исчерпывающей бизнес-аналитики и формированию корпоративной культуры принятия решений на основе данных. Созданное многомерное хранилище данных послужит основой для расширения масштабируемости, повышения скорости создания отчетов и повышения уровня безопасности данных, что сулит безоблачное будущее в сфере бизнес-аналитики.


