

Что такое Apache Iceberg
Автор статьи – Жюльен Хюро, инженер-консультант, специализирующийся на создании современных платформ данных. В данной статье он подробно расскажет Вам об Iceberg, а также о своих открытиях, сделанных в процессе изучения данного продукта.
В этой статье собрано все, что я узнал об Iceberg за последний месяц. Да, она получилась немного длинноватой, но все же я надеюсь, что она Вам понравится!
26.07.2024 – вот-вот в Париже начнутся Олимпийские игры.
Вы только что приехали в Париж и начали искать забронированную Вами гостиницу.
И вдруг - «катастрофа»...
Ваше новое приложение на базе ИИ отказывается (уже в который раз ) понимать то, как Вы произносите название своей гостиницы - "L'Hôtel Élégance”.
Хм… Так как же ее найти?
К счастью, Вы помните, что за сутки проживания в отеле Вы заплатили около 600 евро (как такое можно забыть ?!).
Вдруг в шумном кафе аэропорта Вы замечаете достаточно доброжелательного на первый взгляд человека, похожего на парижанина.
"Прошу прощения," – говорите Вы. "Я пытаюсь найти свою гостиницу, но помню лишь то, что заплатил за сутки проживания в ней около 600 евро. Можете ли Вы помочь мне?”
Парижанина зовут Готалак. Не прекращая читать свою газету, он наотрез отказывается помочь Вам, сказав короткое «Нет».
Ох уж эта знаменитая парижская гостеприимность…
Вы уже собираетесь уходить, как вдруг Готалак кричит: «Подождите!» и дальше буквально бормочит себе под нос, что знает несколько таксистов, которые могла бы Вам помочь.

Он показывает на длинную очередь такси, припаркованных на улице. «Вон то, может быть... а, нет, слишком старое. А вот это... ммм... тоже. Вот! вот это подойдет!», - наконец восклицает он.
Энергично размахивая руками, он подзывает к себе водителя. «Эй, иди скорее сюда!»
Поболтав по-французски с Готалаком, «наш водитель» поворачивается к нам и, улыбаясь, говорит: «Я помогу Вам! Сегодня Вы – настоящий счастливчик! Несмотря на то, что я не знаю точную стоимость проживания в каждом отеле Парижа, я примерно ориентируюсь в минимальных и максимальных ценах для каждого района. Это сузит наш круг поиска”
Звучит обнадеживающе!
Вместо того, чтобы ездить от одного отеля к другому, «сканируя» тем самым столицу Франции, мо можем сосредоточиться только на тех районах, где есть гостиницы в нашем ценовом диапазоне.
В процессе обращения к ворчливому парижанину, его сканирования очереди такси и взаимодействия с таксистом Вы получили доступ к метаданным, которые помогли Вам сузить круг поиска.
То же самое делает и Iceberg: он устанавливает стандарт для выявления метаданных, а также для формирования статистики о файлах, хранящихся в Data Lake.
Данный формат из трех компонентов: каталога, файлов vx.metadata.json (моментальных снимков) и файлов манифеста.
В нашем случае они представлены следующим образом:
- Файлы данных = стоимость проживания в отеле за сутки.
- Файл манифеста = самая низкая и самая высокая стоимость проживания в гостиницах в каждом районе Парижа.
- Моментальные снимки/ vx.metadata.json = стоимость проживания в гостиницы на определенный момент времени
- Файл такси = история стоимости проживания в гостинице в Париже (все исторические моментальные снимки).
- Каталог = ворчун, указывающий на таксиста, владеющего актуальными сведениями о стоимости проживания в гостиницах Парижа.
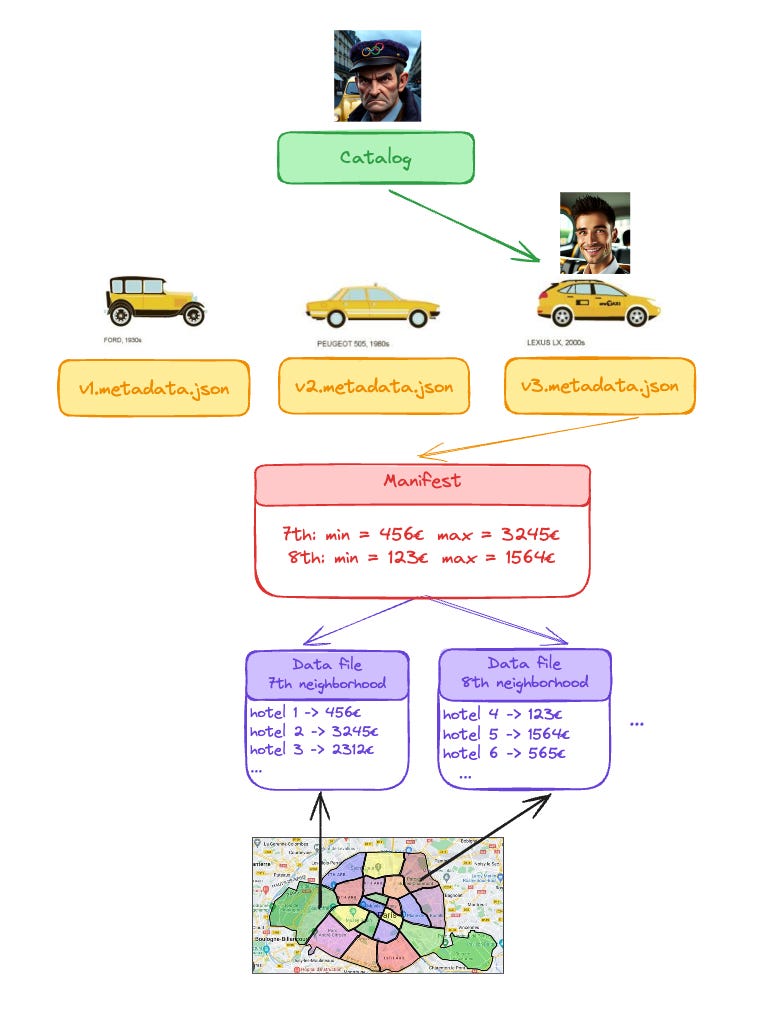
Одна из абстракций, которую мы упустили в этой истории, - это файлы со списком манифестов, содержащие в себе статистику о группе файлов данных и отслеживающие все связанные с ними манифесты, а также некоторую агрегированную статистику.
Ниже приведен более формальный обзор организации метаданных в Iceberg, а также того, как к ним обращается механизм запросов.

Характеристики Iceberg
Iceberg предлагает своим пользователям гораздо больше, чем просто просмотр метаданных; он преобразует файлы, хранящиеся в Data Lake, в правильные таблицы баз данных!
Рассмотрим ключевые характеристики Iceberg:
- Стабильное выполнение условий ACID
ACID расшифровывается как Atomicity (атомарность), Consistency (консистентность), Isolation (изоляция) и Durability (наденость). Эти четыре важнейших свойства гарантируют целостность данных, даже если во время транзакции возникает какая-либо проблема.
Система управления метаданными Iceberg, в частности изоляция моментальных снимков гарантирует, что пока какая-либо транзакция не будет завершена, в БД невозможно будет внести никакие изменения. Поэтому транзакция либо полностью завершается, обновляя все необходимые данные, либо заканчивается неудачей, оставляя все как было.
Изоляция моментальных снимков позволяет нескольким пользователям одновременно читать и заносить записи в базу данных, не мешая друг другу. Эта функция особенно полезна для предотвращения конфликтов, когда разные пользователи пытаются одновременно обновить одни и те же данные.
NB: Для обеспечения атомарности транзакций необходимо использовать каталог.
- Партиционирование
Партиционирование в разы повышает скорость выполнения запросов за счет объединения схожих данных в группы, что сокращает количество файлов, которые приходится открывать механизму.
Одним из наиболее распространенных методов партиционирования, используемых в Data Lake, является партиционирование Hive, в рамках которого разделение упорядочивает данные в иерархию папок на основе значений определенных столбцов.
Например, наши данные об отеле могут храниться в бакете S3 следующим образом:
/hotel-prices/neighborhood=7/pricing-date=2024-04-12/prices.parquet
Здесь файл данных содержит стоимости проживания для определенного района на определенную дату.
Однако такая структура может затруднить доступ к данным.
Например, чтобы проверить цены в разных районах на определенную дату, Вам придется открыть множество файлов, что неэффективно.
Одним из решений повышения эффективности может быть перегруппировка данных:
/hotel-prices/pricing-date=2024-04-12/neighborhood=7/prices.parquet
Однако это подразумевает переписывание данных для обработки различных запросов.
Вместо этого Iceberg предлагает интеллектуальный способ управления разделами с помощью метаданных, а не структуры папок, что позволяет изменять способ разделения данных путем корректировки метаданных без перемещения самих данных.
Кроме того, Iceberg выполняет функцию скрытого партиционирования.
Например, если Вы хотите разделить данные по дате ценообразования на ежемесячной, а не ежедневной основе, Вам придется вручную определять месяц для каждой даты и сохранять его в таблице.
Однако с помощью Iceberg можно автоматически выполнить эти операции с помощью таких встроенных функций как год(), месяц(), день() и час().
Например, чтобы разделить таблицу по месяцам, можно воспользоваться функцией month():
CREATE TABLE hotel_prices(
        pricing_date  date,
        hotel_id      int,
        price         double,
)USING iceberg
PARTITIONED BY (month(pricing_date))
Фактические значения партиционирования не видны конечному пользователю, поэтому этот процесс называется «скрытым партиционированием».
- Отслеживание изменений
Iceberg отслеживает все обновления таблиц, создавая отдельные снимки для каждого изменения.
Эта функция позволяет легко вернуться к предыдущей версии таблицы, если это необходимо.
Чтобы вернуться к более ранней версии, каталог Iceberg просто указывает таблице на нужный файл моментального снимка.
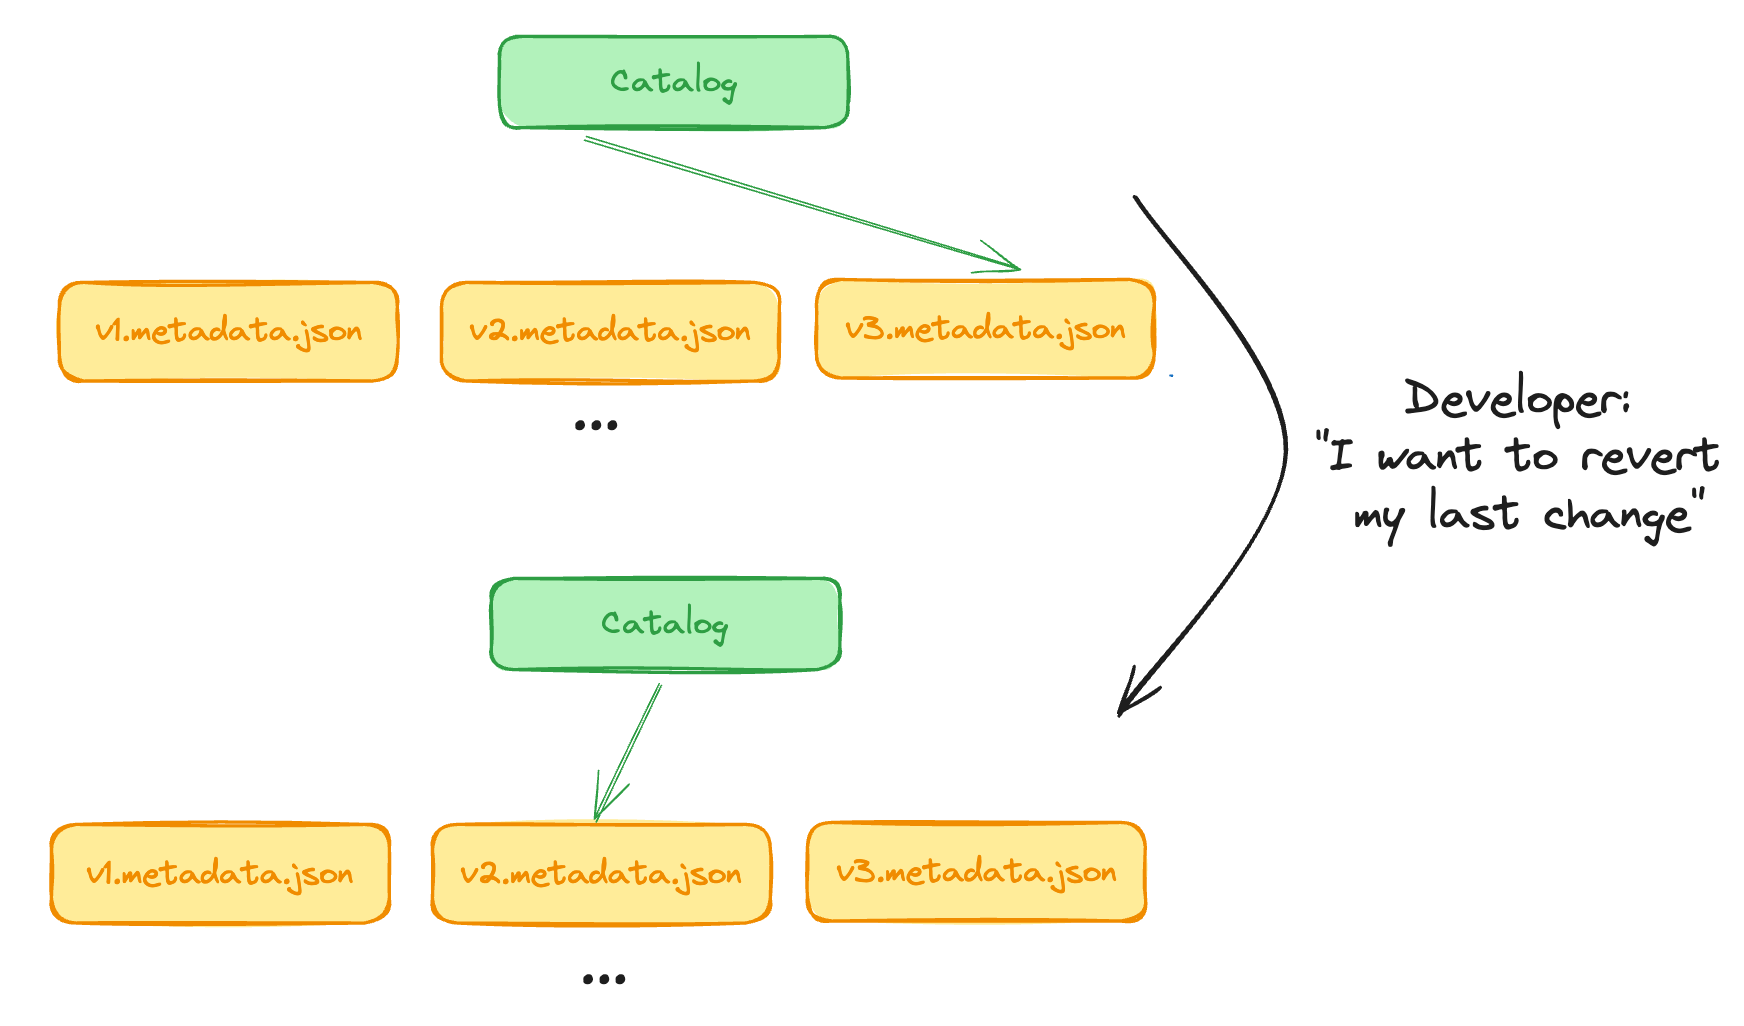
Это также позволяет создавать виртуальные копии данных по аналогии со Snowflake или выполнять функцию клонирования нулевой копии наподобие Databrick.
Обслуживание Apache Iceberg
Эффективность обработки запросов зависит от количества файлов, к которым база данных должна обращаться во время выполнения запроса. Работа с потоковыми данными, которые часто создают множество небольших файлов, может замедлить работу Iceberg.
Для решения этой проблемы используется процесс, называемый уплотнением, при котором небольшие по размеру файлы данных объединяются в более крупные. Это уменьшает количество файлов, к которым база данных должна получить доступ, что повышает эффективность работы в целом.
Некоторые каталоги, например, Glue, предлагают автоматическое уплотнение для таблиц Iceberg.
Уплотнение может быть простым (простое объединение файлов в случайном порядке) или сложным, включающим в себя сортировку записей перед объединением файлов.
Экосистема Iceberg
Реализация каталогов
Каталог в Iceberg играет важнейшую роль, поскольку выступает в качестве централизованного узла. Он предоставляет механизму запросов всю необходимую информацию для доступа к метаданным таблицы и обеспечивает корректную обработку транзакций.
Существует несколько типов реализаций каталогов, каждый из которых подходит для различных сред и потребностей:
- Open-source каталоги: Hive Metastore, Apache Nessie
- Каталоги вендоров: AWS Glue, Snowflake Catalog, Dremio Catalog, Starburst Catalog, GCP BigLake Metastore
- Каталоги JDBC: PostgreSQL catalog, AWS DynamoDB catalog
- Каталог REST (более подробная информация предоставлена ниже)
Выбор правильного каталога определяется комбинацией сразу нескольких факторов:
- Совместимость – убедитесь том, что Ваш каталог поддерживает операции чтения и записи с механизмами запросов, которые Вы планируете использовать.
- Управление инфраструктурой - некоторые каталоги требуют дополнительной инфраструктуры, например, базы данных для каталога PostgreSQL или выделенного сервера для Nessie и Hive.
- Поддержка транзакций - если Ваш сценарий использования включает в себя сложные транзакции по нескольким таблицам, выбирайте каталоги, поддерживающие эти функции.
Каталог REST
Каталог REST в Apache Iceberg - это, по сути, стандартный интерфейс API для взаимодействия с каталогом Iceberg посредством HTTP-запросов.
В нашей истории с отелем это было бы похоже на заполнение стандартной анкеты для общения с ворчливым парижанином.
Каталог REST предоставляет стандартный интерфейс API, но фактическая реализация может отличаться в зависимости от используемой внутренней системы.
Такая конструкция обеспечивает согласованность интерфейса независимо от конкретной технологии или системы, выполняющей операции с каталогом. В результате это повышает функциональную совместимость и снижает степень привязки к тому или иному производителю.
Apache Nessie
Способ, которым Apache Iceberg обрабатывает мгновенные снимки при каждом обновлении таблицы, похож на системы контроля версий, такие как Git.
Apache Nessie использует эту концепцию, предлагая Git-подобную семантику для управления данными в таблицах Iceberg:
- снапшоты как коммиты - подобно коммитам Git, каждый снимок в Iceberg представляет собой определенное состояние таблицы в определенный момент времени. Это позволяет отслеживать изменения и при необходимости возвращаться к предыдущим версиям;
- ветви - Как и Git, Nessie использует ветви для управления различными линиями разработки или тестирования наборов данных. Каждая ветвь представляет собой последовательность снимков, что позволяет параллельно работать над разными версиями данных без помех.
- команда merge - когда изменения из одной ветки готовы к интеграции в основной набор данных, их можно объединить, аналогично объединению веток в Git.
Гибкость, обеспечиваемая этим подходом, особенно ценна для реализации шаблона аудита записи.
Война каталогов
Каталог в Iceberg является важнейшей точкой доступа к Data Lake.
Когда поставщик контролирует этот каталог, он, по сути, контролирует доступ к данным и становится охранником данных.
Если движок хочет прочитать/записать таблицу, он сначала должен спросить у каталога, где найти ее метаданные.
Такая позиция контроля дает стратегические преимущества для бизнеса: Вы можете ограничивать взаимодействие с другими платформами или поощрять интересные интеграции.
Эта проблема становится очевидной при рассмотрении возможностей чтения/записи каталогов, управляемых поставщиками услуг хранения данных.
Например, Snowflake может читать только записи из внешнего каталога, а внешний каталог может читать только из каталога Snowflake.
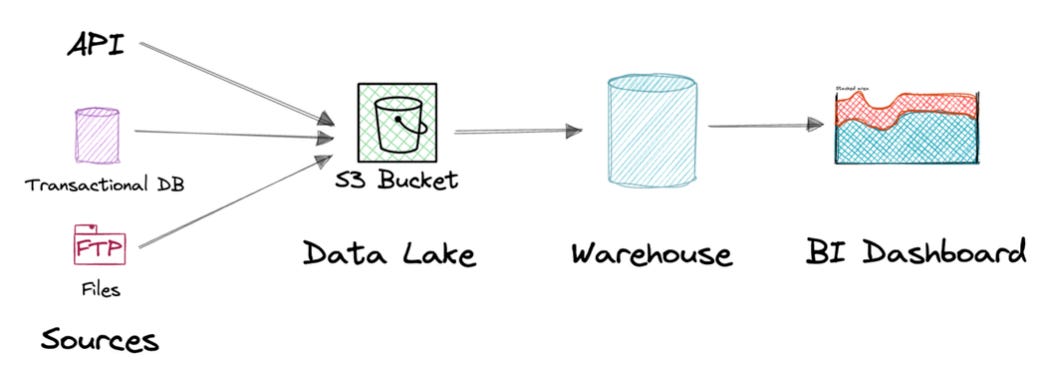
Это ограничение не позволяет пользователям иметь единый, универсально доступный каталог, который также может записывать данные в собственные таблицы Snowflake.
Эта тенденция характерна не только для Snowflake: другие провайдеры, такие как Dremio, Starburst и Databricks поступают так же - они подталкивают пользователей к использованию своих каталогов, ограничивая функциональность таблиц, не управляемых ими.
Чтобы решить эту проблему, Вы можете использовать несколько каталогов, предназначенных для определенных таблиц. Затем можно передавать данные между этими каталогами с помощью таких команд, как:
CREATE TABLE snowflake_iceberg_table AS SELECT * FROM external_engine_iceberg_table
PyIceberg
PyIceberg - это библиотека Python, предназначенная для работы с таблицами Iceberg. Она напрямую поддерживает ряд каталогов, например, REST, SQL, Hive, Glue и DynamoDB..
Каталог настраивается с помощью конфигурационного файла YAML, хранящегося в ~/.pyiceberg.yml:
# Glue Catalog
catalog:
  default:
    type: glue
    aws_access_key_id: <ACCESS_KEY_ID>
    aws_secret_access_key: <SECRET_ACCESS_KEY>
    aws_session_token: <SESSION_TOKEN>
    region_name: <REGION_NAME>

# DynamoDB Catalog
catalog:
  default:
    type: sql
    uri: postgresql+psycopg2://username:password@localhost/mydatabase

# REST Catalog
catalog:
  default:
    uri: http://rest-catalog/ws/
    credential: t-1234:secret
После настройки и загрузки каталога в PyIceberg Вы можете создавать пространства имен (аналогичные схемам в других базах данных) и таблицы.
В приведенном ниже примере схема таблицы напрямую выводится из файла parquet.
from pyiceberg.catalog import load_catalog
import pyarrow.parquet as pq
import os

# LOAD CATALOG
catalog = load_catalog("glue")

# CREATE SCHEMA
catalog.create_namespace("paris_og")

# CREATE TABLE
catalog.create_table(
    "paris_og.hotel_prices",
    schema=pq.read_table("/tmp/hotel_prices.parquet").schema,
    location="s3:///paris_og/hotel_prices",
)
PyIceberg поддерживает два режима записи данных: «append», который добавляет новые данные в существующую таблицу, и «overwrite», который заменяет существующие данные в таблице. Возможность Слияния пока не поддерживается.
import pyarrow.parquet as pq
from pyiceberg.catalog import load_catalog

catalog = load_catalog(name="glue")
table = catalog.load_table("paris_og.hotel_prices")
df = pq.read_table("/tmp/hotel_prices_2024-04-04.parquet")
table.append(df)
Для работы с данными в PyIceberg используется Apache Arrow - формат, разработанный для эффективного хранения колоночных данных в памяти. Этот формат хорошо совместим с различными механизмами обработки данных. Например, DuckDB, база данных in-memory, может напрямую взаимодействовать с наборами данных, хранящимися в формате Arrow.
Это означает, что вы можете использовать DuckDB для выполнения запросов к данным, а затем напрямую передавать результаты запросов обратно в формат Arrow.
from pyiceberg.catalog import load_catalog

catalog = load_catalog(name="glue")

# Load data from Iceberg into DuckDB
con = catalog.load_table("paris_og.hotel_prices").scan().to_duckdb(table_name="hotel_prices")

# Run SQL in DuckDB and send back the result to Arrow
output = con.execute("""
        SELECT *
        FROM hotel_prices
        WHERE price > 1000
""").arrow()

# Write output in Iceberg table
catalog.load_table("paris_og.my_hotel").overwrite(output)
Стоит отметить, что PyIceberg удивил своих пользователей поистине впечатляющими результатами!
Примеры использования Iceberg
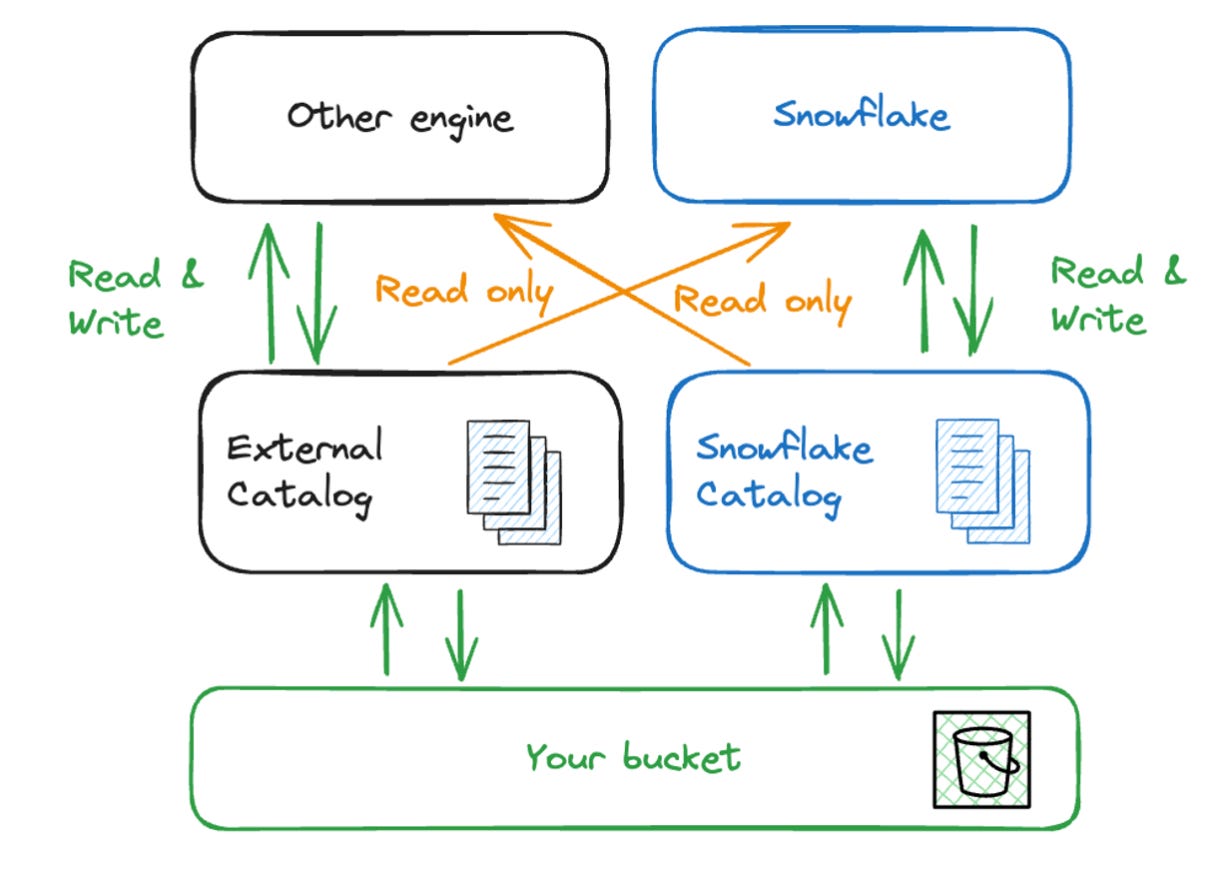
Платформы данных обычно работают по определенной схеме: данные хранятся в озере данных, затем перемещаются в хранилище данных для очистки и объединения, и только после этого используются в аналитических целях.

Поддержание процесса ETL между Data Lake и DWH предполагает дублирование данных, что чревато ошибками.
Благодаря использованию Iceberg в Data Lake данные можно загружать в хранилище без копирования.
Это основной вариант использования Iceberg: запрос данных без их копирования.
“Побочным эффектом” данной операции является обеспечение совместимости вычислительных машин. Любой движок может получить доступ к данным, не привязываясь к конкретному провайдеру.
Пользователи могут выбрать оптимальный движок в зависимости от размера набора данных, задержки конвейера или сложности преобразования.
Благодаря использованию Iceberg в озере данных данные можно загружать в хранилище без копирования.
Это основной вариант использования Iceberg: запрос данных без их копирования.
Побочным эффектом этого является обеспечение совместимости вычислительных машин. Любой движок может получить доступ к данным, не привязываясь к конкретному провайдеру.
Пользователи могут выбрать оптимальный движок в зависимости от размера набора данных, задержки конвейера или сложности преобразования.
Если продвинуть эту мысль еще дальше, то в Iceberg вся «тяжесть» стека должна сместиться со склада на озеро.
В качестве заключения хотелось бы отметить, что хранилище и вычислительные машины вскоре станут самыми настоящими товарами. Они будут использоваться на регулярной основе, систематически читая данные из Iceberg..
… не находите, что это очень похоже на сверхфункции Lambda ?


