

От реляционных БД до Data Lakehouse: краткая история развития систем управления данными
Бизнес-аналитика и инженерия данных - относительно новые направления в сфере работы с данными. Зарождение анализа данных можно датировать началом XX века, однако его настоящий расцвет приходится на разгар эпохи информационных технологий. Сегодня все достаточно просто - успеха добьются только те, кто обладает полезными данными (собирают их) и умеет извлекать из них ценные инсайты для развития своего бизнеса.
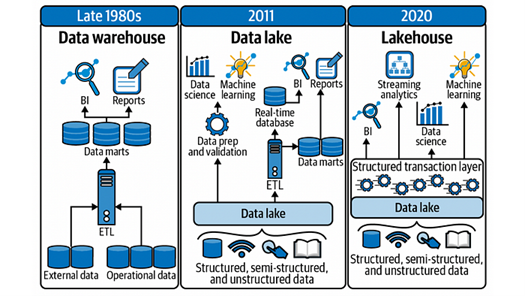
1980 - е годы
В 1980-х годах крупные компании работали с реляционными БД и для того, чтобы получить интересующие их данные, использовали SQL. Первые упоминания об этом языке датируются 1974 годом, таким образом, ему уже 50 лет! В какой-то момент компании столкнулись с ограничениями реляционных БД в плане обработки аналитических запросов в следствие чего появилась концепция бизнес DWH.
Сейчас это нечто само собой разумеющееся, но в те время это было настоящим прорывом. Основные преимущества данного подхода заключаются в следующем:
- Ускорение BI процессов;
- Повышение эффективности работы со структурированными данными.
Естественно, у него есть и недостатки:
- Сложности работы с неструктурированными и полуструктурированными данными;
- Проблемы, связанные с большими объемами данных и скоростью их обработки.
- Трудности, возникающие в процессе анализа больших массивов данных.

Сегодня на рынке информационных технологий представлены эффективные решения по хранению данных, например, Snowflake, BigQuery, Redshift, Azure Synapse Analytics и т.д. В сочетании с инструментами оркестровки потоков операций по обработке данных (таких как Airflow) и создания моделей DWH (dbt и его аналоги) эти продукты позволяют эффективно анализировать большие объемы данных.
Очевидно, что с момента выхода на рынок эти сервисы стали более продуманными и результативными, однако многим малым и средним предприятиям они попросту не нужны – их вполне устраивают классические DWH, позволяющие хранить и анализировать сравнительно небольшие объемы данных.
Рис. 
2000–2010 – е годы
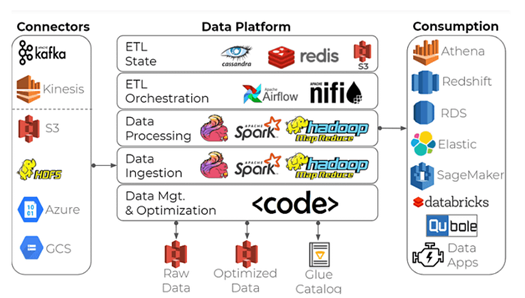
В середине 2000-х годов, когда объемы информации для аналитических задач росли в геометрической прогрессии, появилось понятие Big Data. Традиционные хранилища данных были не в состоянии справиться с ними. Наиболее наглядным примером стали такие гиганты, как Google и Yahoo, генерировавшие огромные объемы данных. Кроме того, развитие машинного обучения, подразумевающее работу с большими массивами неструктурированных данных (например, изображений) также оголило несостоятельность существующих систем управления данными. В результате появилась концепция Data Lake, Google разработала MapReduce , модель распределённых вычислений, используемая в технологиях Big Data. Это привело к разработке комплексного решения с распределенной файловой системой под названием Hadoop Distributed File System (HDFS) . Благодаря этому появилась возможность эффективного хранения и обработки больших массивов данных с помощью MapReduce и Spark.
Основные преимущества Data Lake заключаются в следующем:
- Экономически выгодное облачное хранилище данных;
- Возможность развивать технологии машинного обучения;
- Потоковая обработка данных.
Естественно, и у этого метода хранения данных есть недостатки:
- Отсутствие транзакционной поддержки приводит к созданию новых файлов при добавлении данных, что “раздувает” Data Lake;
- Сложная аналитика данных;
- Вопросы касательно надежности хранимых данных, их достоверности..
Data Lake, основанные на облачных технологиях, таких как S3, GCS или HDFS, а также инструменты оркестровки и распределенной обработки данных, такие как Apache Spark, в разы упростили работу с Big Data. Однако, несмотря на все преимущества Data Lake, традиционные хранилища данных по-прежнему остаются актуальными и востребованными решениями в сфере работы с данными.
20 – е годы
Мы прошли долгий путь от реляционных баз данных до распределенных систем хранения для обработки Big Data. Казалось бы, все проблемы Big Data должны быть решены… Но как бы не так. Многие компании по-прежнему не могут использовать имеющиеся у них данные по максимуму -достаточно большие объемы информации остаются неиспользованными.
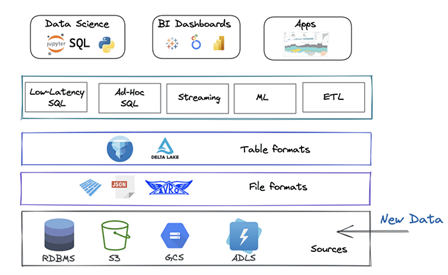
В 20 году компания Databricks опубликовала интереснейшую Databricks разработала достаточно много решений в этой сфере, однако их вполне можно построить и самостоятельно, используя множество open-source инструментов. При работе с системами хранилищ данных очень важно использовать правильную технологию хранения данных на уровне DWH. Такие системы характеризуются использованием табличных форматов, наиболее распространенными из них являются Apache Iceberg, Delta Lake и Apache Hudi.
По остальным характеристикам Data Lakehouse во многом похож на предыдущие решения, предполагающие использование Spark в целях преобразования данных. Однако, важно отметить тот факт, что данный метод хранения данных постоянно эволюционируют и развивается. Каждый год появляются новые технологии, упрощающие процесс обработки Big Data.
Заключение
Итак, мы прошли достаточно долгий путь эволюции решений по управлению данными, в первую очередь это касается аналитических технологий. Абсолютно все подходы имеют как преимущества, так и недостатки. Их применение зависит от целей, которые преследуют компании. Все эти методы активно применяются по всему миру. На мой взгляд, проще всего понять устройство и применить хранилище данных, поскольку оно очень близко к реляционной базе данных на основе SQL. Data Lake также опирается на SQL, но данная технология объективно является более сложной.
Выбирая ту или иную технологию работы с данными, обратите внимание на следующие пункты:
- Используются ли в Вашей компании инструменты МО и ИИ, нужно ли предоставлять им данные? Если нет, то, вероятно, структурированных данных будет достаточно для решения Ваших задач, а это значит, что целесообразнее всего остановиться на хранилище данных;
- Учитывайте объем Ваших данных. Хранение данных в хранилищах – дорогое удовольствие;
- Наконец, еще одним важным вопросом является состав команды разработчиков данных. При использовании Data Lakehouse Вам определенно придется нанять опытных инженеров по обработке данных, одних из самых высокооплачиваемых специалистов.
Искренне надеюсь, что понимание эволюции систем управления данными позволит Вам лучше разбираться в различных подходах и сделать правильный выбор, подходящий именно Вашей компании!


