
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс Современная архитектура хранилища данных » Apache Parquet: как приручить open-source колоночно-ориентированный формат хранения Big Data

Apache Parquet: как приручить open-source колоночно-ориентированный формат хранения Big Data

Apache Parquet отлично подходит для основных сервисов интерактивных запросов, таких как AWS Athena, PresoDB, Azure Data Lake и Amazon Redshift Spectrum. Каждый из этих сервисов дает возможность анализировать данные с помощью стандартного SQL.

Однако стоит заметить, что выбранный формат данных, предназначенных для аналитической работы, может существенно повлиять на производительность системы и стоимость, особенно если речь идет о машинном обучении, искусственном интеллекте или других сложных операциях.

Если Вы хотите построить ETL или ELT процесс ввода данных в Data Lake, значит, настало самое время познакомиться с форматом хранения данных под названием Apache Parquet, а также с основными его преимуществами.


Что такое Apache Parquet?

Возможно, Вы никогда не слышали о формате хранения файлов Apache Parquet. Подобно файлу CSV, Parquet - это тип хранения файлов. Основная разница состоит в том, что Parquet разработан как столбцовый формат хранения данных, предназначенный для сложной обработки данных.

Apache Parquet - это формат данных, который встраивает определенную  схему или структуру в сами данные. Формат файла использует модель измельчения и сборки записей, которая была разработана Google. В результате получается файл, оптимизированный для выполнения запросов и минимизации операций ввода-вывода.

Основные характеристики Apache Parquet:

Apache Parquet - колоночно-ориентированный формат , предназначенный для эффективного хранения данных по столбцам (блоки, группы строк, куски столбцов...) Apache Parquet построенный  с помощью алгоритмов, разработанных компанией Google;

  • Формат хранения был разработан с учетом сложных вложенных структур данных;
  • Apache Parquet создан для поддержки эффективных схем сжатия и кодирования;
  • Apache Parquet позволяет снизить затраты на хранение файлов данных и максимально повысить эффективность запросов к данным с помощью бессерверных технологий, таких как Amazon Athena, Redshift Spectrum, BigQuery и Azure Data Lakes;
  • Лицензирован Apache Software и доступен для самых разных проектов;
  • Поддержка привычных типов данных, метаданных файлов, автоматическое кодирование словарей


На первый взгляд может показаться, что формат Parquet предназначен исключительно для работы с Big Data. Но это не так. Сегодня команды работают над созданием  недорогих и при этом высокопроизводительных BI – систем, способных работать с разными объемами корпоративных данных.


Parquet vs. CSV

Формат CSV является одним из самых распространенных и достаточно простых. Многие инструменты, такие как Excel, Google Sheets и даже решения по редактированию текстов  могут создавать файлы этого формата.

Все мы любим файлы CSV, но все имеет свою цену, даже файлы CSV, особенно если CSV - Ваш формат по умолчанию для конвейеров обработки данных. Цена, скажете Вы? А у моих CSV-файлов тоже есть цена? А как же?!!

Колоночно-ориентированные БД, такие как AWS Redshift Spectrum, или сервисы запросов, такие как AWS EMR (Apache Hive) или Amazon Athena, взимают плату за объем данных, используемых дл обработки запроса. (Многие другие сервисы также взимают плату на основе запрашиваемых данных, так что это присуще не только AWS).

Google и Amazon взимают плату за объем данных, хранящихся на GS/S3.

Использование CSV по умолчанию приведет как к техническим, так и к финансовым последствиям (не в лучшую сторону). И, возможно, Ваша страсть к CSW немного поутихнет.


Почему именно Parquet? Пример: файл 1 TB CSV

Производительность формата Parquet по сравнению с таким форматом, как CSV, имеет ряд весомых и неоспоримых преимущества с точки зрения стоимости, эффективности и гибкости. Ниже показана эффективность и результативность использования файла Parquet по сравнению с CSV.

Преобразование данных CSV в формат Parquet, их сжатие и разбиение на разделы позволит Вам сэкономить деньги и при этом добиться повышения производительности системы.


Только подумайте: если бы в течение года Вы использовали файлы CSV объемом 1 ТБ, затраты на хранение данных составили бы около 2000 долларов США. При использовании файлов Parquet Ваши общие затраты составили бы всего лишь 3,65 доллара США. Я знаю, что Вы любите CSV-файлы, но оправдана ли такая привязанность?

Всем хорошо известна одна непреложная истина - «время – деньги». Если Вы используйте необработанный файл CVS , Вы потратите примерно 5 минут на ожидание завершения обработки запроса. Если Вы платите кому-то 150 долларов в час и при этом на ожидание завершения запроса у него уходит около 30 часов в год,  получается, что стоимость «непродуктивного времени ожидания» составляет примерно $ 4500 в год.

Общее время ожидания завершения обработки запросов для пользователя Apache Parquet, спросите Вы? Около 42 минут или $ 100.


Архитектура Parquet, пример № 2: Redshift Spectrum и Amazon Athena Data Lakes

Как выполнять запросы к файлам Parquet? Amazon Athena и Amazon Redshift Spectrum позволяют выполнять запросы Amazon SQL к данным в Amazon S3. Наличие Parquet на S3 – отличное решение для команд, которые хотят разделить данные между Redshift и S3.

Например, предположим, что в Вашей таблице historical_purchase в Redshift хранится около 4 ТБ данных. Поскольку к ней обращаются нечасто, вполне целесообразно выгрузить ее в S3. И тут возникает вопрос: какой формат хранения  предпочтителен – CSV или Parquet?

Наша таблица historical_purchase состоит из четырех одинаковых по размеру столбцов, которые хранятся в Amazon S3 в трех файлах:
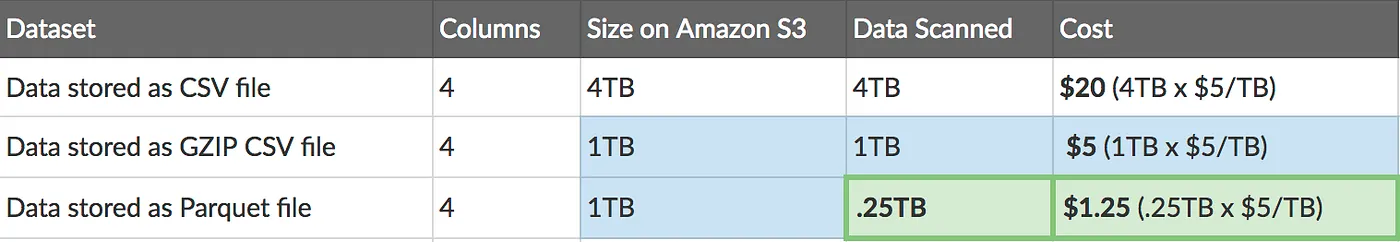
  1. Несжатый CSV файл

Общий размер несжатого CSV-файла составляет 4 ТБ. Выполнение запроса для получения данных из одного столбца таблицы потребует от Redshift Spectrum сканирования всего файла размером 4 ТБ. В результате обработка этого запроса будет стоить 20 долларов.


  1. Сжатый CSV

Если сжать CSV-файл с помощью GZIP, его размер уменьшится до 1 ГБ. Вот это да! Хорошая новость: CSV-файл уменьшился в четыре раза, поэтому Вы заплатите четвертую часть того, что платили раньше. Этот запрос стоил бы 5 долларов. Плохая новость: Redshift Spectrum все равно придется сканировать весь файл.


  1. Файл Parquet

Сжатие файла и преобразование CSV в Apache - пример эффективного кодирования 1 ТБ данных в S3. Поскольку мы имеем дело с колоночно-ориентированным форматом хранения данных, Redshift Spectrum будет читать только столбцы, имеющие отношение к выполняемому запросу. Ему нужно будет просканировать только 1/4 часть данных. Такой запрос обойдется всего в 1,25 доллара.


Если Вы выполняете этот запрос раз в год, использование несжатых CSV-файлов обойдется в $7300. Сжатые CSV-запросы будут стоить чуть больше - около $1800. Использование формата Parquet обойдется примерно в $460 … Все еще без ума от CSV?


Заключение

Бессерверные интерактивные аналитические сервисы становятся все более и более популярными. Если Вы являетесь приверженцем AWS, то, скорее всего, рано или поздно Вы столкнетесь с дилеммой Redshift Spectrum vs. Athena.

Помните, что при правильном подходе сочетание озера данных и формата Parquet откроют перед Вами широкий спектр аналитических возможностей независимо от выбранного бессерверного сервиса.

Когда Вы платите только за обработку запросов, очень важно оптимизировать формат используемых данных. Parquet + Athenа (или Spectrum) в разы снижает затраты на хранение данных.  При этом анализ данных с помощью Amazon S3 и стандартного SQL превращается в задачу, с которой сможет справиться даже первоклассник.

Более того, Google поддерживает загрузку этих файлов в BigQuery, а Microsoft - в Azure Data Lake, что позволяет легко маневрировать между облачными платформами.


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
От реляционных БД до Data Lakehouse: краткая история развития систем управления данными
Следующая статья →
Apache Parquet
Запросить видео презентацию Запросить доступ к демо стенду online Узнать стоимость лицензий

Задать вопрос

loading...

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • НПФ «Будущее» — один из крупнейших негосударственных пенсионных фондов России, предоставляющий услуги по пенсионному обеспечению и накоплениям. Фонд активно внедряет цифровые технологии для повышения качества обслуживания клиентов.

  • ПАО «Транснефть» – крупнейшая российская нефтепроводная компания. «Транснефть» обеспечивает транспортировку более 85% добываемых в России нефти и нефтепродуктов.

  • Компания ООО "Комус" - один из лидеров российского рынка оптовых продаж офисных товаров и техники. Компания поставляет широкий ассортимент продукции - от канцелярских принадлежностей до компьютерной техники и офисной мебели.

  • Русклимат
    Русклимат — международный торгово-производственный холдинг, концентрирующий опыт ведущих мировых производителей индустрии климата, мощный потенциал конструкторских бюро и лабораторий индустриального дизайна.
     
    Компания образована в 1996 году. За более чем двадцатилетнюю историю Русклимат прошел путь от локальной компании до мощной вертикально-интегрированной многопрофильной структуры.
     
  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.